16.5GB のファイルが、2月時点で最強だった非公開モデルを上回った
3年前、ダウンロードできる最良のモデルは HumanEval で GPT-4 に37ポイント差で敗れ、動かすにはグラフィックカードが2枚必要でした。先週、27B のオープンウェイトモデルが Artificial Analysis の Intelligence Index で 52.0 を記録。Claude Opus 4.6 Max は 44.9 です。価格は9分の1、ファイルは 16.5GB。ベンチマーク表、価格曲線、そして追随ラグが162日まで縮んだことの意味をまとめます。
Hacker News のあるユーザーが、メモリ 16GB のグラフィックカードでフロンティア級の言語モデルを動かしています。毎秒50〜60トークン、コンテキストは12万8千トークン。モデルは2026年8月14日公開の Qwen3.8-27B です。Artificial Analysis の Intelligence Index でこのモデルは 52.0。つい2月まで市場最強の非公開モデルだった Claude Opus 4.6 Max は 44.9 です。
2023年であれば、この一文はSFでした。しかも愉快な種類のSFではありません。
この記事はその前と後を比べます。リリース報道そのものはすでに書いたので、ここで扱うのは3年を挟んだ比較です。当時と今、ダウンロード可能な最良のモデルがフロンティアに対して取った点数。当時と今、一定水準の知能を買うのにかかる費用。そして当時と今、自前で動かすために必要だったハードウェア。以下のすべての数値には出典と日付が付いています。その数値が描く傾向は、いまソフトウェアの世界で起きていることの中でも、かなり率直に楽観的な部類です。
要点:
- 差は縮まり、その日付まで特定できます。 2023年7月、最良のオープンモデルは MMLU で GPT-4 に17.5ポイント、HumanEval で37.1ポイント差で負けていました。2026年8月、オープンな 27B は2月の非公開フラッグシップに対し、双方が数値を公開している19のベンチマークのうち15で勝ち、独立した総合指標でも上回っています。
- 価格は23か月で約208倍下がりました。 性能を固定したうえでの Epoch AI の測定値です。現在のオープン 27B は100万トークンあたり混合単価 1.09ドル、Opus 4.6 Max は 10.00ドル。自前で動かせばトークンあたりの費用はゼロです。
- フロンティアではありません。そこも明記します。 Claude Opus 5 Max は 63.1、GPT-5.6 Sol Max は 60.9 です。27B は幅広い知識推論で Opus 4.6 に大きく負けます。HLE で 30.8 対 40.0 です。
画像: Steve Jurvetson、ウィキメディア・コモンズ、CC BY 2.0。1988年頃の Cray Y-MP の相互接続部。かつて本格的な計算とは、人が歩いて入る部屋のことでした。
「前」は実際にこう見えていた
時計を2023年7月18日、メタが Llama 2 を公開した日に戻します。当時、公開されてダウンロードできる世界最良のモデルであり、その論文は非公開フロンティアとの点数表を隠さずに載せました。
Llama 2 70B は MMLU で 68.9、GPT-4 は 86.4 でした。GSM8K では 56.8 対 92.0。コーディングのベンチマークである HumanEval では 29.9 対 67.0 と、半分にも届きません。論文自身の要約はこうです。「Llama 2 70B と GPT-4 および PaLM-2-L の間には依然として大きな性能差がある」。2023年、オープンウェイト陣営の旗艦が自ら残した一文です。
ハードウェアも見ましょう。人々が実際に Llama 2 70B を動かしていた方法である TheBloke の4ビット版コミュニティビルドは 41.4GB のファイルで、2023年9月4日に公開されました。実用的な速度で動かすには 24GB のグラフィックカードが2枚、あるいは 64GB の Mac が必要でした。普通のノートPCに実際に収まるのは Llama 2 13B で、7.9GB のファイル、MMLU 54.8点。GPT-4 より31.6ポイント低く、デモ以外の用途はほとんどありませんでした。
つまり2023年の選択肢はこうでした。フロンティアの研究所に支払うか、目に見えて劣るものを大半の人が持っていないハードウェアで動かすか。「素直に API を使え」という主張が2年間圧倒的に勝ち続けた理由がここにあります。その主張は正しかったのです。
同じ問いを2026年8月に向ける
アリババは2026年8月14日、Apache 2.0 のもとで Qwen3.8-27B を公開し、モデルカードに Claude Opus 4.6 Max との直接比較表を載せました。双方に数値がある行をすべて数えました。
Qwen3.8-27B は19行のうち15行で勝ち、4行で負けています。 勝ちには SWE-bench Pro(61.7 対 53.4)、IFBench の指示追従(79.5 対 62.5)、LiveCodeBench v6 の競技コーディング(90.3 対 88.8)、OSWorld-Verified のコンピュータ操作(84.3 対 72.7)、AndroidWorld のモバイルエージェント(81.9 対 62.0)が含まれ、差が接戦とは言えないマルチモーダルのベンチマークが続きます。MathVision で 90.0 対 65.5、CharXiv のチャート解析で 83.7 対 66.0、ERQA の身体性推論で 65.5 対 40.8 です。
負けた4行のほうが勝った15行より重要です。270億パラメータのモデルに何がまだできないかを教えてくれるからです。Terminal Bench 2.1 で 73.0 対 78.2、NL2Repo-Bench のリポジトリ単位のコード生成で 42.3 対 47.6、GPQA Diamond で 89.2 対 91.3 と僅差で負け、そして幅広い分野の推論を測る HLE で 30.8 対 40.0 と大きく負けます。最後の一つがこの限界の形そのものです。世界の知識を 16.5GB のファイルに圧縮することはできません。一方で、技能はきわめて多く圧縮できます。
一行には注釈が必要です。79.0 対 63.8 が出た QwenSWEBench は Qwen 自身が作ったベンチマークです。ベンダーが作ったベンチマークをベンダーが走らせた結果は、どのモデルカードでも最も弱い証拠であり、私たちはこの数値を当てにしていません。
独立した採点表も同じことを言う
ベンダーの表はベンダーの表なので、第三者を見ます。他社の数値を転載せず自ら評価を回す Artificial Analysis が、27B のベンチマークを完了しました。2026年8月21日時点で Qwen3.8-27B の Intelligence Index は 52.0、オープンウェイトの40億〜400億パラメータ級135モデル中1位です。Claude Opus 4.6 Max は 44.9。利害関係のない第三者が測った7.1ポイント差であり、Opus 4.6 の出荷から190日後の出来事です。
この比較を時間軸で遡ると、それ自体が物語になります。2023年7月、400億パラメータ以下で最良のオープンモデルは同じ指標で 2.6 でした。2024年7月は 7.4。2025年3月は 13.4。2026年2月は 34.6。そして先週 52.0 です。
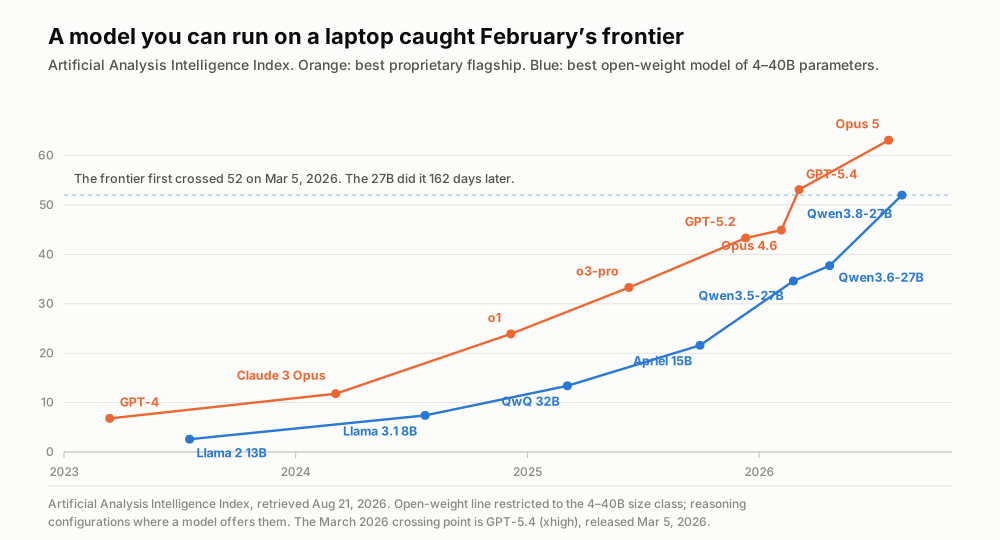
どちらの線も上がります。興味深いのは両者の横方向の距離です。Artificial Analysis Intelligence Index、2026年8月21日取得。
ここに名前を付けるに値する数値があります。フロンティアが Intelligence Index 52 を初めて超えたのは2026年3月5日、GPT-5.4 が最大の推論強度で 53.1 を出したときです。個人の機械で動く程度に小さいモデルがそこに届いたのは8月14日、162日後でした。これを追随ラグと呼ぶことにします。ある能力がフロンティアに現れてから、自分のハードウェアに現れるまでの時間です。
このラグはかつてもっと長いものでした。Llama 3.1 8B が GPT-4 Turbo の水準に届くまで260日。GLM-4.7-Flash が o1 に並ぶまで410日。直近のノートPC級リリース3件は、201日、155日、162日です。フロンティアが減速したわけではありません。Opus 5 Max は本日 63.1 にいます。ただ、追う側の縁が2年前のおよそ2倍の速さで詰めてきています。
価格は下がったのではなく、崩れた
能力は前後比較の半分です。もう半分は請求書です。
Epoch AI が2025年3月にこれを最も明快に測っており、その方法自体が知る価値があります。ベンチマークの点数を固定し、その点数を出す最も安いモデルの価格を時間で追う、というものです。GPT-4 の MMLU 86点を基準にすると、価格の階段は2023年3月に100万トークンあたり 37.50ドル、2023年11月に 15.00ドル、2024年5月に 7.50ドル、同月末に 2.19ドル、2025年2月に 0.18ドルまで下がります。点数は同じままです。23か月で208倍安くなりました。
Epoch の中心的な発見は、その速度が課題によって大きく異なることです。どの能力を固定するかによって年9倍から900倍まで幅があり、博士課程レベルの科学問題で GPT-4 級の性能を出す価格は年およそ40倍の速さで下がりました。方向だけは一度も変わっていません。
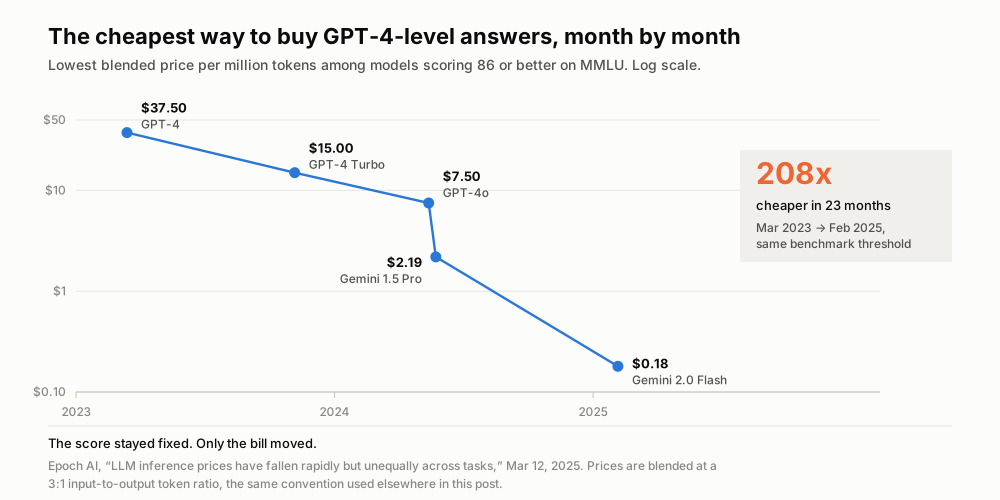
この線上のすべての点で、ベンチマークの点数は固定されています。Epoch AI、2025年3月12日。
この系列を現在の価格まで延ばしても流れは続きます。2026年8月21日時点の OpenRouter のカタログでは、Qwen3.8-27B は入力100万トークンあたり 0.45ドル、出力100万トークンあたり 3.20ドル。Claude Opus 4.6 はそれぞれ 5.00ドルと 25.00ドルです。Epoch が用いる入力対出力3:1の混合換算で 1.09ドル 対 10.00ドル、すなわちオープンモデルは半年前の非公開フラッグシップより9.1倍安く、指標で7.1ポイント高いということになります。
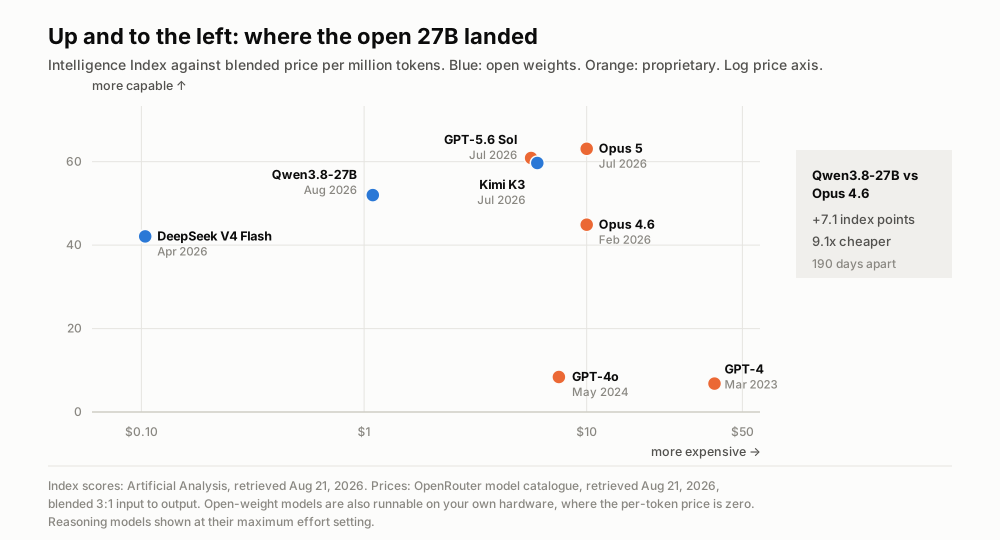
意味のあるモデルはすべて左上へ移動しています。得点は Artificial Analysis、価格は OpenRouter、いずれも2026年8月21日取得。
そして、トークンあたりの価格という概念自体が存在しない選択肢もあります。27B を自分の RTX 4090 で、リリーススレッドで実務者が報告したおよそ毎秒48トークンで動かすとします。カードの定格450ワットを仮定し、米国の家庭用平均電力価格である1キロワット時あたり18.44セント(EIA、2026年5月)を当てはめると、電気代は出力100万トークンあたりおよそ0.48ドルです。カード自体の代金はまだ数えておらず、その代わり誰の利幅も数えていません。ベンダーの主張ではなく、前提をすべて開示した計算上の推定値です。
前と後を、一行ずつ
| 2023年7月 | 2026年8月 | |
|---|---|---|
| ダウンロードできる最良のモデル | Llama 2 70B(メタ、2023年7月18日) | Qwen3.8-27B(アリババ、2026年8月14日) |
| パラメータ数 | 700億 | 270億 |
| 標準的な4ビットのコミュニティビルド | 41.4GB | 16.5GB |
| 実用最小のビルド | 7.9GB(13B、MMLU 54.8) | 9.8GB(2ビット、16GB のカードで12万8千コンテキスト) |
| 現実的なハードウェア | 24GB の GPU 2枚、または 64GB の Mac | 16GB のコンシューマ向け GPU 1枚 |
| 当時のフロンティアモデル | GPT-4(2023年3月14日) | Claude Opus 4.6 Max(2026年2月5日) |
| それとの対戦成績 | MMLU −17.5、GSM8K −35.2、HumanEval −37.1 | 公開された19ベンチマーク中15勝、Intelligence Index +7.1 |
| そのフロンティアモデルの混合単価 | 100万トークンあたり 37.50ドル | 100万トークンあたり 10.00ドル |
| オープンモデルの混合単価 | 大規模な提供なし | 100万トークンあたり 1.09ドル |
| ライセンス | Llama 2 コミュニティライセンス | Apache 2.0 |
各セルの出典は末尾にまとめてあります。私たちが何度も戻ってしまうのは下から2番目の行です。フロンティア自身の価格は3年で3.75倍下がりましたが、オープンな代替はその下、およそ10分の1の水準に現れました。両方が起きたのです。誰が何を作れるかを変えるのは、後者のほうです。
まだ事実ではないこと
このリリースを巡る熱狂は、4つの具体的な点で証拠を追い越しています。印を付けておきます。
フロンティアではありません。同じ指標で Claude Opus 5 Max は 63.1、GPT-5.6 Sol Max は 60.9 と、52.0 を大きく上回ります。いま手に入る最も難しい推論に仕事が依存しているなら、フロンティアは依然として別の製品であり、依然として非公開です。
サイズの割に安くもありません。Artificial Analysis 自身の要約が Qwen3.8-27B を「同程度のサイズの他のオープンウェイトモデルと比べると特に高価」と書いています。同クラスのオープンモデルの入力単価の中央値は100万トークンあたり 0.05ドル、Qwen は 0.43ドルです。支払っているのはパラメータ数ではなく能力に対してです。
冗長であり、冗長さは費用です。Intelligence Index の評価を回すあいだ、27B は出力トークンを1億6千万個生成しました。中央値は4千5百万個です。ある利用者は 64GB の Mac mini で2語のプロンプトを与え、17分12秒のあいだモデルが考えるのを見守りました。推論モデルはトークンが無料でも、実時間で請求してきます。
そしてベンチマークの点数は元の精度のモデルのものです。あなたのグラフィックカードに収まる 9.8GB の2ビット版は、52.0 を取ったモデルではありません。強い量子化は精度を削り、とりわけ長いコンテキストでそれが出ます。「ノートPCで動く」という主張には、私たちのものも含めて、この但し書きが付きます。
ラグが縮み続けるはずの理由
ここからは私たちの見解です。転換点を明示します。ここまではすべて測定で、ここからはそこからの推論です。
追随ラグを押し下げている仕組みは、不思議なものではありません。フロンティアで公開された事後学習の手法は、数か月のうちにオープンな研究所で再現されます。1年半前には専有技術だった推論強度の制御は、いまやこのモデルカードに文書化されたパラメータとして出荷されています。コミュニティによる量子化は、元の研究所のドキュメントが確定するより先に終わります。この3つのフィードバックループのどれにも減速する理由はなく、うち2つは参加者が増えるほど速くなります。
したがって次世代への妥当な期待は、オープンモデルがフロンティアを追い抜くことではありません。162日というラグが縮み続ける一方で、両端の絶対的な能力も上がり続ける、ということです。すると興味深い問いは「オープンモデルは勝てるか」ではなく「自分の作業で差が問題でなくなるには、フロンティアはどれだけ最近であれば足りるか」になります。会議の文字起こし、翻訳、要約、そして大半の文書業務では、その閾値はとうに越えています。最前線の研究や最も難しいエージェント型のエンジニアリングでは、まだです。
2023年の世界よりずっと良い世界であり、それははっきり言う価値があります。コンピュータに言語をきちんと理解させる費用は3年で100倍規模まで下がり、いまも下がり続けています。最も恩恵を受けるのは、これまで価格で締め出されていた側です。個人開発者、100万トークンあたり10ドルが誤差では済まない国のチーム、予算ではなく助成金で働く研究者、そして法的な理由でデータを自分の機械から出せないすべての人たちです。
結論: フロンティアは場所であることをやめ、日付になった
かつての問いは「どの研究所にアクセスできるか」でした。新しい問いは「9分の1の費用で自分のハードウェアで動くとして、フロンティアから何か月遅れることを受け入れられるか」です。
ますます多くの仕事について、正直な答えはこうです。だいたい5か月、そして縮小中。
Telli.sh の位置づけ: 以上が、私たちが特定ベンダーの周りを固めるのではなくオープンモデルの上に作る理由です。Telli.sh は要約の経路にすでにオープンな Qwen モデルを使っており、この曲線を一段下るたびに、値上げの告知ではなくより良い議事録として届きます。私たちが取り組んでいるのは、どんなダウンロードでも手に入らない部分です。1時間の音声を途切れさせずに捉え、話者を分け、15言語をリアルタイムに翻訳し、その全部を数か月後でも検索できるノートに変えることです。
出典
- Qwen3.8-27B のモデルカードとベンチマーク表、Hugging Face — Opus 4.6 Max との直接比較数値、2026年8月21日取得
- Artificial Analysis: Qwen3.8 27B の知能・性能・価格分析 — Intelligence Index 52.0、価格および出力量、2026年8月21日取得
- Artificial Analysis: Claude Opus 4.6 モデルページ — 最大推論強度で Intelligence Index 44.9、2026年8月21日取得
- Epoch AI「LLM inference prices have fallen rapidly but unequally across tasks」2025年3月12日 — 性能固定の価格階段と年9〜900倍の幅
- Llama 2: Open Foundation and Fine-Tuned Chat Models(arXiv:2307.09288)2023年7月18日 — 表4、Llama 2 70B 対 GPT-4
- TheBloke/Llama-2-70B-Chat-GGUF のファイル一覧 — 41.4GB の Q4_K_M ビルド、2023年9月4日公開
- unsloth/Qwen3.8-27B-GGUF のファイル一覧 — 16.5GB および 9.8GB ビルド、ダウンロード数は2026年8月21日取得
- OpenRouter モデルカタログ — Qwen3.8-27B、Claude Opus 4.6、Claude Opus 5 のトークン単価、2026年8月21日取得
- Qwen3.8-27B 公開に関する Hacker News の議論、2026年8月14日 — 16GB および 24GB のカードにおける実測スループット報告
- 米国エネルギー情報局 Electric Power Monthly 表5.3 — 2026年5月の家庭用平均、1キロワット時あたり18.44セント
- Qwen3.8 オープンウェイト公開についての以前の記事とより広いオープンウェイトの波についての記事
- Cray Y-MP 写真のウィキメディア・コモンズのページ
