Qwen3.8-27B オープンウェイト:サイズ、Q4_K_M、4090 と Mac の実測速度
Qwen3.8-27B は Apache 2.0。Q4_K_M の GGUF は 17.1 GB で 32 GB のノートPCに収まり、FP8 は 30.9 GB。実測は RTX 4090 で毎秒 48 トークン、Mac mini M4 Pro で 12.75 トークン。
8月3日、アリババの Qwen アカウントはオープンウェイトが「来週」出ると述べました。AI 業界が長年かけて「割り引いて聞くもの」と教え込んできた類の文です。ところが12日後、割り引く余地は何も残っていませんでした。2.4兆パラメータの Qwen3.8-Max のウェイトが8月12日に Hugging Face へ上がり、小さいほうの Qwen3.8-27B は、ごく普通の Apache 2.0 ライセンスを付けて8月14日に続いたのです。
そこから先が本当に興味深い部分でした。Qwen が27B のモデルカードを書き終えたのと同じ一時間のうちに、三つの異なるコミュニティが、すでにこのモデルを個人用パソコンで動かせる形式へ変換し終えていました。その2日後、変換版のダウンロード数は100万件を超えました。
この記事の主役はベンチマーク表ではなく、この数字です。世界有数の AI 研究所が出した270億パラメータのモデルが、「発表された」から「百万台規模の机の上で動いている」までに、およそ48時間しかかかりませんでした。本稿はそれが実際に何を意味するのかを、平易な言葉で案内します。どのライセンスで何が公開されたのか、いま手元にあるハードウェアで27B を動かすには何が要るのか、この3年でどこまで来たのか、そして多くの記事が飛ばす部分 — ローカルの27B がいまだにできないことは何か。
要点
- 約束は守られました。Qwen3.8-Max(総2.4兆/有効950億)は8月12日、Qwen3.8-27B は8月14日に到着。どちらもホスティングのプレビューではなく、本当にダウンロードできるウェイトです。
- ライセンスは同じではなく、その差はスコアより重要です。 27B は Apache 2.0。しきい値も条項もなく、商用に使って何も負いません。Qwen3.8-Max はモデル提供事業に売上トリガーが付いた独自ライセンスです。
- 誰が何を動かせるかは結局サイズが決めます。Max は4,892GB のダウンロード、4ビットに圧縮した27B は17.1GB で、32GB のマシンにも収まります。コミュニティの4ビット版は2日で107万ダウンロードを超えました。
画像: Dejan Krsmanovic, Wikimedia Commons, CC BY 2.0。フロンティア研究所のモデルを自分で動かすとは、その機械と保守も自分のものになるということです。
約束には日付が付いていて、その日付は守られた
8月4日、私たちはその発表そのものを取り上げ、待ち時間が「いつか」ではなく「来週」単位で測られていると書きました。当時の証拠で行ける限界でした。結末はきれいに決着しました。
Qwen3.8-Max として売り出されている Qwen3.8-2.4T-A95B は、ライセンスファイルとともに8月12日に公開されました。Qwen3.8-27B と効率重視の FP8 版は8月14日に到着しました。どちらの日付も「来週」が指した範囲の内側です。発表されたモデルが結局出てこないことが珍しくない業界で、9日前の口約束の期限を守ったこと自体が注目に値します。
反応は即座で、しかも大きなものでした。27B に関する Hacker News のスレッドは1日で1,351ポイントと769件のコメントを集めました。数時間のうちに実務者が特定のハードウェア向けの動作するサーバ設定を投稿しはじめ、ある人は NVIDIA DGX Spark と民生用 RTX 4090 グラフィックスカードの両方の設定を共有しました。新しいアーキテクチャを動かすこと自体が週末プロジェクトだった2年前のオープンモデル公開とは、まるで違う光景です。
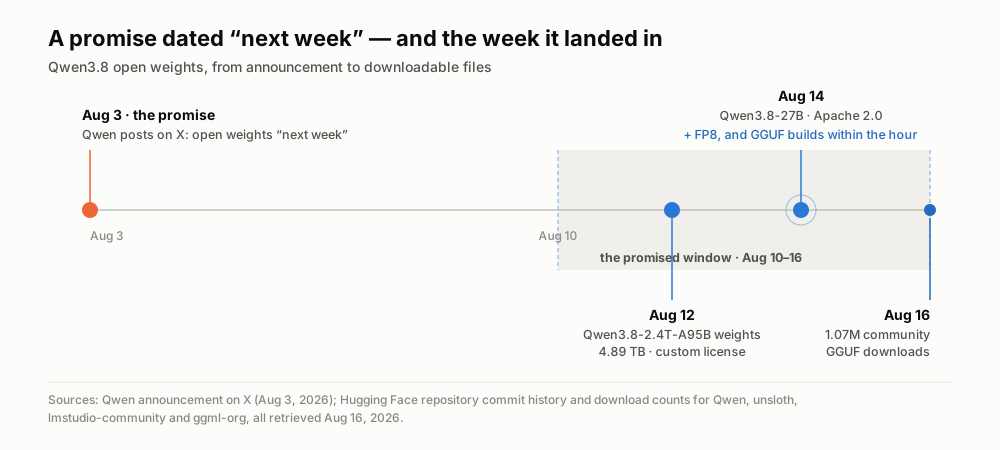
日付の付いた約束と、その内側に届いた2回の公開。日付は Hugging Face リポジトリのコミット履歴より、2026年8月16日取得。
「自分で動かせるのか」という問いに向けた5つの用語
以前の記事から来られた方は、オープンウェイトが何かはすでにご存じでしょう。研究所が完成したモデルを構成する巨大な学習済み数値の格子を公開し、私たちはそれをダウンロードして自分のハードウェアで動かし、リクエストごとの課金なしにその上に何かを作れる、という話です。ここで問題になるのはその次の、完全に実務的な問いです。実際に動かすとハードウェアはいくらかかるのか。
パラメータとはその学習済みの数値で、その個数がモデルの素の大きさを決めます。目安は残酷なほど単純です。研究所が学習に使う精度では、パラメータ10億個あたりディスク約2GB、動作中にモデルを保持するメモリもだいたい同じだけ要ります。つまり270億パラメータのモデルは55GB のダウンロードです。2.4兆パラメータなら5テラバイト近い。片方がノートPC の話で、もう片方がデータセンターの話になる理由がここにあります。
量子化はその差を埋める手段で、自宅でモデルを動かしたい人にとって最も有用な概念です。パラメータは通常16ビットの精度で保存されます。量子化はこれを8ビット、4ビット、ときには2ビットへ丸め、ファイルサイズはほぼその比率で縮みます。4ビット量子化はさきほどの55GB を約17GB にします。精度を少し失い、そもそも動かせるという能力を得る取引です。GGUF は、こうした圧縮版が収まるファイル形式にすぎません。llama.cpp、Ollama、LM Studio といったツールが読む形式です。「Q4_K_M」という表記は「たいていの人が使う4ビット版」と読んでください。
密なモデルと混合エキスパートの違いは、収まったあとの速度を決めます。Qwen3.8-27B は密なモデルで、単語を1つ生成するたびに270億パラメータすべてが動きます。Qwen3.8-Max は混合エキスパートで、総計2.4兆パラメータのうち、ルーターが512の専門サブネットワークからトークンごとに約950億個分だけを選びます。総数は保管のコストを、有効数は計算のコストを教えてくれます。この区別には鋭い実務上の意味があり、あとで戻ってきます。
コンテキストウィンドウは、モデルが一度に考慮できる分量です。27B は262,144トークンを標準で扱います。1時間の議事録を何本も積んだ程度で、設定を変えれば100万まで伸ばせます。
まずライセンスを読むべきだ
ここが本稿で最も重みのある発見です。同じ系列のモデルなら同じ系列の条件を共有するはずだ、という思い込みを正面から裏切ります。
Qwen3.8-27B は Apache 2.0 です。 スペクトラムの最も寛容な側です。使い、改変し、ファインチューニングし、商用製品に載せて出し、その上で事業を営んでも、何も負わず誰にも尋ねる必要がありません。売上のしきい値も、画面への名称表示義務も、用途の除外条項もありません。
Qwen3.8-Max は違います。 MIT のように始まり、そこに2つの条件を付ける独自の「Qwen3.8-Max ライセンス」で公開されました。製品が月間アクティブユーザー1億人または月商2,000万米ドルを超えたら、インターフェースにモデル名を表示しなければなりません。そして、モデル提供事業や AI 業務アシスタント事業を営み、任意の12か月の売上が5,000万ドルを超える場合は、商用利用の前に Qwen と別途契約を結ぶ必要があります。
個人開発者や社内利用の企業には、どちらも刺さりません。しかしこれは Kimi K3 が MIT ではなく独自ライセンスで公開されたときに私たちが指摘したのと同じ但し書きであり、教訓も繰り返されます。「オープンウェイト」と「オープンライセンス」は別の問いであり、一つの研究所が2日違いで出した2つのモデルに、別々の答えを出すことがあります。スコアに惚れる前にライセンスを読んでください。
| モデル | 総パラメータ | トークンあたり有効 | ダウンロードサイズ | ライセンス | 現実的な動作環境 |
|---|---|---|---|---|---|
| Qwen3.8-Max (2.4T-A95B) | 2.4兆 | 950億 | 4,892GB | 独自、売上トリガー | アクセラレータのクラスタ |
| Qwen3.8-Max, FP8 | 2.4兆 | 950億 | 2,496GB | 独自、売上トリガー | アクセラレータのクラスタ |
| Qwen3.8-27B | 270億、密 | 270億 | 55.6GB | Apache 2.0 | 複数 GPU のワークステーション |
| Qwen3.8-27B, FP8 | 270億、密 | 270億 | 30.9GB | Apache 2.0 | ハイエンド GPU 1枚 |
| Qwen3.8-27B, Q4_K_M GGUF | 270億、密 | 270億 | 17.1GB | Apache 2.0 | 32GB のノートPC か 4090 |
27B を動かすのに実際に要るもの
正直な答えはこうです。思っているより少なくて済み、見出しがほのめかすより多くかかります。
いちばん低い段は、コマンド1つです。27B は Ollama のライブラリにあり、ollama run qwen3.8 で256K のコンテキストウィンドウと画像入力を備えた18GB のビルドが降ってきます。Apple シリコン向けを含め12の派生があります。ターミナルの代わりにチャット画面を与えてくれる LM Studio も、公開から数分でビルドを上げました。どちらも前節の内容を理解しろとは要求しません。
そのあと、毎秒トークン数という形で現実が割り込んできます。公開スレッドに投稿された実務者の計測値は、おおむねハードウェアが予測する位置に落ちました。RTX 4090 で4ビット版を動かしたある人は毎秒およそ48トークン。人が読む速さより余裕で速い。メモリ64GB の Mac mini M4 Pro では毎秒12.75トークン。使えますが、打ち出されるのを眺めることになります。そして AMD 7840U と一般的な DDR5 64GB を積んだノートPC では、同じ4ビット版が毎秒約4トークンでした。技術的には動いており、実質的には仕掛けて席を立つバッチ処理です。
最後の数字こそ、密と混合エキスパートの違いが働く場所です。同じ人が同じノートPC で、名目上はより大きい旧世代の混合エキスパートモデルを測ったところ、毎秒およそ20トークンが出ました。より小さい密なモデルの5倍です。単語ごとにパラメータの一部しか動かないからです。CPU で動かすものを選んでいるなら、比べるべき数字は総パラメータではなく有効パラメータです。ローカル AI で最も直感に反し、最も役に立つ教訓です。
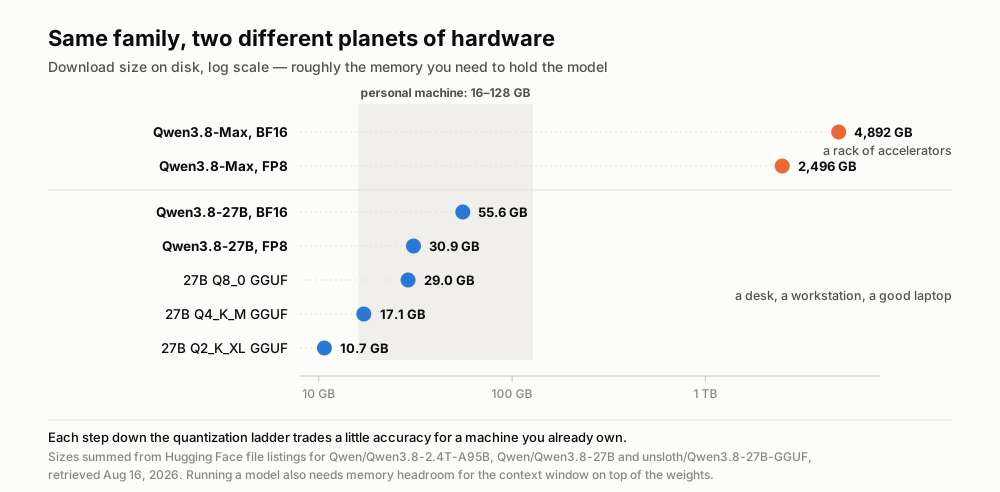
同じモデル系列の2つのメンバー、ダウンロードサイズの差は290倍。Hugging Face のファイル一覧から合算、2026年8月16日取得。
3年前はリークと週末が1つ必要だった
この跳躍の大きさを見るには、ローカルモデルの出発点と並べる必要があります。
2023年2月、Meta は初代 LLaMA のウェイトを承認された研究者にのみ公開しました。それは1週間ほどで流出し、趣味レベルのローカルモデル文化はまるごと、本来持っていてはいけないファイルの上に築かれました。2023年3月10日、ある開発者が llama.cpp を公開します。70億パラメータのモデルを MacBook で動かすのが持ち芸の、小さな C++ プログラムでした。そのリポジトリはいまや12万4千のスターを集め、今日使われているほぼすべての「ローカルで動かす」ツールの祖先になっています。
2つの公開日を比べてみましょう。2023年は、流出した7B、ライセンスと呼べるものはなし、動かすまでにコミュニティの1週間、そして有用というより興味深いモデル。2026年は、フロンティア研究所の27B が意図的に Apache 2.0 で公開され、画像と動画の入力と262K のコンテキストウィンドウを備え、コミュニティのビルドは研究所自身のドキュメントがまだ変わっている最中に完成していました。unsloth 版の最初のコミットは8月14日の協定世界時14時56分。Qwen がモデルカードを最後に更新する4分前です。
普及の数字はもっと素っ気なく同じことを言います。8月16日時点で、27B のコミュニティ4ビット版は、ある配布者から867,963回、2番目から171,518回、3番目から34,520回ダウンロードされました。2日で107万回です。Qwen 自身の公式27B リポジトリがさらに21万5千回を加えます。はるかに高性能な Qwen3.8-Max は、2つのリポジトリを合わせて17,126回にとどまっています。
この比率をもう一度読んでください。フロンティア級のモデルが集めたのは、ノートPC 級のモデルが集めた関心のおよそ1.6%です。市場が取りに行ったのは性能ではありません。到達範囲です。
ローカルの27B がいまだにできないこと
ここで補正が要ります。熱狂が証拠を追い越す仕方は、いつも予測がつきます。
アリババ自身のベンチマーク表では、27B はいくつかのエージェント的コーディングや指示追従の指標で Opus 4.6 Max を上回ります。SWE-bench Pro で61.7対53.4、IFBench で79.5対62.5。一方で負ける指標もあり、広範な知識を問う HLE では30.8対40.0です。これらはすべてベンダー自己申告の数値です。本稿執筆時点で、私たちが頼りにしている独立評価機関 Artificial Analysis には27B の項目自体がありません。Qwen3.8-Max なら188モデル中10位、知能スコア58で載っています。見事な成績であり、同時に別のモデルの話です。
実務者はスプレッドシートより鋭かった。公開スレッドで最も支持された反論は、長年のオープンモデル利用者を自認する人によるもので、明快でした。これらは実運用で最上位のホスティングモデルには勝たない。多くのタスクに「十分よく」、手が届く価格のハードウェアで動く。それは別の、もっと控えめな主張だ、と。別のコメントは天井を物理的な言葉で表しました。人類の知識全体を30GB のファイルに圧縮することはできないのだから、小さなモデルは、コーディングや道具の使用がどれだけ鋭くなっても、知られていない事実の想起では相対的に弱いままだ、と。
自分で動かして初めて見える限界がもう2つあります。量子化はただではありません。強く圧縮したモデルは長い文脈で筋を見失い、同じ言葉を繰り返すループに落ちやすい。メモリに余裕がある人にはフル精度版が勧められる理由です。そしてこの世代の Qwen は、既定で深く考えます。あるユーザーは64GB の Mac mini で27B に「svg owl」という2語を投げ、答えが出るまでに17分12秒かけて21,769トークンの推論が生成されるのを見守りました。出てきたフクロウは見事でした。同時に、どのホスティング API も請求しなかったはずの実時間の請求書も出てきました。
そして誰も数えない項目があります。運用があなたのものになるのです。モデルの更新、量子化の選択、メモリの余裕、ドライバのバージョン、機械のファンまで。避けようとしていたそのホスティング API は、何かを動かし続ける人々のチームでもありました。
結論: 堀はスタックの下へ移った
要点はこれで、公開1件より大きな話です。
フロンティア研究所が木曜日に有能な27B を公開しました。土曜日には、コミュニティが圧縮した版の100万部以上が人々のマシンに載り、Ollama ではコマンド1つの距離にあり、その上で事業を営むことも法的に自由でした。そのモデルが表す優位が何であれ、すべての競合に同時に開かれるまでおよそ2日でした。これを2日間の堀と呼びましょう。モデルの優位の半減期が、いまや48時間程度だということです。
これは予測ではありません。今週、この公開で取られた測定値です。
そしてこれは、AI プロダクトを作るとは何かを定義し直します。モデル層が誰でも午後1回で差し替えられるコモディティになると、モデルは競争する場所ではなくなります。生き残るのはその周りを包むすべてです。午前3時に推論サーバが倒れたときの信頼性、正しい文脈を捕まえ、整え、取り出すデータパイプライン、ベンチマークのデータではなくあなたのデータで動くかを教える評価、人が実際に触るインターフェース、そしてそもそも誰が会議の録音を預けるかを決める信頼の取り決め — プライバシー、保存期間、誰が何を見られるか。
どれ一つ、2日でコモディティにはなりません。どれにもダウンロードボタンはありません。
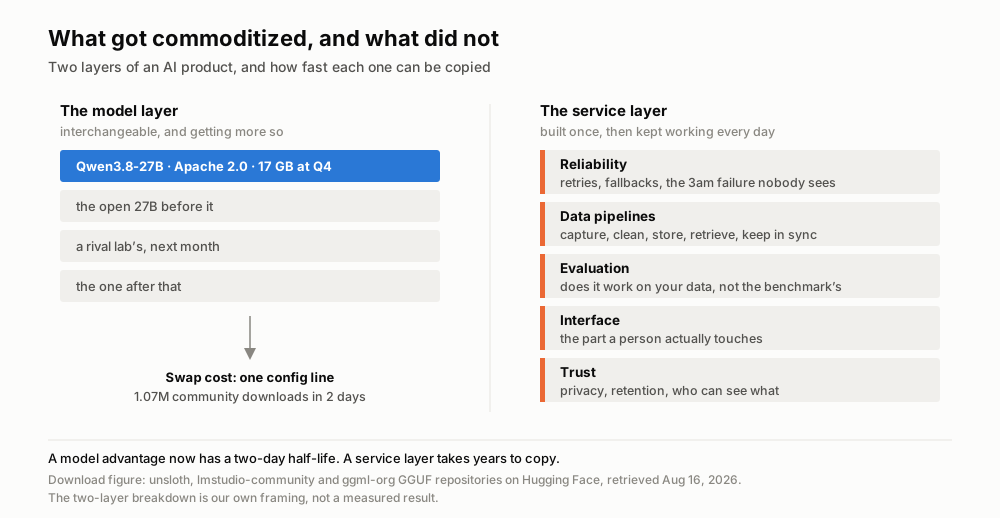
今週安くなった層と、安くならなかった層。ダウンロード数値は Hugging Face より2026年8月16日取得。2層の切り分けは私たちの見立てです。
ですから、優れたオープンモデルがノートPC に届いたことへの正しい反応は、「モデル企業が勝った」でも「プロダクト企業が負けた」でもありません。面白い仕事がスタックの一階下へ移った、ということです。真似するのがずっと難しく、記事にするのがずっと退屈な場所へ。
Telli.sh の立ち位置。 私たちはまさにそのサービス層を、オープンモデルの上に作っています。Telli.sh はすでに要約の経路でオープンな Qwen モデルを使っています。オープンモデルの品質が跳ねるたびに — 今回のものも含めて — その利得が会議の文字起こし、翻訳、要約へ直行し、みなさんの側の価格は変わらないということです。私たちが時間を使うのは、GGUF ファイルでは届かない部分です。音声を確実に捉え、話者を取り違えず、60分の録音を数か月後でも検索できるノートに変え、みなさんのデータがどこにあるかを明確にすることです。
出典
- Qwen3.8-27B モデルカードとライセンス、Hugging Face
- Qwen3.8-2.4T-A95B モデルカードとライセンス、Hugging Face
- unsloth/Qwen3.8-27B-GGUF の量子化ビルドとダウンロード数
- Ollama モデルライブラリの Qwen3.8
- Qwen3.8-27B 公開に関する Hacker News の議論 (2026年8月14日)
- Artificial Analysis の Qwen3.8 Max モデルページ
- Qwen (@Alibaba_Qwen) のオープンウェイト告知、X (2026年8月3日)
- llama.cpp リポジトリ、2023年3月10日作成
- Wikimedia Commons の画像ページ
