中国のオープンウェイト、3週間の疾走:Kimi K3、Qwen3.8-Max、そしてこの波を終わらせかねない逆転
この3週間で、中国の主要AIラボがフロンティア級のオープンウェイトモデルを公開、あるいは予告しました——Kimi K3、Qwen3.8-Max、そして正式提供に達したDeepSeek V4。それぞれが何なのか、何が実際に出て何がまだ約束なのか、そしてなぜ北京がいま自ら育てた波を規制しようとしているのかを、平易な言葉で読み解きます。
7月16日から26日にかけて、中国の主要AIラボ3社がフロンティア級のオープンモデルを相次いで公開しました。Moonshot AIは7月16日にKimi K3を発表し、7月26日に重みを公開。アリババは7月19日、上海のWAICでQwen3.8-Maxを披露。DeepSeekのV4ラインは7月20日ごろに正式提供(GA)へ到達しました。3つのラボ、およそ3週間です。
パターンははっきりしていて、しかもそれは中国のオープンモデル勢がこれまで築いてきた評判とは違います。これらのラボは、小さく速く安く、体格以上の働きをするモデルで知られていました。今回の波は正反対の賭けです。1兆パラメータ級のシステムを、公開した、あるいは公開すると約束したのです。
本稿はその波を率直に読み解きます。何が実際に出て、何がまだプレビューや約束にとどまっているのか。そして一緒に訪れた逆転——この公開を可能にしたまさにその政府が、いま規制すべきか否かを天秤にかけているという事実です。専門用語は最小限にとどめ、残りはその都度かみ砕いて説明します。「オープンウェイト」や「mixture-of-experts」が初めてでも話を追えるように。7月のまとめ記事をお読みなら、本稿はその続編であり、当時残した伏線のひとつが回収されました。
Image: OLCF at ORNL, Wikimedia Commons, CC BY 2.0.
まず、この話が腑に落ちる5つの考え方
この分野が初めてなら、5つの用語が話の大半を担います。モデルに入る前に、平易な言葉でひと息ぶん押さえておく価値があります。
「オープンウェイト」は、この波が重要である理由そのものです。モデルの重みとは、学習中に習得した巨大な数値の格子——いわば完成した脳です。ラボが重みを公開すると、あなたはそのファイルをダウンロードし、自分のハードウェアでモデルを動かし、手を加え、その上に製品を作れます。誰の許可も、リクエストごとの課金も要りません。対極にあるのがクローズドモデルです。多くの商用チャットボットのように、重みはベンダーのサーバーに閉じ込められ、あなたは有料APIでアクセス権を借ります。オープンウェイトはモデルを「借りて使うサービス」から「自分が複製を所有するもの」へと変え、良いモデルが出るたび業界全体が注目する理由がまさにこの違いです。
「パラメータ」とはその学習済みの数値であり、その数はモデルがどれだけ抱え込めるかの大まかな目安です。「2.8兆パラメータ」のモデルはそれが2.8兆個あるということ。大きければ自動的に良いわけではありませんが、フロンティアではたいてい推論の余地が大きいことを意味し——同じくらい重要なことに、動かすのに多くのハードウェアが要ることも意味します。そこで登場するのが「mixture-of-experts(MoE)」です。単語ごとに全パラメータを発火させる代わりに、MoEモデルはエキスパートと呼ばれる多数の専門サブネットワークに分かれ、ルーターがトークンごとにその一部だけを選びます。ですから「総2.8兆、アクティブ1,040億」とあれば、モデルは巨大でも、ある瞬間に実際に働くのは約1,040億パラメータだけという意味です——数千人の専門医を抱えつつ、患者ごとに関係する数名だけが診る病院のように。総数はどれだけ有能になり得るかを示し、アクティブ数は提供コストがどれだけかかるかを教えます。この差こそ、コストを判断する最も有用な数字です。
「コンテキストウィンドウ」は、モデルが一度に頭の中に保てるテキストの量で、トークンで数えます——トークンひとつは単語のおよそ4分の3です。100万トークンの窓は抽象的な仕様ではありません。長編小説を数冊、あるいは1時間の会議書き起こしを数十本、一度に取り込めるということです。メール1通を要約するのと、四半期分のメール全体を踏まえて推論するのとの違いです。
最後にライセンス——そしてこれこそ、実務者がベンチマークより先に読むべき部分です。ライセンスは、重みで何をしてよいかを定める法的な細字です。MITは金字塔です。使い、改変し、商用製品に載せて出しても、何も負いません。カスタムライセンスは開いて見えつつ、あなたが狙っていたまさにその用途を除外していることがあります——たとえば、その上に築いた事業が大きくなると課金する、といった具合に。2つのモデルがどちらも「オープンウェイト」でありながら、法的に何が許されるかは天と地ほど違うことがあります。ですからスコアに惚れる前に、この一行を先に読むのが得策です。この5つの考え方を手にすれば、波はくっきりと読めます。
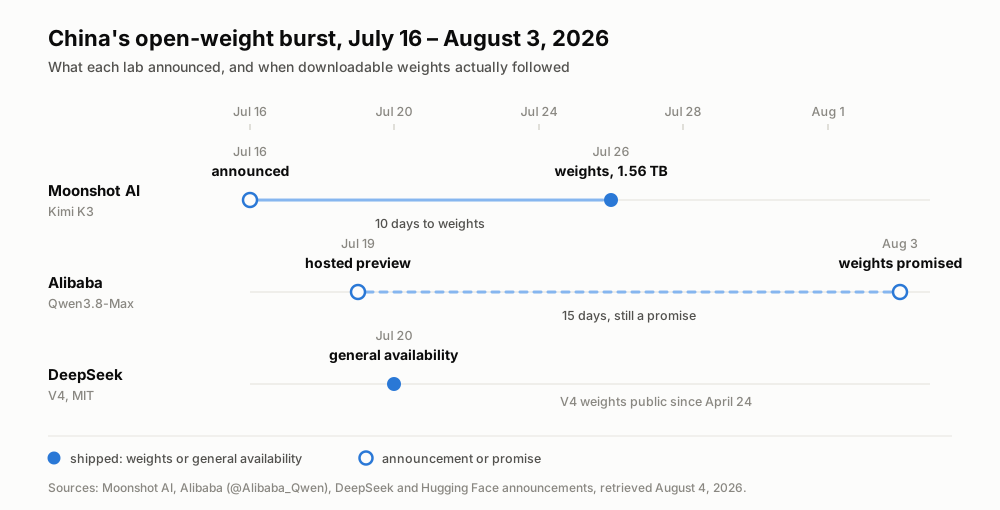
ラボ3つ、3週間 — そしてこの5つの出来事のうち、実際に重みを手元へ届けたのは2つだけです。日付は各ラボの公式発表に基づき、2026年8月4日に確認しました。
実際に出たのはKimi K3だ
まずMoonshot AIから。Kimiアシスタントを手がける北京のラボで、この一年、大きく有能なオープンモデルで評判を築いてきました。7月にKimi K3を取り上げたとき、重みはまだ約束にすぎませんでした。Moonshotは「7月27日までに」と言っていました。その重みが7月26日に届いたのです。Hugging Faceのmoonshotai/Kimi-K3に、96シャードに分かれた1.56テラバイト。これがニュースの核心です。発表はプレスリリースですが、ダウンロードできる重みは、その上に何かを築ける「事実」です。
平たく言えば、K3はこれまで公開された中でも最大級のオープンモデルです。総2.8兆パラメータ、トークンあたりのアクティブ約1,040億のmixture-of-expertsで、Moonshotが「Kimi Delta Attention」と呼ぶ仕組みで896のエキスパートのうち約16をルーティングし、100万トークンのコンテキストウィンドウを備え、前身のK2比で約2.5倍のスケーリング効率向上が報告されています。仕様書を脱いで言い換えると、非常に大きいが、トークンごとに一部しか発火しないので規模のわりに比較的安く動かせ、書籍1冊分の入力をまるごと飲み込めます。
これらの数字は、実際に誰が動かすかも教えてくれます。96シャードに分かれた1.56テラバイトはノートPCのダウンロードではありません。読み込むだけでも高性能アクセラレータのクラスターが要る、データセンター級の産物です。実際には個人がK3を自前でホストすることはほぼなく、すでにハードウェアを持つプロバイダー経由で触れることになります。そしてその市場は初日に到来しました。Together AIとModalはいずれも、重みが落ちた瞬間にKimi K3のホスティングエンドポイントを立ち上げました。好奇心ある読者が今日これを試す方法もこれです——1.56TBをダウンロードするのではなく、そうしたホスティングエンドポイントを呼ぶか、Kimiアプリを使うのです。ここでの「オープン」は、重みが公開され、ハードウェアを持つ誰もが提供できるという意味であり、それこそが価格競争を保ちます。あなた自身が机の上で動かすという意味ではありません。
出来はどうでしょう。今回、私たちが信頼する唯一の独立数値で言えば、良いです。Artificial Analysisのランキングで189モデル中4位——Claude Fable 5と2種類のGPT-5.6「Sol」構成の後、Opus 4.8とGPT-5.5の前です。ダウンロードできるオープンモデルがその顔ぶれに並ぶこと自体が、ひとつの物語です。
そのうえでライセンスを読んでください。ここで「オープン」に注釈がつくからです。Kimi K3はMITではありません。OSI承認を受けていない独自の「Kimi K3 License」で配布され、売上高のしきい値条項がついています。K3を大規模なModel-as-a-Serviceの基盤として動かすなら、Moonshotとの個別契約が必要です。個人開発者や、社内利用の普通の企業には何も変わりません。しかし大規模なホスティング製品を作る側にとって、「オープンな重み」と「オープンなライセンス」は別の問いであり、ここで明確に「はい」と言えるのは前者だけです。
Qwen3.8-Maxはダウンロードではなくプレビューだ
Qwenはアリババのモデルファミリーで、そのチームは世界でも屈指のオープンモデル量産勢です——その履歴こそ、最新作をややこしくしています。7月19日に上海のWAICで披露されたQwen3.8-Maxは、この波で最大の見出しであり、最も柔らかい見出しでもあります。2.4兆パラメータのスパースMoE——アクティブパラメータは非公開——で、テキストだけでなく画像・動画・文書を入力に取る、1兆パラメータを超えた初のマルチモーダルQwenです。
初心者に明かしておくべき落とし穴はこれです。華々しさとは裏腹に、ダウンロードはできません。いまは「ホスティングプレビュー」としてのみ存在します——qwen3.8-max-previewとして、アリババ自身のサービス(Token PlanとQoderツール)経由で標準比およそ10%の価格で触れられます。ホスティングプレビューとは、アリババが自社サーバーでモデルを動かし、あなたに呼ばせるという意味。「借りるAPI」型であって、「複製を所有する」型ではありません。今日これをオープンウェイトの公開と呼ぶのは時期尚早です。
この構図は8月3日に変わりました。Qwenの公式Xアカウント@Alibaba_Qwenが、Qwen3.8-Maxの重みが「来週」公開され——より小さいQwen3.8-27Bも一緒にオープンウェイト化される、と投稿したのです。ですから27Bは噂ではありません。先の雑音が何であれ、これはアリババ自身のアカウントによる公式の約束です。そして肝心なのはサイズです。2.4兆パラメータのMaxはK3同様データセンターでしか動かせない代物ですが、27Bは高性能マシン1台で提供できるほど小さい——個人や小さなチームが実際に自前でホストできる体格です。これは「具体策なしに約束しただけ」という構図を実際に和らげます。いまやサイズがあり、おおよその時期もあります。
とはいえ、正直な但し書きはなお有効です。「来週」は方向であって出荷日ではなく、本稿を書いている8月4日時点でQwenのHugging Face組織には何も上がっていません——そこにある最新モデルは6月のものです。オープンウェイトのライセンスもまだ公開されておらず、プレビュー規約を先に読んだ人々は地域制限の可能性を指摘しています。本物のライセンスが出るまでは未確認の話です——まさに冒頭のライセンス優先の教訓どおりです。このモデルが「Fable 5に次ぐ2位」だという同社の主張も、依然として第三者の数値を欠く自己申告なので、アリババの外の誰かが測定するまではベンダーのマーケティング文句として受け取るのが賢明です。今日このモデルを試したいなら、ホスティングプレビューが唯一の扉です——しかし初めて、ダウンロードできる重みを待つ時間が「いつか」ではなく「来週」で測れるようになりました。
DeepSeek V4は静かに正式提供へ達した
DeepSeekは、2025年初頭に現在のオープンモデル競争に火をつけたR1モデルのラボであり、その流儀どおり、今回も最も告知が少なく、最も使えるものを出しました。4月24日に公開されたV4ラインは、最も素直に採用できるモデルです。冒頭の基礎説明で金字塔と挙げた、まさにそのライセンスを掲げて出てくるからです。
V4は2つのサイズで登場し、どちらもMITです。V4-Proは総1.6兆・アクティブ490億パラメータのフラッグシップ、V4-Flashは総2,840億・アクティブ130億の軽量版。アクティブ数の意味を思い出してください。V4-Flashはトークンあたり130億パラメータしか発火しないので、提供が安く速い。それが、トークンあたりコストが全てを決める大量処理——大規模な書き起こしと要約の負荷——での「コスパの選択肢」にしています。どちらも100万トークンのコンテキストウィンドウを備え、1回の応答で最大384Kトークンを生成できます。1段落ではなく長い報告書を下書きできる分量です。7月20日ごろ、V4は時間ベースの料金で正式提供に達し、春の公開をK3・Qwenと同じ3週間の枠内に引き込んだのがこの点です。
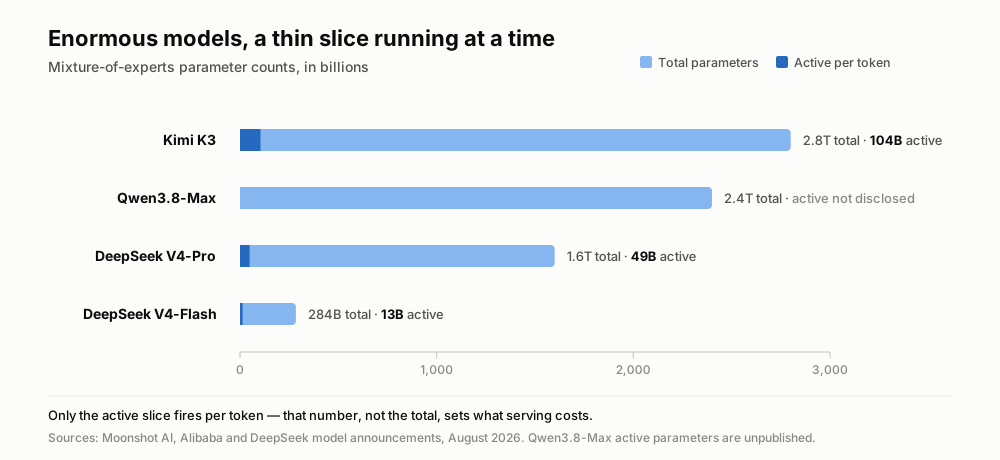
淡いバーはモデルの大きさ、濃い部分はトークンごとに実際に動く量です。アリババはQwen3.8-Maxのアクティブパラメータを公表していません。
MITだからこそ、V4は最も弁護士の要らないモデルです。重みを入手(またはホスティングプロバイダーを利用)して動かし、商用に出し、何も負わず誰にも尋ねずに済みます。そしてバージョン番号についてはっきりさせておくと——噂はこれを好みますが——R2も、V5も、V4.1もありません。ただV4系が、チームが頼れる何かへ成熟しただけです。
差はリーダーボードが認めるより速く縮んでいる
一歩引くと、個々の公開よりも「傾き」が重要になります。Nathan Lambertの見立てでは、最良のオープンモデルと最良のクローズドモデルの距離は、約6〜9か月から3〜5か月へと縮んだといいます——「DeepSeek R1以降、オープンモデルがフロンティアに最も近づいた時点」です。平たく言えば、無料でダウンロードできるモデルが、いまや金で借りられる最良のモデルにわずか数か月遅れというところで、1年前はゆったり一周遅れだったのです。
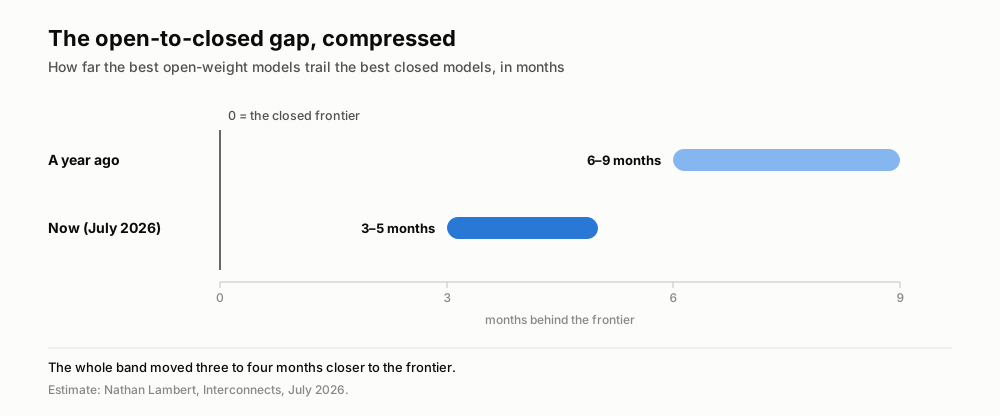
Lambertの見立てを実際の目盛りで描いたものです。オープン勢は近づいただけでなく、幅そのものが狭まりました。
利用データも同じ方向を指します。多くのモデルへリクエストを振り分けるマーケットプレイス、OpenRouterでは、米国発モデルのトークンシェアが2025年6月の約70%から1年後には約30%へ下がり、中国発モデルはいまや常時30%を超えています。価格が大きな理由です。中国のオープンモデルはトークンあたり60〜90%安い傾向があり、ホスティングもすぐに現れました。初日に立ったK3のエンドポイントがそれを如実に示しました。
より静かな変化は規模に関するものです。中国オープンモデルのブランドは、小さく・速く・安いでした。2.8兆パラメータのK3と2.4兆パラメータのQwen3.8-Maxはその正反対——オープンで大きく行くことが、いまや割に合うという賭けです。6月16日にMITで公開され、Artificial Analysis Indexで51点とオープンウェイト部門の首位に立つZ.aiのGLM-5.2も、4つ目のラボが発する同じメッセージです。
逆転:この波を可能にした政府が、いま規制しようとしている
そして局面が変わりました。7月22〜25日ごろ、Financial TimesとReutersは、中国の商務部がオープンウェイトLLMを含むAIモデルの輸出規制を検討していると報じました——アリババ、ByteDance、Z.aiが協議に含まれているとされます。取り沙汰されている枠組みは階層型です。弱いモデルには届け出義務、強いモデルには安全審査、最も強力なモデルには公開そのものの禁止の可能性。まだ法制化されたものはありません。ですが方向性は際立っています。この波は、自らを生んだ政府がこれらのモデルをオープンな貢献ではなく戦略的な輸出品として扱い始めた、まさにその瞬間に頂点を迎えているのかもしれません。
おわりに:開かれたものが戦略資産になるまで
きれいな物語は「中国が追いついた」です。より正確な物語は、オープンな重みが戦略資産になる速度が速すぎて、いまや政府がその蛇口に手をかけようとしている、というものです。3週間のうちに、オープンモデルはフロンティアに2〜3四半期遅れの状態から1四半期遅れへと縮め——小さく安いものから、どんな形であれ公開された中で最大級のモデルへと変わりました。オープンなフロンティアは、ただ動いただけではありません。作り手がこの先も出し続けられるとは限らない場所へ動いたのです。
これらのモデルの上に何かを作るチームにとって、実務的な結論は変わらず、少しだけ鋭くなりました。Telli.shはすでに要約レイヤーにオープンモデルQwen3を使っており、オープンモデルの品質と価格が良くなるたび、その利得は会議の文字起こし・翻訳・要約へと直に流れ込みます。新たに加わった項目は「供給」です。報じられたとおりに中国の輸出規則が固まれば、どのオープンモデルが自由にダウンロードできる状態を保つのかは、当然視するのではなく注視すべき問題です。レイヤーを支えるモデルが良くなるのは趨勢であり、そのモデルがどこから来られるのかは、目を離さずにおくべき点です。
出典
- Simon Willison on Kimi K3 weights (July 27, 2026)
- Nathan Lambert, "Kimi K3: the open-weights escalation" (Interconnects, July 20, 2026)
- Kimi K3 announcement (Moonshot AI)
- Kimi K3 weights on Hugging Face
- Artificial Analysis on Kimi K3
- Qwen (@Alibaba_Qwen), Qwen3.8-Max & Qwen3.8-27B open-weights announcement on X (Aug 3, 2026)
- Latent Space / AINews, "Qwen 3.8 Max (2.4T) and 27B, new open weights models" (Aug 4, 2026)
- WinBuzzer on DeepSeek V4 (April 27, 2026)
- The Decoder on Chinese open-model adoption
- Tom's Hardware on China's proposed AI export controls (July 2026)
- Wikimedia Commons image page
