3日間でフロンティアモデルが4本、しかしどれが必要だったかは誰も教えてくれない
2026年9月1日から3日にかけて、Anthropic、Meta、Google、OpenAIがそろってフロンティアモデルを出荷し、CNBCはそこで生じた疲弊に名前を与えた。モデル疲れである。リリース本数は退屈な部分にすぎない。興味深いのは、リリースのひとつひとつが下流の誰かに必ず走らせる評価を生むこと、そしてモデルを出す企業にはその評価を省かせる理由が一切ないことだ。モデル差し替えが実際にいくらかかるのか、なぜトークン単価の安さがタスク単価の安さにならないのか、そしてなぜ狭い仕事ひとつのために作られたフルマネージドのソフトウェアだけが、他人に判断を代わってもらえる形式なのかを検討する。
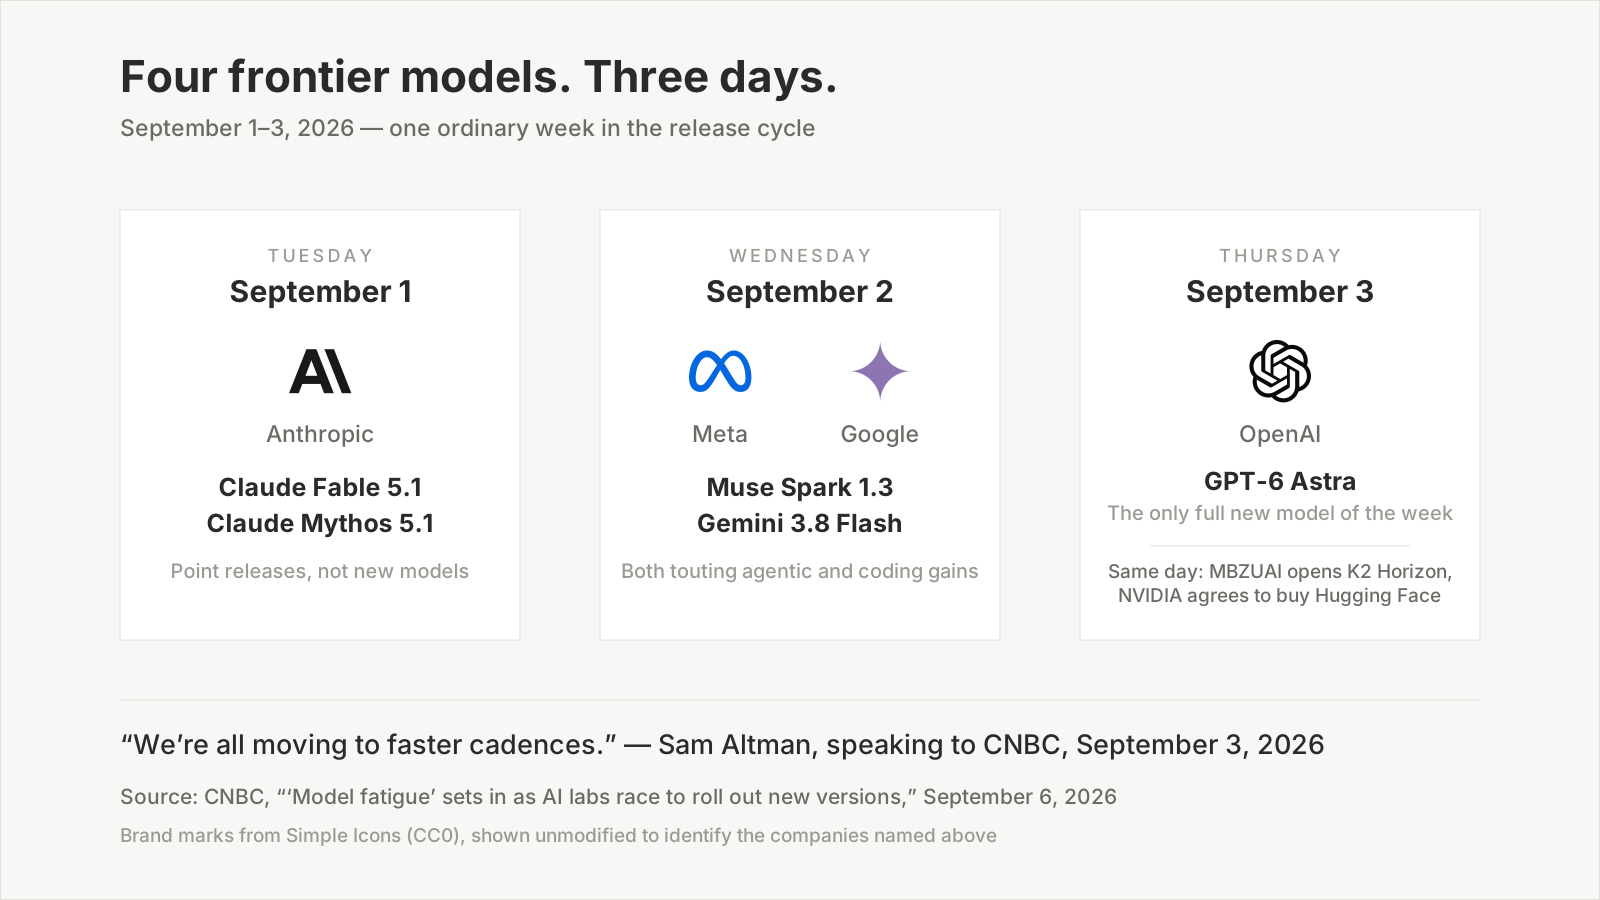
ブランドマークは Simple Icons(CC0)。言及した企業を識別する目的で、改変せずに掲載しています。リリース日とAltman氏の発言は2026年9月6日のCNBC報道に基づきます。
2026年9月第1週の火曜から木曜にかけて、AnthropicはClaude Fable 5.1とClaude Mythos 5.1を、MetaはMuse Spark 1.3を、GoogleはGemini 3.8 Flashを、OpenAIは GPT-6 Astra を出荷しました。同じ木曜日には、アブダビのモハメド・ビン・ザイード人工知能大学(MBZUAI)がK2 Horizonファミリーを世界に公開し、NVIDIAは Hugging Faceの買収 に12,930,300,000ドルを支払うことで合意しました。
発表6件。3日間。CNBCは9月6日日曜日、数週間前から実務者のあいだで流通していた表現を掲げてこの記事を出しました。モデル疲れです。
わかりやすい読み方は、業界が誰も追随できない速度で動いている、というものです。正しく、そしてほぼ退屈な読み方です。注意を払う価値があるのはこちらです。リリースはひとつひとつがコストを移転させ、その移転はきっかり一方向にしか流れません。研究所が出すモデルはすべて、下流の誰かが走らせる評価になります。そして上流の誰にも、その評価を省かせる理由はまったくありません。
TL;DR
- 3日間でフロンティアリリースが4本(2026年9月1〜3日)。CNBCは9月6日、そこで生じた疲弊を「モデル疲れ」と名づけました。
- 本当のコストは注意力ではなく評価の労力です。あるエンタープライズCEOはCNBCに、あるタスクのために10のモデルを評価したくても、実際に試すのは5つ程度だと語りました。
- トークン単価はタスク単価の代理指標として不適切です。強く高価なモデルのほうが手数を減らして難しい仕事を安く終えることがあります。
- モデルベンダーには、より安いモデルで足りる場面を教える構造的な理由がありません。その空白こそが、マネージドで目的特化のソフトウェアが存在する理由のすべてです。
モデル疲れは9月6日に名前を得た
「モデル疲れは実在すると思います」。AIインフラのスタートアップRunpodのCEO、Zhen Lu氏はCNBCにそう語りました。「誤解しないでほしいのですが、いま起きているイノベーションのすべてに私はきわめて興奮しています。ただ、いまは泡立ちが多すぎて、音を立てざるをえない環境にあると本当に思うのです」
Sam Altman氏は同じ週、CNBCにもう少し穏やかな見方を示しました。「私たちは皆、より速いケイデンスに移行している」と述べ、加速の一部を、皆が「夏休みから戻ってきた」ことに帰しています。
どちらも成り立ちます。ケイデンスは実際に加速しており、その加速には実際に演出が混じっています。AI分野で25年の経験を持つノートルダム大学メンドーサ経営大学院のAhmed Abbasi教授は、商業的な論理をそのまま述べました。研究所は「そろって財布のシェア争いをしている」のだ、と。株式公開に向かうAnthropicとOpenAIがもっとも強く押しており、両社はすでに未公開の投資家から1兆ドル近い評価を受けています。
問題の財布は巨大です。Gartnerは2026年5月、世界のAI支出が今年2兆5,900億ドルに達し、2025年から47%増えると予測しました。最大の取り分はインフラですが、そのうち1兆ドルをはるかに超える額がサービス、ソフトウェア、セキュリティ、モデル、ツールに向かいます。つまり、誰かが下さなければならない判断に向かいます。
ここが要点です。それほど大きく、それほど速く伸びる市場は、声の大きさに報います。もっと少ないもので足りると顧客に伝えることには報いません。
コストは注意力ではない。終えられない評価だ
実務者にモデル疲れが実際どう感じられるかを尋ねると、「リリース記事を読みすぎる」という答えは返ってきません。返ってくるのは算数です。
エンタープライズAIのスタートアップClockwork SystemsのCEO、Suresh Vasudevan氏は、この記事全体でもっとも有用な数字をCNBCに示しました。あるタスクのためにAIモデルを10評価したくても、実際には5つを選ぶだけになるかもしれない、と。「いま出てくるものを一つひとつ評価しに行くのは、本当に難しいのです」
この比率の前で少し立ち止まってください。この主題全体を支える事実だからです。事業そのものがエンタープライズAIで、これを職業として行う人員がおり、まさにこの目的のために配分された計算予算まである会社が、自ら評価に値すると考えた候補の半分しか評価していません。
残る半分を試されなかった五つと呼ぶことにします。却下されたのではありません。誰も不足を見つけたわけではありません。ただ一度も走らせていないだけであり、そのどれかがあなた固有のワークロードでより速かったか、より安かったか、より正確だったかという問いは、永久に開いたまま残ります。リリースのある週ごとに、その山は高くなります。
そして、その山を片づけるのは高くつきます。モデルの差し替えはバージョン更新ではなく、再認定だからです。新しいモデルが本番に届くまでに実際に起きなければならないことは、次のとおりです。
| 再確認が必要なもの | 新しいモデルがそれを壊す理由 |
|---|---|
| プロンプトとシステム指示 | 旧モデルの癖に合わせて調整されている。あるモデルを確実に導いた言い回しが、別のモデルを別の場所へ導きます |
| 出力フォーマットの安定性 | 下流のパーサーはJSON、見出し、区切り文字といった形に依存しますが、書式の癖はモデル間で変わります |
| 実データでの精度 | ベンチマーク差は公開データセットで測られたものであり、あなたの会議、あなたのチケット、あなたのコードベースで測られたものではありません |
| ツールとAPIの挙動 | エージェント型のモデルは、いつ呼ぶか、何度リトライするか、呼び出しが失敗したとき何をするかが異なります |
| 負荷時のレイテンシとスループット | 単発のリクエストで速いモデルが、あなたのレート制限の背後では遅くなることがあります |
| あなたのボリュームでの総コスト | トークン単価 × 消費トークン × 試行回数。後述します |
| 安全性と拒否の挙動 | 境界線はバージョンをまたいで両方向に動きます |
| リグレッションのケース | すでに直したはずの具体的な失敗。他人のベンチマークが知るはずのないもの |
8カテゴリ、それぞれに実例と比較実行と誰かの判断が必要です。設定変更ではなくプロジェクトです。これに、その月のフロンティアリリース本数を掛ければ、10対5という比率の理由は明白になります。
リーダーボードを信じる代わりに 自分のワークロードで測る方法 については別に一本書きましたが、正直な要約は、きちんとやるなら数時間ではなく数日かかる、というものです。
トークン単価が安くてもタスク単価は安くない
この話全体でもっとも直観に反する発見は、研究所からではなく、その選択を自動化しようとしたエンジニアから出てきました。
オープンソースのAIゲートウェイLiteLLMのプロダクトエンジニア、Moe Khalil氏は9月4日、「Model Fatigue is Real」と題した記事を公開しました。彼はLiteLLMの自動ルーター、つまりあなたの代わりにモデルを選ぶことが仕事のすべてであるソフトウェアを手がけており、その所属を冒頭で開示しています。この主題について書く多くの人より誠実な態度です。
チームの出発点の仮定は直観的なものでした。同じタスクを解ける2つのモデルがあるとき、モデルカード上のトークン単価が半分のほうが、およそ半分の値段でそれを解くはずだ、と。
テストが示したのはそれではありませんでした。より強く、より高価なモデルが、より難しいタスクを、安いモデルのコストのごく一部で解いていたのです。Khalil氏の説明はこうです。「賢いがゆえに賢いアプローチを取り、完成品まではるかに速くたどり着いたのです」
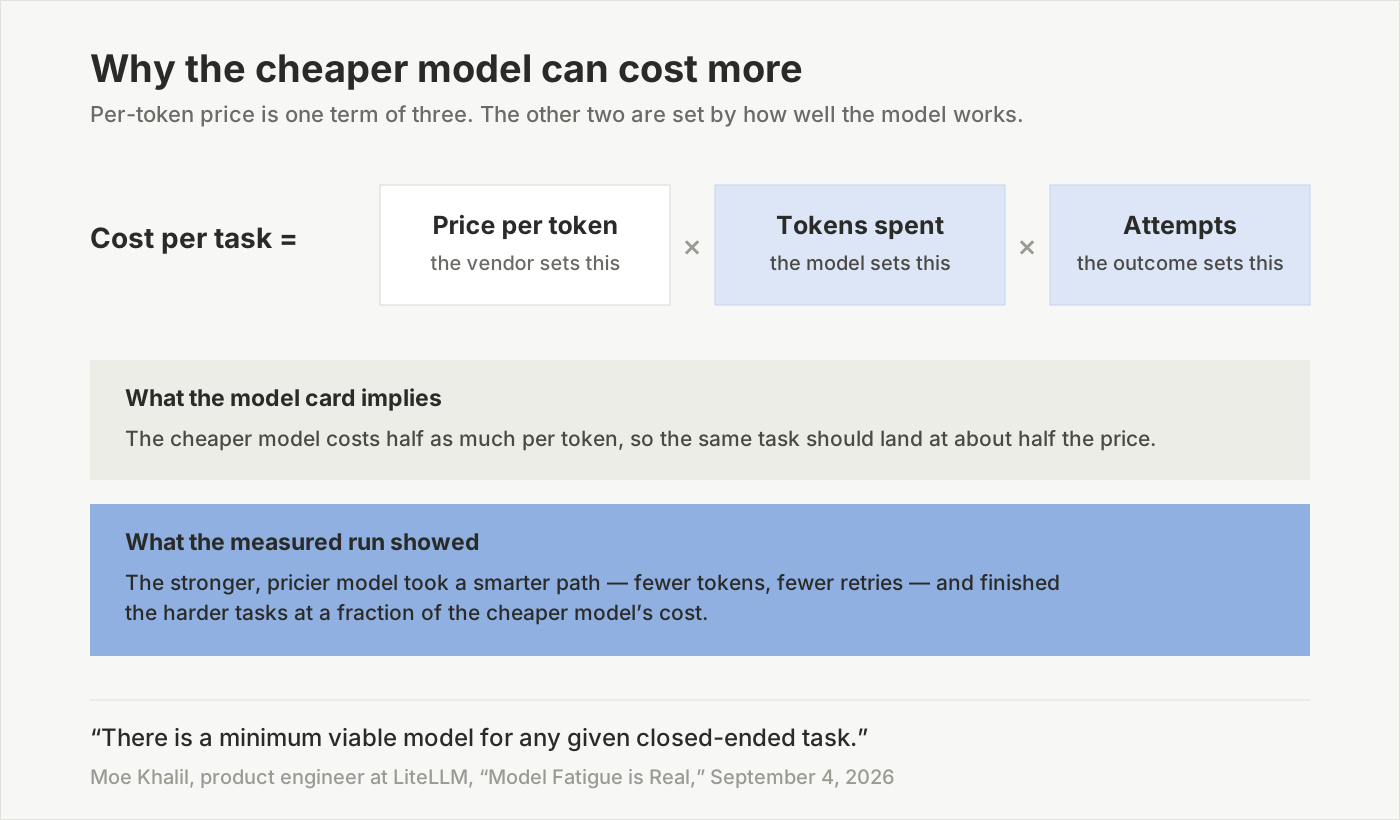
3つの項のうち価格表に載るのはトークン単価だけです。残る2つはモデルの実力の属性であり、仕事を実際に走らせて初めて姿を現します。
これは価格表の意味を根本から変えます。ベンダーが掲げる数字は、3項の積のうちの1項にすぎません。トークン単価、消費トークン、そしてタスクが実際に成功するまでの試行回数です。1つ目はベンダーが決めます。2つ目と3つ目はモデル自身が決め、どちらもあなた自身の仕事を通してみるまでわかりません。
つまり、するように教えられてきた比較、価格の列を眺めて安いほうを選ぶという比較は、単に不完全なだけではありません。実際のタスクでは逆方向を指しうるのです。
上流には教える動機がない
続けてKhalil氏は、皆が飲み込む部分を口にします。この主題について今年書かれたもっとも鋭い一文です。
「モデル企業にとって、この怠惰はバグではなく機能です。彼らは私がメールを要約するのにも[最上位モデル]を使うことを好みますし、より安いモデルで同じように済むときにそれを教える動機はありません。彼らの仕事はフロンティアを押し広げ続けることです。いつフロンティアを使わないかを見極める仕事は、私に残されます」
Gartnerの数字を念頭に、もう一度読んでください。2兆5,900億ドルの市場が年47%で成長し、そのなかで供給側は、すべての顧客が上位を既定値にすることで利益を得て、顧客が使いすぎても何の負担も負いません。
陰謀ではありませんし、誰かが悪く振る舞う必要もありません。インセンティブの勾配がそういう形をしている、というだけです。フロンティア研究所の仕事はフロンティアを動かすことです。昨年の中位モデルであなたのワークロードの80%が処理できると伝えるのは別の誰かの仕事であり、最近までは誰の仕事でもありませんでした。
Abbasi氏の2つ目の指摘もここに置かれます。主要な開発元がそろって同じ週に発表したのは「偶然ではない」と彼は述べ、AI金融スタートアップFarsightの技術責任者Noah Faro氏も同意しました。競合は互いの計画を、ある程度はクラウドの計算資源の空き状況から読み取っている、と付け加えています。全員が同じ少数のベンダーの容量を奪い合っているからです。Faro氏は熱を冷ます指摘もしました。GPT-6 Astraと違い、その週のAnthropic、Meta、Googleの発表はポイントリリース、つまり新しいモデルではなく既存モデルのアップグレードだった、と。彼の評価では、本当に潮目を変えた直近の2本は6月のAnthropicのFable 5と7月のMoonshot AIのKimi K3です。
まとめれば、発表6件、真に新しいフロンティアモデル1本、そして下流の全員に生じた評価サイクル1周分の仕事です。
業界がこれを吸収する2つの道、そして両者は同じではない
研究所が判断を下さないなら、誰かが下さなければなりません。答えは2つ現れており、両者は構造的に異なります。
水平方向の答えはルーティングです。 LiteLLMのようなゲートウェイは、あらゆるモデルを1本のAPIキーの後ろに置き、リクエストごとに選ぼうとします。Khalil氏は技術的な問題を正確に記述しています。閉じたタスクには最小実行可能モデル、つまりそれでも成功する最安のモデルが存在し、難しいのは、タスクを走らせる前にそれがどれかを予測することだ、と。チームの現時点での最良の方法は、公開ベンチマークのデータとプロンプト内のヒューリスティクスから推定するもので、LLMによる分類やハイブリッドも試しています。彼自身の評価はこうです。「どれもまだ不完全ですが、何もないよりは一段まし、です」
ルーティングは本物のエンジニアリングであり、役に立ちます。ただし、それが何を動かし何を動かさないかを見てください。ルーティングが吸収するのは配管です。鍵ひとつ、インターフェースひとつ、新しいモデルへの自動的なアクセス。しかし説明責任は吸収しません。ルーターが選び損ねたとき、その悪い出力はやはりあなたのものであり、あなたのプロダクトのなかにあり、あなたのユーザーの目の前にあります。答えがよかったかどうかの評価は、依然としてあなたのものです。
垂直方向の答えは、ひとつの仕事のために作られたフルマネージドのソフトウェアです。 ここではベンダーはあなたに代わってモデル間をルーティングしません。タスクそのものを丸ごと引き取り、完成した結果を届けます。あなたはモデル名を見ません。文字起こし、要約、翻訳、提出済みの経費精算書を見ます。
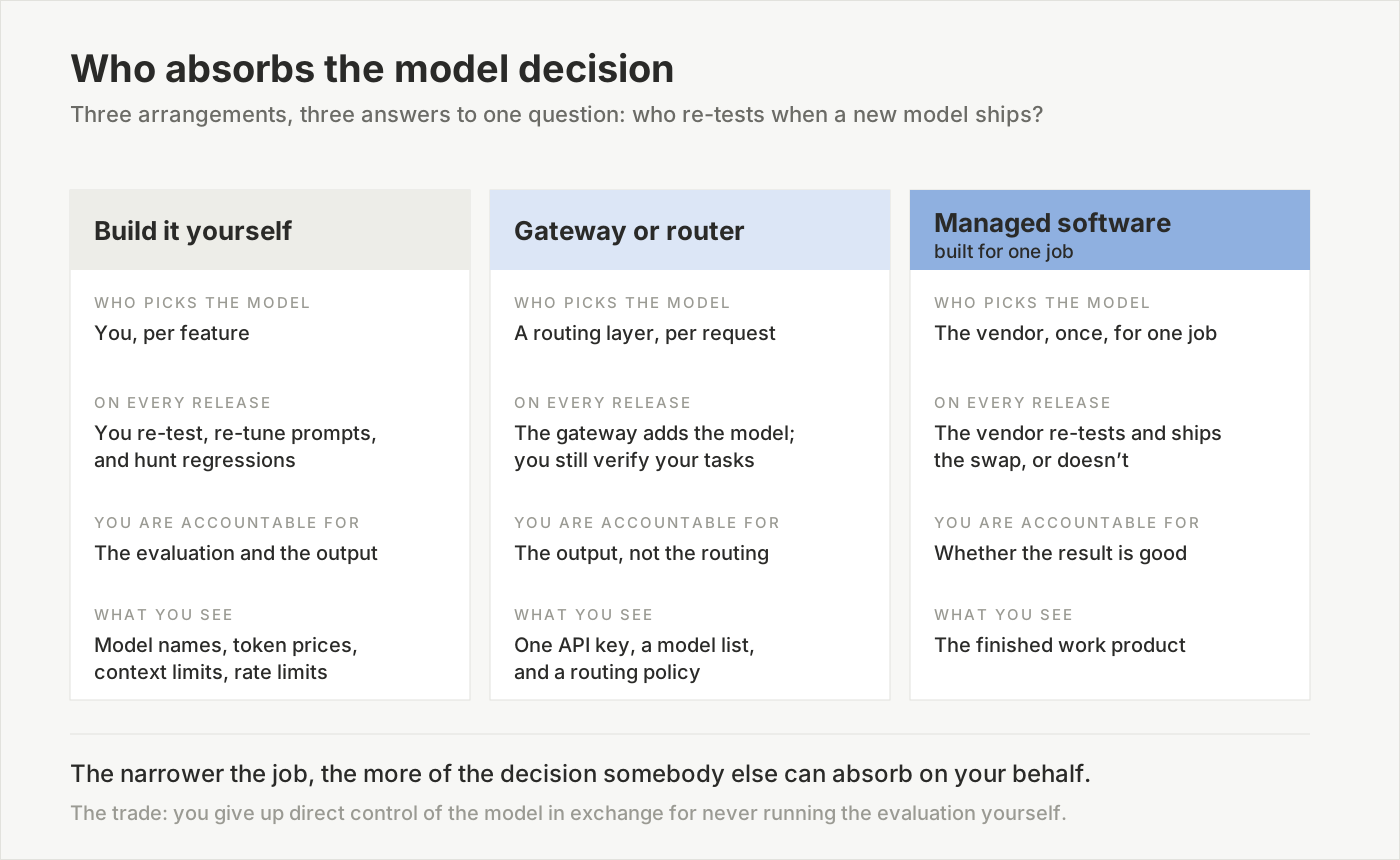
右へ行くほど、あなたに残る判断は減り、そのぶんベンダーが評価を誠実に行ったかどうかに依存することになります。
ローカルAIのコミュニティは、正反対の方向から似た結論に至りました。今年発表されたある分析は、小型モデルのシーンをランニングマシンにたとえています。ダウンロードし、設定し、プロンプトをいくつか走らせ、なかば判断し、次のリリースへ移る、というものです。その提言は、やめること。実績のあるデイリードライバー構成ひとつに標準化し、新しいモデルは、実際に代表的なタスクで十分に長く試して自分のワークロードに本当に優れていると確認できてから採用せよ、というものでした。GPU2枚の趣味人と、計算予算を持つCEOが、同じ結論にたどり着いています。一度、きちんと選び、毎週木曜のたびに蒸し返すのはやめる。
狭い仕事だからこそ、判断を引き取れる
ここからが私たちの見解であり、このカテゴリが存在する理由そのものです。
モデルの判断は、そのタスクを知っている者にしか下せません。当たり前に聞こえます。当たり前ではありません。この一文はほとんど全員を除外するからです。
汎用のチャットインターフェースはあなたの代わりに判断できません。どの朝であっても、ソネットを書けと言われるかもしれず、競合状態をデバッグしろと言われるかもしれず、賃貸借契約を要約しろと言われるかもしれないからです。「ユーザーが次に打ち込むもの何でも」に最小実行可能モデルは存在しません。唯一安全な既定値は、手に入る最強のモデルです。それはまさにベンダーの利益にかなう既定値であり、Khalil氏が、誰にも思いとどまらせる動機がないと述べたその既定値です。
ゲートウェイはプロンプトを見るので、もう少しましな推測ができます。ただし、あなたの領域でよい答えがどう見えるかの知識なしにプロンプトを見ており、外しても払う代償がありません。
目的特化のマネージドソフトウェアは、まったく別の位置にいます。仕事が固定されているとき、たとえば日本語と英語を行き来する4人の話者による60分の会議を文字起こしし、アクションアイテムを作るというように固定されているとき、そのタスクはまさにKhalil氏の意味で閉じています。最小実行可能モデルが存在します。そして決定的なことに、その仕事を持つすべての顧客にとって、最小実行可能モデルは同じです。つまり評価は一度走らせればよく、そのコストは全員に按分されます。
このカテゴリの経済的な論拠はそれで全部であり、規則として書き留める価値があります。仕事が狭いほど、モデルの判断を他人が代わりに引き受けられる範囲は広くなる。 ひとつのワークロードを担うベンダーは、候補10をすべて試す余裕があります。数千の顧客のために、よい結果の固定された定義に照らして、一度だけ試すからです。あなたが一人で、自ら考案しなければならない定義に照らして5つを試すのは、より悪い答えを得るための高くつくやり方です。
この取引は実在し、正直に名指しする価値があります。あなたは、どのモデルが自分の仕事を走らせるかの直接の統制を手放します。引き換えに、評価を走らせるのをやめ、リリースカレンダーを追うのをやめ、判断の対象は出力になります。もともとあなたが本当に気にしていた唯一のものです。
いま買おうとしているのがどちらかを見分ける
次のAI購入の前に、順番に4つの問いです。
- その仕事は閉じているか。 正しい出力がどう見えるかを一文で言えますか。言えるなら、マネージドな垂直ツールが判断を引き取れます。答えが「何を頼むかによる」なら、あなたが買うのは汎用モデルであり、評価はあなたに残ります。
- 新しいモデルが出たとき、誰が再テストするのか。 ベンダーに直接尋ねてください。マネージドのベンダーなら、自社の評価セットと差し替えのプロセスを説明できるはずです。答えが「最新のモデルにアクセスできます」なら、あなたが買ったのは配管であって判断ではありません。
- 見えるのはモデルか、結果か。 プロダクトがモデル名、コンテキストウィンドウ、トークン価格を前面に出すなら、判断をあなたに返しています。それも正当なプロダクトですが、価格はそれに見合って評価してください。
- あなたのボリュームでの総コストはいくらか。 トークン単価 × あなたの仕事で実際に消費されるトークン × 正解に至るまでの試行回数。自分のタスクを走らせてください。価格表はこの問いに答えられません。
結論:フロンティアは判断ではなく既定値だ
モデル疲れはたいてい注意力の問題として語られます。ニュースが多すぎ、速すぎる、と。違います。テクノロジー業界でもっとも速く伸びる市場が静かに顧客側へ移した、値付けもされず、ほとんど測られてもいないコストです。
研究所は出荷を続けます。出荷が仕事であり、市場がそれに支払うからです。評価の負担は増え続けます。リリースごとに機械的に増えるからです。そして大半のチームは、忙しいチームに可能な唯一のやり方でこれを片づけます。最も新しく、最も大きく、最も高価なモデルに手を伸ばすという、会議で誰も弁護しなくてよい唯一の選択肢です。
仕事を丸ごと引き取り、モデル名を最後まで見せないソフトウェアはすべて、そのやり方は事業の回し方として悪い、という賭けです。リリースのある週ごとに、この賭けは分がよく見えます。
Telli.shの位置: 私たちが作っているのは、まさにこのカテゴリです。Telli.shは会議を録音し、話者を分離し、15言語をリアルタイムで翻訳し、要約とアクションアイテムを作ります。そして、どのモデルを使うかを決して尋ねません。それは私たちの仕事であって、あなたの仕事ではないからです。ブラウザ拡張機能では、完全オンデバイスの選択肢を含む9つの翻訳エンジンを提供しています。その統制を本当に望む方がいるからです。会議プロダクトは意図的にそうしていません。「この会議をうまく文字起こしする」は閉じたタスクであり、私たちは背後のモデルではなく文字起こしそのもので評価されたいからです。
出典
- CNBC, "'Model fatigue' sets in as AI labs race to roll out new versions at dizzying pace," 2026年9月6日 — 2026年9月1〜3日のリリース年表、Zhen Lu氏の「モデル疲れは実在する」という発言、Sam Altman氏の「より速いケイデンス」という言及、Ahmed Abbasi氏の「財布のシェア争い」と1兆ドル近い未公開評価額、Noah Faro氏のポイントリリース指摘およびFable 5とKimi K3が直近の2本だとする評価、そしてSuresh Vasudevan氏の10のうち5という数字。取材協力 Kate Rooney、MacKenzie Sigalos。2026年9月8日取得
- Moe Khalil, "Model Fatigue is Real," 2026年9月4日 — 「より安いモデルで足りるときに教える動機がない」という論、閉じたタスクに対する最小実行可能モデルの枠組み、そして強く高価なモデルが難しいタスクを安いモデルのコストのごく一部で解いたという実測。Khalil氏は自動ルーターを開発するLiteLLMのプロダクトエンジニアであることを記事内で開示しています。2026年9月8日取得
- Gartner, "Gartner Forecasts Worldwide AI Spending to Grow 47% in 2026," 2026年5月19日 — 2026年の世界のAI支出2兆5,900億ドル、前年比47%増、最大セグメントはAIインフラ
- MindStudio, "Local AI Model Fatigue: Why One Setup Beats Chasing Every Release" — ローカル小型モデルのリリースサイクルをランニングマシンと描写した箇所と、実績あるデイリードライバー構成ひとつへの標準化を説く議論
- AI타임스, "[9월7일] '일주일에 4개나 출시'...커지는 '모델 피로감'," 2026年9月7日 — CNBCの記事と周辺の開発者の反応を伝えた韓国語の報道
- NVIDIAによるHugging Face買収についての私たちの読み — 同じ週のもうひとつの発表であり、ここで名前を挙げたすべてのモデルの下にある流通層
- 自分のワークロードで文字起こし精度を測る方法 — 評価をきちんと一度走らせたとき、実際にいくらかかるか