一个 16.5GB 的文件,分数超过了二月最强的闭源模型
三年前,你能下载到的最好模型在 HumanEval 上落后 GPT-4 三十七分,而且要两块显卡才跑得动。上周,一个 27B 开放权重模型在 Artificial Analysis 智能指数上拿到 52.0,Claude Opus 4.6 Max 是 44.9。价格只有九分之一,文件只有 16.5GB。本文把基准表、价格曲线,以及追赶时差缩短到162天这件事的含义讲清楚。
Hacker News 上有人正用一块 16GB 显存的显卡跑前沿级别的语言模型,每秒50到60个词元,上下文12万8千词元。模型是2026年8月14日发布的 Qwen3.8-27B。在 Artificial Analysis 智能指数上,它拿到 52.0;而直到今年二月还是市面最强闭源模型的 Claude Opus 4.6 Max,是 44.9。
这句话放在2023年是科幻,而且不是让人高兴的那种科幻。
这篇文章做的是前后对比。发布本身我们已经写过,这里要做的是跨越三年的比较:当年和现在,能下载到的最好模型对上前沿模型分别拿到什么分数;当年和现在,买到一定水平的智能要花多少钱;当年和现在,自己跑起来需要什么硬件。下面每一个数字都带出处和日期。这些数字描绘出的趋势,是眼下软件行业里少数真正令人乐观的事情之一。
要点:
- 差距被追平了,而且日期可以精确到天。 2023年7月,最好的开放模型在 MMLU 上落后 GPT-4 十七点五分,在 HumanEval 上落后三十七点一分。2026年8月,一个开放的 27B 在双方都公布数据的19项基准中赢下15项,在独立综合指数上也领先。
- 价格在23个月里下降了约208倍。 这是 Epoch AI 在固定性能门槛下的测量结果。今天这个开放 27B 的混合单价是每百万词元 1.09 美元,Opus 4.6 Max 是 10.00 美元;自己跑,每词元成本为零。
- 它不是前沿,这点我们照说不误。 Claude Opus 5 Max 是 63.1,GPT-5.6 Sol Max 是 60.9。27B 在广域知识推理上大幅输给 Opus 4.6:HLE 上 30.8 对 40.0。
图片:Steve Jurvetson,维基共享资源,CC BY 2.0。约1988年的 Cray Y-MP 互连部分。当年所谓认真的算力,是一间你要走进去的房间。
「之前」到底长什么样
把时钟拨回2023年7月18日,Meta 发布 Llama 2 的那天。它是当时世界上可公开下载的最好模型,而它的论文毫不遮掩地印出了与闭源前沿的比分。
Llama 2 70B 在 MMLU 上是 68.9,GPT-4 是 86.4。GSM8K 上是 56.8 对 92.0。在编程基准 HumanEval 上是 29.9 对 67.0,连一半都不到。论文自己的总结写着:「Llama 2 70B 与 GPT-4、PaLM-2-L 之间仍存在很大的性能差距。」这是2023年开放权重阵营的旗舰,用自己的话留下的记录。
再看硬件。人们真正用来跑 Llama 2 70B 的方式,是 TheBloke 的4比特社区版本,41.4GB,2023年9月4日发布。要跑出可用速度,你需要两块 24GB 显卡,或者一台 64GB 的 Mac。真正能塞进普通笔记本的是 Llama 2 13B:7.9GB 的文件,MMLU 54.8分,比 GPT-4 低31.6分,除了演示几乎派不上用场。
所以2023年的选择是这样的:要么付钱给前沿实验室,要么在大多数人并不拥有的硬件上跑一个明显更差的东西。「直接用 API 就好」这个论点能压倒性地赢两年,原因就在这里。它是对的。
现在把同一个问题拿到2026年8月来问
阿里巴巴在2026年8月14日以 Apache 2.0 发布了 Qwen3.8-27B,并在模型卡上印出了与 Claude Opus 4.6 Max 的正面对比表。我们把双方都有数字的行全部数了一遍。
Qwen3.8-27B 在19行中赢下15行,输掉4行。 赢的部分包括 SWE-bench Pro(61.7 对 53.4)、IFBench 指令遵循(79.5 对 62.5)、LiveCodeBench v6 竞赛编程(90.3 对 88.8)、OSWorld-Verified 电脑操作(84.3 对 72.7)、AndroidWorld 手机智能体(81.9 对 62.0),后面还跟着一长串差距根本不算接近的多模态基准:MathVision 上 90.0 对 65.5,CharXiv 图表分析上 83.7 对 66.0,ERQA 具身推理上 65.5 对 40.8。
输掉的那4行比赢下的15行更重要,因为它们告诉你一个270亿参数的模型还做不到什么。它在 Terminal Bench 2.1 上以 73.0 对 78.2 落败,在 NL2Repo-Bench 的仓库级代码生成上以 42.3 对 47.6 落败,在 GPQA Diamond 上以 89.2 对 91.3 小幅落败,而在衡量跨学科广域推理的 HLE 上以 30.8 对 40.0 大幅落败。最后这一项就是这个局限的形状本身。你没法把世界的知识压进一个 16.5GB 的文件里;但你可以压进去极其大量的技能。
有一行需要加星号:79.0 对 63.8 出自 QwenSWEBench,那是 Qwen 自己造的基准。厂商在自造基准上自己跑出来的结果,是任何模型卡里最弱的证据,我们并不指望它。
独立评测给出同样的结论
厂商的表格终究是厂商的表格,所以看第三方。自己跑评测而不是转载别人数字的 Artificial Analysis 已经测过这个 27B 了。截至2026年8月21日,它给 Qwen3.8-27B 的智能指数是 52.0,在开放权重40亿至400亿参数这一档的135个模型中排第一;Claude Opus 4.6 Max 是 44.9。这是7.1分的差距,由一个与结果无关的机构测出,发生在 Opus 4.6 发布之后190天。
把这个比较沿时间轴往回看,本身就是故事。2023年7月,400亿参数以下最好的开放模型在同一指数上是 2.6。2024年7月是 7.4。2025年3月是 13.4。2026年2月是 34.6。上周是 52.0。
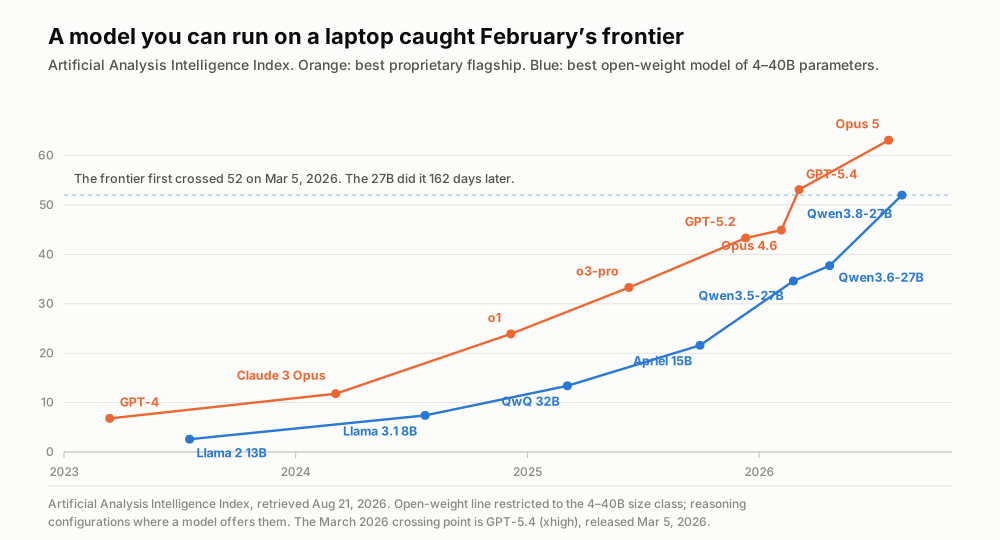
两条线都在上升,值得看的是它们之间的水平距离。Artificial Analysis 智能指数,2026年8月21日获取。
有一个数字值得起个名字。前沿第一次越过智能指数52,是2026年3月5日,GPT-5.4 在最高推理强度下拿到 53.1。而一个小到能在个人设备上跑的模型抵达同一位置,是8月14日,162天之后。我们把它叫做追赶时差:某项能力出现在前沿,与出现在你自己硬件上,这两个时刻之间的距离。
这个时差以前长得多。Llama 3.1 8B 用了260天才够到 GPT-4 Turbo 的水平。GLM-4.7-Flash 用了410天才追平 o1。最近三次笔记本级别的发布分别是201天、155天和162天。前沿没有变慢,Opus 5 Max 今天在 63.1;只是后面那条边缘正以约两年前两倍的速度逼近。
价格不是下跌,是塌了
能力只是前后对比的一半,另一半是账单。
Epoch AI 在2025年3月做出了这方面最干净的测量,方法本身就值得了解:把基准分数固定住,然后追踪随时间推移能达到该分数的最便宜模型。以 GPT-4 的 MMLU 86分为门槛,这条价格阶梯是:2023年3月每百万词元 37.50 美元,2023年11月 15.00 美元,2024年5月 7.50 美元,同月晚些时候 2.19 美元,2025年2月 0.18 美元。分数一直没变。23个月里便宜了208倍。
Epoch 的核心发现是,这个速率因任务而异,差别极大:固定的能力不同,年降幅在9倍到900倍之间;博士级科学问题上达到 GPT-4 水平的价格,大约以每年40倍的速度下降。唯有方向从未改变。
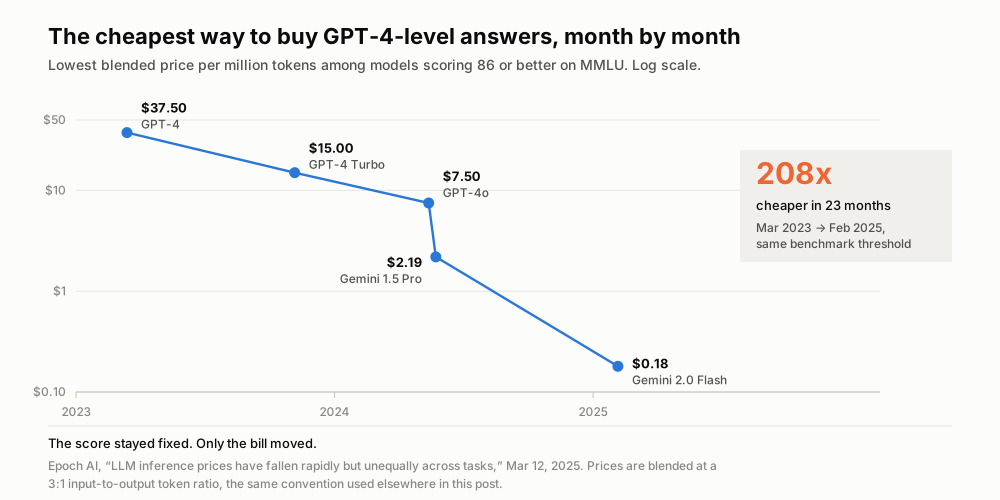
这条线上的每一个点,基准分数都是固定的。Epoch AI,2025年3月12日。
把这条序列延伸到今天的实时价格,趋势照旧。在2026年8月21日的 OpenRouter 目录上,Qwen3.8-27B 的输入价是每百万词元 0.45 美元,输出是 3.20 美元;Claude Opus 4.6 分别是 5.00 美元和 25.00 美元。按 Epoch 采用的输入与输出3:1混合口径换算,就是 1.09 美元对 10.00 美元——这个开放模型比半年前的闭源旗舰便宜9.1倍,指数上还高7.1分。
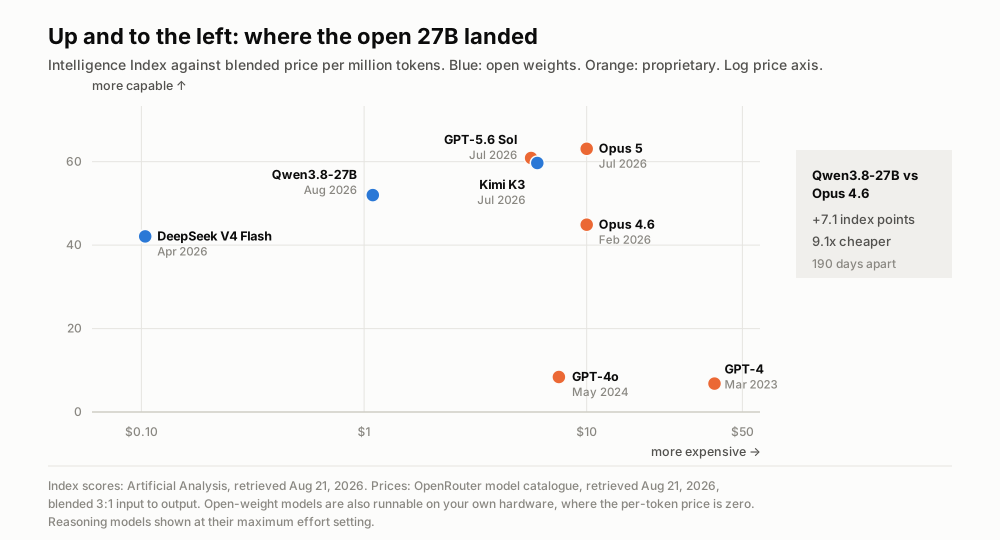
所有值得一提的模型都在往左上角迁移。分数来自 Artificial Analysis,价格来自 OpenRouter,均于2026年8月21日获取。
还有一个根本没有「每词元价格」这回事的选项。把 27B 放在自己的 RTX 4090 上,按发布讨论里实践者报告的每秒约48个词元计算,假设显卡450瓦的标称功耗,再套上美国居民平均电价每千瓦时18.44美分(EIA,2026年5月),电费大约是每百万输出词元 0.48 美元——这还没算显卡本身,但也不用算任何人的利润。这是一个把假设全部摊开的计算估值,不是厂商宣称。
前与后,一行一行看
| 2023年7月 | 2026年8月 | |
|---|---|---|
| 可下载的最好模型 | Llama 2 70B(Meta,2023年7月18日) | Qwen3.8-27B(阿里巴巴,2026年8月14日) |
| 参数量 | 700亿 | 270亿 |
| 标准4比特社区版本 | 41.4GB | 16.5GB |
| 最小可用版本 | 7.9GB(13B,MMLU 54.8) | 9.8GB(2比特,16GB 显卡上12万8千上下文) |
| 现实硬件要求 | 两块 24GB 显卡或一台 64GB Mac | 一块 16GB 消费级显卡 |
| 当时的前沿模型 | GPT-4(2023年3月14日) | Claude Opus 4.6 Max(2026年2月5日) |
| 对阵结果 | MMLU −17.5,GSM8K −35.2,HumanEval −37.1 | 公布的19项基准中赢15项,智能指数 +7.1 |
| 该前沿模型的混合单价 | 每百万词元 37.50 美元 | 每百万词元 10.00 美元 |
| 开放模型的混合单价 | 无规模化供应 | 每百万词元 1.09 美元 |
| 许可 | Llama 2 社区许可 | Apache 2.0 |
每一格的出处都列在文末。我们反复回看的是倒数第二行:前沿自身的价格在三年里降了3.75倍,而开放的替代品直接出现在它下方大约十分之一的位置。两件事都发生了。真正改变「谁有资格做东西」的,是第二件。
还不成立的部分
围绕这次发布的热情,在四个具体位置跑到了证据前面。我们把它们标出来。
它不是前沿。同一指数上 Claude Opus 5 Max 是 63.1,GPT-5.6 Sol Max 是 60.9,都远高于 52.0。如果你的工作依赖当下能买到的最强推理,前沿仍然是另一种产品,而且仍然是闭源的。
按体量算它也不便宜。Artificial Analysis 自己的总结就说 Qwen3.8-27B「与同等规模的其他开放权重模型相比尤其昂贵」——同档开放模型输入价的中位数是每百万词元 0.05 美元,Qwen 是 0.43 美元。你付的是能力的钱,不是参数的钱。
它话多,而话多就是钱。跑完整套智能指数评测,这个 27B 生成了1亿6千万个输出词元,中位数是4千5百万。有位用户在 64GB 的 Mac mini 上给了它两个单词的提示,然后看着它思考了17分12秒。推理模型即便词元免费,也会用挂钟时间跟你结账。
还有,基准分数属于全精度模型。塞进你显卡的那个 9.8GB 的2比特版本,不是拿到 52.0 的那个模型。重量化会损失精度,长上下文尤其明显。任何「能在笔记本上跑」的说法,包括我们的,都带着这个星号。
为什么时差还会继续缩短
以下是我们的判断,转折点我们明确标出:上面全是测量,下面是从中做出的推论。
把追赶时差压下来的机制并不神秘。前沿公开的后训练方法,几个月内就会在开放实验室里被复现。一年半前还是专有技巧的推理强度调节,如今作为一个有文档的参数出现在这张模型卡上。社区量化甚至在原实验室的文档定稿之前就完成了。这三条反馈回路没有一条有减速的理由,其中两条还会随着参与者变多而变快。
所以对下一代的合理预期,不是开放模型超过前沿,而是162天这个时差继续压缩,同时两端的绝对能力一起上升。于是有意思的问题就不再是「开放模型能不能赢」,而是「对我的任务而言,前沿要多新,差距才不再重要」。对会议转写、翻译、摘要和大部分文档工作来说,这个门槛早就过了;对最前沿的研究和最难的智能体工程来说,还没有。
这比2023年的世界好太多了,值得直说。让计算机称职地理解语言,这件事的成本在三年里降了两个数量级,而且还在降。受益最大的是过去被价格挡在门外的人:单干的开发者、在每百万词元10美元不是四舍五入误差的国家里工作的团队、拿的是课题经费而不是预算的研究者,以及所有因为法律原因必须让数据留在自己机器上的人。
结论:前沿不再是一个地方,而是一个日期
旧问题是「你能用上哪家实验室」。新问题是「既然只要九分之一的钱、还能跑在你自己的硬件上,你愿意落后前沿几个月」。
对越来越多的工作来说,诚实的答案是:大约五个月,而且还在缩短。
Telli.sh 处在哪里: 上面这一切,正是我们选择在开放模型之上构建、而不是围着某一家厂商打转的原因。Telli.sh 的摘要链路已经在用一个开放的 Qwen 模型,所以这条曲线每往下走一格,到你手上的是更好的会议记录,而不是一封涨价通知。我们真正花时间的地方,是任何下载都给不了你的部分:稳定地录满一小时音频、把说话人分清楚、15种语言实时互译,再把这一切变成几个月后仍然搜得到的笔记。
资料来源
- Qwen3.8-27B 模型卡与基准表格,Hugging Face — 与 Opus 4.6 Max 的正面对比数据,2026年8月21日获取
- Artificial Analysis:Qwen3.8 27B 智能、性能与价格分析 — 智能指数 52.0,价格与输出量数据,2026年8月21日获取
- Artificial Analysis:Claude Opus 4.6 模型页 — 最高推理强度下智能指数 44.9,2026年8月21日获取
- Epoch AI,《LLM inference prices have fallen rapidly but unequally across tasks》,2025年3月12日 — 固定门槛价格阶梯与年降9到900倍的区间
- Llama 2: Open Foundation and Fine-Tuned Chat Models(arXiv:2307.09288),2023年7月18日 — 表4,Llama 2 70B 对 GPT-4
- TheBloke/Llama-2-70B-Chat-GGUF 文件列表 — 41.4GB 的 Q4_K_M 版本,2023年9月4日发布
- unsloth/Qwen3.8-27B-GGUF 文件列表 — 16.5GB 与 9.8GB 版本,下载量于2026年8月21日获取
- OpenRouter 模型目录 — Qwen3.8-27B、Claude Opus 4.6、Claude Opus 5 的词元单价,2026年8月21日获取
- 关于 Qwen3.8-27B 发布的 Hacker News 讨论,2026年8月14日 — 16GB 与 24GB 显卡上的实测吞吐报告
- 美国能源信息署 Electric Power Monthly 表5.3 — 2026年5月居民平均电价每千瓦时18.44美分
- 我们此前关于 Qwen3.8 开放权重发布的报道与关于更广泛开放权重浪潮的报道
- Cray Y-MP 照片的维基共享资源页面
