Qwen3.8-27B 开源权重:文件大小、Q4_K_M 与 4090/Mac 实测速度
Qwen3.8-27B 采用 Apache 2.0 许可。Q4_K_M 的 GGUF 为 17.1 GB,32 GB 笔记本即可运行;FP8 为 30.9 GB。实测 RTX 4090 每秒 48 个 token,Mac mini M4 Pro 为 12.75。
8 月 3 日,阿里巴巴的 Qwen 账号说开放权重「下周」就来。这是 AI 行业多年来教会所有人打折听的那种句子。十二天后,没有任何可以打折的余地了:2.4 万亿参数的 Qwen3.8-Max 权重在 8 月 12 日出现在 Hugging Face 上,而更小的那个 —— Qwen3.8-27B,带着一份普普通通的 Apache 2.0 许可证 —— 在 8 月 14 日跟上。
接着,真正有意思的事情发生了。就在 Qwen 写完 27B 模型卡的同一个小时里,三个不同的社区团队已经把它转换成了能在个人电脑上运行的格式。再过两天,这些社区转换版本的下载量超过了一百万次。
这个数字才是新闻,而不是跑分表。一家世界顶级 AI 实验室的 270 亿参数模型,从「宣布」到「在大约一百万张桌子上运行」,大约只用了 48 小时。本文是一份通俗指南:发布了什么、许可证是什么、用你手头已有的硬件跑 27B 需要什么、这三年走了多远,以及大多数报道会跳过的部分 —— 一个本地 27B 仍然做不到什么。
快速要点
- 承诺兑现了。Qwen3.8-Max(总计 2.4 万亿 / 激活 950 亿)于 8 月 12 日落地,Qwen3.8-27B 于 8 月 14 日落地。两者都是真正可下载的权重,不是托管预览。
- 两者的许可证不同,而这个差别比分数更重要。 27B 是 Apache 2.0:没有门槛、没有附加条款,商用也不欠任何人任何东西。Qwen3.8-Max 采用自定义许可证,对模型即服务类业务设有营收触发条件。
- 谁能跑什么,最终由体积决定。Max 是 4,892 GB 的下载量;压缩到 4 比特的 27B 只有 17.1 GB,一台 32 GB 的机器就装得下。社区 4 比特版本两天内下载量超过 107 万次。
图片:Dejan Krsmanovic,Wikimedia Commons,CC BY 2.0。自己运行一个前沿实验室的模型,意味着这台机器和它的维护也归你了。
承诺带着日期,而日期兑现了
8 月 4 日我们报道过那次宣布本身,当时写道等待是以「下周」而不是「某天」为单位的。那是证据当时能支撑的极限。结局很干净。
以 Qwen3.8-Max 名义推广的 Qwen3.8-2.4T-A95B 在 8 月 12 日连同许可证文件一起出现。Qwen3.8-27B 和一个效率优化的 FP8 版本在 8 月 14 日到达。两个日期都落在「下周」所指的窗口之内。在一个宣布过的模型经常永远不会发布的行业里,一家实验室兑现九天前的口头期限,本身就值得注意。
反响立刻而且很大。关于 27B 的 Hacker News 讨论帖一天内收获 1,351 分和 769 条评论。几小时内,从业者就开始贴出针对特定硬件的可用部署配置,有人同时分享了英伟达 DGX Spark 和消费级 RTX 4090 显卡的设置。这和两年前的开放模型发布完全不同 —— 那时候让一个新架构跑起来本身就是一个周末的工程。
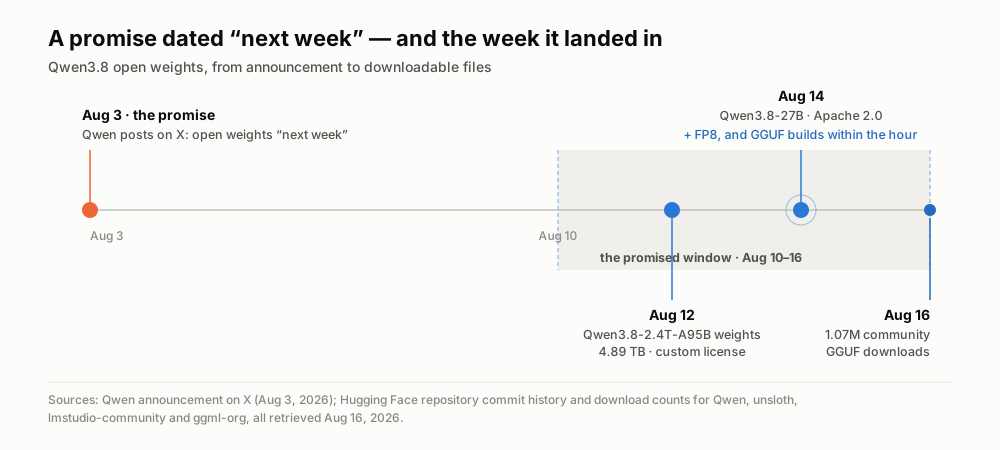
一个带日期的承诺,和落在它里面的两次发布。日期取自 Hugging Face 仓库提交记录,2026 年 8 月 16 日检索。
五个术语,全都指向「我能跑得动吗」
如果你是从我们之前的文章过来的,你已经知道开放权重是什么:实验室公开构成成品模型的那一大片学习得到的数字,你可以下载它、在自己的硬件上运行、在它之上做产品,而不必按次付费。这里我们关心的是下一个问题,一个完全实际的问题 —— 真正跑起来,硬件要花多少?
参数就是那些学出来的数字,数量决定模型的原始体积。经验法则简单得近乎残酷:在实验室训练所用的精度下,每十亿参数约占磁盘 2 GB,运行时容纳模型所需的内存也差不多是这个量。所以一个 270 亿参数的模型是 55 GB 的下载。一个 2.4 万亿参数的接近 5 TB。这就是为什么一个是笔记本电脑的问题,另一个是数据中心的问题。
量化是弥合这个差距的办法,也是想在家里跑模型的人最该掌握的概念。参数通常以 16 比特精度存储。量化把它们四舍五入到更少的比特 —— 8 比特、4 比特,有时 2 比特 —— 文件体积大致按同样比例缩小。4 比特量化把那个 55 GB 的下载变成约 17 GB。你损失一点准确率,换来「根本跑得动」这件事。GGUF 只是这些压缩版本所用的文件格式,llama.cpp、Ollama、LM Studio 这类工具读的就是它。看到「Q4_K_M」,就读成「大多数人用的那个 4 比特版本」。
稠密模型与混合专家模型的区别,决定了装得下之后跑得多快。Qwen3.8-27B 是稠密模型:每生成一个词,全部 270 亿参数都要参与。Qwen3.8-Max 是混合专家模型 —— 总计 2.4 万亿参数,但一个路由器在 512 个专门的子网络中,为每个词元只挑出约 950 亿参数来用。总数告诉你存储的账单,激活数告诉你算力的账单。这个区分有一个很锋利的实际后果,后面会回来讲。
上下文窗口是模型一次能同时考虑的量。27B 原生支持 262,144 个词元 —— 大约相当于好几份一小时会议记录叠在一起 —— 改一下配置还能拉到一百万。
应该先读许可证
这是本文最有分量的发现,而且它直接推翻了「同一个系列的模型会共享同一套条款」这个假设。
Qwen3.8-27B 是 Apache 2.0。 这是光谱上最宽松的一端:使用、修改、微调、放进商业产品发布、在它之上做生意,都不欠任何东西、不必问任何人。没有营收门槛,没有必须在界面上署名的要求,没有使用领域的限制。
Qwen3.8-Max 不是。 它采用自定义的「Qwen3.8-Max 许可证」,开头像 MIT,然后附加两个条件。如果你的产品月活跃用户超过一亿,或月营收超过两千万美元,你必须在界面上显著展示模型名称。如果你经营模型即服务或 AI 办公助手业务,且任意连续十二个月的营收超过五千万美元,那么在商用之前,你需要与 Qwen 另行签约。
对个人开发者,或只在公司内部使用的企业来说,这些条款都咬不到。但这正是当初 Kimi K3 用自定义许可证而非 MIT 发布时我们指出过的同一个星号,教训也在重复:「开放权重」和「开放许可证」是两个独立的问题,同一家实验室相隔两天发布的两个模型,答案可以完全不同。在为分数心动之前,先读许可证。
| 模型 | 总参数 | 每词元激活 | 下载体积 | 许可证 | 现实运行环境 |
|---|---|---|---|---|---|
| Qwen3.8-Max (2.4T-A95B) | 2.4 万亿 | 950 亿 | 4,892 GB | 自定义,营收触发 | 一组加速器集群 |
| Qwen3.8-Max, FP8 | 2.4 万亿 | 950 亿 | 2,496 GB | 自定义,营收触发 | 一组加速器集群 |
| Qwen3.8-27B | 270 亿,稠密 | 270 亿 | 55.6 GB | Apache 2.0 | 多卡工作站 |
| Qwen3.8-27B, FP8 | 270 亿,稠密 | 270 亿 | 30.9 GB | Apache 2.0 | 单张高端显卡 |
| Qwen3.8-27B, Q4_K_M GGUF | 270 亿,稠密 | 270 亿 | 17.1 GB | Apache 2.0 | 32 GB 笔记本或 4090 |
跑 27B 到底需要什么
老实的答案是:比你想的少,比标题暗示的多。
最低的那一级是一条命令。27B 在 Ollama 的模型库里,ollama run qwen3.8 会拉下一个 18 GB 的版本,带 256K 上下文窗口和图像输入,共有十二个变体,包括一个为苹果芯片调优的。给你聊天窗口而不是终端的 LM Studio,也在发布几分钟内就上线了自己的版本。这两者都不要求你理解上一节的任何内容。
然后现实以「每秒多少词元」的形式介入。发布帖里从业者报告的数字,大体落在硬件所预测的位置。在 RTX 4090 上跑 4 比特版本,有人测到每秒约 48 个词元 —— 比你阅读的速度快得多。在 64 GB 内存的 Mac mini M4 Pro 上,另一个人得到每秒 12.75 个词元:能用,但你会看着它一个字一个字往外打。而在一台配 AMD 7840U 和 64 GB 普通 DDR5 内存的笔记本上,同样的 4 比特版本大约每秒 4 个词元 —— 技术上在运行,实际上是一个挂上去就走开的批处理任务。
最后这个数字,正是稠密与混合专家之差发挥作用的地方。同一个人在同一台笔记本上测了一个名义上更大的旧款混合专家模型,得到每秒约 20 个词元 —— 比更小的稠密模型快五倍,因为每个词只有一部分参数在工作。如果你在为 CPU 挑模型,该比的数字是激活参数,不是总参数。这是本地 AI 里最反直觉、也最有用的一课。
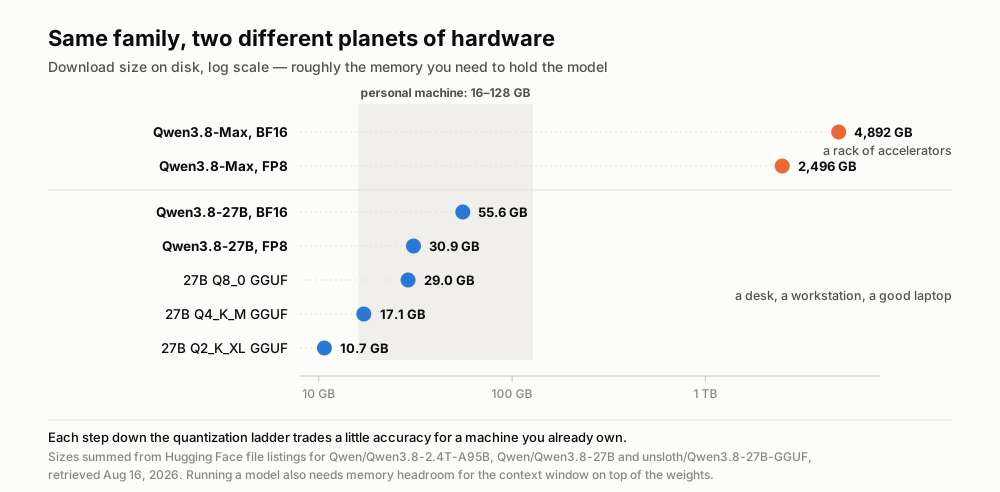
同一个模型家族的两位成员,下载体积相差 290 倍。体积由 Hugging Face 文件清单累加,2026 年 8 月 16 日检索。
三年前,这需要一次泄露和一个周末
要看清这一跃有多大,得把它和本地模型的起点放在一起。
2023 年 2 月,Meta 只向获批的研究者发布初代 LLaMA 权重。它在大约一周内泄露,整个业余本地模型圈子,就建立在一份人们本不该拥有的文件之上。2023 年 3 月 10 日,一位开发者发布了 llama.cpp —— 一个小小的 C++ 程序,绝活是在 MacBook 上跑 70 亿参数的模型。那个仓库如今有 12.4 万颗星,是今天几乎所有「本地运行」工具的祖先。
对比这两个发布日。2023 年:一个泄露的 7B,谈不上什么许可证,社区花了一周才让它跑起来,而且模型本身是有趣多过有用。2026 年:一家前沿实验室的 27B,主动以 Apache 2.0 发布,带图像和视频输入、262K 上下文窗口,而社区版本在实验室自己的文档还在变动时就已经做完了。unsloth 转换版的第一次提交发生在 8 月 14 日世界协调时 14 时 56 分 —— 比 Qwen 最后一次更新模型卡还早四分钟。
采用数字把同样的话说得更直白。截至 8 月 16 日,27B 的社区 4 比特版本在第一个发布者处被下载 867,963 次,第二个处 171,518 次,第三个处 34,520 次:两天内 107 万次。Qwen 自家的官方 27B 仓库再加 21.5 万次。而能力强得多的 Qwen3.8-Max,两个仓库加起来只有 17,126 次。
把这个比例再读一遍。前沿规模的模型拿到的关注,约为笔记本规模那个的 1.6%。市场跑去拿走的不是能力,是触达范围。
一个本地 27B 仍然做不到什么
现在该做修正了,因为热情超越证据的方式总是可以预料的。
阿里巴巴自己的跑分表里,27B 在若干智能体编程与指令遵循指标上胜过 Opus 4.6 Max —— SWE-bench Pro 上 61.7 对 53.4,IFBench 上 79.5 对 62.5 —— 在另一些上则落败,包括考查广博知识的 HLE 上 30.8 对 40.0。这些数字全部是厂商自报的。截至本文写作时,我们所依赖的独立评测机构 Artificial Analysis 根本没有 27B 的条目;它确实把 Qwen3.8-Max 排在 188 个模型中的第 10 位,智能分数 58 —— 这个成绩很出色,同时也是另一个模型。
从业者比表格更锋利。发布帖里得票最高的那条反驳,来自一位自称长期使用开放模型的人,说得很直白:这些模型在真实使用中并不能胜过顶级托管模型;它们对很多任务「够好」,并且能在负担得起的硬件上运行 —— 这是一个不同的、也更克制的说法。另一条评论把上限说成了物理问题:你没法把人类的全部知识压进一个 30 GB 的文件里,所以无论小模型在编程或工具调用上变得多锋利,它在回忆冷门事实上始终相对薄弱。
还有两个限制,只有真正跑过才会显现。量化不是免费的:压得很狠的模型在长上下文里容易跑偏,还会掉进重复循环 —— 这就是为什么内存有富余的人会被建议直接跑全精度版本。而且这一代 Qwen 默认用力思考:有位用户在 64 GB 的 Mac mini 上,只给 27B 丢了「svg owl」两个词,然后看着它花了 17 分 12 秒、生成 21,769 个词元的思考过程才给出答案。猫头鹰做得很好。同时也产生了一份任何托管 API 都不会收取的、以挂钟时间计的账单。
还有一项没人计算:运维现在归你了。模型更新、量化选择、内存余量、驱动版本、机器的风扇。你想避开的那个托管 API,同时也是一群让某个东西持续运转的人。
结论:护城河向下移了一层
要点在这里,而且它比一次发布更大。
一家前沿实验室在周四发布了一个能干的 27B。到周六,社区压缩版本已有一百多万份装在人们的机器上,在 Ollama 里只有一条命令的距离,而且在法律上可以自由地在它之上做生意。无论那个模型代表什么优势,它变得对所有竞争者同时可得,大约用了两天。我们叫它两天护城河 —— 模型优势如今的半衰期约为 48 小时。
这不是预测。这是本周、在这次发布上取得的测量结果。
而它重新定义了做 AI 产品意味着什么。当模型层成为任何人一个下午就能换掉的大宗商品,模型就不再是你竞争的地方。留存下来的是包裹在它周围的一切:凌晨三点推理服务器倒下时的可靠性;捕获、清洗、检索正确上下文的数据管道;告诉你它在你的数据而非跑分数据上是否有效的评测;一个人真正愿意去用的界面;以及决定别人是否愿意把会议录音交给你的那套信任安排 —— 隐私、留存期限、谁能看到什么。
这些没有一样能在两天内被商品化。它们没有一样有下载按钮。
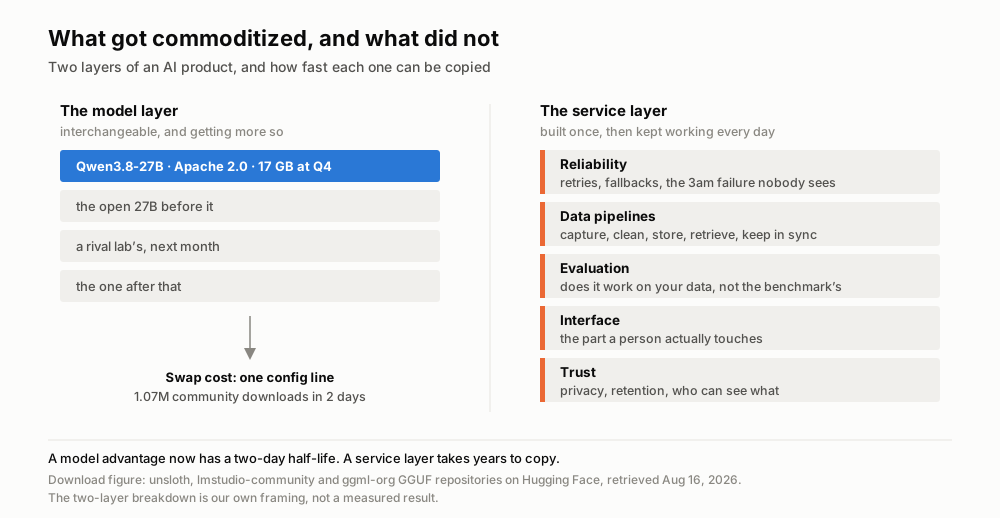
这周变便宜的那一层,和没有变便宜的那一层。下载数据取自 Hugging Face,2026 年 8 月 16 日检索。两层划分是我们自己的框架。
所以,面对一个优秀的开放模型抵达笔记本电脑,正确的反应既不是「模型公司赢了」,也不是「产品公司输了」。而是:有意思的工作往栈的下面挪了一层 —— 挪到了一个更难被复制、也更不适合写成标题的地方。
Telli.sh 在其中的位置: 我们做的正是那个服务层,而且建在开放模型之上。Telli.sh 的摘要环节已经在使用一个开放的 Qwen 模型,这意味着开放模型质量的每一次跃升 —— 包括这一次 —— 都会直接流入会议转写、翻译和摘要,而你这边的价格不变。我们把时间花在 GGUF 文件里不会送达的那部分:可靠地采集音频、把说话人分清楚、把一段 60 分钟的录音变成几个月后还能搜到的笔记,以及把你的数据放在哪里说清楚。
来源
- Qwen3.8-27B 模型卡与许可证,Hugging Face
- Qwen3.8-2.4T-A95B 模型卡与许可证,Hugging Face
- unsloth/Qwen3.8-27B-GGUF 量化版本与下载量
- Ollama 模型库中的 Qwen3.8
- Hacker News 关于 Qwen3.8-27B 发布的讨论(2026 年 8 月 14 日)
- Artificial Analysis 的 Qwen3.8 Max 模型页面
- Qwen (@Alibaba_Qwen) 在 X 上的开放权重公告(2026 年 8 月 3 日)
- llama.cpp 仓库,创建于 2023 年 3 月 10 日
- Wikimedia Commons 图片页面
