中国开放权重的三周狂奔:Kimi K3、Qwen3.8-Max,以及可能终结这波浪潮的转折
短短三周,中国头部AI实验室接连发布或预告了前沿级开放权重模型——Kimi K3、Qwen3.8-Max,以及已进入正式可用的DeepSeek V4。用大白话讲清每个模型是什么、哪些真正落地、哪些仍是承诺,以及北京为何如今要监管自己催生的这波浪潮。
从7月16日到26日,中国三家头部AI实验室相继摆出了前沿级的开放模型。Moonshot AI在7月16日发布Kimi K3,并于7月26日放出权重。阿里巴巴在7月19日的上海WAIC上亮相Qwen3.8-Max。DeepSeek的V4系列在7月20日前后进入正式可用(GA)。三家实验室,大约三周。
这条脉络很难忽视,而且它与中国开放模型阵营一贯赖以立名的方式并不相同。这些实验室过去以又小又快又便宜、却能以小博大的模型著称。这波浪潮押的是相反的注:把万亿参数级的系统,公开出来,或者承诺公开。
本文诚实地梳理这波浪潮:哪些真正落地,哪些仍停留在预览或承诺,以及随之而来的转折——正是让这些发布成为可能的那个政府,如今正在权衡是否要加以限制。我们会尽量少用术语,其余的边讲边解释,好让你即便第一次听到“开放权重”和“mixture-of-experts”,也能跟上这个故事。如果你读过我们7月的盘点,那么本文就是续集,而当时留下的一个悬念已经揭晓。
Image: OLCF at ORNL, Wikimedia Commons, CC BY 2.0.
先讲清让这一切说得通的五个概念
如果你刚接触AI的这个角落,有五个词撑起了故事的大半,值得在进入模型之前用大白话花一分钟捋一捋。
“开放权重(open weights)”正是这波浪潮之所以重要的全部理由。一个模型的权重,就是它在训练中学到的那张巨大的数字网格——实际上就是练成的大脑。当实验室公开权重,你就能把那个文件下载下来,在自己的硬件上运行模型、加以调整,并在其上做产品,无需向任何人请示,也不必按次付费。另一端是封闭模型,就像大多数商用聊天机器人那样,权重被锁在厂商的服务器上,你只能通过付费API租用访问权。开放权重把模型从“你租用的服务”变成“你拥有一份副本的东西”,而每当一个好模型问世、整个行业都为之侧目,靠的正是这个区别。
“参数(parameters)”就是那些学到的数字,它们的数量大致代表模型能装下多少东西。“2.8万亿参数”的模型就是有2.8万亿个参数。更大并不自动更好,但在前沿,它通常意味着更多的推理余地——同样重要的是,也意味着运行它需要更多硬件。这就引出了“mixture-of-experts(MoE)”。MoE模型不是每个词都点亮全部参数,而是拆成许多被称为专家的专门子网络,由一个路由器为每个token只挑出其中一小撮。所以当你看到“总计2.8万亿、激活1040亿”,意思是这个模型极其庞大,但任一时刻真正干活的只有约1040亿参数——就像一家有几千名专科医生的医院,每位病人只由相关的少数几位诊治。总数暗示它能有多强,激活数告诉你服务它有多贵。这个差值,是判断成本时最有用的一个数字。
“上下文窗口(context window)”是模型一次能同时记在脑中的文本量,以token计——而一个token大约相当于四分之三个词。一百万token的窗口不是抽象规格:它相当于好几部长篇小说,或者几十份一小时的会议记录,一次性装进去。这是“总结一封邮件”和“把整整一个季度的邮件放在一起来推理”之间的差别。
最后是许可证——而这恰是从业者该在看跑分之前先读的部分。许可证就是那行法律细字,规定你能拿这些权重做什么。MIT是黄金标准:使用、修改、放进商用产品发布,全都不欠人情。自定义许可证可以看起来很开放,却恰好把你心里想的那种用途排除在外——比如,当你在它之上做起来的生意做大之后,就要向你收费。两个模型可以同样是“开放权重”,但在法律上允许你做什么这件事上却有天壤之别。所以在你迷上一个分数之前,先读这一行才划算。手握这五个概念,这波浪潮就读得清清楚楚了。
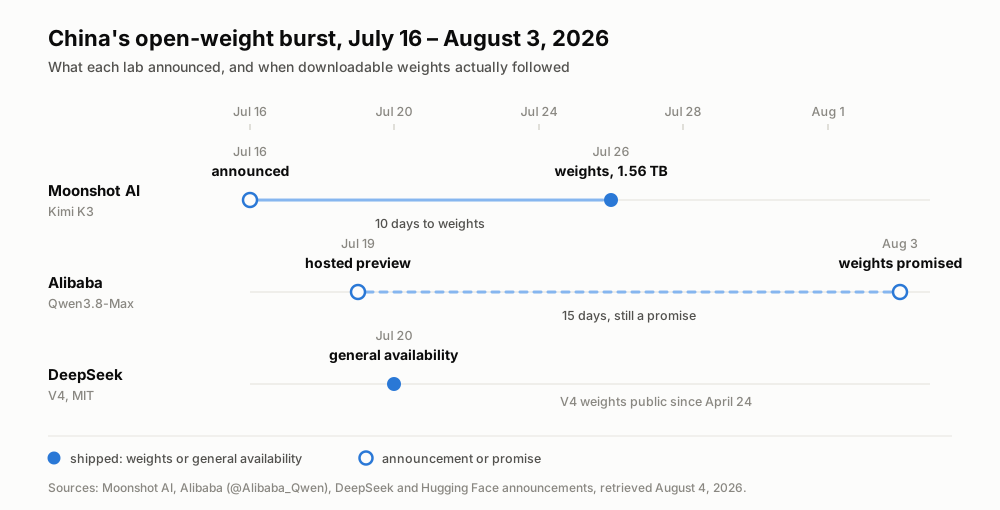
三家实验室,三周 — 这五个节点里,真正把权重交到人手里的只有两个。日期依据各实验室的官方公告,2026年8月4日核对。
真正落地的是Kimi K3
先从Moonshot AI说起。这是打造Kimi助手的北京实验室,过去一年靠又大又能打的开放模型攒下了名声。我们7月写到Kimi K3时,权重还只是一个承诺——Moonshot说过“不晚于7月27日”。它在7月26日到来了:Hugging Face上的moonshotai/Kimi-K3,1.56TB,分成96个分片。这才是新闻的核心。发布是一份新闻稿,而可下载的权重,是你可以在其上动手搭建的事实。
用大白话说,K3是迄今公开过的最大一批开放模型之一——一个mixture-of-experts系统,总参数2.8万亿,每个token激活约1040亿,通过Moonshot称之为Kimi Delta Attention的机制,从896个专家中路由约16个,支持100万token上下文窗口,并据称相比前代K2实现了约2.5倍的扩展效率提升。把规格表翻成人话:它非常大,但因为每个token只点亮一小部分,按其体量算运行起来相对便宜,还能把一整本书那么长的输入整个吞下去。
这些数字也告诉你,谁才会真去运行它。分成96个分片的1.56TB可不是笔记本能下载的东西;它是数据中心级的产物,光是加载就需要一整簇高端加速器。现实中几乎没有个人会自己托管K3——他们会通过早已备好硬件的服务商去用,而这个市场第一天就到位了:Together AI和Modal都在权重落地的那一刻上线了托管的Kimi K3端点。这也是好奇的读者今天试用它的方式——不是去下载1.56TB,而是调用这类托管端点,或使用Kimi应用。这里的“开放”意思是权重公开、任何有硬件的人都能提供它,这正是保持价格竞争的原因;它并不意味着你会亲自在书桌上跑它。
它好用吗?以我们这一轮唯一信得过的独立数字来看,好用。在Artificial Analysis的排名中,它位列189个模型中的第4——排在Claude Fable 5和两种GPT-5.6“Sol”配置之后,在Opus 4.8和GPT-5.5之前。对一个你能下载的开放模型来说,能跻身这样的名单本身就是故事。
然后请读许可证,因为“开放”就在这里被加了个星号。Kimi K3不是MIT。它以自定义的“Kimi K3 License”发布,未获OSI认证,并附带一条营收门槛条款:若把K3作为大型Model-as-a-Service业务的引擎运行,你需要与Moonshot另行签约。对个人开发者,或内部使用的普通公司来说,这毫无影响。但对任何要大规模构建托管产品的人来说,“开放权重”和“开放许可”是两个不同的问题,而这里能明确回答“是”的,只有前者。
Qwen3.8-Max是预览,不是下载
Qwen是阿里巴巴的模型家族,其团队是全球最高产的开放模型发布者之一——正是这段履历,让最新这款显得叫人犯迷糊。7月19日在上海WAIC亮相的Qwen3.8-Max,是这波浪潮里最大的标题,也是最软的标题。它是一个2.4万亿参数的稀疏MoE——激活参数未公开——也是首个突破万亿参数的多模态Qwen,不仅吃文本,还把图像、视频和文档当作输入。
给新手把这个坑说明白:尽管声势浩大,你并不能下载它。眼下它只以“托管预览”的形式存在——qwen3.8-max-preview,通过阿里巴巴自家的服务(其Token Plan和Qoder工具)以约标准价10%的价格触达。托管预览意思是阿里巴巴在自己服务器上运行模型、让你去调用它;这是“租API”的模式,不是“拥有一份副本”的模式。今天就把它称作开放权重发布,为时尚早。
这一说法在8月3日发生了改变。Qwen的官方X账号@Alibaba_Qwen发帖称,Qwen3.8-Max的开放权重将在”下周”发布——而且一个更小的Qwen3.8-27B也会一同开放权重。所以27B并非传闻,无论此前有过什么议论:这是阿里巴巴自家账号立下的、白纸黑字的承诺。而尺寸正是关键。2.4万亿参数的Max和K3一样,是只有数据中心才跑得动的东西;而27B小到足以在一台高端机器上提供服务——正是个人或小团队真能自行托管的量级。这实实在在地缓和了”只承诺、没细节”的图景:如今既有了尺寸,也有了大致的时间。
不过,诚实的告诫依然成立。”下周”是方向,不是发货日期,而截至本文写作的8月4日,Qwen的Hugging Face组织上仍无任何新东西——那里最新的模型还是6月的。开放权重许可证也尚未公布,先读过预览条款的人已指出可能存在地区限制,在真正的许可证出现之前都属未经证实——这正是前面那条”许可证优先”的教训。该公司称这款模型”仅次于Fable 5”,依旧是一份没有第三方数字支撑的自我陈述,所以在阿里巴巴之外有人测过之前,把它当作厂商的营销措辞更稳妥。若你想今天就试这款模型,托管预览仍是唯一的门——但这是头一回,等待可下载权重的时间可以用”下周”而不是”某天”来衡量。
DeepSeek V4悄然进入正式可用
DeepSeek正是那家用R1模型在2025年初点燃当下开放模型竞赛的实验室,一如既往,它这回宣传得最少,却拿出了最能用的东西。它的V4系列早在4月24日就已发布,是你最能顺理成章去采用的一款,因为它挂着前面那段基础知识里被点名为黄金标准的那种许可证。
V4有两种规格,都采用MIT许可。V4-Pro是旗舰,总参数1.6万亿、激活490亿;V4-Flash是轻量款,总参数2840亿、激活130亿。回想一下激活数意味着什么:V4-Flash每个token只点亮130亿参数,因而服务起来又便宜又快,这也让它成为高吞吐量工作的“省钱之选”——就是那种按token成本决定一切的大规模转录与摘要负荷。两者都配备100万token上下文窗口,单次回复最高可输出384K token,足以起草一份长报告,而不只是一个段落。7月20日前后,V4以按时长计费的方式进入正式可用,正是这一点把一个春天的发布拉进了与K3、Qwen相同的三周框架里。
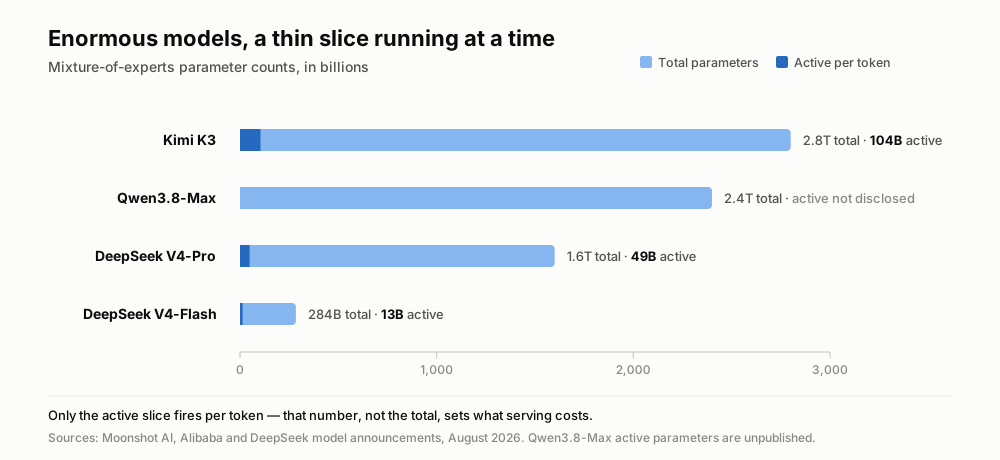
浅色条是模型的体量,深色的一小段是每个token真正启用的部分。阿里巴巴未公布Qwen3.8-Max的活跃参数。
因为是MIT,V4是采用者最不需要请律师的一款:拿到权重(或用托管服务商),运行、商用发布,不欠人情也不必征得谁的同意。再把版本号说清楚,毕竟传闻圈最爱这些——没有R2,没有V5,也没有V4.1。只是V4家族成熟为团队可以依赖的东西。
差距收窄的速度,比排行榜承认的更快
退一步看,单个发布的重要性不及那条斜率。Nathan Lambert的判断是,最好的开放模型与最好的封闭模型之间的距离,已从大约6到9个月压缩到3到5个月——“这是自DeepSeek R1以来,开放模型最接近前沿的时刻”。说白了:那些免费可下载的模型,如今只落后花钱能租到的最好模型区区几个月,而一年前它们还稳稳地落后整整一圈。
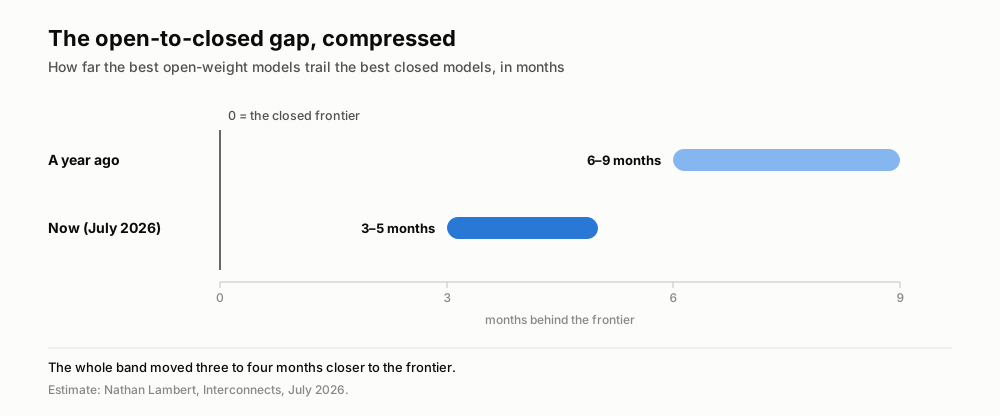
把Lambert的估计按真实刻度画出来:开源这一档不只是靠近了,整个区间本身也收窄了。
使用数据也指向同一方向。在把请求分发给众多模型的市场OpenRouter上,美国来源模型的token份额从2025年6月的约70%跌到一年后的约30%,而中国来源模型如今经常超过30%。价格是很大一部分原因:中国开放模型每token通常便宜60%到90%,而且托管几乎立刻就位——那些第0天上线的K3端点已经说明了这一点。
更安静的转变关乎规模。中国开放模型的品牌形象曾是小、快、便宜。2.8万亿参数的K3和2.4万亿参数的Qwen3.8-Max恰恰相反——这是在押注:如今在开放领域做大是值得的。Z.ai的GLM-5.2于6月16日以MIT发布,并以51分位居Artificial Analysis Index开放权重榜首,这是第四家实验室发出的同一条讯息。
转折:催生这波浪潮的政府,如今或将加以限制
然后局势转了个弯。7月22至25日前后,《金融时报》和路透社报道,中国商务部正在权衡对AI模型——包括开放权重LLM——实施出口管制,据称阿里巴巴、ByteDance和Z.ai都在磋商之列。被提出的框架是分级的:较弱的模型需备案,较强的模型需安全审查,而最强的模型则可能被禁止公开发布。目前尚无任何立法落地。但方向令人瞩目:这波浪潮或许正在其顶点,而恰在此刻,孕育它的政府开始把这些模型视作战略出口品,而非开放的贡献。
结语:当开放之物成为战略资产
漂亮的说法是“中国追上来了”。更准确的说法是:开放权重成为战略资产的速度太快,以至于政府如今想把手搭在那个水龙头上。三周之内,开放模型从落后前沿两三个季度收窄到落后一个季度——并且从又小又便宜,变成了以任何形式公开过的最大一批模型之一。开放的前沿不只是移动了,它移到了一个连它的缔造者都未必能继续从中发货的地方。
对在这些模型之上做产品的团队而言,实务结论没变,却更锋利了一分。Telli.sh的摘要层已经在使用开放模型Qwen3,因此开放模型在质量和价格上的每一次进步,都会直接流入会议转录、翻译与摘要。新增的一项是“供给”。如果中国的出口规则如报道所示落地,那么哪些开放模型仍能被自由下载,就是一个应当关注、而非想当然的问题。支撑这一层的模型越来越好,是趋势;而这些模型能从何处而来,则是需要持续留意的事。
来源
- Simon Willison on Kimi K3 weights (July 27, 2026)
- Nathan Lambert, "Kimi K3: the open-weights escalation" (Interconnects, July 20, 2026)
- Kimi K3 announcement (Moonshot AI)
- Kimi K3 weights on Hugging Face
- Artificial Analysis on Kimi K3
- Qwen (@Alibaba_Qwen), Qwen3.8-Max & Qwen3.8-27B open-weights announcement on X (Aug 3, 2026)
- Latent Space / AINews, "Qwen 3.8 Max (2.4T) and 27B, new open weights models" (Aug 4, 2026)
- WinBuzzer on DeepSeek V4 (April 27, 2026)
- The Decoder on Chinese open-model adoption
- Tom's Hardware on China's proposed AI export controls (July 2026)
- Wikimedia Commons image page
