音声認識も静かにオープンウェイトになった — サイズは1.56GB
アリババのQwen3-ASRはApache 2.0ライセンスで52の言語と方言に対応し、ダウンロードサイズは2ギガバイト未満です。オープンウェイトの文字起こし層をやさしく整理しました。いま何があるのか、自分のノートPCで動かすと実際に何が手に入るのか、そしてクローズドなAPIがいまだに勝っている場所はどこか。
ノートPCでも、オープンウェイトの音声認識を動かせるようになりました。アリババのQwenチームはQwen3-ASR-0.6B、Qwen3-ASR-1.7Bと、補助モデルQwen3-ForcedAligner-0.6BをApache 2.0で公開しています。最小モデルは1.56GBで、52の言語と方言に対応し、6月26日以降は標準的なPythonを3行書けば動きます。自分のマシンで動かせば、リクエストごとの文字起こし料金はかかりません。
オープンな言語モデルを追ってきた人には、見覚えのある変化でしょう。自前でホストすればコスト、プライバシー、オフライン利用をより自在にできます。一方、運用の手軽さではホスト型APIが勝ります。音声認識でも、ローカルで動かせる小さなモデルによって同じ選択肢が生まれています。
このガイドでは、オープンウェイト音声認識の役割、モデルとライセンスの違い、小型モデルを動かせる環境、そしてホスト型APIが今も優位な点を説明します。
TL;DR:
- オープンウェイトの文字起こしはすでに実用段階です。Qwen3-ASRはApache 2.0で52の言語・方言、WhisperはMIT、NVIDIAのParakeetとCanaryはCC BY 4.0、MistralのVoxtralはApache 2.0です。
- 自前でホストすればプライバシー、オフライン動作、コスト管理が手に入ります。独立系ベンチマークのArtificial Analysisでは、オープンモデルのホスティングが1,000分あたり1.50ドル、MicrosoftのMAI-Transcribe-1.5が6.00ドル、Gemini 3.1 Pro Previewが18.15ドルです。
- 精度1位はいまもダウンロードできないクローズドのプレビューエンドポイントです。ただしApache 2.0のオープンモデルであるVoxtral Smallが5位に入っており、1位との差は単語誤り率で約1ポイントです。
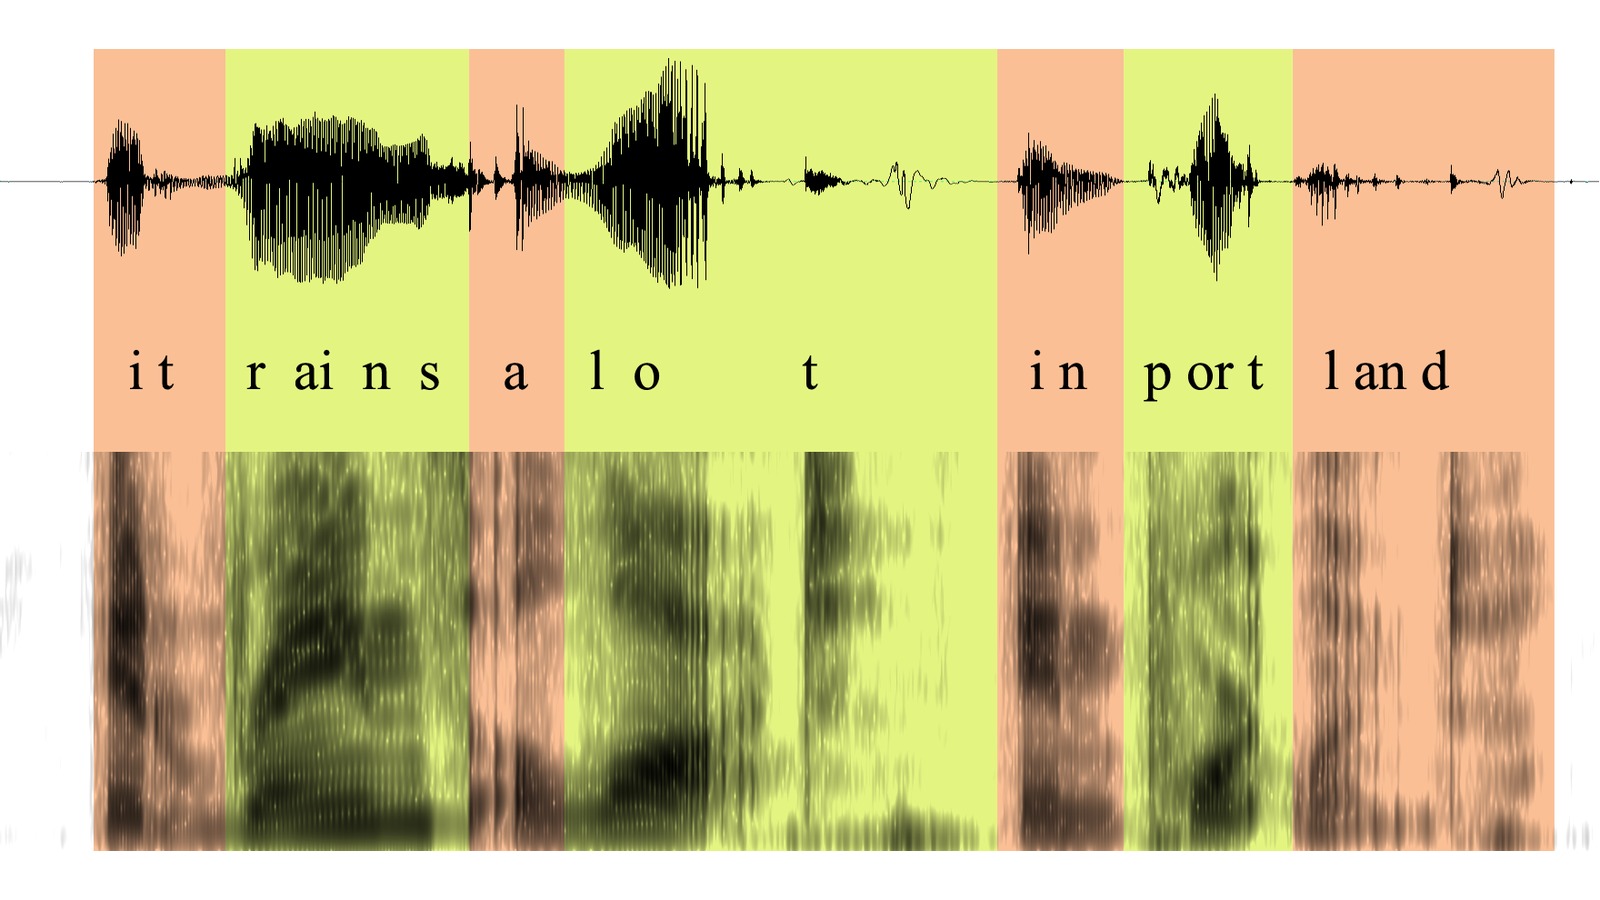
画像: Aaron Parecki, Wikimedia Commons, CC BY 2.0。「it rains a lot in Portland」という文の波形とスペクトログラムで、文字が対応する音声区間の上に置かれています。あらゆる音声認識モデルが扱う原材料がこれです。
文字起こしモデルをダウンロードするとき、何をダウンロードしているのか
ASRモデル、つまり自動音声認識モデルは、STTや音声テキスト変換と同じ意味で使われますが、音声を入れるとテキストを出すプログラムです。仕事はそれだけ。誰が話したかを判断せず、要約もせず、その会議が何の話だったかも知りません。言葉を聞いて書き取るだけです。
「オープンウェイト」とは、研究所が完成したモデルファイルそのものを公開したという意味です。モデルの重みは学習で獲得した巨大な数値の格子で、それを公開するということは、そのファイルをダウンロードして自分のハードウェアで動かし、その上に製品を作れるということです。許可も要らず、リクエストごとの課金もありません。反対側はクローズドなモデルです。重みはベンダーのサーバーに残り、あなたはAPIでアクセス権を借ります。音声を送ればテキストが返り、分単位で請求されます。
名前についた数字はパラメータ数で、音声モデルではこの数字が特に実質的です。「0.6B」はパラメータが約6億という意味で、実際にQwen3-ASR-0.6Bは1.56GBのファイル、Qwen3-ASR-1.7Bは4.08GBのファイルです。どちらもノートPCのSSDに置いても気づかれない大きさです。中国のオープンモデルをまとめた記事で扱った言語モデルと比べてみてください。あちらの目玉は96分割で1.56テラバイト、読み込むだけでもクラスタが要りました。音声モデルは最前線のテキストモデルより千倍ほど小さく、その一点が、今回の変化があのときより強く効いてくる理由です。
このサイズ帯をノートPC層と呼びます。試すために必要なのがハードウェア予算の検討ではなくダウンロードだけで済むモデルです。最先端のテキストモデルの多くは対象外ですが、音声モデルの多くは収まります。
モデルを採用する前にライセンスを確認しましょう。Apache 2.0とMITは利用、改変、商用配布を認めます。NVIDIAのモデルが使うCC BY 4.0も商用利用できますが、帰属表示が必要です。
Qwenは1月に出した。6月に簡単になった
Qwen3-ASRは2026年1月28日に初めて公開され、技術報告書は翌日にarXivへ掲載されました。6月26日には、Hugging Face Transformers v5.13.0以降に対応する3モデルの-hf版が公開されました。
このパッケージ変更で、より慣れた方法で設定できるようになりました。Qwen独自のqwen-asrパッケージやvLLMバックエンドを入れる代わりに、Transformersを使う開発者は標準的なPythonで-hfチェックポイントを読み込めます。認識内容は変えずに、導入の手間を下げる変更です。
モデルカードによると、両モデルは英語、中国語、韓国語、日本語、スペイン語、アラビア語、ヒンディー語、タイ語、ベトナム語、ポーランド語など30言語の識別と認識に対応し、さらに中国語の方言22種を扱います。合計52言語・方言です。どちらも1つのモデルでストリーミングとオフライン推論に対応し、長時間音声も受け付けます。歌唱やBGM入りの楽曲も対応音声として記載されています。
Qwen3-ForcedAligner-0.6Bは強制アライメントを追加します。音声と書き起こしから、11言語で最大5分の音声について各単語の開始・終了時刻をミリ秒単位で示します。クリック可能な書き起こし、字幕のタイミング、発話箇所へのジャンプに使えます。認識器と一緒にアライナーを公開したことで、デモだけでなく文字起こし製品を作る用途にも役立つファミリーになっています。
Qwenのモデルカードは、2026年6月26日付のHugging Face Open ASR Leaderboardの結果として、1.7Bモデルの平均単語誤り率を5.59%、0.6Bを6.31%と報告しています。AMI会議音声ではそれぞれ9.26%と10.57%です。単語誤り率が低いほど誤認識が少ないことを意味します。Qwenは1.7BをオープンASRの最高水準で商用APIにも匹敵するとしていますが、これらはベンダー報告の結果です。下記の独立ボードとは音声が異なるため、直接比較できません。
始まりはWhisperで、いまも皆がWhisperを動かしている
いまの形はOpenAIのWhisperなしにはあり得ませんでした。リポジトリは2022年9月16日にMITライセンスで公開され、コードと重みが揃っていました。まともな音声認識といえばクラウド事業者との契約を意味した時代です。以来、GitHubスターを106,679集めています。
Whisperを重要にしたのは、モデル自体よりも、コミュニティが数か月で上に積み上げたものでした。whisper.cppは素のC/C++で再実装し、PythonもGPUもなしにノートPCやスマートフォンで動くようにしました。MITライセンスでスター52,591です。faster-whisperはCTranslate2の上に載せ直して速度とメモリを大きく改善しました。こちらもMITでスター24,750です。モデルが種で、生態系が木でした。
4年後もWhisperは広く使われています。2026年8月5日までの30日間に、Hugging Faceでwhisper-large-v3-turboは872万回、whisper-large-v3は550万回ダウンロードされ、Qwen3-ASR-0.6Bは429万回でした。Artificial AnalysisのボードではWhisper Large v3がAA-WER 4.07%、同じ時点の首位は1.73%です。

オープン音声の層は3年の間隔をあけて二度の波として届き、その間はほぼ空白でした。公開日はGitHubとHugging Face、2026年8月5日取得。
オープン側は一つの研究所だけではない
Qwenだけではありませんし、他は得意分野がはっきり違います。
NVIDIAのParakeet系は速度を重視しています。2025年8月にCC BY 4.0で公開されたparakeet-tdt-0.6b-v3は6億パラメータで欧州25言語に対応し、言語自動判定、句読点、大文字化、単語単位のタイムスタンプを備え、1回で最大24分の音声を処理します。同じくCC BY 4.0のCanary系canary-1b-v2とcanary-qwen-2.5bも関連する機能を提供します。2025年7月にApache 2.0で公開されたMistralのVoxtralは、下記の独立比較で上位に入っています。
オープン側を横に並べてみます。最終行は対比のためのホスティングAPIです。
| モデル | ダウンロード | ライセンス | 言語 | 動く場所 | 最も得意なこと |
|---|---|---|---|---|---|
| Whisper Large v3 | 3.09GB | MIT | 99 | ノートPCまたはGPU1枚 | すでにあらゆるツールが対応する既定値 |
| Qwen3-ASR-0.6B | 1.56GB | Apache 2.0 | 方言込み52 | ノートPC | 最小サイズでの多言語処理 |
| Qwen3-ASR-1.7B | 4.08GB | Apache 2.0 | 方言込み52 | ノートPCまたはGPU1枚 | Qwen系で最高の精度 |
| Parakeet TDT 0.6B v3 | 2.51GB | CC BY 4.0 | 欧州25 | ノートPCまたはGPU1枚 | 速度と単語単位のタイムスタンプ |
| Voxtral Small | — | Apache 2.0 | — | サーバーGPU、240億パラメータ | 独立ボードでオープン最高スコア |
| ホスティングAPI | 不可 | プロプライエタリ | まちまち | ベンダーのクラウド | 話者分離、ストリーミング、稼働保証 |
ダウンロード容量は各Hugging Faceリポジトリの既定チェックポイントです。「—」はこの比較で使った資料に値がありませんでした。2026年8月5日取得。
そして、これらのモデルを実機に載せる梱包作業があります。ノートPC層が絵空事でなくなる地点です。Apple向けにコンパイルされたWhisperであるwhisperkit-coremlは直近30日で831万回ダウンロードされました。Apple Silicon向けParakeetのMLXビルドが187万回、通常のCPUでモデルを動かす量子化形式であるGGUF変換版が二つ合わせて204万回と187万回です。毎月数百万人が、自分の機械で動かすために特別に梱包された音声認識をダウンロードしています。研究上の物珍しさではありません。流通経路です。
1位はいまもダウンロードできないプレビューエンドポイントだ
この比較では、認識精度と自前でモデルを動かす運用上の利点を分けて考えます。
2026年8月5日取得のArtificial Analysis音声認識ボードは、同じ音声でオープンモデルとクローズドモデルを測定します。AA-WER v2の結果には次が含まれます。
| 順位 | モデル | AA-WER | ダウンロード可否 |
|---|---|---|---|
| 1 | Fun-Realtime-ASR-preview | 1.73% | 不可 — プレビューエンドポイント |
| 2 | Scribe v2, ElevenLabs | 2.18% | 不可 — ホスティングAPI |
| 3 | MAI-Transcribe-1.5, Microsoft | 2.38% | 不可 — ホスティングAPI |
| 4 | Smallest AI Pulse Pro | 2.43% | 不可 — ホスティングAPI |
| 5 | Voxtral Small, Mistral | 2.77% | 可 — Apache 2.0 |
| 6 | Gemini 3.1 Pro Preview, High | 2.82% | 不可 — ホスティングAPI |
| 11 | Whisper Large v3 | 4.07% | 可 — MIT |
出典: Artificial Analysis 音声テキスト変換リーダーボード、AA-WER v2、2026年8月5日取得。ダウンロード可否は各モデルの公開ライセンスから判断しました。
上位4行を見ると、この時点で高得点のモデルはホスト型で、首位はダウンロード可能なモデルではなくプレビューエンドポイントだと分かります。
Voxtral SmallはApache 2.0で、独立ボードでは2.77%の5位です。首位のクローズドなプレビューモデルとの差は約1ポイント。6,300語の1時間会議なら約66語に相当します。実際の差ですが、ローカル運用を重視するチームにとって乗り越えられない差ではありません。
多くの用途でオープン音声モデルはすでに実用的です。残る判断は、わずかな精度差に対して自前運用の制御性を取るか、ホスト型サービスの付加機能に費用を払うかです。
自前で動かすと何が手に入り、何を払うのか
チームを自前ホスティングへ押し出す理由は三つあり、そのどれも精度ではありません。
一つめはプライバシーで、たいてい決定打になります。診療の相談、法律のインタビュー、人事の面談を文字起こしするなら、「音声は自社のハードウェアから出ない」は好みではなく調達要件です。自分でホストするモデルだけが、その条件をきれいに満たします。二つめはオフライン動作です。端末の中のモデルは飛行機でも、地下でも、工場の床でも、電波のない現場でも動きます。whisper.cppやGGUFビルドのダウンロード数がそれだけ出ている理由は、まさにこれです。
三つめはコストで、数字が露骨です。同じArtificial Analysisのスナップショットで音声1,000分あたりの価格を見ると、fal.aiでホストされるWhisper Large v3が0.50ドル、ReplicateのNVIDIA Canary Qwen 2.5Bが0.74ドル、Together AIのParakeet TDT 0.6B V3が1.50ドルです。クローズド側はDeepgramのNova-3が4.30ドル、MAI-Transcribe-1.5が6.00ドル、Gemini 3.1 Pro Previewが18.15ドル。他人のサーバーでオープンモデルを動かすだけで、Microsoft比4倍、Google比12倍の差です。自分のサーバーで動かす場合はまだ計算にも入れていませんし、そちらは千時間目の限界費用が電気代です。
同じスナップショットの速度では、Together AIで提供されるParakeet TDT 0.6B V3が実時間の885倍、つまり1時間の音声を約4秒で処理します。Deepgram Nova-3は512倍、TogetherのWhisper Large v3は478倍、MAI-Transcribe-1.5は189倍です。最速として掲載されたのはオープンウェイトモデルですが、この結果はローカル機器ではなくTogether AI上のホスティングを測っています。

そもそも精度と精度の勝負ではありませんでした。制御とコスト対、認識を取り巻く機能の勝負です。
ではホスティングAPIは何を売っているのか。認識以外のすべてです。Deepgramのドキュメントがその目録を正直に示しています。話者分離、リアルタイムのストリーミング、整形、カスタム語彙、固有情報のマスキング、言語判定、そしてあなたが寝ている間もサービスが生きているという保証。Qwen3-ASRをダウンロードすれば、単語とタイムスタンプが手に入ります。話者ラベルはなく、SLAもなく、GPUの請求とスケーリングと午前3時の呼び出しはあなたのものです。
この分野で最もダウンロードされているモデルは、文字起こしモデルではない
ダウンロード傾向からは、文字起こしに加えて話者識別も求められていることが分かります。
Hugging Faceの自動音声認識カテゴリ全体をダウンロード順に並べると、いちばん上にいるのはWhisperでもQwenでもParakeetでもありません。直近30日で891万回のpyannote/speaker-diarization-3.1で、別のpyannote話者分離モデルが526万回で5位に入っています。話者分離は誰がいつ話したかを割り出す機構、つまり文字起こしのすぐ上の層です。

オープンウェイトは今や下の二層を覆っています。ノートが使えるかどうかを決める層は、その上にあります。
音声認識カテゴリで最もダウンロードされているモデルは音声を認識せず、誰がいつ話したかを識別します。この需要は、認識した言葉を役立つ会議記録に変える、文字起こしの上位層に注目が集まっていることを示します。クローズド市場の分析で述べた製品上の不足とも重なります。
結論
オープンウェイト音声認識について面白い問いは、そもそも「クローズドのモデルと同じくらい良いのか」ではありませんでした。単語誤り率で約1ポイント差まで来ており、より速く、4倍から12倍安く、ノートPCに収まります。面白い問いは、文字起こしが借りる費用項目であることをやめたときに空く場所に、何を建てるのかです。52言語を聞き取る1.56GBのファイルは製品ではありません。たったいま無料になった部品です。
モデルではなく会議ノートのツールを選ぶチームにとって、読むべきことは短いです。ある製品がオープンモデルを使うかクローズドAPIを使うかは、いまや概ね実装の詳細であり、次第に両方になるでしょう。量をこなす部分はオープンウェイトで、話者分離やストリーミングや規模が値段に見合う場所はホスティングAPIで。Telli.shはすでに要約層でオープンモデルを動かしているので、オープン側の改善が文字起こし、翻訳、会議ノートへ値上げなしにそのまま流れ込みます。ツールは最後に出てくる成果物で判断してください。そのノートが、誰が何をやると決めたのかを伝えているかどうかで。
出典
- Qwen3-ASR-0.6B-hf モデルカード (Hugging Face) — ライセンス、対応言語、2026年6月26日付のリーダーボード数値
- Qwen3-ASR-1.7B-hf モデルカード (Hugging Face)
- Qwen3-ForcedAligner-0.6B (Hugging Face)
- Qwen3-ASR Technical Report, arXiv:2601.21337 (2026年1月29日提出)
- OpenAI Whisper リポジトリ (MIT, 2022年9月16日公開)
- whisper.cpp / faster-whisper
- NVIDIA parakeet-tdt-0.6b-v3 モデルカード (CC BY 4.0)
- Mistral Voxtral-Small-24B-2507 (Apache 2.0)
- Artificial Analysis 音声テキスト変換リーダーボード — AA-WER v2、速度と価格は2026年8月5日取得
- Hugging Face Open ASR Leaderboard
- Deepgram 話者分離ドキュメント
- Wikimedia Commons 画像ページ
