40 多种语言实时互译,挂断即删:真正把会议留下来的,是多语言转写这一层
DeepL 于 2026 年 4 月 16 日发布支持 40 多种语言的 Voice-to-Voice,而同一款产品的 FAQ 写着:会议数据「在内存中临时处理,通话结束后即被删除」。8 月 28 日,Open ASR 排行榜首次加入全球南方语言,并显示两个在 4.9 WER 上难分高下的模型,在「精度随说话人来自哪里而波动的幅度」上相差近四倍。实时会议翻译正在变成大路货,记录还不是。
2026 年 4 月 16 日,DeepL 在科隆发布了 Voice-to-Voice:一套覆盖线上会议、移动端与网页对话、一线员工的群组场景,以及面向企业的 API 这四个界面的实时语音翻译产品。支持语言超过 40 种,包含全部 24 种欧盟官方语言,另加越南语、泰语、阿拉伯语、挪威语、希伯来语、孟加拉语和他加禄语。在 DeepL 委托、Slator 独立执行的盲测中,96% 的语言专家更倾向于它,而不是谷歌、微软和 Zoom 内置的翻译;Zoom 版 DeepL Voice 拿到 96.4 分(满分 100),竞品平台是 87 到 89 分。
这是一款认真做出来的产品,而值得写的并不是发布本身,而是同一个产品页 FAQ 里的一句话。我们在 2026 年 8 月 31 日又确认了一遍:
「DeepL 不会永久存储转写数据或翻译数据。会议数据在内存中临时处理,通话结束后即被删除。」
把这两件事并排读一遍。翻译很出色,而这份翻译到晚饭时就不存在了。
要点速览
- 实时会议翻译在 2026 年从难题变成了已经出货的大路货:DeepL 的 40 多种语言、Deepgram Nova-3 的 58 种单语言、以及塞进 Google Meet 的实时翻译。
- 「什么都不留」通常是刻意的隐私设计,不是缺陷。但结果是:会议本身没有留下任何可复查的产物。
- 多语言转写是下面那一层,是另一件事。它把原语转写、译文、说话人标签和摘要留在同一份可复查的记录里。本文讲的是:为什么必须留下的偏偏是原语,以及怎么把会开得让记录真的留得住。
我们在 6 月写过这个论点的谷歌版本,当时 Meet 和 Translate 正把实时语音翻译推给普通用户,那篇是为什么多语言会议仍然需要可复查的笔记。此后市场替我们回答了当时只是提问的部分:实时翻译现在真的可用了。于是有意思的问题挪了位置——到了周一早上,你手里还剩什么?
实时会议翻译已经不是难的那部分
有十来年的时间,实时跨语言语音一直是那种一碰到真实会议就散架的演示。延迟吃掉了轮流发言,口音打垮了识别器,稍微专业一点的内容出来就是一团糨糊。这个时代在大约十个月里结束了。
Deepgram 的 Nova-3 在 2025 年 12 月 10 日的发布说明里写着 31 种语言,到 2026 年 8 月的文档里写着 58 种:不到九个月里,有据可查的新增就有 39 种,大约每七天一种。这轮扩张以及它下面压着的免责细节,我们在语音识别语言覆盖里「支持」到底藏了什么里拆过。谷歌把实时语音翻译放进了 Meet。DeepL 在 4 月推出了四个界面的语音套件。
质量宣称如今也具体到可以拿来争论,这本身就是成熟的信号。DeepL 委托的 Slator 评估报告称 DeepL Voice 的错误率为 4%,竞争性会议平台的平均值为 17%,Zoom 版 96.4 分、Teams 版 96.3 分。厂商委托的数字就按厂商委托的数字来看待。但方向本身没有争议,认真报道这次发布的媒体指向同一处:The Next Web 在 2026 年 4 月 17 日的文章里写到,首尔的现场演示跑在一到两句话的延迟上,而 DeepL 的首席产品官承认,语言之间的语序差异仍然是语音对语音翻译速度的根本约束。
一到两句话的延迟够用了。它不足以在条约谈判里取代职业口译,也没有人这么宣称。但对一场连着华沙、首尔和圣保罗的周二产品例会,它绰绰有余——而那正是我们大多数人真正在开的会。
关键在这里:当一种能力以这个速度好到这个程度,瓶颈就会挪走。它已经挪走了。现在瓶颈在下面一层,在会议留下了什么这件事上。
按设计,译文活不过这通电话
回到那句 FAQ。那不是疏忽,那是一种安全姿态,而且是好姿态。DeepL 自己的表述接着说:所有数据传输中加密,绝不用于训练模型,并且「仅保留在会议参与者的本地设备上」。当银行或医院采购会议工具时,最快通过法务审查的答案就是「我们什么都不保存」。
同样的姿态在整个实时字幕品类里都很常见,因为存储多语言会议音频正是没人愿意接手的那类责任。于是行业默认值变成了:当下的理解极好,事后没有产物。
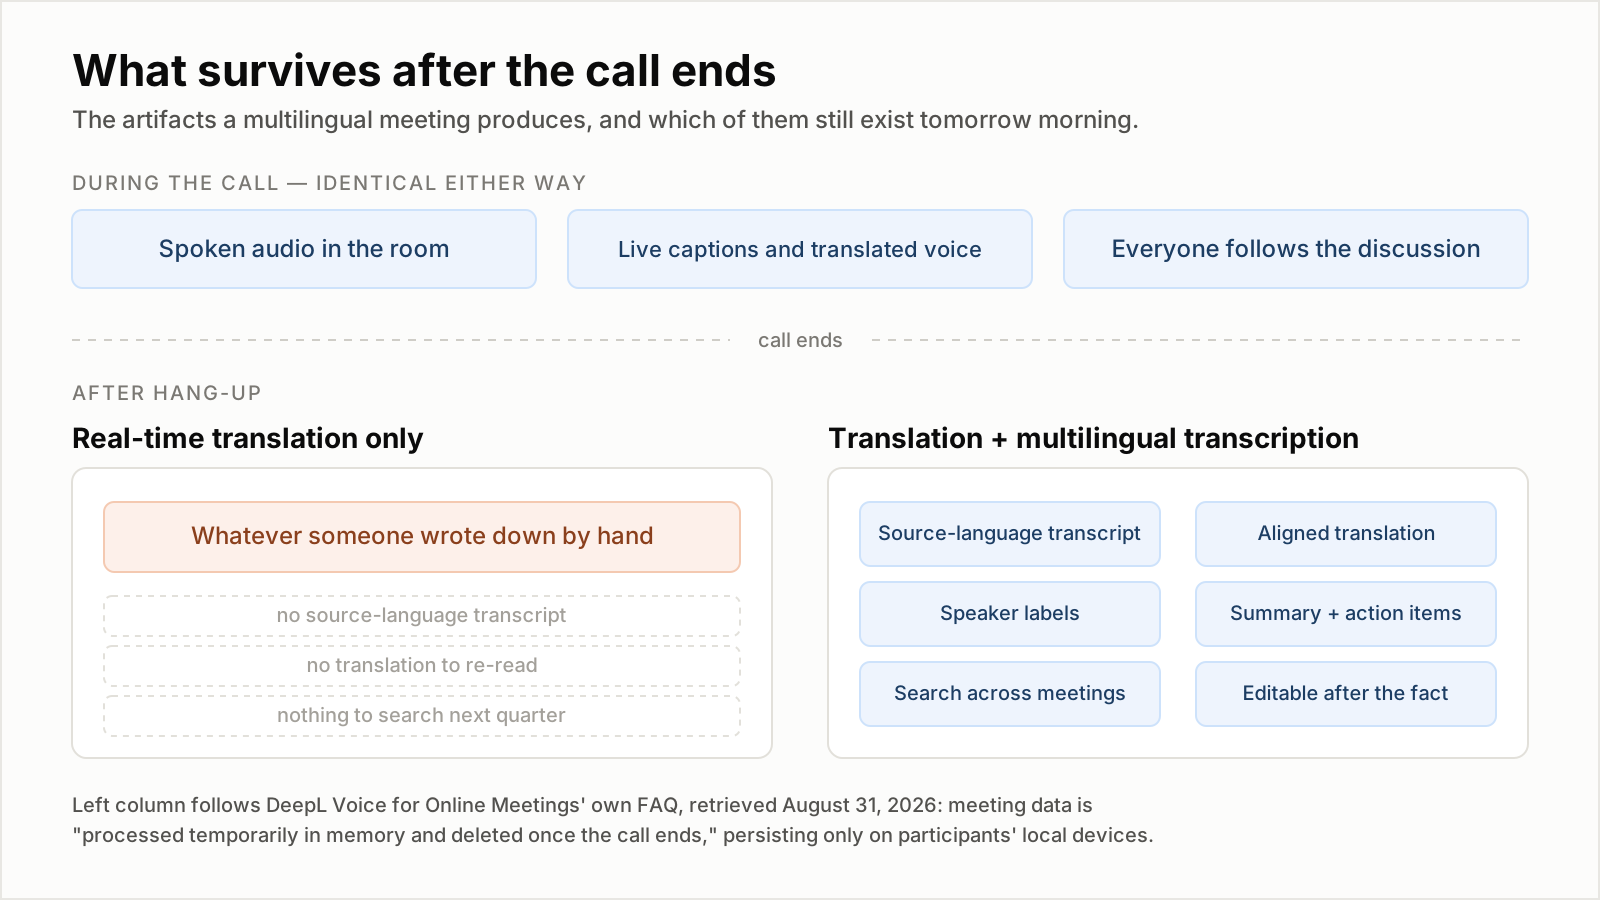
通话过程中,两种做法无法区分。差别全部发生在挂断之后。左栏依据 2026 年 8 月 31 日查阅的 DeepL Voice for Online Meetings 自家 FAQ。
这种结构造出来的失败有固定形状,需要一个名字。就叫决策漂移吧:所有人都完美理解了这场会,三周后却没有人能证明当时到底达成了什么。这不是误解——实时翻译干好了自己的活。问题在于,一个用两种语言做出的决定,唯一的副本存在五个人的记忆里,有五种说法,横跨至少两种语言,而记忆做的是重构,不是回放。
决策漂移的代价从不出现在工具的账单上。它出现在被重做一遍的功能里,出现在重新谈判的截止日期里,出现在没人答得上来的合规问题里,出现在一个无从得知团队上季度决定了什么的新人身上。
8 月 28 日:那个说明了你为什么需要原语的基准
如果转写是一件已经解决、且到处一样好的商品,那么留下记录就只是存储问题,这篇文章也会短很多。事实并非如此,而最清楚的近期证据是三天前落地的。
2026 年 8 月 28 日,Hugging Face 与 Voice Arena 把第一门全球南方语言加进了 Open ASR 排行榜:使用人口超过五亿的印地语,进入了此前只覆盖欧洲语言的多语言标签页。他们贡献了四个评测切分——Monsoon en-IN 与 hi-IN 的公开与私有版本——共 4,888 位互不重叠的说话人,每位记录 12 项属性,采自 428 个县区和数百种真实手机机型,而不是录音棚。
然后他们把排行榜上现成的模型放到这套数据上跑了一遍。结果是本月关于语音识别最有用的一份材料。
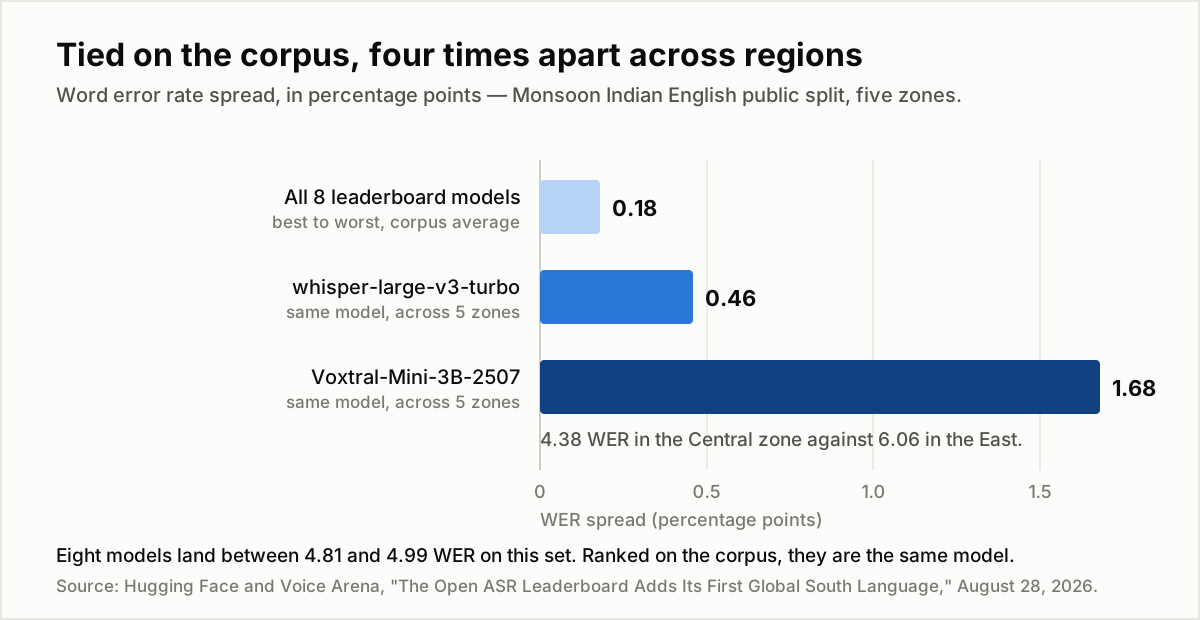
同一根轴,同一个单位:被比较的两方相差多少个 WER 百分点。来源:Hugging Face 与 Voice Arena,2026 年 8 月 28 日。
排行榜上的八个模型,在印度英语公开切分上都落在 WER 4.81 到 4.99 之间。最好与最差相差 0.18 个百分点——五小时的音频根本分辨不出这个差距。按原文的说法:按语料排名,它们就是同一个模型。
可是把说话人按地区分组,它们就不再是同一个模型了。把每位说话人的原籍县区上卷到分区委员会一级,openai/whisper-large-v3-turbo 在五个区之间只波动 0.46 个百分点。而在语料均值上仅落后它 0.14 个百分点的 mistralai/Voxtral-Mini-3B-2507,波动了 1.68 个百分点:中部区 WER 4.38,东部区 6.06。两个在排行榜上分不出高下的系统,在「精度有多依赖说话人在哪里长大」这件事上相差近四倍。
而且并不是某个地区天生更难。ibm-granite/granite-speech-3.3-2b 在北部最差,microsoft/VibeVoice-ASR-HF 在南部最差,Voxtral 在东部最差。如果真有某个区本质上更难,所有模型排出来的顺序应该一样。它们不一样,这说明问题出在模型身上,不在音频。
对于要主持多语言会议的人,该读出来的是这句:你的转写质量不是一个能查到的数字,而是一个取决于房间里坐着谁的函数。你的厂商采样最少的那种口音,正属于那位同事——他的句子会出错,而排行榜和厂商页面都不会提醒你。唯一的防线是一份人能读、能改的转写,而这要求转写首先得存在。
印地语的同一个短语有十种写法,翻译只挑其中一种
同一份发布里的第二个发现更微妙,也更贴近本文的论点。
英语的拼写变体是有边界的:英式对美式、标点、数字写成阿拉伯数字还是词。归一化器能把大部分映射到一种形式。印地语没有这种边界。日常口语大量夹杂英语,英语来源的词没有稳定的天城文拼法,复合词按个人习惯或连写或分写。同一个短语可以有十种以上有效写法,而且根本不存在可以把它们归拢过去的「正统」一侧。
所以印地语切分随附一份格架(lattice):转写的每一段都带上一组被判定为正确的写法。评分也不用普通 WER,而用 AI4Bharat 提出的 OIWER,即计入正字法的词错误率。当同一批模型输出被拿去对着「压平成单一参考」的版本重新评分时,所有系统的错误率都上升了,上升幅度并不一致,而且成对系统的排名发生了翻转。在单一参考下,模型有一部分分数是靠复现标注员选的那种拼法拿到的;在格架下,评的只有识别本身。
停下来想想这意味着什么。哪怕在「到底写成什么」这一层,正确答案往往也不是一个字符串,而是一个可接受的集合——而从集合里挑一个的那一刻,信息就被丢掉了。
翻译就是同一种压缩,只是发生在更上一层,而且损失大得多。每一行译文,都是替原文做了一个原文本来不必做的选择。
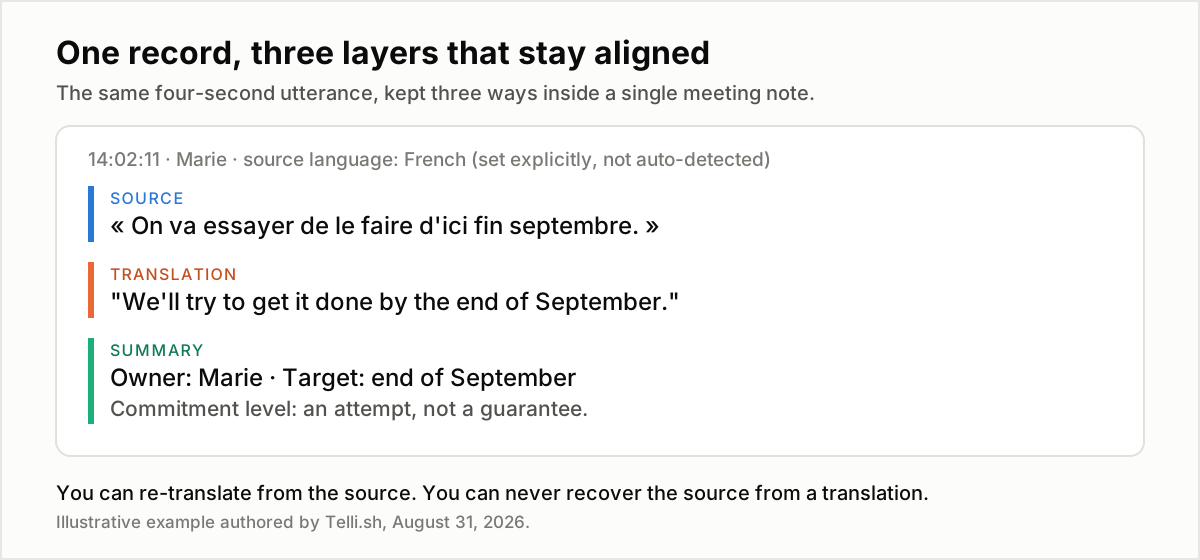
三层里,唯一无法从另外两层重新生成的,是原语那一行。
当「On va essayer de le faire d'ici fin septembre」变成「我们会争取在九月底之前做完」,确实有东西变了:法语 essayer 携带的那种特定的留有余地的语气,被「争取」压平了。那到底是承诺,还是意向?译文那行回答不了,原语那行可以。六周后日期滑了,两个团队对这句话记得不一样时,原语那一行就是全部的论据。
这就是整个话题正中央的那处不对称。翻译是单向的。 你可以从原文一译再译,明年换更好的模型再来一遍。但你永远无法从译文倒推回原文。
通话结束之后还剩什么:实时翻译器 vs 带笔记的会议翻译器
把团队目前处理多语言会议的三种方式并排摆出来,直说。
| 第二天早上你手里有的 | 实时翻译层 | 人类口译员 | 带笔记的会议翻译器 |
|---|---|---|---|
| 当场的理解 | 有 | 有,质量最高 | 有 |
| 会议音频 | 仅当你另外录音 | 仅当你另外录音 | 有 |
| 原语转写 | 无 | 无,除非另行转写 | 有 |
| 与原文对齐的译文 | 无 | 无 | 有 |
| 哪句话是谁说的 | 无 | 无 | 有,带说话人标签 |
| 摘要与待办事项 | 无 | 口译员自己的笔记(如果有) | 有,由转写生成 |
| 三个月后可检索 | 否 | 否 | 是 |
| 出错的一行能否修正 | 否 | 事后不能 | 能,直接编辑记录 |
| 每小时大致成本 | 软件订阅 | 100 至 200 美元以上,长会需两名口译 | 软件订阅 |
「会消失」那一栏的行为依据 2026 年 8 月 31 日查阅的 DeepL Voice for Online Meetings 公开 FAQ;口译费率取的是职业会议口译公开的市场区间,随语言对与市场而变。第三栏描述的是「带笔记的会议翻译器」这一整个品类,不是某一家厂商。
这张表的形状本身就是论点。第一栏和第三栏,在买家通常唯一会去评估的那一行——当场的理解——上完全相同,而在会议结束之后才有意义的每一行上都分道扬镳。厂商对比几乎永远只跑第一行。
实时翻译器是一扇窗。带笔记的会议翻译器是一扇窗,同时也是一本账。团队买窗,因为那是他们亲身体验到的部分;然后他们靠一本从没买过的账本过完一个季度。
怎么开一场让记录真的留得住的多语言会议
六步,按会议里发生的顺序排。没有一步是花哨的,失败几乎总是因为没人做过决定。
- 明确指定原语,不要依赖自动检测。 自动检测必须在整场会议里上下文最贫乏的头几秒就把话押下去,而一旦押错,下游每一个环节会同时变差。显式选择还能让引擎把你路由到专用的单语模型,它通常比多语模型更强——比如 Nova-3 逐个记录了 58 种单语语言,但代码切换只支持恰好 10 种。
- 把人们会「说」的语言和人们会「读」的语言分开。 这是两份不同的清单,把它们当成一份是这个品类里最常见的配置错误。DeepL 自己的帮助中心就是这么分的:「口说语言」是识别器能接受的清单,「翻译语言」是字幕可以显示的清单,而后者长得多。
- 在开会之前就决定记录落在哪里,并确认那不是会议平台本身。 如果你的翻译厂商在挂断时删除会议数据——这是默认行为,而且是站得住脚的默认行为——那么在那个工具里怎么设置都不会产生记录。留存必须是一个有意为之的、单独的选择。
- 保持说话人标签开着。 一行没有归属的译文,对它日后可能支撑的任何决定都毫无用处。「我们九月之前做完」只有在知道是谁说的之后,才成为一个事实。
- 在头五分钟里实时纠正人名和专业术语。 专有名词、产品代号和缩写是转写稳定翻车的地方,也是错误行对事后生成的摘要伤害最大的地方。会还在开的时候改,只花几秒;在一份没人会重读的文档里改,成本为零——因为没人会重读。
- 尽可能从原语转写而不是从译文生成摘要。 对译文做摘要,等于把两道有损工序叠在一起。这一条是我们的建议而非跑过基准的结论,但机理很直白:每一道工序都在丢信息,叠起来丢得更多。
然后把这三样产物放进同一份记录里。转写在一个工具、译文在聊天记录、摘要在文档里,这三个文件一个月之内就会互相打架——而那种打架,正是你本来想要避免的东西。
结论:理解曾经是带宽问题,记录是记忆问题
实时会议翻译解决的是带宽问题:把意思以足够快的速度送过桌子,快到对话仍然像对话。到 2026 年,40 多种语言、一到两句话的延迟、盲测里 96% 的偏好率,这个问题基本上被解决了,而且每个季度都在变便宜。
多语言转写解决的是记忆问题,而带宽那边的解法完全碰不到它。产物不同,留存策略不同,失败方式也不同。只买了前者却以为顺带买到了后者的团队,会继续开一场又一场出色却无法交代的会。
所以下次和厂商开会时值得带上的问题,不是「你们能翻多少种语言」。如今任何一家正经厂商都会给出一个大于 40 的数字。该问的是:通话结束时,还剩下什么,以及那是谁的语言?
Telli.sh 在这里的位置: 上面所有内容讲的都是实时翻译底下那一层,而那正是我们做的东西。Telli.sh 提供实时转写并同步翻译成 44 种目标语言,界面本身有 15 种语言,因此身在华沙的参与者可以一边开会一边用波兰语读韩语站会。真正在第二天早上起作用的是:三样产物留在同一条笔记里——实际说出口的原语文本、与之对齐的译文、以及在此之上生成的摘要,在通话结束很久以后依然可复查、可修正、可检索。
来源
- Hugging Face 与 Voice Arena,"The Open ASR Leaderboard Adds Its First Global South Language",2026 年 8 月 28 日 —— Monsoon en-IN 与 hi-IN 切分、4,888 位说话人、分区 WER 波动、OIWER 与印地语格架。
- DeepL,"DeepL unveils real-time spoken translation, breaking the next language barrier with Voice-to-Voice",PR Newswire,科隆,2026 年 4 月 16 日 —— 40 多种语言、四个产品界面、DeepL 委托的 Slator 盲测。
- The Next Web,"DeepL launches real-time voice-to-voice translation in 40+ languages",2026 年 4 月 17 日 —— 首尔演示的延迟与语序约束。
- DeepL,DeepL Voice for Online Meetings 产品页与 FAQ,2026 年 8 月 31 日查阅 —— 数据留存表述、Slator 分数,以及线上会议的语音对语音功能仍在分批推出的说明。
- DeepL 帮助中心,DeepL Voice languages,2026 年 8 月 31 日查阅 —— 口说语言与翻译语言的区分。
- AI4Bharat,Orthographically-Informed Word Error Rate —— 印地语切分所用的指标。
- Deepgram Nova-3 的语言覆盖,整理自我们自己的文章语音识别语言扩张分析,2026 年 8 月 31 日。