三天四个前沿模型,可没人会告诉你你需要的是哪一个
2026年9月1日到3日,Anthropic、Meta、Google和OpenAI接连发布前沿模型,CNBC给由此产生的疲惫起了个名字:模型疲劳。发布数量是这件事里最无聊的部分。有意思的是,每一次发布都会制造出一场必须由下游某个人来跑的评测,而发布模型的公司完全没有理由帮你省掉它。本文拆解一次模型更换的真实代价,为什么每token更便宜并不等于每任务更便宜,以及为什么只为一件窄活儿打造的全托管软件,是唯一能让别人替你做决定的形态。
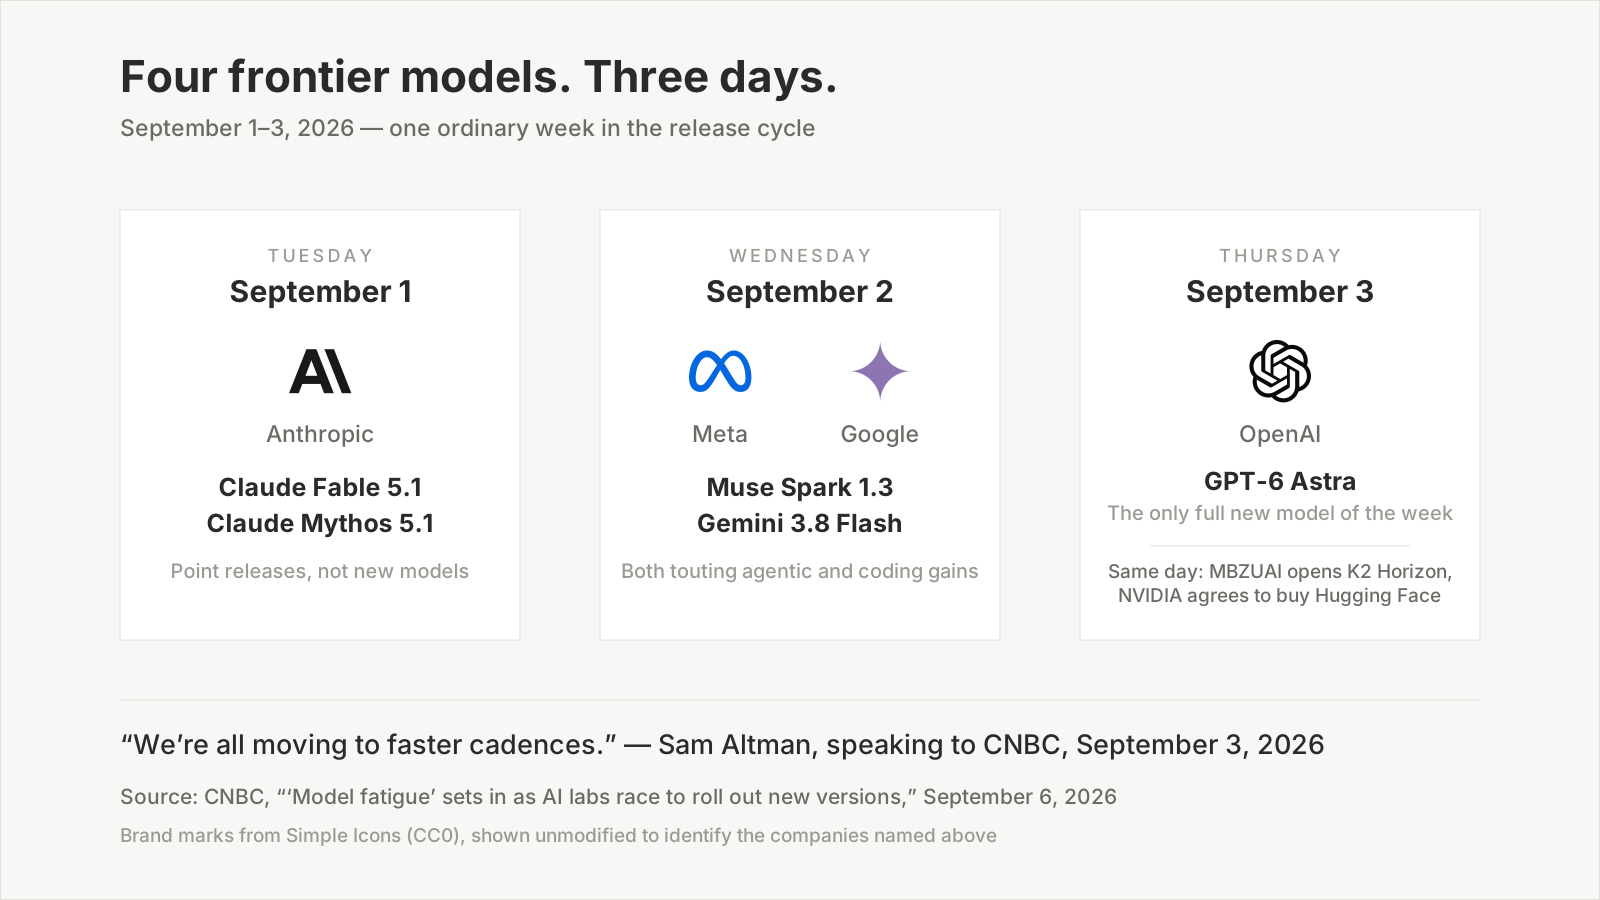
品牌标识来自 Simple Icons(CC0),未经修改,仅用于标识文中提到的公司。发布日期与Altman的引语来自CNBC 2026年9月6日的报道。
2026年9月第一周的周二到周四,Anthropic发布了Claude Fable 5.1和Claude Mythos 5.1,Meta发布了Muse Spark 1.3,Google发布了Gemini 3.8 Flash,OpenAI发布了 GPT-6 Astra。同样是那个周四,位于阿布扎比的穆罕默德·本·扎耶德人工智能大学(MBZUAI)向全世界开放了K2 Horizon系列,NVIDIA则同意以12,930,300,000美元 收购Hugging Face。
六项发布。三天。CNBC在9月6日周日发出了这篇报道,标题用的是一个在从业者中间已经流传了几周的说法:模型疲劳。
最顺手的读法是:这个行业跑得比任何人跟得上的速度都快。这个读法没错,也基本没意思。真正值得你注意的是另一件事:每一次发布都在转移一笔成本,而这个转移只朝一个方向流动。实验室发出的每一个模型,都会变成下游某个人必须跑的一场评测——而上游没有任何一方有半点理由帮你跳过它。
TL;DR
- 三天之内落地四个前沿发布(2026年9月1日至3日);CNBC在9月6日把由此产生的疲惫命名为“模型疲劳”。
- 真正的成本不是注意力,而是评测的人力。一位企业CEO告诉CNBC,当他的团队想为某项任务评估10个模型时,实际大约只测5个。
- 每token价格是每任务成本的糟糕代理指标——更强、更贵的模型可能因为步骤更少而把更难的活儿做得更便宜。
- 模型厂商在结构上就没有兴趣告诉你什么时候更便宜的模型就够了。这道缺口,正是托管型、专用型软件存在的全部理由。
模型疲劳在9月6日有了名字
“我觉得模型疲劳是真实存在的。”AI基础设施创业公司Runpod的CEO Zhen Lu对CNBC说,“别误会,我对正在发生的所有创新都极度兴奋,但我确实认为我们身处一个泡沫太多、以至于你不得不制造噪音的环境里。”
同一周,Sam Altman向CNBC给出了一个更温和的说法:“我们都在转向更快的节奏。”他把部分加速归因于大家“休完暑假回来了”。
两件事可以同时成立。节奏确实在加快,而这种加快也确实有一部分是表演。在AI领域做了25年的圣母大学门多萨商学院教授Ahmed Abbasi把商业逻辑说得很直白:这些实验室“都在玩钱包份额的游戏”。走向公开市场的Anthropic和OpenAI推得最狠,两家在私募投资者眼中的估值都已接近1万亿美元。
这个钱包大得惊人。Gartner在2026年5月预测,全球AI支出将比2025年增长47%,在今年达到2.59万亿美元。基础设施占去最大的一块,但其中远超1万亿美元会落到服务、软件、安全、模型和工具上——也就是说,落到必须由某个人来做的决定上。
关键在这里:一个这么大、长得这么快的市场,奖励的是声音大。它不奖励告诉客户“你用更少的东西就够了”。
成本不是注意力,是那场你跑不完的评测
问一个从业者,模型疲劳实际是什么感觉,你不会听到“我读了太多发布文章”。你听到的是算术。
企业AI创业公司Clockwork Systems的CEO Suresh Vasudevan给了CNBC整篇报道里最有用的一个数字。他说,如果公司想为某项任务评估10个AI模型,可能只会挑其中五个。“要把现在冒出来的每一个都评估一遍,真的非常困难。”
请在这个比例上停一停,因为它是整个话题的承重事实。一家主业本身就是企业AI、有专门做这件事的专业人员、并且为这个目的专门划拨了算力预算的公司,只评估了它自己认为值得评估的候选者中的一半。
我们把另一半叫作未被测试的那五个。它们没有被否决。没有人发现它们不行。它们只是从来没被跑过;于是“它们中的某一个是否会在你自己的工作负载上更快、更便宜或更准确”这个问题,就永久地悬在那里。每一个有发布的星期,这堆东西都会再高一层。
而清理这堆东西很贵,因为换模型不是版本号上调,是一次重新认证。在一个新模型进入生产之前,实际必须发生的事情是这些:
| 必须重新核对的东西 | 新模型为什么会把它弄坏 |
|---|---|
| 提示词与系统指令 | 它们是针对旧模型的脾气调出来的;能稳定驾驭一个模型的措辞,可能把另一个模型带去别的地方 |
| 输出格式的稳定性 | 下游解析器依赖形状——JSON、标题层级、分隔符——而排版习惯会在模型之间变化 |
| 在你真实数据上的准确率 | 基准分差是在公开数据集上测的,不是在你的会议、你的工单、你的代码库上测的 |
| 工具与API行为 | 智能体型模型在何时调用、重试多频繁、调用失败时怎么做上各不相同 |
| 负载下的延迟与吞吐 | 单次请求更快的模型,在你的限流背后可能更慢 |
| 在你的用量下的总成本 | 每token价格 × 消耗的token × 尝试次数——见下文 |
| 安全与拒答行为 | 边界会在版本之间朝两个方向移动 |
| 回归用例 | 那些你已经修好的具体失败,别人的基准测试根本不知道它们存在 |
八个类别,每一个都需要真实样例、一次对照运行,以及某个人的判断。这是一个项目,不是一次配置改动。再乘以任意一个月里的前沿发布数量,10比5这个比例的原因就一目了然了。
关于如何 在你自己的工作负载上做这件事 而不是相信排行榜,我们专门写过一篇;诚实的结论是,认真做完要花几天,不是几小时。
每token更便宜,不等于每任务更便宜
整个故事里最反直觉的发现,不是来自实验室,而是来自一位试图把这个选择自动化的工程师。
开源AI网关LiteLLM的产品工程师Moe Khalil在9月4日发表了一篇题为《Model Fatigue is Real》的文章。他做的正是LiteLLM的自动路由器——一种全部工作就是替你挑模型的软件——而且他在开头就披露了这层关系,这比写这个话题的大多数人都做得好。
他团队的出发假设是那个直觉性的假设:拿两个都能解决同一任务的模型,按模型卡上每token价格便宜一半的那个,应该以大约一半的价钱把它解决。
测试结果不是这样。更强、更贵的那个模型,正在以便宜模型成本的一小部分解决更难的任务。Khalil的解释是:“因为它更聪明,它会采取更聪明的路径,会快得多地做出成品。”
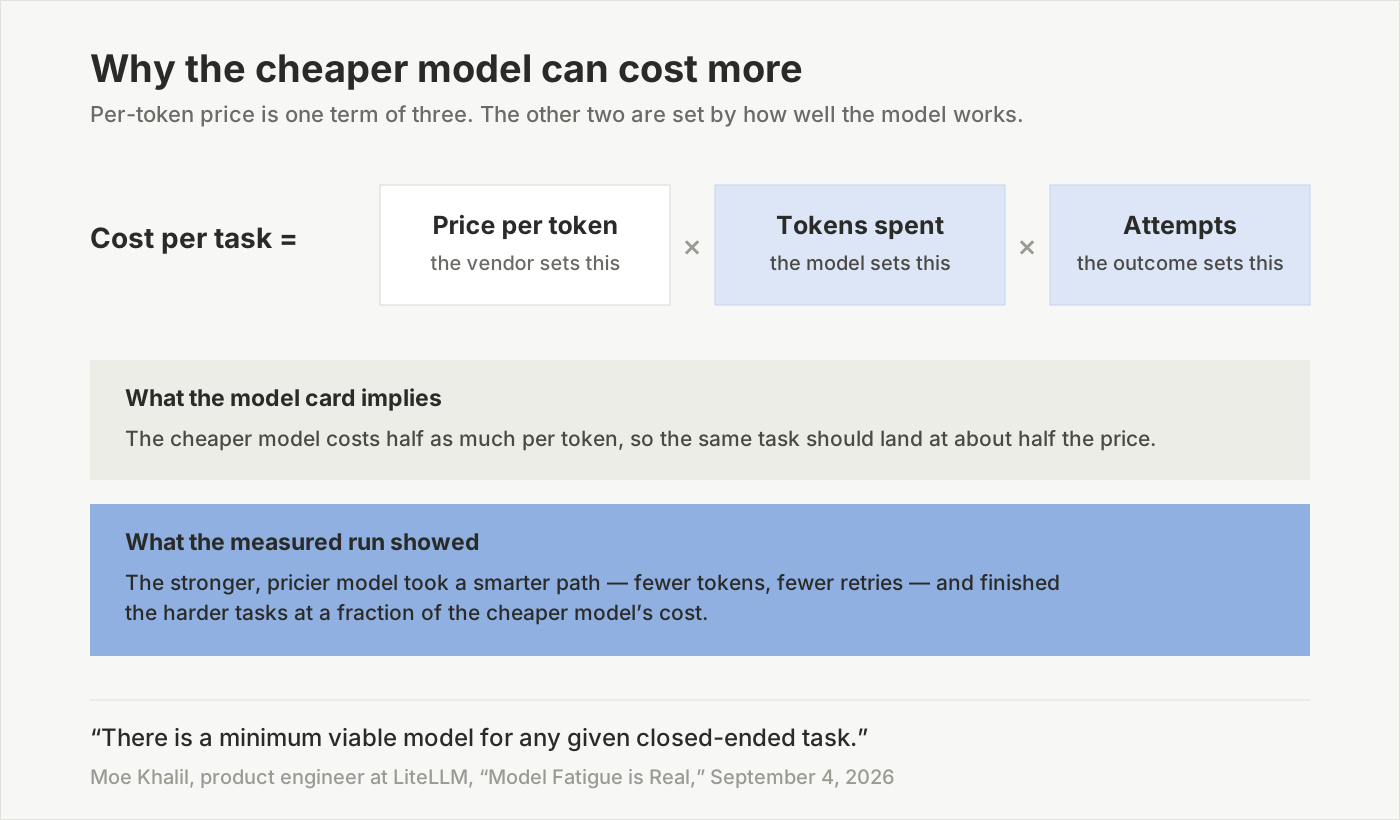
三项里只有每token价格会出现在定价页上。另外两项是模型能力的属性,只有当你真的把活儿跑一遍时它们才会现身。
这彻底重构了定价页的意义。厂商标出的那个数字,只是三项乘积中的一项:每token价格、消耗的token,以及任务真正成功所需的尝试次数。第一项由厂商定。第二和第三项由模型本身决定,而在你把自己的活儿跑一遍之前,两者都不可知。
这意味着,别人教你做的那种比较——扫一眼价格列,挑便宜的那个——不只是不完整。在真实任务上,它可能指错方向。
上游没有人有动机告诉你
接着Khalil说出了那句大家都咽下去的话,也是今年就这个话题写下的最锋利的一句:
“对模型公司来说,这种懒惰是特性,不是缺陷。他们更希望我用[顶级模型]来总结我的邮件,而当更便宜的模型同样管用时,他们没有动机告诉我。他们的工作是不断推进前沿。至于什么时候不该用前沿,那是留给我自己去弄明白的事。”
带着Gartner那个数字再读一遍。一个2.59万亿美元、每年增长47%的市场,供给方从每一位默认往上选的客户身上获益,而客户花超了,他们不承担任何代价。
这不是阴谋,也不需要任何人使坏。这只是激励梯度长出来的样子。一家前沿实验室的工作是推动前沿。告诉你去年的中端模型就能处理你80%的工作负载,那是别人的工作,而直到不久之前,那根本不是任何人的工作。
Abbasi的第二个观察也属于这里。他认为所有主要开发方在同一周宣布“不是巧合”,AI金融创业公司Farsight的技术负责人Noah Faro也同意,并指出竞争对手有一部分是从云算力的可用情况读出彼此计划的,因为他们都在向同样那几家供应商抢容量。Faro还泼了一盆冷水:与GPT-6 Astra不同,那一周Anthropic、Meta和Google的发布都是小版本发布,是对现有模型的升级而不是新模型。在他的判断里,真正改变局面的最近两次发布,是6月Anthropic的Fable 5和7月Moonshot AI的Kimi K3。
所以:六项发布,一个真正意义上的新前沿模型,以及给下游所有人凭空生成的一整轮评测工作量。
行业吸收这件事的两条路,它们并不一样
如果实验室不肯做这个决定,就得有人来做。目前出现了两个答案,而它们在结构上完全不同。
横向的答案是路由。 像LiteLLM这样的网关把所有模型放在同一个API密钥后面,试图逐请求地做选择。Khalil把技术难题描述得很准确:对任何封闭式任务,都存在一个最小可用模型——仍能成功的最便宜的那个——难点在于,要在任务跑起来之前就预测出它是哪一个。他团队目前最好的做法是结合公开基准数据和提示词里的启发式规则来推断;他们也试过用LLM做分类,以及各种混合方案。他自己的评价是:“都还不完美,但比什么都没有强一档。”
路由是真正的工程,而且确实有用。但要看清它移动了什么、没移动什么。它吸收的是管道——一把密钥,一个接口,自动接上新模型。它吸收不了问责。当路由器选错时,那个糟糕的输出仍然是你的,在你的产品里,摆在你的用户面前。答案好不好,评判仍然归你。
纵向的答案是为一件活儿打造的全托管软件。 在这里,厂商不替你在模型之间做路由;它把整件任务从你手上拿走,交付一个成品。你看不到模型名。你看到的是一份转写、一份摘要、一份翻译、一张已提交的报销单。
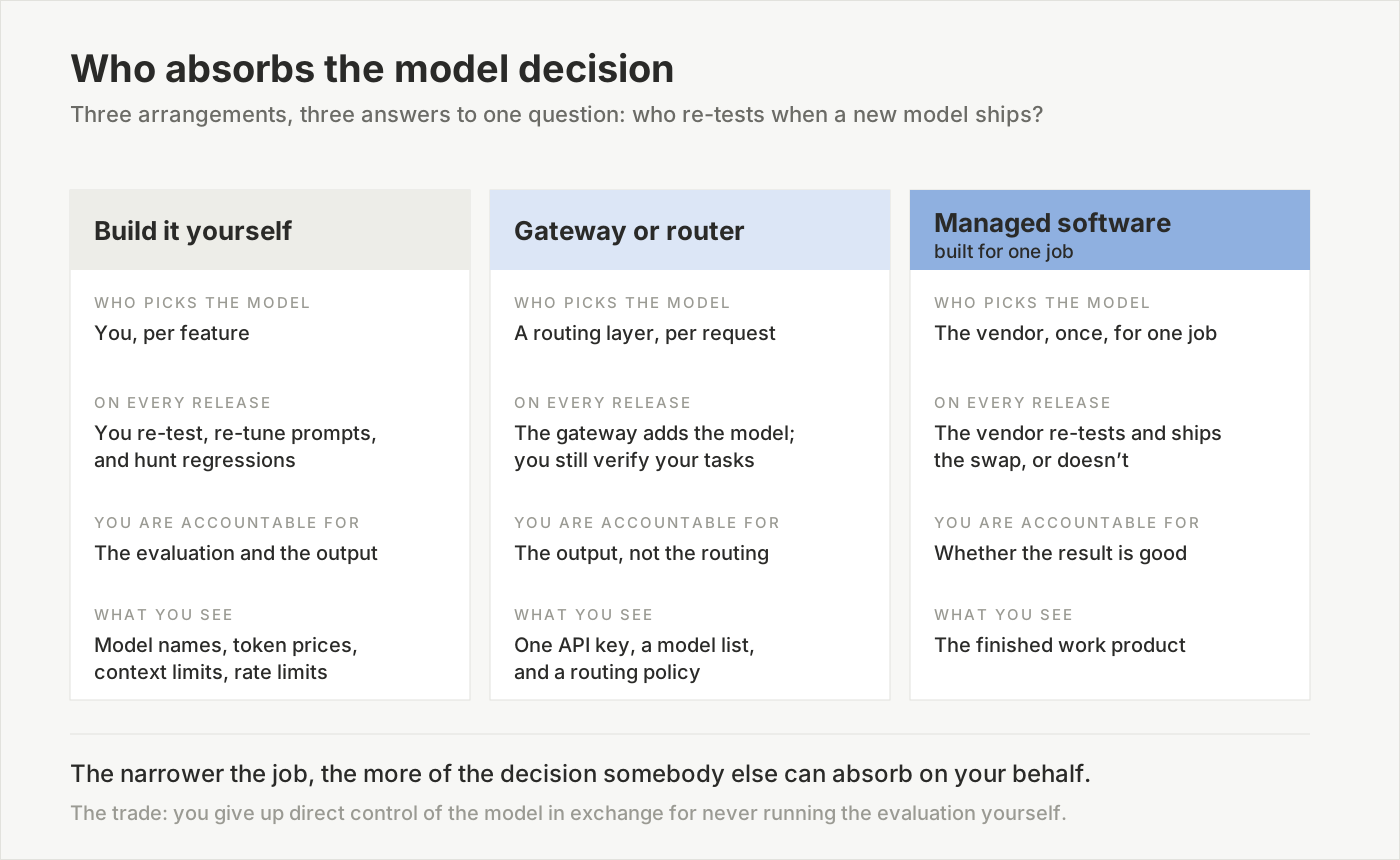
越往右,留给你的决策越少——而你越依赖厂商是否诚实地做完了那场评测。
本地AI社区从相反的方向抵达了类似的结论。今年发布的一篇分析把小模型圈子形容成一台跑步机:下载、配置、跑几个提示词、半吊子地下个判断、然后奔向下一个发布。它的建议是停下来——固定在一套已验证的日常主力配置上,只有在真实的、有代表性的任务上试得足够久、确认它对你的具体工作负载确实更好之后,才采纳新模型。同一个结论,由一个拥有两块GPU的爱好者和一个握着算力预算的CEO分别抵达:认真选一次,别每个周四都重新审一遍。
为什么活儿窄,决定才吸收得掉
下面是我们的看法,也是这个品类之所以存在的原因。
模型决定只能由懂这项任务的人来做。这句话听起来像废话。它不是,因为它把几乎所有人都排除在外了。
一个通用聊天界面没法替你做这个决定,因为在任意一个早晨,它可能被要求写一首十四行诗、调试一个竞态条件,或者总结一份租约。对“用户接下来输入的任何东西”而言,不存在最小可用模型。唯一安全的默认值是可获得的最强模型——而那恰恰是符合厂商利益的默认值,也恰恰是Khalil所说的、没有人有动机劝你放弃的那个默认值。
网关能猜得好一些,因为它看得到提示词。但它看提示词时并不知道在你的领域里一个好答案长什么样,而且猜错了也不用付代价。
专用的托管软件处在完全不同的位置上。当活儿是固定的——为一场四位讲话者在中文和英文之间来回切换的60分钟会议做转写,然后产出行动项——这项任务就恰好是Khalil意义上的封闭式任务。它存在一个最小可用模型。而且关键在于,对每一位有着同样这件活儿的客户来说,那是同一个最小可用模型,这意味着评测只需要跑一次,成本被摊到所有人头上。
这就是这个品类的全部经济论证,值得写成一条规则:活儿越窄,模型决策中能由别人替你吸收的部分就越多。 一家服务单一工作负载的厂商付得起把10个候选全部测完的成本,因为它只测一次,为成千上万的客户,对照一个固定的“好结果”定义。而你自己测五个,为你一个人,对照一个还得你自己发明的定义,是花更多的钱拿到更差答案的方式。
这笔交易是真实的,也值得如实说明。你放弃了对“哪个模型在跑你的活儿”的直接控制权。作为交换,你不用再跑评测,不用再盯发布日历,而你要评判的东西变成了输出——那本来就是你唯一真正在意的东西。
怎么判断你买的是哪一种安排
在你下一次采购AI之前,按顺序问四个问题:
- 这件活儿是封闭式的吗? 你能用一句话说清正确的输出长什么样吗?如果能,一个托管的垂直工具就可以接管这个决定。如果答案是“看我们问它什么”,那你买的是一个通用模型,评测仍然归你。
- 新模型发布时,谁来重测? 直接问厂商。一家托管厂商应该能说清自己的评测集和更换流程。如果答案是你会“用上最新的模型”,那你买到的是管道,不是判断。
- 你看到的是模型还是结果? 如果产品把模型名、上下文窗口和token价格摆在台面上,它就是在把决定还给你。那也是一种正当的产品,但请照此定价。
- 在你的用量下总成本是多少? 每token价格,乘以在你的活儿上实际消耗的token,再乘以做对它所需的尝试次数。跑你自己的任务。定价页回答不了这个问题。
结论:前沿是一个默认值,不是一个决定
模型疲劳通常被描述成注意力问题——新闻太多、太快。它不是。它是科技行业增长最快的市场悄悄转嫁给客户的一笔成本,如今它就停在那里,没有定价,也基本没有被测量。
实验室会继续发布,因为发布就是他们的工作,而市场为此付钱。评测负担会继续增长,因为它随每一次发布机械地增长。而大多数团队会用一个忙碌团队唯一可用的方式来解决它:伸手去拿最新、最大、最贵的那个模型——那是唯一一个在会议上不需要任何人辩护的选项。
每一款把一件活儿整个从你手上拿走、并且从不向你展示模型名的软件,都是在赌上面那种做法是一种糟糕的经营方式。每一个有发布的星期,这个赌注看起来都更划算一点。
Telli.sh的位置: 这正是我们在做的品类。Telli.sh录制会议、区分说话人、以15种语言实时翻译,并生成摘要与行动项——而且它从不问你要用哪个模型,因为那是我们的工作,不是你的。我们的浏览器扩展确实提供了九种翻译引擎,包括一个完全在本地设备上运行的选项,那是给真正想要这份控制权的人准备的;而会议产品刻意不这么做,因为“把这场会议转写好”是一项封闭式任务,我们宁愿被人评判转写本身,而不是背后的模型。
来源
- CNBC, "'Model fatigue' sets in as AI labs race to roll out new versions at dizzying pace," 2026年9月6日 — 2026年9月1日至3日的发布时间线;Zhen Lu的“模型疲劳是真实存在的”引语;Sam Altman的“更快的节奏”说法;Ahmed Abbasi关于“钱包份额游戏”与接近1万亿美元的私募估值;Noah Faro关于小版本发布,以及Fable 5和Kimi K3是最近两次真正改变局面的发布;还有Suresh Vasudevan的“10个里评估五个”这一数字。采访贡献者 Kate Rooney 与 MacKenzie Sigalos;2026年9月8日检索
- Moe Khalil, "Model Fatigue is Real," 2026年9月4日 — “更便宜的模型管用时没有动机告诉我”的论点;针对封闭式任务的最小可用模型框架;以及“更强更贵的模型以便宜模型成本的一小部分解决了更难任务”的实测结论。Khalil在文中披露自己是LiteLLM的产品工程师,该公司做自动路由器;2026年9月8日检索
- Gartner, "Gartner Forecasts Worldwide AI Spending to Grow 47% in 2026," 2026年5月19日 — 2026年全球AI支出2.59万亿美元,同比增长47%,AI基础设施为最大细分
- MindStudio, "Local AI Model Fatigue: Why One Setup Beats Chasing Every Release" — 把本地小模型发布周期形容为跑步机,以及固定在一套已验证日常主力配置上的论证
- AI타임스, "[9월7일] '일주일에 4개나 출시'...커지는 '모델 피로감'," 2026年9月7日 — 转述CNBC报道及周边开发者评论的韩文报道
- 我们对NVIDIA收购Hugging Face的解读 — 同一周的另一项发布,也是这里提到的每一个模型底下的分发层
- 如何在你自己的工作负载上衡量转写准确率 — 认真跑一次真实评测到底要花多少