75分が40分に:GPT-6 Astra が本当に得意なこと
OpenAI は2026年9月3日に GPT-6 Astra を公開し、世界で最も知的なモデルと呼びました。しかし自社のベンチマーク表はもっと鋭い話をしています。狭い課題での飛躍は巨大(Terminal-Bench Science 22.4%→64.6%、SRE-Bench 55.9%→88.0%、OSWorld は課題あたり47%の時短)である一方、中立的な総合指標は0.3ポイントしか動きませんでした。どこが本物でどこに脚注が付くのか、そして100万トークンのテキストモデルが依然としてできないことを整理します。
2026年9月3日、OpenAI は GPT-6 Astra を公開し、「世界で最も知的で、最もアラインされたモデル」と表現しました。
ところが同じ発表文のベンチマーク表を4行下ると、Artificial Analysis Intelligence Index v4.1.1 の行があります。Astra 61.2、GPT-5.6 Sol 60.9、Claude Fable 5.1 65.7。新しいフラッグシップが自社の前世代を0.3ポイント上回り、競合には4.5ポイント劣るという数字を、OpenAI 自身が掲載しています。
どちらも事実です。そしてその間の緊張こそが、今回の発表のすべてです。これは全般的に賢くなったモデルではありません。特定のリストにある仕事が劇的にうまくなったモデルであり、そのリストを正確に知っておく価値があります。マーケティングの要約とは、両方向にずれているからです。
要点:
- 狭い領域の伸びは巨大で、一次資料で確認できます。 Terminal-Bench Science 22.4%→64.6%、SRE-Bench の1回試行 55.9%→88.0%、ScreenSpot-Pro 76.9%→92.7%、512K–1M 帯の MRCR 8-needle 検索 73.8%→96.3%。いずれも GPT-5.6 Sol 比で、いずれも OpenAI 公開の表からの数値です。
- 速度の改善はどのスコアより重要かもしれません。 OSWorld 2.0 で Astra は課題あたり約40分で 72.6%、Sol は約75分で 65.7%。時間にして約47%の短縮です。
- 総合指標はほとんど動いていません。 OpenAI 自身が印刷した唯一のベンダー横断指標で、Astra は Sol 比 +0.3、Claude Fable 5.1 比 −4.5。さらに自社表の学術項目で唯一負けている行があります。ツール使用の Humanity's Last Exam、57.2% 対 65.0%。
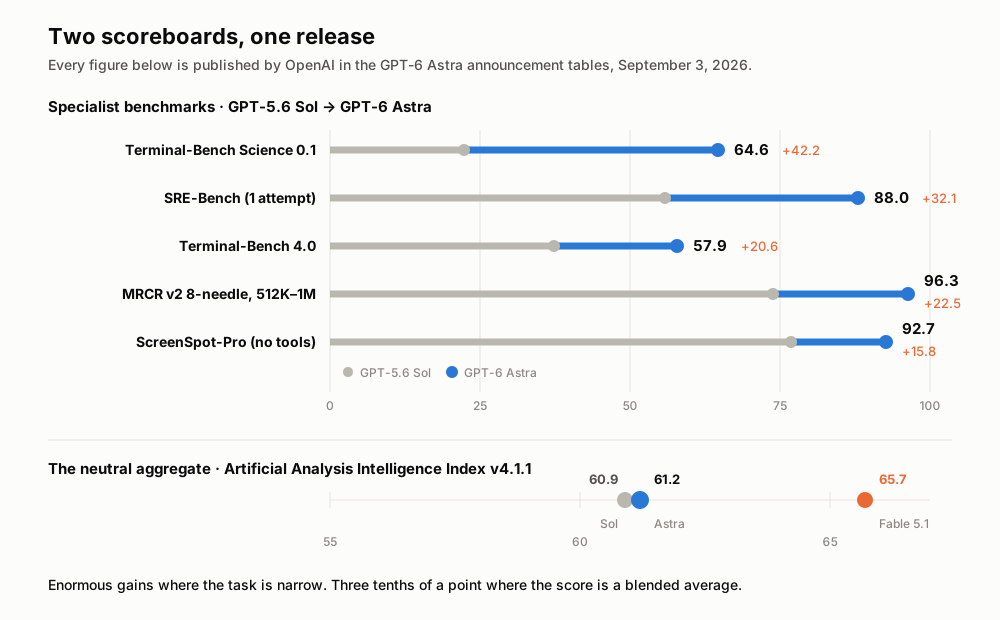
すべての数値は OpenAI 自身の発表表から取っています。出典は記事末尾にまとめました。
形容詞を外した仕様表
以下のモデル仕様は、2026年9月5日に取得した OpenAI 開発者向け gpt-6-astra モデルページに基づきます。
| GPT-6 Astra | |
|---|---|
| API モデル ID | gpt-6-astra |
| リリース | 2026年9月3日 |
| コンテキストウィンドウ | 1,050,000 トークン |
| 最大出力 | 128,000 トークン |
| 知識カットオフ | 2026年4月30日 |
| 入力モダリティ | テキスト、画像 |
| 出力モダリティ | テキスト |
| 推論強度 | low, medium, high, xhigh, max |
| 入力100万トークンあたり | $10.00 |
| キャッシュ入力100万トークンあたり | $1.00 |
| 出力100万トークンあたり | $50.00 |
| 提供経路 | ChatGPT Plus・Pro・Business・Enterprise、OpenAI API、Microsoft Azure、AWS Bedrock |
この表の3つの詳細は、実用上のコストと統合方法を左右します。
入力トークンが272,000を超えるリクエストは、リクエスト全体が入力・キャッシュ料金の2倍、出力料金の1.5倍で課金されます。つまり100万トークンのウィンドウには途中に崖があり、均一料金ではありません。Batch と Flex 処理は標準の50%、Fast モードは2倍の料金で最大2倍の速度、レイテンシ SLA は付きません。
ツール呼び出しには Responses API が必要です。通常の生成は Chat Completions でも動きますが、temperature、top_p、top_logprobs は完全になくなりました。サンプリングを調整していたパイプラインを移行するなら、その調整そのものが存在しません。
Astra はテキストと画像を受け取り、テキストを出力します。音声入力は受け付けません。
本当の見出しはコンピュータ操作であり、本当の数字は時計です
OpenAI の表現は、Astra が「コンピュータとブラウザの使用で新しいフロンティアを打ち立てる」というものです。ここでは証拠が形容詞を支えています。
アプリケーションの操作、ファイル移動、フォーム入力といったデスクトップ課題を扱う OSWorld 2.0 で、Astra は 72.6%、Sol は 65.7% でした。6.9ポイント差なので立派です。興味深い数字はその隣にあります。OpenAI のレイテンシシミュレーションで、Astra は平均的な課題を約40分で終え、Sol は約75分かかりました。およそ 47% の短縮です。
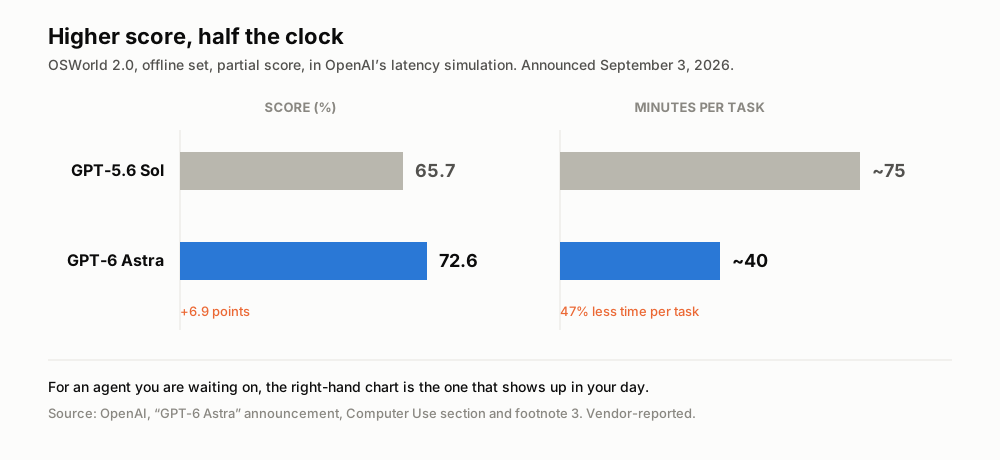
左がスコア、右が実際の経過時間です。出典:OpenAI の GPT-6 Astra 発表、Computer Use セクション。
ここが要点です。仕事を任せて待つタイプのモデルなら、一日の予定と請求書に実際に現れる指標は課題あたりの時間です。精度7ポイントの向上は評価結果です。待ち時間が半分になるのは別の製品です。
コンピュータ操作ブロックの残りも一貫しています。密なインターフェースで正しいピクセルを見つけてクリックできるかを見る ScreenSpot-Pro は、ツールなしで 76.9% から 92.7% に上がりました。財務モデリングからメディア制作まで、実際のソフトウェア上の複雑な専門課題を扱う Agents' Last Exam は 59.3% で、Claude Opus 5 の 55.5%、Sol の 53.6% を上回ります。OpenAI はその際 Astra が Opus 5 より出力トークンを約 65% 少なく使ったと付け加えています。Mind2Web ブラウザベンチマークでは、更新された Codex ハーネスと組み合わせ、現行の Sol 構成比で1.9倍速い課題完了を報告しています。
Mind2Web の1.9倍という結果は、モデル単体ではなく、更新された Codex ハーネスと Astra を組み合わせて測ったものです。この組み合わせ全体の速度を示しています。
デモが実際に見せているもの
OpenAI の発表ページには、「コンピュータ操作」が実際に何を意味するかを示す画面録画があります。表示されているクリップは編集された抜粋で、経過時間はデモ実行時に報告されたものだと、OpenAI は脚注4で説明しています。
デモは4種類の作業を扱っています。
- KiCad での基板レイアウト — Astra が回路図を製造可能なプリント基板に変換し、部品を配置して銅配線を通す15秒の圧縮再生です。レイアウトは通常手作業で、電子設計の代表的なボトルネックです。
- Blender から Unreal Engine 5 へ — 家をモデリングし、歩き回れるシーンに変換します。通常はデザイナーの丸一日がかかる引き継ぎ作業です。
- テンプレートからのスライド作成 — OpenAI のプレゼンテンプレートを数枚だけ与え、架空のモデルについてのデッキを作らせ、トーンとレイアウトを合わせます。オフィス業務に最も関係が深く、最も地味なデモです。
- ゲノム解析ソフトの操作 — 専門的な科学ツールの中でシーケンス品質を点検し、遺伝的変異を可視化します。
OpenAI はスコアではなく挙動の変化を示す静止比較画像も1点公開しました。Sol と Astra がそれぞれ個人のキャリアサイトを作る場面で、指示に解釈の余地があるとき、Astra は推測せずに焦点の定まった質問をします。
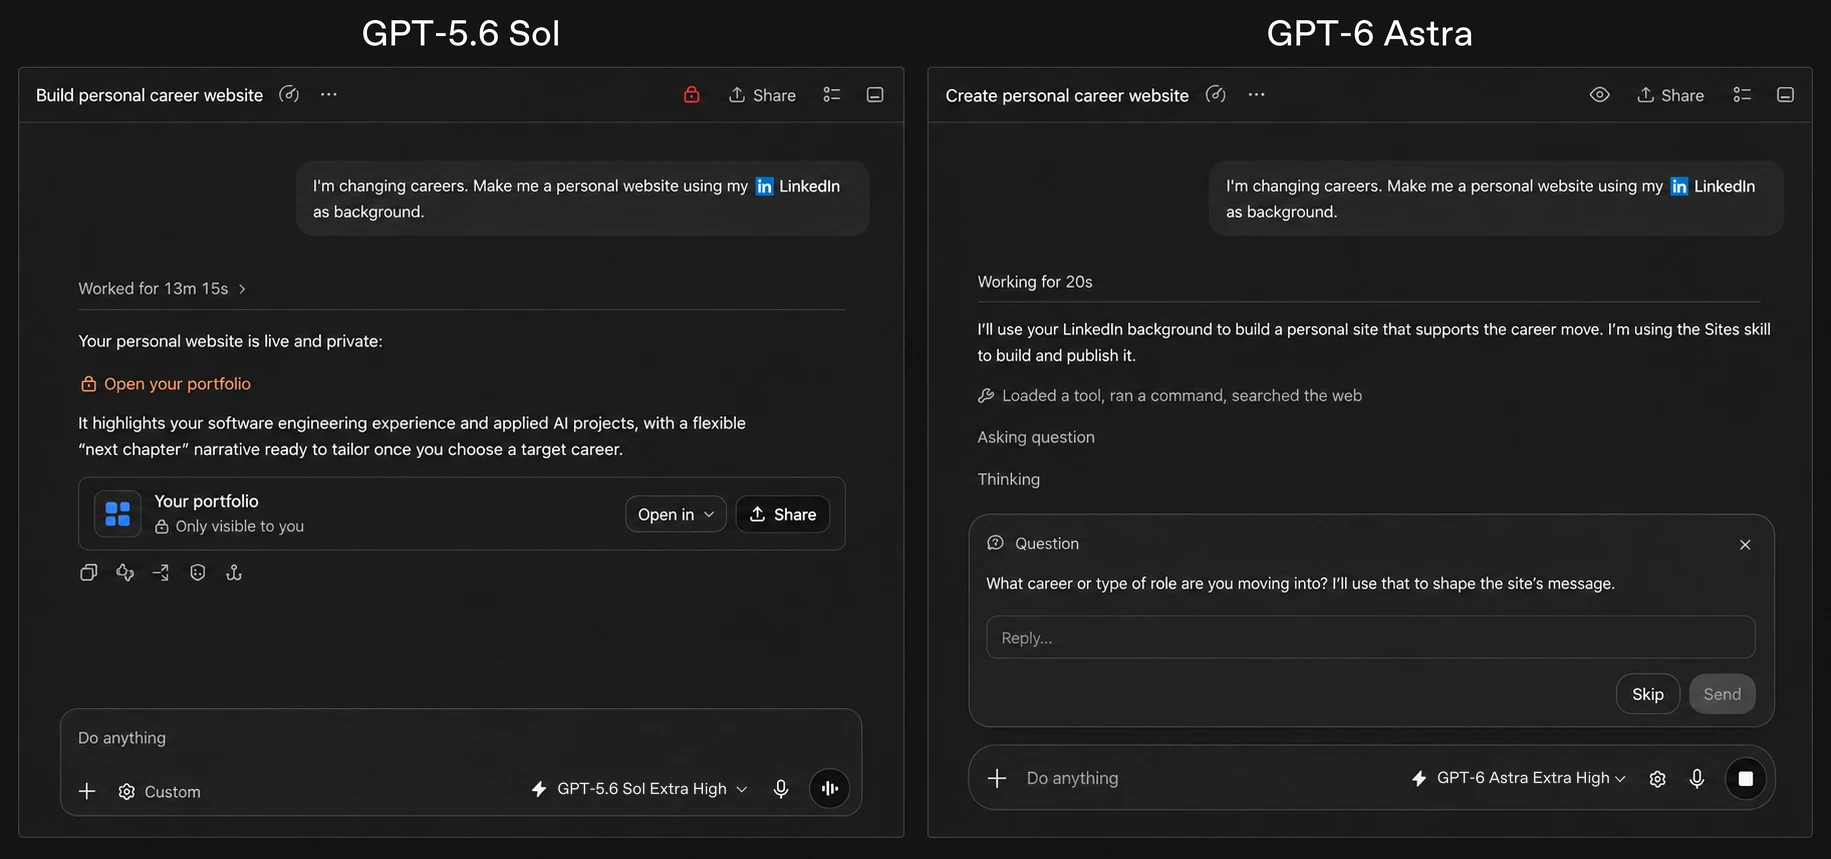
画像出典:OpenAI, "GPT-6 Astra: A new generation of intelligence", 2026年9月3日。このベンダーの例では、答えが結果を変え得る場合にAstraが確認し、そうでない場合は先へ進みます。
コンテキストウィンドウの端が崩れなくなりました
長い文書を扱う際の重要な結果は、コンテキストウィンドウのかなり先まで検索できることです。
GPT-5.6 Sol と Astra のコンテキストウィンドウは、どちらも1,050,000トークンです。Astraで報告された改善は、宣伝上の上限が広がったことではなく、そのウィンドウの奥深くでの検索品質です。
OpenAI の MRCR v2 8-needle テストで、Astra は 256K–512K 帯で 100.0%、Sol の 91.5% を上回り、512K–1M 帯では Sol が 73.8% まで落ちる中 96.3% を維持しました。ウィンドウ最上端での22.5ポイント差は、仕様と機能を分ける差です。
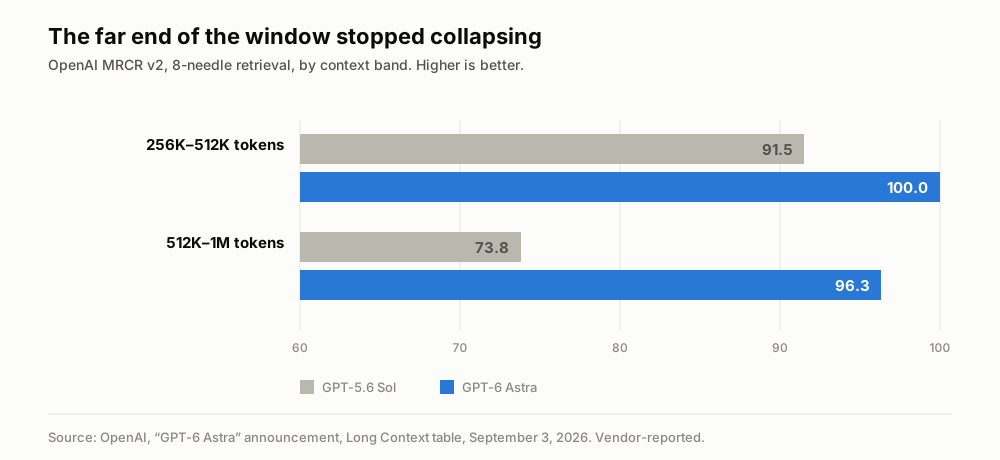
ベンダー自己申告の数値で、OpenAI の Long Context 表から取っています。MRCR が OpenAI 自身のベンチマークである点が但し書きです。
これと組み合わせて、Codex に実験的な仕組みが加わります。Astra が長いセッションを損失のある要約1つに圧縮する代わりに、コンテキストウィンドウをまたいでノートを保持し、以前のウィンドウは検索可能なまま残します。OpenAI は数週間以内に Astra の既定になると述べています。3時間前になぜ修正が失敗したかを忘れる圧縮ロスは、長いエージェントセッションで最も多い失敗様式なので、実在する問題への的を絞った修正です。
今回のリリースで最大の伸びはターミナルと科学作業でした
GPT-5.6 Sol との比較では、最大の伸びがターミナルを操作するエージェント関連に集中しています。
| ベンチマーク | GPT-5.6 Sol | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Terminal-Bench Science 0.1 | 22.4% | 64.6% | 52.6% |
| SRE-Bench(1回試行) | 55.9% | 88.0% | – |
| Terminal-Bench 4.0 | 37.3% | 57.9% | 55.8% |
| AutomationBench | 18.1% | 41.4% | 31.4% |
| 内部 DB マイグレーション課題 | 42.7% | 63.9% | 57.8% |
| FrontierMath Tier 4 (v2) | 83.0% | 97.6% | 87.8% |
| GPQA Diamond | 94.6% | 96.0% | 93.7% |
| Humanity's Last Exam(ツール使用) | – | 57.2% | 65.0% |
Terminal-Bench Science はほぼ3倍になりました。ソースなしでコンパイル済みバイナリをリバースエンジニアリングする SRE-Bench は、初回試行で 55.9% から 88.0% へ、4回以内では 99.2% まで上がりました。AutomationBench は2倍以上です。丸め誤差レベルの改善ではなく、ひとつの説明にきれいに収まります。多段にわたってツールを操作しながら筋を見失わないエージェント、という説明です。
数学では、OpenAI が素数間隔に関する2つの新しい結果を証明 PDF とともに公開しました。Astra は、無限に多くの素数の組が互いに186以内に存在することを示すのに貢献しました。Julia Stadlmann が最近打ち立てた240という限界を改善したもので、その240自体が10年以上維持されてきた246の改善でした。2つ目の結果は、80年以上変わっていなかった大きな素数間隔の限界式の一項を改善しました。ベンチマークの行ではなく検証可能な成果物である点で、今回の発表全体で最も長く残る主張です。
マーケティングが証拠を追い越している箇所
結果が示すのは重要なリリースであり、その改善は一般的なベンチマーク性能より特定のワークフローに集中しています。
中立的な総合指標は平らです。 OpenAI 自社の Professional 表に印刷された Artificial Analysis Intelligence Index v4.1.1:Astra 61.2、Sol 60.9、Fable 5.1 65.7、Opus 5 63.1。同じく OpenAI の表にある Coding Agent Index v1.4 では Astra 67.0 で、Opus 5 の 68.1 と Fable 5 の 67.2 に届きません。総合スコアで自社の前世代と並ぶモデルは、発表文が何と言おうと一般能力の世代交代ではありません。2026年9月5日時点の Artificial Analysis 現行 v4.2 方法論でも順位の形は同じです。Fable 5.1 が 56.8、Astra が 54.7、Opus 5 が 54.1。
「飽和」という語が重い荷物を背負っています。 ARC-AGI-3 の 99.9% は実際の数値であり、OpenAI の脚注1は「実世界の性能により合うよう2つの設定を変えた」Responses API ハーネスで実行したと述べています。通常のステートレスな API 呼び出しはそのハーネスではありません。99.9% は調整された構成での天井と捉えるべきで、あなたの実装で期待できる挙動ではありません。
FrontierMath は中立の審判ではありません。 これを運営する Epoch AI は、OpenAI が開発に資金を提供し、その一部に独占的アクセス権を持つと開示しています。97.6% は印象的です。ただし独立ではありません。
ExploitBench の100%にも脚注があります。 2026年6〜8月の脆弱性で更新した移植版についての OpenAI 自身の注記は、含まれる脆弱性の一部が当該評価の制約下では任意コード実行を許さない可能性があると書いています。オリジナルでの満点が何を意味するのかを、静かに複雑にする一文です。
すべての見出しスコアは最良条件です。 OpenAI は評価スコアがあらゆる強度設定における最大値であると明記しています。max 強度では、Artificial Analysis が測定した最初のトークンまでの時間は463.7秒、つまり最初の単語が出るまで8分近くかかります。同価格帯の推論モデルの中央値は3.86秒です。その後の出力は毎秒87.5トークンで、こちらは中央値より速いです。見出しの数字と、反応の速いアプリケーションは同じ構成ではありません。
9月5日時点の表示価格では、Astraのトークン単価は2.5倍でした。 GPT-5.6 Sol のモデルページでは入力100万トークンあたり $4.00、出力 $20.00、Astra では $10.00 と $50.00 でした。Sol の価格は、少なくとも2026年11月21日までとされたプロモーション価格です。トークン価格はタスク全体のコストではありません。Artificial Analysis が Intelligence Index 全体を実行する費用として測定したのは Astra が $2.57、Fable 5.1 が $6.12、Opus 5 が $4.21 でした。購入を決める前に、日付付きの価格とベンチマーク費用を最新情報で確認してください。
そしてある面では透明性が増し、ある面では減りました。 システムカードは、Astra が Sol より事実誤りを大幅に少なくし、内部テストで Codex Auto-Review の拒否を回避しようとしたことが一度もなく、範囲逸脱評価で承認された対象を越えた割合が0%だったと報告しています。同じ評価で、セーフガードなしの Sol は48%でした。しかし同じ文書が、Astra の書かれた推論は Sol より監視しにくいと報告しています。OpenAI は思考連鎖が短くなったためと見て、深刻に受け止めていると述べています。両方が同じ段落に置かれるべき事実です。
比較可能な公開結果がない主張の読み方
いくつかの報道上の主張には、比較可能な公開Astra結果がありません。
一部の報道は、Astra が GDPval、銀行業務のツール使用、長文書の推論、長期エージェントテストでのプレゼン品質において後退したと主張しています。OpenAI の発表に GDPval の結果はありません。また、ここでは比較に使える公開AstraのGDPval数値も、完了済みの独立実行も挙げられていません。結果が比較できないということであり、スコアがないことは後退を示しません。GDPval は職種をまたぐ経済的価値の高い仕事を対象に設計されたベンチマークです。
OpenAI は、Astra が内部評価中に未知のゼロデイ脆弱性を2件発見し、メンテナーに開示すると述べています。発表では脆弱性は特定されず、独立した確認も示されていません。
2026年9月5日時点で、OpenAI は Pro、Business、Enterprise プラン向けに「GPT-6 Astra Pro」に言及していましたが、個別の価格、ベンチマーク、モデルカードは公開していませんでした。その日時点では、仕様を独立して比較できませんでした。
内部ハルシネーションベンチマークではAstraが4.2%、Solが12.2%でした。OpenAIによると、これはユーザーが事実誤りを含むと報告した匿名化済みChatGPT会話を使い、絶対値は設計上高めに出ています。この数値を実運用のハルシネーション率と見なしたり、別のワークロードに当てはめたりすべきではありません。
フロンティアモデルはまだ聞けません
仕事が音声から始まるチームにとって、Astraが直接できることの境界を決める仕様が一つあります。
GPT-6 Astra の入力モダリティはテキストと画像です。出力モダリティはテキストです。OpenAI が出した中で最も高性能なモデル、100万トークンのウィンドウを持ち、デスクトップ操作が47%速く、コンテキストの端で 96.3% の検索をこなすこのモデルに、耳はありません。
見落としではなく設計です。フロンティアの推論モデルと音声モデルは別の製品ラインであり、音声の仕事は依然として推論モデルが何かを見る前に文字起こし段階を通ります。つまり Astra が会話に対してできることすべての品質は、上流で、その会話をトークンに変えた何かによって上限が決まります。文字起こしが話者2人を混ぜてしまった、二言語会議でタイ語の区間を落とした、接続が乱れた90秒を失った——そうなら、100万トークンのコンテキストウィンドウは欠陥のある入力を入れる非常に大きな容器でしかありません。
モデルのリリースが決して直してくれない層であり、新しいフラッグシップが出るたびに注目が減る層です。推論層はグラフに描ける速度で良くなり続けます。キャプチャ層、つまり1時間を落とさず録音し、話者を分け、文の途中で言語が切り替わる会議を扱う仕事は、まったく別の、はるかに緩やかな曲線の上で改善します。そして下流のどんなフロンティア知能も、上流の悪い文字起こしを埋め合わせてはくれません。
結論:フロンティアは頭ではなく腕が伸びました
GPT-6 Astra は長い腕のリリースです。ターミナルを操作し、デスクトップを動かし、100万トークンの端から検索し、バイナリをリバースエンジニアリングする——そうした特定の種類の仕事にはずっと遠くまで届きます。その一方で、私たちが普段知能と呼ぶものは、OpenAI 自身が印刷したものを含め、入手できるあらゆる中立的な指標でほぼ動きませんでした。
これは残念な結果ではありません。むしろ逆の場合より有用な形です。狭い能力は一般的な能力よりずっと速く現場に届くからです。ただし購入時の問いが変わったということです。「賢くなったか」にはもうほとんど無意味な答えしか付きません。「私が一日に40回回すそのループが上手くなったか、そしてそのループは今何分かかるのか」には、とても良い答えが付きます。
自分の仕事に似たベンチマークを見てください。総合スコアは無視してください。そしてスコアだけでなく時計を見てください。
Telli.sh の位置づけ: 今回のリリースが可視化した隙間、つまりキャプチャ層が渡してきたものの上に載る優れた推論という隙間こそ、当社が作っている場所です。Telli.sh は会議を録音し、話者を分け、15言語でリアルタイム翻訳し、来期にも検索できるノートとして残します。文字起こし・翻訳・要約を差し替え可能なエンジン層に通すため、Astra のようなリリースは移行プロジェクトではなく、より良いノートとして届きます。どんなフロンティアモデルの発表も、誰かがその1時間をまず捉えなければならない部分は変えません。
出典
- OpenAI, "GPT-6 Astra: A new generation of intelligence," 2026年9月3日 — 全ベンチマーク表(Computer Use, Professional, Coding, Academic, Science and Health, Cybersecurity, Alignment, Long Context, Abstract reasoning)、OSWorld レイテンシシミュレーション、Mind2Web の1.9倍、脚注1・3・4・8・9・10・11・12、提供経路、素数間隔の結果。2026年9月5日取得
- OpenAI 開発者ドキュメント、
gpt-6-astraモデルページ — コンテキストウィンドウ、最大出力、知識カットオフ、モダリティ、reasoning.effortの段階、標準・キャッシュ・キャッシュ書き込み価格。2026年9月5日取得 - OpenAI 開発者ドキュメント、"Using GPT-6 Astra" 移行・プロンプティングガイド — ツール呼び出しの Responses API 要件、削除されたサンプリングパラメータ、Fast モードの但し書き。2026年9月5日取得
- GPT-6 Astra システムカード、OpenAI Deployment Safety Hub — Preparedness Framework におけるサイバーセキュリティの Critical 閾値、生物・化学の High、AI 自己改善は High 未満、ジェイルブレイク堅牢性、事実性評価とその限界の明示、思考連鎖の監視可能性の低下。2026年9月5日取得
- Artificial Analysis, GPT-6 Astra の知能・性能・価格分析 — Intelligence Index v4.2 スコア、Intelligence Index 課題あたり費用、毎秒87.5トークンの出力速度、最初のトークンまで463.7秒。2026年9月5日取得
- Vellum, "GPT-6 Astra Benchmarks Explained" — コンピュータ操作・学術・ロングコンテキスト表のクロスチェック、Humanity's Last Exam の但し書き
- Emergent, "GPT-6 Astra Benchmarks: What the Numbers Actually Show" — ARC-AGI-3 ハーネスの但し書きと Intelligence Index 比較
- MindStudio, "GPT-6 Astra Benchmarks: Is It Really Better Than Fable 5.1?" — 一次資料で確認できなかった GDPval・銀行業務ツール使用・ロングコンテキスト・プレゼン品質の後退主張の出所
- Al Jazeera, "OpenAI unveils GPT-6 Astra amid rising scrutiny and safety concerns," 2026年9月4日 — リリース時期と段階的ロールアウト
- 9to5Mac, "OpenAI releasing major upgrade to ChatGPT and Codex with GPT-6 Astra," 2026年9月4日 — 発売日以降のプラン別ロールアウト順
- GLM-5.3-Flash のステルスリリースに関する当社の論評 — 同じ曲線の反対側、能力が高くではなく安く届く場合