誰も「9月」とは言っていない — AI議事録に必要な9分間のレビュー
議事録要約の研究では、実際の市議会の書き起こしを要約した結果の30.4%に少なくとも1つの事実誤りが含まれ、その背後には7つの誤りの型がありました。AIが書いた議事録を書き起こしと突き合わせて確認する実践ガイド。何をどの順で確認するか、そしてレビューを30分ではなく9分で終えるために会議中に何を言うべきか。
その要約は3段落で、構成もきれいで、たった1文だけが間違っていました。チームは移行を9月にリリースすることで合意した。
誰も合意していません。誰かが「ベンダーの返答が間に合えば9月もたぶん可能だ」と言っただけです。別の話題の途中で一度だけ出た条件付きの発言でした。モデルは条件を落とし、推測を決定に格上げし、その議事録は会議にいなかった11人に届きました。うち2人は9月を前提に計画を立て始めました。
これは珍しい事故ではありません。自動要約システムでもっとも詳しく記録されている挙動のひとつで、研究文献には名前まで付いていて、次のモデルが大きくなっても消えません。この記事でお渡しするのは3つです。要約が実際の発言からずれていく7つの型、その7つすべてを捕まえる9分間のレビュー、そしてレビューを短くするために会議中に言っておくべき数行です。
要点
- TofuEvalベンチマーク(NAACL 2024)では、実際の市議会の書き起こしを要約した結果の30.4%に少なくとも1つの事実誤りが含まれ、周辺的な話題では43.6%まで上がりました。
- 誤りはランダムなノイズではありません。研究者は7つの型に分類しており、会議にもっとも打撃を与えるのは意見を事実として述べる誤りと時制・モダリティのずれです。「するかもしれない」が「する」に変わる、あの箇所です。
- チェックをモデルに戻すこともできません。FaithBench(2024年10月)では最良のハルシネーション検出モデルでも正解率は約50%にとどまり、TofuEvalではLLM評価器が小型の専用指標に負けました。
画像: Shixart1985, Wikimedia Commons, CC BY 2.0. 要点は眼鏡です。結局は誰かが読まなければなりません。
記録は解決した。確認は始まってもいない
直近半年でHacker Newsに投稿された議事録ツールを数えると、2026年3月1日から8月13日までで少なくとも15本あります。オンデバイスの書き起こし、ボットを呼ばないノートパッド、Obsidianへの取り込み、オープンソースのGranolaクローン。そのすべてが同じ2つの機能を載せています。音声を取り、要約を作る。
3つ目の工程を載せた製品はひとつもありません。判断が入る唯一の工程なのに、です。要約は整形済みで、自信たっぷりで、すでに参加者全員に送信された状態で受信箱に届きます。そのワークフローが暗黙に主張しているのは一点です。この出力は完成している。
ここが肝心です。生成された要約は会議の記録ではありません。会議についての陳述であり、正確であることに責任を負わないシステムが作ったものであり、ほかのあらゆる伝聞と同じように扱うべきものです。つまり、出どころの証拠と突き合わせて読むということです。
幸い、証拠はすぐそこにあります。要約を作ったツールは書き起こしも作っています。両者を突き合わせる時間は、その会議で自己紹介に使った時間より短くて済みます。
議事録の読み方を変えるべき数字
TofuEvalはSalesforce AIの研究者らがNAACL 2024で発表したもので、この問題について私たちが持つもっとも統制された測定に近いものです。研究チームは2つの対話コーパス — ニュースインタビューと、米国市議会の書き起こしから作られたMeetingBank — を用い、5つの言語モデルにトピック別の要約を書かせ、専門の言語学者が要約の全文について原文との事実整合性を注釈しました。
会議の書き起こしでは、5モデル平均で主要トピックの要約の30.4%に少なくとも1つの事実不整合が含まれ、周辺トピックでは43.6%に上がりました。論文はこう明記しています。GPT-3.5-Turboを除けば「要約の約40〜50%が少なくとも1つの事実不整合を含む」。
正直に付けるべき但し書きはこうです。この5モデルは2023年世代 — Vicuna、3サイズのWizardLM、GPT-3.5-Turbo — であり、今日のフロンティアモデルは事実性で明確に改善しています。ただし同じ論文の2つの発見はその反論を越えて生き残り、それこそがあなたの火曜日に効いてくる部分です。
第一に、規模は問題を安定して解きませんでした。会議データでのWizardLM-30Bの誤り率はWizardLM-7Bよりわずか3.8ポイント低いだけでした。サイズは4倍以上あるのにです。比較によっては同系列の大きいモデルのほうが誤りを多く出しました。第二に、誤りの数と要約の長さに意味のある関係はありませんでした(ピアソンρ = 0.18)。長く詳しい要約が安全な要約とは限らないということです。より大きなモデルを待つことはレビュー手順ではありません。
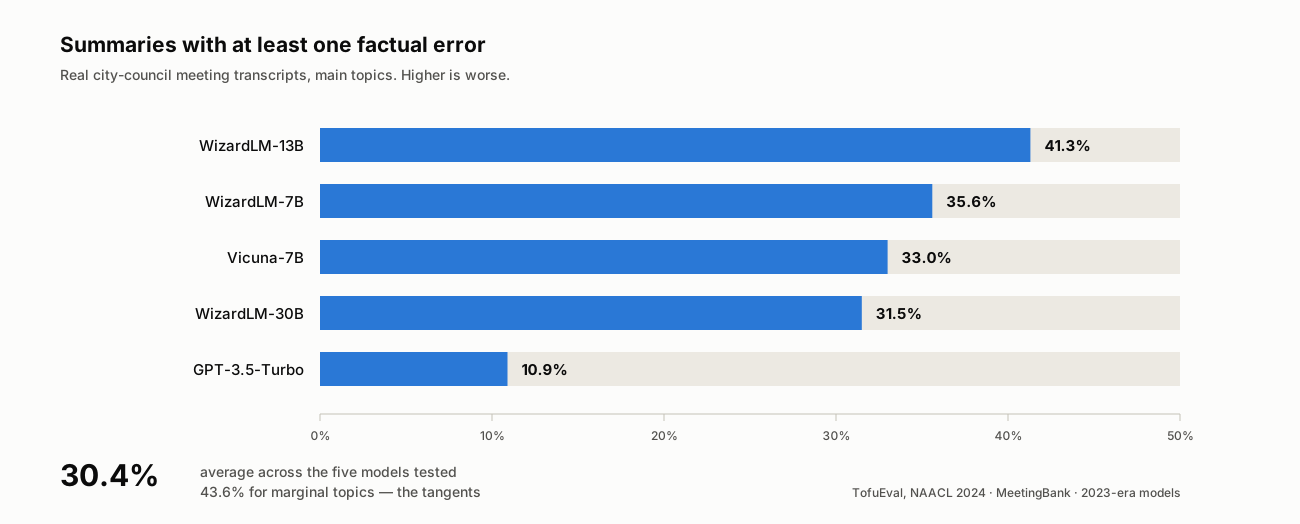
実際の市議会の書き起こしを要約した結果のうち、少なくとも1つの事実誤りを含む割合。主要トピックのみ。出典: TofuEval, Tang et al., NAACL 2024(arXiv:2402.13249)。実験に使われたモデルは2023年世代ですが、以下の誤りの型はその世代を越えて残りました。
要約が会議室からずれる7つの型
その論文でもっとも役に立つのはパーセンテージではありません。分類体系です。注釈者が数千の指摘文から導いた7つの誤りの型で、短い対話向けに作られた既存の分類を拡張したものです。
一度読んでおくと、自分の議事録でも見えるようになります。ランダムな不具合ではなく、話し言葉を散文に圧縮するときに会議室が頼っていた区別が失われる、具体的で反復的な経路だからです。
| 誤りの型 (TofuEval) | 議事録での現れ方 | 見つけ方 |
|---|---|---|
| 外挿情報 | 要約にあって音声にない情報 — 数字、顧客名、誰も述べていない根拠 | 書き起こしでその固有名詞や数値を検索する。ヒットしなければ捏造である |
| 参照の取り違え | 正しい決定を別の人に帰属させる、Aの反対意見をBのものにする | タイムスタンプに飛んで発話者を確認する |
| 意見の事実化 | 誰かが懸念しただけの内容が「この価格変更は解約率を上げる」に | 原文の緩衝表現を探す。考える、懸念する、推測する |
| 推論の誤り | 計算違い、あるいは会議室が引いていない因果関係 | 数値を計算し直し、その「だから」が発言か推論かを問う |
| 時制・相・モダリティ | 「9月に出せるかもしれない」が「9月に出す」に | 未来形の動詞ごとに原文のモダリティと突き合わせる |
| 矛盾 | 否定の脱落 — 「締切は動かさない」が「締切を動かす」に | 該当箇所の近くで「ない」「決して」「でなければ」を検索する |
| 微妙な意味のずれ | 「提案する」が「要請する」に言い換えられる | 要約の動詞と原文の動詞を並べて比べる |
このうち3つは、現物を並べるといちばん見分けやすくなります。書き起こしと要約の一文を隣り合わせに置いてみます。
否定の脱落、矛盾の誤り。 会議室で出た発言:
ダニエル (00:31:12): つまりリリース日は動かしません。ほかが変わっても
あの日付は維持します。
要約が書いた文:
チームはリリース日を動かすことで合意した。
一語抜けただけで、文は正反対の行動を指示しています。しかも文法的には完璧です。読み返しが素通りするのはそのためで、決定の近くで「ない」を検索すれば4秒で捕まるのもそのためです。
帰属の取り違え、参照の取り違えの誤り。 会議室で出た発言:
プリヤ (00:18:40): 私は席数課金には反対です。前四半期にエンタープライズ
のお客さま2社から、それだと商談が壊れると言われました。
ミナ (00:18:55): ええ、同意します。
要約が書いた文:
ミナはエンタープライズ顧客の声を根拠に席数課金へ反対した。
この文の事実はすべて書き起こしの中にあります。人物だけがありません。難しさの核心はそこです。主張が真かどうかを問うても捕まえられず、その主張が名指しされた人のものかどうかを問うて初めて捕まります。
格上げされた推測、モダリティの誤り。 会議室で出た発言:
サム (00:44:02): ベンダーが間に合って返事をくれれば、9月もたぶんいけます。
要約が書いた文:
チームは移行を9月にリリースすることで合意した。
限定詞が2つ消えました。「たぶん」という語と、条件節まるごとです。それだけで、共有された推測が日付つきの確約に変わりました。そうなるのに誰かが嘘をつく必要はありません。圧縮がやったのです。
このうち2つは特に見ておく価値があります。チームに実際のコストを負わせる型だからです。
意見の事実化は、冒頭の9月の事故そのものです。会議では大半の文が緩衝されています。人は声に出して考えているところで、その緩衝表現が意味のすべてを担っています。要約モデルは設計上、緩衝表現を削ぎ落とします。散文を圧縮するとき最初に切るのがそれだからです。結果として出力は会議室より断定的に読め、だからこそ誰も疑いません。
モダリティのずれは日付に同じ損害を与えます。「かもしれない」「すべき」「たぶん」「ベンダーから返答があれば」は、計画と確約を分ける言葉であり、同時にもっとも落としやすい言葉でもあります。チームが9月に何かをすると書かれた要約は、誰も引き受けていない締切を静かに製造したのです。
2つの共通点を見てください。モデルは無から事実を作ったのではありません。限定詞を取り除いたのです。モデルにできるもっとも目立たない編集であり、原文が手元になければどんな読者にも検出できない編集です。
捏造は脇道で起きる
データにはもうひとつ、実際の会議の進み方と正確に重なるパターンがあります。
周辺トピック — 詳しく議論されず、通りすがりに触れられただけのもの — の要約は明確に悪化しました。会議コーパスで43.6%対30.4%です。研究チームはその仕組みをこう説明します。トピックが原文でほとんど扱われていないとき、モデルは「そのトピックについて推論するために自らの知識に頼り、裏付けのない情報を要約に持ち込む」。証拠の薄い場所が一般知識で埋められ、その埋め草は口調のうえで根拠のある部分と区別がつきません。
あなたの会議は脇道だらけです。セキュリティレビューに触れた2分、一度だけ名前が出たベンダー、誰かがうろ覚えで言った数字。これらの行はもっとも議論されておらず、もっとも間違いやすく、それでいて残りとまったく同じ滑らかさで読めます。
その一段下の層も同じ形をしています。ACM FAccT 2024で発表された「Careless Whisper」で、KoeneckeらはWhisperの書き起こしの約1%が元の音声にいかなる形でも存在しない語句や文をまるごと含んでいたこと、そしてそのハルシネーションの38%が明示的な害 — 存在しない関連付け、偽の権威、捏造された暴力 — を伴っていたことを報告しました。興味深いのは引き金です。ハルシネーションは、発話のない時間が長い話者に不均衡に多く現れました。
つまり沈黙です。そして会議は沈黙でできています。考えるための間、誰かがミュートを解除する時間、画面共有が表示されるまで、難しい質問のあとの4秒。書き起こしモデルが言われてもいないことで埋めやすいのは、まさにその素材です。これは書き起こしの誤りと要約の誤りが独立ではないことも意味します。捏造された書き起こしの一行は、要約から見れば完全に根拠のある入力だからです。
チェックをモデルに戻すことはできない
2つ目のモデルに1つ目を検証させればいい、という発想は自然です。測定結果はあまり励みになりません。
同じTofuEval研究で、著者らはLLMを事実整合性の二値判定器として評価し、GPT-4を含むすべてが「LLM生成要約の誤りの検出において性能が低い」と結論づけました。この課題のために作られた小型の非LLM事実性指標に負けたのです。GPT-4が文を正しく指摘した場合でさえ、なぜ誤りなのかの説明が正しかったのは約80%。ほかの評価器はおよそ半分でした。
2024年10月にVectaraが公開したFaithBenchは、その天井に数字を与えました。8系列10種の現代的LLMが生成したハルシネーションのうち、既存の検出器の判定が割れた事例を集め、最良のハルシネーション検出モデルでも正解率は約50%だと報告しています。肝心な事例でのコイン投げということです。
だからレビューはあなたの仕事です。負担に聞こえますが、非対称性がひとつあります。検出器は見知らぬ文書を基準に任意のテキストを判定しなければなりませんが、あなたはその部屋にいました。どの主張が妙だったかをすでに知っています。確認するだけでいいのです。
3つの成果物、3つの役割
「AI議事録 対 手書き議事録」という論争は、たいていカテゴリー錯誤です。会議は3つの成果物を生み、それらは代替物ではなく、ひとつしか残さないチームは必ず具体的な何かを失います。
| 生の書き起こし | AI要約 | 決定ログ | |
|---|---|---|---|
| 正確な言い回しの保存 | あり — 逐語 | なし — 圧縮され緩衝表現が落ちる | なし |
| 誰が言ったか | 話者分離があればあり | ときどき。取り違えは命名された誤りの型 | あり — 担当者が要点 |
| いつ言ったか | あり — タイムスタンプ付き | まれ | 期限のみ |
| 担当者と期限のある決定 | 約9,000語の中に埋もれる | 部分的で不安定 | あり — これが唯一の役割 |
| 何を、なぜ却下したか | 誰かが言っていればあり | たいてい冗長として削られる | あり、1行で |
| 60秒で読める | なし | あり | あり |
| 証拠と突き合わせられる | これが証拠である | 書き起こしが残っている場合のみ | 両方が残っている場合のみ |
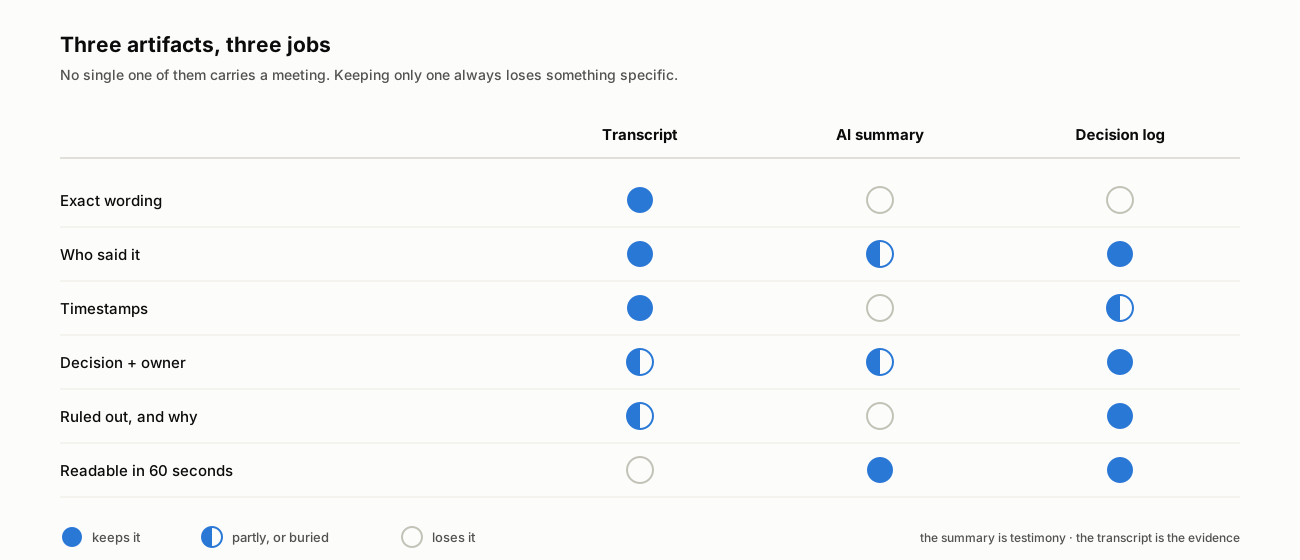
それぞれが何を保ち、部分的に保ち、失うか。ほかの2つの価値を決めるのは最下行です。
最下行が議論のすべてです。書き起こしの残っていない要約は反証不能です。同僚が「合意したのはそれではない」と言ったとき、手元にあるのは2つの意見と0の記録です。ここでAI議事録は人間のそれよりもろい。人が書いた議事録には可謬性が目に見える形で付いていて、誰もが適度に疑いながら読みました。機械の散文はきれいな見出しと断定的な文体で届き、稼いでいない権威を借りてしまいます。
そのまま呼びましょう。要約は証言であり、書き起こしは証拠です。証言は有用です。そして証言とは、突き合わせて確かめるものでもあります。
9分間のレビュー、順番どおりに
私たちが勧める手順です。60分の会議を想定して時間を割り当てました。順番が重要です。間違ったときのコストが高い確認を前に置いているので、4分で中断されても高価な誤りはすでに捕まえています。
- 0:00〜1:30 — 決定文だけを読む。 最初のパスでは説明的な要約を完全に無視します。結果、確約、日付を主張する文だけを探してください。60分の会議なら通常3〜6文です。誰かが実際に動く文はそれだけです。
- 1:30〜3:00 — モダリティを復元する。 各文について書き起こしの該当箇所に飛び、動詞を確認します。誰かがすると言ったのか、できる、すべき、たぶんと言ったのか。原文が緩衝されていたなら、緩衝表現を戻して要約文を書き直すか、より良くは担当者付きの未決事項として印を付けます。
- 3:00〜4:30 — 固有名詞と数字をすべて確認する。 名前、会社、バージョン、価格、日付、パーセント。ひとつずつ書き起こしを検索します。そこにないものは外挿情報です。削除するか、会議外で裏を取ってください。読む作業ではなく検索窓の作業です。
- 4:30〜5:30 — 帰属を検証する。 各決定と各反対意見について、そのタイムスタンプで誰が話しているかを確認します。参照の取り違えは、計画上の問題より人間関係の問題を引き起こしやすい誤りであり、確認は最速です。
- 5:30〜6:30 — 落ちた否定を狩る。 各決定の周辺で「ない」「決して」「〜でなければ」「〜の代わりに」を検索します。矛盾の誤りは文法的に完璧な文のまま意味だけを反転させるので、読み返しでは見つかりません。検索で見つけるものです。
- 6:30〜8:00 — 何が欠けているかを問う。 どんなツールも代われない工程です。要約は自分の欠落を自分で示せません。問いは2つ。何を、なぜ却下したのか。そして、どの問いに答えられなかったのか。どちらも圧縮を生き延びず、どちらも半年後にその議事録を有用にするものです。
- 8:00〜9:00 — 決定ログを書いて送る。 3〜6行。各行に、何を決めたか、次の一手を誰が持つか、いつまでかを入れます。書き起こしへリンクします。そのリンクが、このレビュー全体を他人が再確認できるものにします。
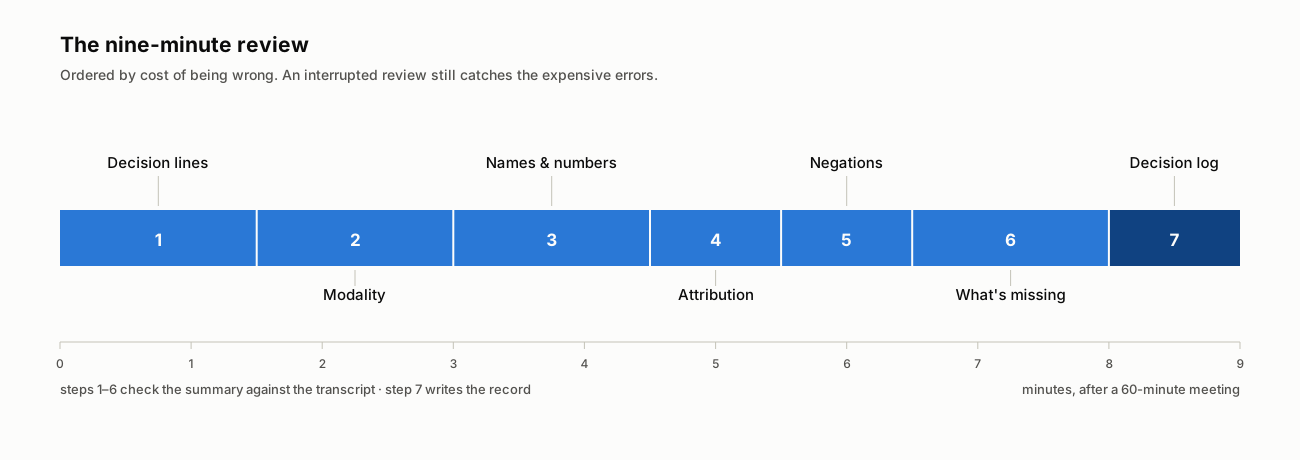
順番そのものが設計です。モダリティと捏造された細部を先に、欠落を最後に。中断されたレビューでも高価な誤りは捕まえます。
運用上の注意を2つ。30分の会議なら4分の作業です。そして要約とタイムスタンプ付き書き起こしを同じ場所に持つツールの中でやれば、工程2から5はウィンドウの行き来ではなく検索とクリックになります。忙しい週を生き延びる習慣と、そうでない習慣の差はそこで生まれます。
会議中の10秒がレビューの5分を節約する
元の録音に最初からその情報が入っていれば、レビューは劇的に短くなります。モデルは誰も言わなかったことを復元できませんし、議事録を曖昧にするものの大半はそもそも音声に存在しませんでした。
- 問いを声に出して始める。 「今日は移行をカンファレンスの前に出すか後に出すかを決めます。」問いを明示すると、要約モデルには周辺トピックの束ではなく主要トピックができます。そして周辺トピックが43.6%の側でした。
- 誰かが退出する前に、決定を名前と日付付きで1文にして言う。 「決定です。ベンダー対応はミナさんが持ち、9月の日付は25日までに確定します。」市場のどのツールもこの文を完璧に捉えます。そしてどれもこの文を作ってはくれません。
- 否定を明示的に言う。 肩をすくめてうなずくより「リリース日は動かしません」のほうが安全です。否定の脱落は文書化された誤りの型であり、そもそも発話されなかった否定は落としようがありません。
- 却下したものとその理由を1行で言う。 「席数課金も検討しましたが、前四半期にエンタープライズ2社から反対があったのでやめました。」半年後に同じ議論が再開するのを止めるのがこの文です。
- 珍しい固有名詞は一度はっきり発音する。 ベンダー名、社内コードネーム、略語こそ、書き起こしが崩し、要約が自信満々に繰り返す対象です。
- 沈黙にしゃべらせない。 全員が資料を読んで静かになったなら、そう口に出してください。長い無発話区間は、書き起こしモデルがもっともハルシネーションを起こす条件です。
これは会議の演出ではありません。記録に口述しているのです。記録が自動で書かれるようになって、むしろ価値が上がった技能です。
結論
AIの会議要約は記録ではありません。記録についての証言です。滑らかに語られ、正確であることに利害を持たず、「たぶん」という語を落とす傾向が文書化された証人による証言です。
この捉え直しで、手書き対AIという論争は片付きます。もともと論争ですらありませんでした。録音は残してください。唯一の証拠だからです。要約はモデルに書かせてください。あなたより速く、40分目でも飽きないからです。そのうえで9分を使い、その場にいた人にしかできない一点をやってください。自信に満ちた文を実際の発言と突き合わせ、誰かが動くべき3行を書き留めることです。
2026年に火傷するチームは、AI議事録ツールを使わなかったチームではありません。その出力を書き起こしとして読んだチームです。実際には言い換えであり、その違いを示せたはずの書き起こしを残さなかったチームです。良い議事録が担うべきものの完全版は会議の議事録になお必要な6つのことに、単語誤り率が書き起こしの実用性についてほとんど何も語らない理由は精度だけでは足りない理由に書きました。
Telli.shの位置づけ: 9分間のレビューは、要約と原本が同じ場所にあるときだけ機能します。Telli.shは話者付きのタイムスタンプ書き起こしを、編集可能なAI要約のすぐ隣に置きます。だから主張ひとつの確認が、2つのシステムを探し回ることではなく検索とクリックになります。部屋がひとつの言語で話していないときは、翻訳が原文を置き換えるのではなく並んで表示されます。要約は受け入れる出力ではなく、直すための下書きとして届きます。
出典
- Tang et al., "TofuEval: Evaluating Hallucinations of LLMs on Topic-Focused Dialogue Summarization," NAACL 2024 (arXiv:2402.13249, 2024年2月20日)
- Koenecke et al., "Careless Whisper: Speech-to-Text Hallucination Harms," ACM FAccT 2024 (arXiv:2402.08021, 2024年2月12日)
- Bao et al., "FaithBench: A Diverse Hallucination Benchmark for Summarization by Modern LLMs," Vectara (arXiv:2410.13210, 2024年10月17日)
- Hu et al., "MeetingBank: A Benchmark Dataset for Meeting Summarization," ACL 2023 (arXiv:2305.17529, 2023年5月27日)
- Wang et al., "Analyzing and Evaluating Faithfulness in Dialogue Summarization," EMNLP 2022 (arXiv:2210.11777, 2022年10月21日)
- Wikimedia Commons 画像ページ
