5つの段階、4つの成果物 — Telli.sh は会議録音に対して実際に何をしているのか
Telli.sh のパイプライン全体を段階ごとに解説します。ライブ録音と音声アップロード、話者識別を伴う AI 会議文字起こし、44 言語を対象としたリアルタイム会議翻訳、10 種類のフォーマットによる AI 要約、そして共有可能なノートまで。正直な限界と正確な価格、そして会議文字起こしの精度が本当に必要とするものも取り上げます。
8人がオフィスに立っています。ひとりがマイグレーションの遅れた理由を説明し、ふたりは半分しか聞いていません。後ろにいた誰かが、3週間後に重要になる一文を口にしますが、誰もそれを書き留めません。
それが素材です。この記事は、その素材を私たちのシステムがどう扱うのかを、音声が流れ始めた瞬間からチャンネルにリンクを貼る瞬間まで、段階ごとに説明したものです。
先に明記しておきます。これは Telli.sh を開発しているチームが書いた製品紹介記事です。リサーチ記事と並行して、こうした製品記事も定期的に公開しています。ただしここで目指したのは、懐疑的な読者が自分で検証できる程度に具体的に内部構造を説明することです。実在するモデル名、実際の数値、実際の限界を挙げます。「AI 搭載」といった霧のような形容詞ではなく。
要点:
- 録音は5つの処理段階を通り、4種類の成果物を別々に残します。生の文字起こし、話者マッピング、整形済みスクリプト、そして適用したフォーマットごとの要約です。
- 話者識別は
pyannote/speaker-diarization-community-1上でチャンク単位に動き、音声埋め込みを引き継いでいくため、5分目と50分目で同じ人物が同じラベルを保ちます。- 翻訳対象は44の言語コード、インターフェイス自体は15言語、要約は10種類の組み込みフォーマットに加えて、名前・指示文・セクション一覧で自分で定義するカスタムフォーマットに対応します。
- 無料プランはカード不要で月60分。有料プランは月300分・500分・1,000分がそれぞれ5ドル・8ドル・10ドルです。
画像: Klean Denmark「Daily sprint meeting」Wikimedia Commons, CC BY-SA 2.0。このパイプライン全体が存在する理由そのものである種類の会議。
音声の入口は2つあり、その2つは同じではない
入口はちょうど2つで、その違いが下流のすべてを決めます。
1つめはライブ録音です。ブラウザが 16,000 Hz のサンプルレートに固定した AudioContext を開き、AudioWorklet を読み込んで、マイク入力を 4,096 サンプル単位でバッファリングします。16 kHz なら 256 ミリ秒ごとに1パケットです。各フレームは 32 ビット浮動小数点から 16 ビット整数 PCM に変換され、WebSocket で /ws/audio/{sessionId} に送られます。2つめのソケット /ws/session/{id} は制御チャンネルを担当します。言語の変更、コンテキストの更新、SUMMARIZE コマンド、そしてセッションを閉じてノートを書き込む FINISH コマンドがここを通ります。
2つめはファイルアップロードです。アップロードのモーダルに録音を置くと POST /upload にストリーミングされ、サーバーは改行区切り JSON で応答します。スピナーではなくストリームなので、偽のパーセンテージではなく名前のついた実際の工程で進捗を表示できます。ここでの上限は正直に書いておきます。1ファイルあたり 500 MB、そしてファイル選択は audio/* のみを受け付けます。 MP4 の画面収録の中に会議が入っているなら、先に音声トラックを取り出す必要があります。それは今のところ私たちが代行しません。
2つの経路は同じ処理軸に合流します。段階1以降、ライブ録音とアップロードファイルは同一に扱われます。
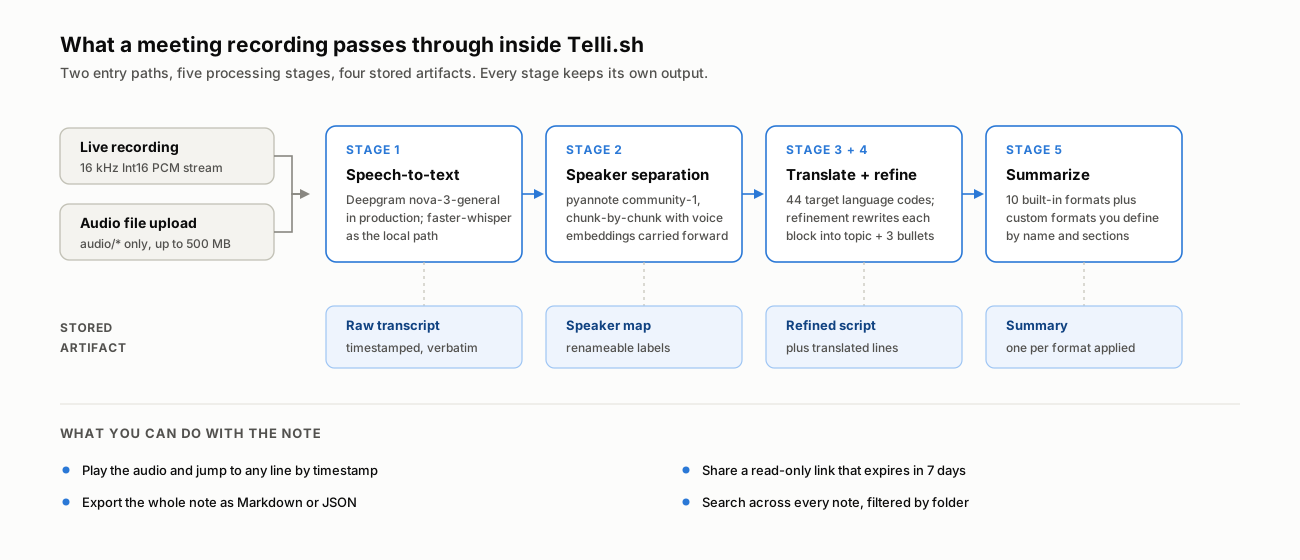
どの段階も自分の出力をそのまま保持します。次の段階が前の段階を上書きすることはありません。
段階1と2 — 言葉を聞き取り、それが誰のものかを判別する
まず音声認識が動きます。本番環境ではバッチ経路とストリーミング経路の両方で Deepgram の nova-3-general モデルを使っています。コードベースには自己ホスト向けに faster-whisper ベースのローカル経路も同梱されており、プロバイダー設定ひとつで切り替わります。ただしこの選択は、多くの人が期待するほど重要ではありません。理由は以前詳しく書きました。独立系ベンチマークの上位モデル群の単語誤り率は、いまや約 1.5 ポイントの幅に収まっています。 エンジンの選択は、もはや品質差が生まれる地点ではありません。
品質差が生まれるのは話者識別です。
話者分離は pyannote/speaker-diarization-community-1 で動きます。実際に効いている実装上の要点は、長い録音の扱い方です。ファイル全体を一度に処理するのではなく、パイプラインは音声をチャンクに分け、各チャンクの直後に話者を割り当てます。同時に話者ごとの音声埋め込みの辞書を蓄積し、以降のすべてのチャンクでその蓄積集合と照合して再識別します。2時間の録音で、同じ人物がいつのまにか SPEAKER_00 になり、SPEAKER_03 になり、SPEAKER_07 になるという典型的な失敗を防いでいるのがこの仕組みです。
ある区間が2人の発話にまたがる場合、重なりの大きいほうにラベルが付きます。重なりが小さいケースでは埋め込みの類似度がタイブレーカーになります。
ラベルは SPEAKER_00、SPEAKER_01 のような汎用名で出てきます。モデルには SPEAKER_01 があなたの会社のエンジニアリング責任者だと知る手段がないからです。ノート上で一度名前を変えれば、その対応表はノートとともに保存され、以降すべての場所に適用されます。エクスポートにも共有リンクにもです。役割分担は正直にこうです。声を分けるのは機械が、名前を与えるのは人間がやります。
各段階が実際に残すもの
私たちが守っている設計上の原則はひとつです。どの段階も前の段階の出力を壊さない。実際に何が話されたのかに、いつでも戻れる必要があります。
| 成果物 | 生成する段階 | 内容 | 用途 |
|---|---|---|---|
| 生の文字起こし | 段階1・2 | タイムスタンプ付きの逐語行、行ごとに話者ラベル | 実際に何が話されたかの確認。行をクリックして音声を頭出し |
| 話者マッピング | 段階2 + 利用者の編集 | ノート内のラベルと名前の対応表 | 他のすべての表示を読めるものにする。ノート・エクスポート・共有に適用 |
| 整形済みスクリプト | 段階4 | ブロックごとに太字のトピック行と最大3点 | 長い会議を読まずに流し読みする |
| 翻訳行 | 段階3 | 原文の隣に付く行単位の翻訳 | 自分の使わない言語で行われた会議を読む |
| 要約 | 段階5 | 適用したフォーマットごとに1つ生成される構造化文書 | 実際に人に送るもの |
ノート画面では3種類のタブとして現れます。履歴(生の文字起こし)、スクリプト(整形版)、そして生成した要約フォーマットごとに1つずつです。録音音声が保存されていれば上部にプレイヤーが付き、文字起こしの任意の行をクリックするとそのタイムスタンプへ音声が移動します。
段階3 — 翻訳で重要な数字は44である
リアルタイム会議翻訳は、初期のユーザーを最も多く引き寄せた機能です。その範囲は正確に述べる価値があります。このカテゴリで「100 言語以上に対応」ほど検証しにくい表現もないからです。
異なる2つの数字があり、同じ数字ではありません。
- 翻訳先として受け付ける言語コードは44です。バックエンドの設定に明示的に列挙されており、
zhとは別にzh-TWが含まれます。台湾と中国本土をまたいで働くなら、聞こえる以上に重要な違いです。 - インターフェイス自体、および AI が要約を書く言語は15です。英語、韓国語、日本語、中国語、ドイツ語、フランス語、スペイン語、イタリア語、ポルトガル語、ロシア語、ポーランド語、ベトナム語、タイ語、インドネシア語、マレー語。
ライブセッションでの翻訳は、最後にまとめてではなく逐次的に進みます。文字起こしに句読点の区切りが到着するたびに、その区間の翻訳が原文の横に流れ込み、セッションごとのキャッシュが変化していないテキストの再翻訳を防ぎます。ファイルアップロードでは代わりに行をまとめてバッチ処理します。誰も画面を見ていないときは、レイテンシよりスループットが重要だからです。
ノートモードとは別に、翻訳ワークフローモードもあります。議事録ではなく翻訳そのものが成果物である場合、つまりリアルタイムで追う必要のある二言語の会話のためのモードです。
段階4 — 誰も要求しないが全員に必要な段階
ここで説明が意見に切り替わります。そしてこの意見には留保を付けません。整形はこのパイプラインで最も過小評価されている段階です。
人間の話し言葉の逐語文字起こしは、ほとんど読めません。人は文を言い直し、語尾を濁し、「はい、はい、そうですね」を4回繰り返し、ひとつの決定を90秒の咳払いの中に埋めます。それを一語も間違えずに書き取っても、依然として90秒の咳払いです。
そこで整形の段階は、会話をブロック単位に区切り、厳しい制約のもとで書き直します。この制約はコードではなくプロンプトテンプレートに定義されているので、デプロイなしで調整できます。各ブロックは内容から導かれた太字のトピック行で始まります。役割名でもなく、角括弧も使いません。その後に最大3つの要点が続き、1ブロックあたり約300文字を目安にします。話者名とタイムスタンプは明示的に取り除きます。すでに生の文字起こしにある情報であり、繰り返せば流し読み用の画面が流し読みしにくくなるだけだからです。
そのテンプレートに含まれる制約のひとつは、名前を挙げる価値があります。モデルは聞き取った内容の語調に合わせるよう指示され、とくにくだけた会話にビジネス会議調を無理に被せないよう指示されています。廊下での雑談を取締役会の議事録のように要約した成果物は、要約がまったくない状態より悪いものです。
私たちはその結果をスクリプトと呼んでいます。ひと目で読めるバージョンであり、争いになったときに引用できるバージョンはタブひとつ隣にそのまま残っています。
段階5 — 要約フォーマットが10種類ある理由
最後の段階は、実際に送る文書を作ります。LLM にただ「要約して」と言えば、何についてでもない要約が返ってきます。だからフォーマットは隠れた既定値ではなく、一級の選択肢にしてあります。
組み込みフォーマットは10種類です。AI 要約(汎用)、議事録、報告用サマリー、講義ノート、説教 / 講話、カウンセリング記録、通話サマリー、インタビュー、アイデアノート、プレゼン資料。それぞれ固有のセクション構成を持ちます。議事録は会議概要・主要議論事項・決定事項・次のステップとアクション項目を生成し、プレゼン資料は発表概要・スライド構成・主要メッセージ・スピーカーノート・次のアクションを生成します。セクション見出しそのものが言語ごとにローカライズされており、生成時に翻訳されるわけではありません。日本語の要約が、翻訳された英語文書ではなく日本語の文書として読める理由です。
10種類のどれも合わないときは、カスタムフォーマットを定義します。名前、指示文、欲しいセクション一覧を保存して再利用します。「リスクと未決事項を含む週次の取締役会向けアップデート」は、一度書けば済むフォーマットです。
どのフォーマットも後からノートに適用でき、それぞれが自分のタブを作ります。同じ録音を3種類の読み手のために3通りに要約するのは、ここでは裏技ではなく通常の使い方です。
会議文字起こしの精度は数字ではなくスタックである
このカテゴリのツールを比較検討しているなら、反論してみる価値があるのはこの節です。
業界は単語誤り率というひとつの数字を公開しますが、その数字は製品を選ぶ役にはもう立ちません。全社が床の近くに固まっているからです。私たちはその議論をSTT の精度だけでは足りないで詳しく分解しました。「ない」がひとつ落ちるだけで決定が反転するのに、精度予算では 0.016% しか消費しないという事例も含めて。
実務的にまとめるとこうです。実際の会議で通用する文字起こし精度は5つの層でできており、音響モデルはその一番下の層にすぎません。
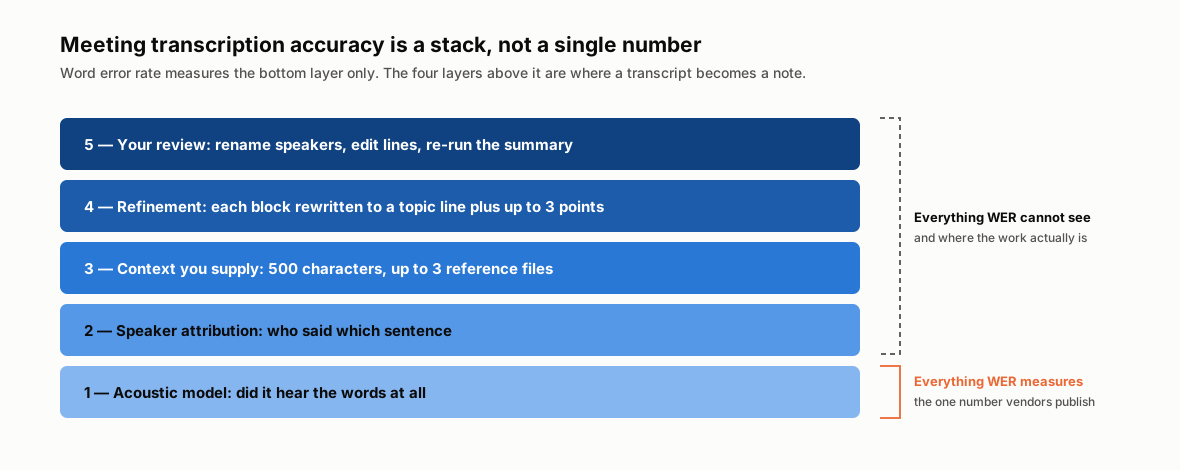
単語誤り率が測るのは第1層だけです。文字起こしが使えるものになるかを決めるのは第2層から第5層です。
第3層は、利用者が直接コントロールできるのに大半が飛ばしてしまう層です。録音やアップロードの前に、最大 500 文字のコンテキストブロックを入力できます。テーマ、参加者名、製品コード、略語などです。さらに参考ファイルを最大3件添付できます。PDF・画像・テキストファイルの文字をブラウザ側で抽出し、同じ 500 文字の枠に折り込みます。このコンテキストが AI の各段階に渡されます。
これは「あると嬉しい」機能ではありません。固有名詞はどの会議でも、情報量が最も多く出現頻度が最も低い語です。社内プロジェクト名、珍しい姓、製品 SKU がそれにあたります。「ケストレル」が製品で「ラヴィ」が人物だと事前に伝えるのに 15 秒かかり、そうしなければ手作業で 10 分かけて直すことになる誤りが消えます。この記事を読んでひとつだけ行動を変えるなら、コンテキスト欄を埋めてください。
ゼロから共有ノートまで、11のステップ
具体的に、初回の実行から共有可能な成果物までの流れです。
- サインアップします。無料プランはカード不要で月60分、有料プランとまったく同じパイプラインが動きます。機能の差ではなく上限の差です。
- 経路を選びます。ライブ録音を始めるか、アップロードのモーダルを開いて音声ファイルを置きます(
audio/*、500 MB 未満)。 - 言語ペアを設定します。ソースは自動検出のままで構いません。ターゲット言語が、翻訳と要約の出力言語を決めます。
- コンテキスト欄を埋めます。テーマ、名前、略語を 500 文字以内で。資料やアジェンダがあれば参考ファイルを最大3件添付します。
- 特定の場所に置きたければフォルダを選びます。あとから移動もできます。
- 録音するか、アップロードのストリームを待ちます。ライブセッションでは話すそばから文字起こしが現れ、ターゲット言語を設定していれば翻訳が横に流れ込みます。アップロード中は名前のついた工程が見えます。音声認識、解析、整形、要約、仕上げの順です。
- セッションを終了します。
FINISH制御メッセージが発火し、最後の区間をフラッシュし、進行中の整形を待ち、音声を保存し、要約を生成し、ノートを書き込みます。 - 話者の名前を変えます。SPEAKER_00 を一度実名にすれば、対応表がすべての表示とすべてのエクスポートに伝播します。
- スクリプトタブで会議の内容をつかみ、おかしく見える箇所があれば履歴に降りてその行をクリックし、まさにその瞬間の音声を聞きます。
- ある読み手には議事録が、別の読み手には報告用サマリーが必要なら、要約フォーマットを追加で生成します。
- 共有するかエクスポートします。共有リンクは読み取り専用で7日後に失効し、任意でパスワードを設定できます。エクスポートは Markdown か JSON を返し、要約・整形ブロック・全文の文字起こしが1つのファイルに入ります。
費用を正確な数字で
上限は処理した音声の分数で計算され、プランを分けているのはそれだけです。
| プラン | 月あたりの分数 | 月額 | 年額 | 100分あたりの実質費用 |
|---|---|---|---|---|
| 無料 | 60 | USD 0 | — | — |
| プラス | 300 | USD 5.00 | USD 51.00 | USD 1.67 |
| プロ | 500 | USD 8.00 | USD 81.60 | USD 1.60 |
| プロ+ | 1,000 | USD 10.00 | USD 102.00 | USD 1.00 |
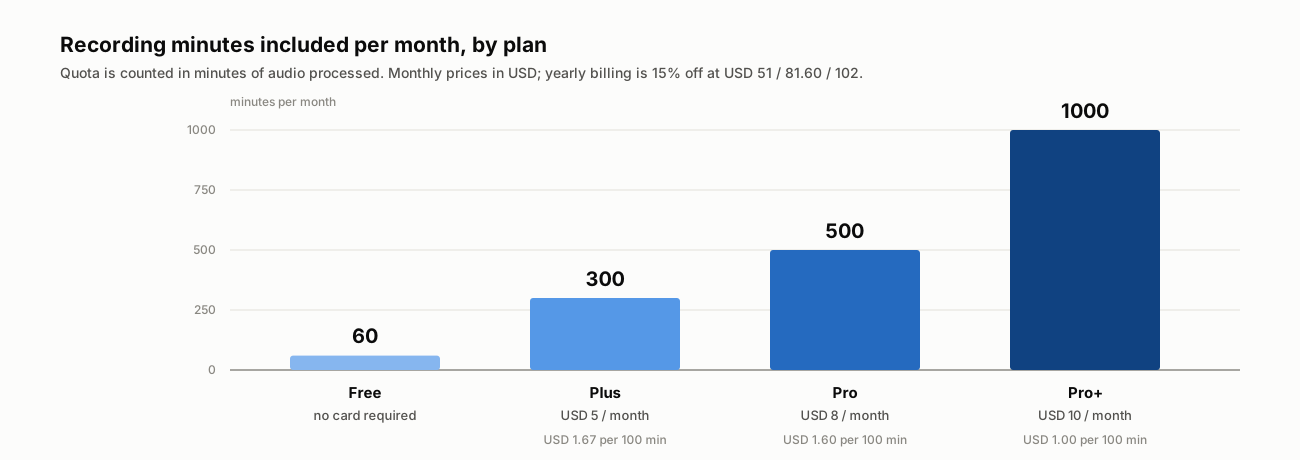
年額は月額 × 12 × 0.85 です。プランが上がるほど分あたりの単価は良くなり、パイプラインは変わりません。
無料の60分は、長い会議1回、またはスタンドアップ3回分です。本当に重要な問いひとつに答えるには十分でしょう。これは自分が実際に送るようなノートを生み出すのか。ベンダーのデモではなく、自分の音声で。
Telli.sh がやらないこと
機能だけを並べる製品記事は広告です。反対側の欄はこうなります。
動画ファイルは受け付けません。 アップローダーは audio/* のみです。先に音声トラックを抽出してください。
通話に代理で参加しません。 Zoom、Meet、Teams にダイヤルインして参加者一覧に居座るボットはありません。会議室を録音するか、自分の端末の音声を録音するか、終わってからファイルをアップロードする方式です。
悪い音声を直しません。 これはカテゴリ全体の正直な境界線です。12人が座るテーブルの端に置かれた無指向性のノートパソコンのマイク1本で、壁の硬い部屋で録れば、どこのモデルを動かしても話者分離の品質は落ちます。重なった発話と遠い話者が、話者帰属の最初に崩れる箇所です。テーブルの真ん中に置いたスマートフォンは、端に置いたノートパソコンに毎回勝ちますし、費用はゼロです。
伝えなければあなたの語彙を知りません。 上の第3層の話です。珍しい固有名詞が最も多い誤りの原因であり、コンテキスト欄がその解決策です。
話者ラベルは汎用名で始まります。 SPEAKER_01 がプリヤさんだと当てられるシステムはありません。ノートごとに一度名前を変えるだけです。
共有リンクには期限があります。 7日、そのあとリンクは死にます。会議コンテンツに対する意図的な既定値であり、忘れた機能ではありません。ただし共有リンクはアーカイブではないという意味でもあります。恒久的に残したいなら Markdown でエクスポートしてください。
結論
初期に私たちがした間違いは、これを文字起こし製品だと考えたことでした。違います。文字起こしは5段階のうちの第1段階であり、解決に最も近づいている段階です。
私たちが実際に作っているのは、録音と決定のあいだの距離です。誰が話したかを知ること、90秒の咳払いをその中にある一文へ縮めること、その一文を読み手が働いている言語に移すこと、そして同僚が開ける場所に置くこと。録音は証拠です。ノートは来週何が起きるかを変えるものです。
いまパソコンに会議の録音がひとつあるなら、それが唯一意味のあるベンチマークです。私たちの場合、セットアップに60秒かかり、4人に送ったノートが出てきました。
出典
- STT の精度だけでは足りない — Telli.sh ブログ、2026年8月4日 — リーダーボードの分布を含む単語誤り率の議論の全文
- pyannote/speaker-diarization-community-1 — Hugging Face — このパイプラインで使う話者分離モデル
- Deepgram Nova-3 モデルのドキュメント — 本番環境で使う音声認識モデル
- Telli.sh の料金 — 上で引用したプランの上限と価格
- Wikimedia Commons の画像ページ — ヘッダー画像、Klean Denmark、CC BY-SA 2.0
