Nova-3が今月58番目の言語を追加しました。同じ文の中で使えるのは、そのうち10言語だけです。
2026年8月4日、DeepgramはNova-3にパンジャブ語とネパール語を追加し、8月7日にはアルメニア語を追加してタミル語、インドネシア語、ベラルーシ語のモデルを改善しました。9か月前は31言語だったものが、今日のドキュメントでは58言語になっています。しかしコードスイッチングが機能するのは正確に10言語だけで、8月のチェンジログ自体が、インドネシア語はバッチのみ、ベラルーシ語はストリーミングのみの改善だったと記しています。音声認識の言語カバレッジが広がる速度と、「対応」という言葉が実際に隠しているものを見ていきます。
2026年8月4日、Deepgramが音声認識モデルNova-3にパンジャブ語とネパール語を追加しました。その3日後には、アルメニア語の追加と、タミル語・インドネシア語・ベラルーシ語のモノリンガルモデルの改善が行われています。
チェンジログの項目が2件、合わせて11行。プレスリリースはありません。それでも、これらの言語で会議をしている人にとっては、今月の音声認識分野で起きた最も重要な出来事です。
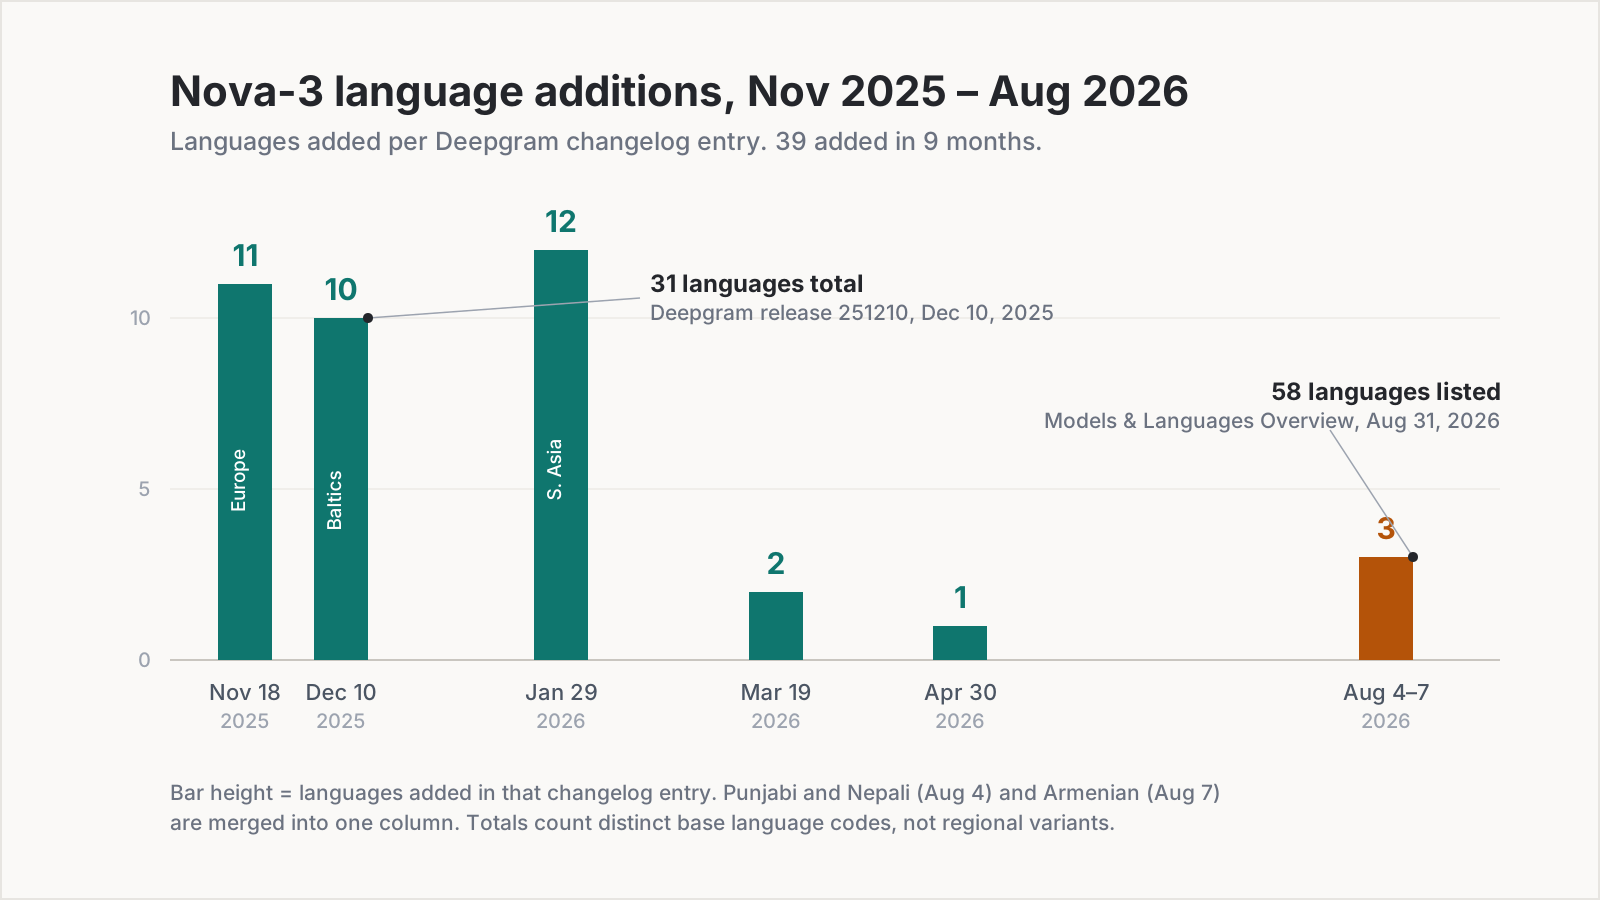
価値があるのは項目そのものよりも、その背後にあるパターンです。2025年12月、Deepgramのリリースノートは Nova-3 の対応言語を31言語と明記していました。そして今日、2026年8月31日時点でDeepgramのModels & Languages Overviewに載っている基本言語コードを重複なく数えると58になります。業界全体がこの速度で動いており、この速度は、あなたが文字起こしに期待すべき水準を静かに変えてしまいました。
この記事は3つのことをします。まず一次情報をもとに、その拡大に数字と日付を与えます。次に、対応言語数という見出しの数字がそれだけではほとんど役に立たない理由と、代わりに問うべき3つの質問を説明します。最後に、パンジャブ語・ネパール語・アルメニア語・タミル語・インドネシア語の話者がいる会議で、8月の追加が具体的に何を変えるのかを整理します。
TL;DR:
- 58対31。 Nova-3のドキュメントは2025年12月10日時点で合計31言語、2026年8月31日時点で重複のない基本言語コード58件を掲載しています。日付入りのチェンジログ9件を通じて39言語が追加された計算です。
- カバレッジは1つの数字ではありません。 Deepgramの
language=multiによるコードスイッチングモードが対象とするのは正確に10言語です(英語、スペイン語、フランス語、ドイツ語、ヒンディー語、ロシア語、ポルトガル語、日本語、イタリア語、オランダ語)。残る48言語は一度に1言語のみです。- バッチとストリーミングは別の製品です。 8月7日のリリースは、タミル語を両方で、インドネシア語をバッチのみで、ベラルーシ語をストリーミングのみで改善しました。同じチェンジログ項目1件の中に、3つの異なる結果が入っています。
- 今もモノリンガルが勝ちます。 Nova-3の58言語のうち48言語では、専用モデルはマルチリンガルモードより優れているどころか、存在する唯一の選択肢です。
図表: Telli.sh。2025年11月18日から2026年8月10日までのDeepgramチェンジログ項目、および2026年8月31日に取得したModels & Languages Overviewをもとに作成。
12月は31言語、8月は58言語
音声認識ベンダーは、精度を発表するようには対応言語を発表しません。リリースノートに数言語ずつ静かに積み上がっていくため、さかのぼって自分で足し合わせない限り、その累積効果は見落とされます。そこで、実際に足してみました。
2025年11月18日付のリリース251118は、Nova-3のモノリンガル対応に11言語を追加しました。ブルガリア語、チェコ語、フィンランド語、ヒンディー語、ハンガリー語、日本語、韓国語、ポーランド語、ロシア語、ウクライナ語、ベトナム語です。その3週間後、2025年12月10日のリリース251210は、南欧・バルト・東南アジアにまたがる10言語を追加しました。ギリシャ語、ルーマニア語、スロバキア語、カタルーニャ語、リトアニア語、ラトビア語、エストニア語、フラマン語、スイスドイツ語、マレー語です。このリリースノートには、この話全体で最も有用な一文が含まれています。「Nova-3は現在、合計31言語に対応しています。」
その後も追加は続きました。2026年1月29日のリリース260129は、ベラルーシ語、ベンガル語、ボスニア語、クロアチア語を含む12言語を追加。2026年3月19日のリリース260319はタイ語と広東語をもたらしました。2026年4月30日のリリース260430はグジャラート語を追加。そして8月です。4日にパンジャブ語とネパール語、7日にアルメニア語でした。
2025年11月18日から2026年8月10日までの、ドキュメントで確認できる追加分を合計すると、9か月弱で39言語になります。1社だけで、およそ7日に1言語のペースを持続してきた計算です。
ここで注目したい細部があります。これらのリリースが実際にどう届くのかを教えてくれるからです。クラウドのチェンジログは、パンジャブ語とネパール語の追加を2026年8月4日としています。同じモデルを同梱するセルフホスト版リリース260812は8月12日付です。ホスト型APIとコンテナイメージのあいだに8日の遅れがあります。Deepgramを自社ハードウェアで動かしているなら、「対応」という状態は他の人より1週間以上遅れて届いたことになります。
「対応」は1つではなく、3つの質問である
ここからが、見出しの数字が隠している部分です。ベンダーがある言語に対応していると言うとき、その一語は少なくとも3つの役割を同時に担っており、この3つは頻繁に食い違います。
リアルタイムで使えるのか、それとも事後だけか。 バッチ文字起こしとストリーミング文字起こしは、制約の異なる別々のモデルで動きます。ストリーミングモデルは文末を聞き終える前に単語を確定しなければならず、バッチモデルは録音全体を受け取れます。ベンダーはこの2つを別々に出荷し、必ずしも同時に出すわけではありません。
モデルは実際どれくらい良いのか。 「対応」が意味するのは、そのコードが受け付けられるということであって、出力が経営会議に使える水準だということではありません。先月追加された言語と、4回の改善を経た言語が、同じ表の同じセルに並んで載っています。
他の言語と混ぜられるのか。 壊れるまでほとんど誰も確認しないのがこれです。全員がネパール語で話す会議を文字起こしすることと、一文の途中でネパール語と英語を行き来する会議を文字起こしすることは、技術的に別の問題です。そして2つ目の問題が解けている言語は、はるかに少ないのです。
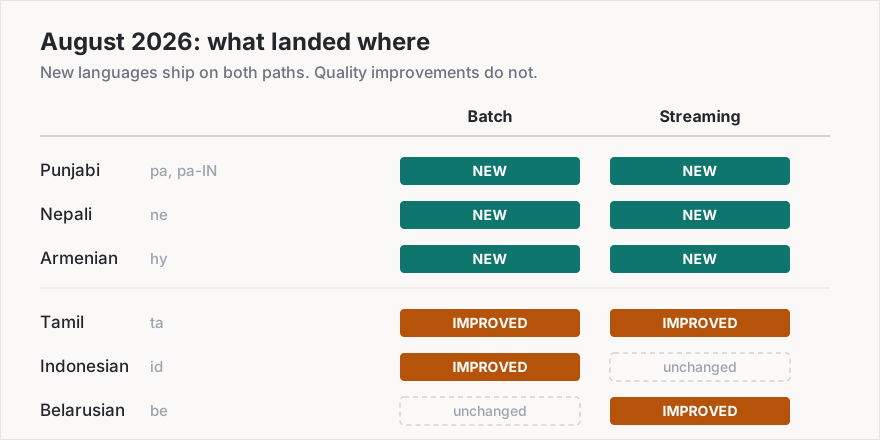
8月のチェンジログ自体が、1つ目の質問について私たちがこの1年で見た中で最も明快な実例になっています。8月7日の項目は4つを改善しましたが、その改善は一様ではありませんでした。
図表: Telli.sh。2026年8月4日および8月7日付のDeepgramチェンジログ項目より。
パンジャブ語、ネパール語、アルメニア語は両方の経路で登場しました。Deepgramは「これらの言語ではバッチモデルとストリーミングモデルの両方が利用可能」とはっきり述べています。タミル語はバッチとストリーミングの両方で改善モデルを得ました。インドネシア語が得たのは改善された バッチ モデルで、ストリーミングには新しいものがありません。ベラルーシ語が得たのは改善された ストリーミング モデルで、バッチには新しいものがありません。
録音済みのインドネシア語インタビューを文字起こししているなら、8月7日は良い日でした。インドネシア語でライブ会議を回しているなら、8月7日に変わったことは何もありません。この2つの事実は1件のチェンジログの1つの箇条書きの中に同居しており、その項目を要約したどの記事も、どちらがあなたに当てはまるのかは教えてくれません。
この非対称性は雑さの表れではありません。これらが学習と検証の予算をそれぞれ持つ、本当に別のモデルであるという事実を反映しています。そして、ベンダーのチェンジログを見出し単位ではなく個々の言語の単位で読むべき、最も強い理由でもあります。
カバレッジの崖: 58言語、10の会話
3つ目の質問に移ります。興味深い断絶があるのはここです。
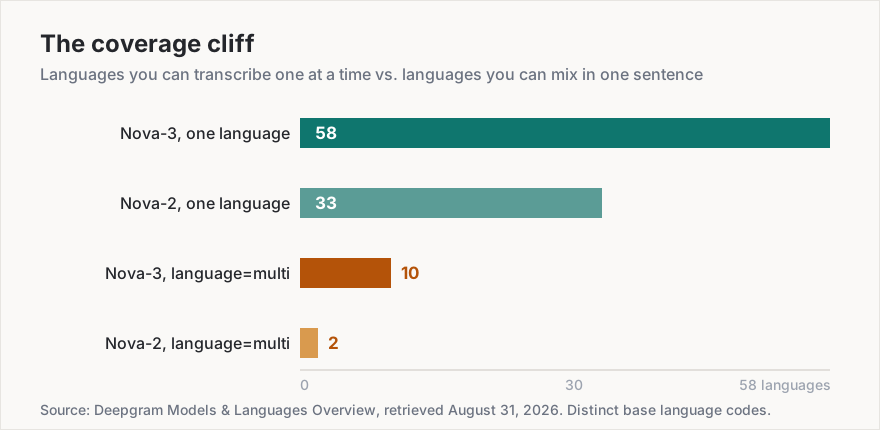
Deepgramのマルチリンガル・コードスイッチングモードはlanguage=multiというパラメータ1つで有効になり、話者が一文の中で言語を移動する状況を1回のリクエストで扱えます。実際に有用で、Nova-2、Nova-3、Flux Multilingualで利用できます。そして、モノリンガルのカタログよりはるかに狭い範囲です。
Nova-3でlanguage=multiが対象とするのは正確に10言語、英語、スペイン語、フランス語、ドイツ語、ヒンディー語、ロシア語、ポルトガル語、日本語、イタリア語、オランダ語です。Nova-2では同じパラメータの対象は2言語、スペイン語と英語だけです。
図表: Telli.sh。2026年8月31日に取得したDeepgram Models & Languages Overviewより。地域別・文字体系別のバリアントを除いた基本言語コードの件数。
これをカバレッジの崖と呼ぶことにします。ベンダーが一覧に載せた言語と、英語が半分混じったあなたの実際の会議が処理される言語との落差のことです。崖の上には58言語が立っています。落ちて生き残るのは10言語です。
崖の反対側に残る48言語、つまりパンジャブ語、ネパール語、アルメニア語、タミル語、ベンガル語、タイ語、韓国語、ベトナム語、マレー語などにとって、専用のモノリンガルモデルは単に良い選択肢なのではありません。唯一の選択肢です。比較すべきコードスイッチングの経路がそもそも存在しません。
ここが要点です。マルチリンガルモードのほうが常に高性能だという直感とは逆になります。世界の大多数の言語にとって、モノリンガルモデルは代替手段ではなく上位の選択肢です。 専用モデルは1つの言語の音韻、1つの言語の語彙分布、1つの言語の数字と日付の表現だけを学習します。マルチリンガルモデルはその10通りを同時に保持し、単語ごとに、いま聞こえているのがどれなのかを判定しなければなりません。会議がタミル語で行われるとわかっているとき、それをエンジンに伝えるのは受け入れる制約ではなく、利用できる中で最も精度の高い設定です。
language=multi(コードスイッチング) | 専用言語モデル | |
|---|---|---|
| Nova-3の対応言語 | 10言語 | 58言語 |
| Nova-2の対応言語 | 2言語(スペイン語 + 英語) | 33言語 |
| 文中での言語切り替えへの対応 | 可能 | 不可 — 対象外の言語の発話は品質が落ちる |
| 言語が1つに定まっている場合の精度 | 低い。モデルが候補間で判定を行う | 高い。モデルがその言語に特化している |
| キータームプロンプティング | Nova-3 Multiで可能。最大500トークン(約100語)、2025年12月10日から | 可能 |
| 推奨されるストリーミング設定 | Deepgramのガイドに従いendpointing=100 | 既定のエンドポインティング |
| パンジャブ語・ネパール語・アルメニア語・タミル語での利用 | 不可 | 可能 |
この表の実務的な読み方はこうです。会議が本当に英語とスペイン語を文単位で行き来するなら、multiを使って精度の代償を受け入れてください。会議がタミル語で、ときどき英語の借用語が混じる程度なら、つまり大半の「多言語」会議が実際にそうであるように、language=taを設定して専用モデルに仕事をさせてください。
今月、実際に会議が良くなるのは誰か
構造の話はここまでにします。2026年8月に状態が変わった言語は6つあり、それぞれのコードの背後には、会議の記録をうまく残せずにいた、あるいはまったく残せずにいた人々がいます。
| 言語 | コード | 話者数 | 2026年8月に変わったこと |
|---|---|---|---|
| パンジャブ語 | pa、pa-IN | 約1億2,500万人 | Nova-3に新規追加、バッチとストリーミングの両方(8月4日) |
| ネパール語 | ne | 約1,600万人 | Nova-3に新規追加、バッチとストリーミングの両方(8月4日) |
| アルメニア語 | hy | 約670万人 | Nova-3に新規追加、バッチとストリーミングの両方(8月7日) |
| タミル語 | ta | 母語話者 約7,500万人 | モデル改善、バッチとストリーミングの両方(8月7日) |
| インドネシア語 | id | 第二言語話者を含め約1億9,900万人 | バッチモデルのみ改善(8月7日) |
| ベラルーシ語 | be | 約760万人 | ストリーミングモデルのみ改善(8月7日) |
話者数: Wikidataのプロパティ P1098 に集約されたEthnologueの数値、2026年8月31日取得。概数。
つまり、わずか1週間のあいだに、およそ4億3,000万人の言語が目に見えて良い音声認識を手にしたことになります。そのうち約1億4,800万人、パンジャブ語・ネパール語・アルメニア語の話者は、Nova-3に正規の選択肢がまったくない状態から、バッチとストリーミングの両方を持つ状態へ移りました。
これが会議室で何を意味するかを考えてみてください。チャンディーガルのエンジニアリングチームの朝会は、これまでツールの都合で第二言語で行われるか、記録が残らないままでしたが、いまはリアルタイムの文字起こしを生み出します。カトマンズのNGOの現地報告は、誰かの手書きメモではなく検索可能な記録になります。アルメニア語の法廷証言は、分単位の料金で手作業の書き起こしに出す代わりに、その場で文字にできます。
文字起こしそのものより重要な二次的効果もあります。ある言語の音声がリアルタイムで機械可読になった瞬間、その下流にあるものが一斉に開きます。遠隔参加者向けのライブ翻訳、自動要約、アクションアイテムの抽出、1年分の会議を横断する検索。音声認識はボトルネックの工程です。そこを通過した言語は、英語のために作られたパイプライン全体をそのまま受け継ぎます。
「うちの言語はツールが対応していないから」という理由で誰かが習慣的に英語へ切り替えているチームなら、今回のアップデートはその妥協を終わらせるものです。
多言語会議で言語設定を選ぶ手順
エンジンの改善は、セッションを正しく設定して初めて効きます。そして既定値は、多言語チームにとって間違っていることが少なくありません。順番に5ステップです。
- 会議に支配的な言語が1つあるのか、本当に混在するのかをまず見極めてください。 タミル語の会議に英語の借用語がときどき混じるのは 1つ の言語です。スペイン語と英語の文を交互に話すのは 2つ の言語です。コードスイッチングが必要なのは後者だけです。
- 1言語であれば、その言語を明示的に指定してください。
model=nova-3に具体的なコードを添えます。パンジャブ語はlanguage=pa、ネパール語はlanguage=ne、アルメニア語はlanguage=hyです。自動検出に任せないでください。答えはすでにわかっており、モデルに伝えるコストはゼロです。 - 本当に混在するなら、その言語が10言語のリストにあるか確認してください。 会議室にあるすべての言語が英語、スペイン語、フランス語、ドイツ語、ヒンディー語、ロシア語、ポルトガル語、日本語、イタリア語、オランダ語に含まれる場合にのみ
language=multiを設定します。1つでも外れるならmultiは助けにならず、支配的な言語のモデルが最良の選択肢です。 multiでライブセッションを行う場合はendpointing=100を設定してください。 Deepgram自身のコードスイッチングガイドは、既定値より短い100ミリ秒をコードスイッチング向けに推奨しています。エンドポインティングが長いと、切り替わった言語のフレーズが誤ったセグメントに取り込まれます。- 約束をする前に、バッチとストリーミングを別々に検証してください。 8月7日が示したとおり、一方の改善はもう一方の改善ではありません。チェンジログの記載が自分の経路にも当てはまると仮定せず、同じ10分のサンプルを両方の経路に通して比較してください。
この話題の別の側面は6月に取り上げました。Deepgram's mid-year update on adaptive live sessions and diarizationでは、実行中のセッションが再接続なしに言語ヒントを変更できるUpdateListenコントロールにも触れています。上のステップ2とこの機能は相性が良く、開始時に言語を明示しておき、会議の流れが実際に変わったら途中で調整できます。
結論: カバレッジは数字であることをやめ、マトリクスになった
音声エンジンを比較するとき、人はまず最も大きい数字を探します。OpenAIのWhisperのトークナイザーは2022年から100の言語トークンを宣言しており、これはNova-3の58のほぼ2倍です。しかしその比較はほとんど何も教えてくれません。Whisperにはネイティブなストリーミング経路がなく、宣言されたトークンは検証済みの本番モデルではないからです。Nova-3は掲載言語こそ少ないものの、言語ごと、モードごとに、日付の付いた根拠とともに実際に出荷しています。
エンジンの本当のカバレッジを表す数値は、件数ではありません。言語 × モード × 品質段階からなるマトリクスです。一度に1つずつ使える58言語。そのうち混在させられる10言語。そして同じリリース、同じ日に、バッチだけで改善された言語と、ストリーミングだけで改善された言語。
だから次のベンダー評価に持っていくべき質問は「何言語に対応していますか」ではありません。私の言語は、私の経路で、いつの時点で対応していますか です。
Telli.shの位置づけ: ここまでの内容はすべてエンジン層の細部であり、私たちは、ほとんどのチームがこれを知らなくて済むべきだと考えています。Telli.shはその層の上に立ち、上の番号付きリストにある判断を代わりに行います。会議が1言語なら専用モデルを選び、ファイルのアップロードとライブセッションをそれぞれ正しい経路に保ち、8月のようなエンジン改善を次回の移行時ではなく出荷されたその週に受け継ぎます。さらに文字起こしの上でライブ翻訳を44の対象言語へ、インターフェースを15言語で提供しているので、ワルシャワからあなたのパンジャブ語の朝会に参加した人は、その場でポーランド語として読めます。
出典
- Deepgram changelog, August 4, 2026 — Nova-3 Model Update — パンジャブ語(
pa、pa-IN)とネパール語(ne)、バッチとストリーミングの両方が利用可能 - Deepgram changelog, August 7, 2026 — Nova-3 Adds Armenian, Plus Improved Models for Tamil, Indonesian, and Belarusian — アルメニア語(
hy)が新規。タミル語とインドネシア語のバッチモデル改善、タミル語とベラルーシ語のストリーミングモデル改善 - Deepgram Models & Languages Overview — Nova-3とNova-2の全言語表および
multiの言語リスト、2026年8月31日取得 - Deepgram Multilingual Codeswitching guide —
language=multiの使い方とendpointing=100の推奨、2026年8月31日取得 - Deepgram Self-Hosted release 251210, December 10, 2025 — 「Nova-3は現在、合計31言語に対応しています」、最大500トークンのマルチリンガル・キータームプロンプティング
- Deepgram Self-Hosted release 251118, November 18, 2025 — 新規11言語と、36言語の言語検出モデル
- Deepgram Self-Hosted release 260129, January 29, 2026 — ベラルーシ語、ベンガル語、ボスニア語、クロアチア語を含むNova-3の新規12言語
- Deepgram Self-Hosted release 260319, March 19, 2026 — タイ語と広東語
- Deepgram Self-Hosted release 260430, April 30, 2026 — グジャラート語
- Deepgram Self-Hosted release 260812, August 12, 2026 — クラウド版の項目から8日遅れの、ネパール語とパンジャブ語のセルフホスト版バンドル
- OpenAI Whisper tokenizer language table — 宣言された言語トークン100件、2026年8月31日取得
- Wikidata property P1098 (number of speakers) —
pa、ne、hy、ta、id、beのEthnologue由来の話者数、2026年8月31日取得 - Our June 2026 coverage of Deepgram's live-session and diarization updates