Plik o wielkości 16,5 GB wyprzedza już najlepszy zamknięty model z lutego
Trzy lata temu najlepszy model do pobrania przegrywał z GPT-4 o 37 punktów w HumanEval i wymagał dwóch kart graficznych. W zeszłym tygodniu otwarty model 27B uzyskał 52,0 w indeksie inteligencji Artificial Analysis wobec 44,9 Claude Opus 4.6 Max — za jedną dziewiątą ceny, z pliku o wielkości 16,5 GB. Porównanie „przed i po” z tabelami benchmarków, krzywą cen i wyjaśnieniem, co oznacza opóźnienie doganiania skrócone do 162 dni.
Ktoś na Hacker News uruchamia model językowy z najwyższej półki na karcie graficznej z 16 GB pamięci, przy 50–60 tokenach na sekundę i oknie kontekstu 128 000 tokenów. To Qwen3.8-27B, wydany 14 sierpnia 2026 roku. W indeksie inteligencji Artificial Analysis uzyskuje 52,0 — więcej niż Claude Opus 4.6 Max, jeszcze w lutym najlepszy zamknięty model na rynku, który ma 44,9.
W 2023 roku takie zdanie byłoby science fiction. I to nie tym przyjemnym.
Ten tekst to porównanie „przed i po”. Nie relacja z premiery — tę już napisaliśmy — lecz zestawienie na przestrzeni trzech lat: ile najlepszy model do pobrania uzyskiwał wobec czołówki wtedy i dziś, ile kosztowało kupienie określonego poziomu inteligencji wtedy i dziś oraz jaki sprzęt trzeba było mieć, żeby uruchomić go samodzielnie. Każda liczba poniżej ma źródło i datę. Trend, który rysują, należy do najbardziej szczerze optymistycznych rzeczy dziejących się dziś w oprogramowaniu.
W skrócie:
- Dystans się domknął i da się go datować. W lipcu 2023 roku najlepszy otwarty model przegrywał z GPT-4 o 17,5 punktu w MMLU i o 37,1 punktu w HumanEval. W sierpniu 2026 roku otwarty 27B wygrywa z lutowym zamkniętym okrętem flagowym w 15 z 19 benchmarków publikowanych przez obie strony oraz w niezależnym indeksie zbiorczym.
- Cena spadła około 208-krotnie w 23 miesiące — to pomiar Epoch AI przy stałym progu jakości. Otwarty 27B kosztuje dziś 1,09 dolara za milion tokenów w taryfie mieszanej wobec 10,00 dolara za Opus 4.6 Max, a zero za token, jeśli uruchamiasz go u siebie.
- To nie jest czołówka i mówimy to wprost. Claude Opus 5 Max ma 63,1, a GPT-5.6 Sol Max 60,9. W rozumowaniu opartym na szerokiej wiedzy 27B wyraźnie przegrywa z Opus 4.6: 30,8 wobec 40,0 w HLE.
Zdjęcie: Steve Jurvetson, Wikimedia Commons, CC BY 2.0. Połączenia Cray Y-MP, około 1988 roku. Poważne obliczenia bywały kiedyś salą, do której się wchodziło.
Jak naprawdę wyglądało „przed”
Cofnijmy zegar do 18 lipca 2023 roku, dnia, w którym Meta opublikowała Llama 2. Był to najlepszy swobodnie pobieralny model na świecie, a jego własny artykuł bez owijania w bawełnę wydrukował tabelę wyników wobec zamkniętej czołówki.
Llama 2 70B uzyskała 68,9 w MMLU wobec 86,4 GPT-4. W GSM8K — 56,8 wobec 92,0. W HumanEval, benchmarku programistycznym — 29,9 wobec 67,0, czyli mniej niż połowę. Podsumowanie samego artykułu brzmi: „Między Llama 2 70B a GPT-4 i PaLM-2-L nadal istnieje duża różnica wydajności”. Tak w 2023 roku brzmiał okręt flagowy otwartych wag, własnymi słowami.
Teraz sprzęt. Czterobitowa wersja społecznościowa TheBloke — sposób, w jaki ludzie faktycznie uruchamiali Llama 2 70B — była plikiem o wielkości 41,4 GB opublikowanym 4 września 2023 roku. Do sensownej prędkości potrzebne były dwie karty po 24 GB albo Mac z 64 GB. Na zwykły laptop wchodziła Llama 2 13B: plik 7,9 GB, 54,8 w MMLU, o 31,6 punktu za GPT-4 i przydatna do niewiele więcej niż demonstracji.
Układ z 2023 roku wyglądał więc tak: zapłać czołowemu laboratorium albo uruchom coś wyraźnie gorszego na sprzęcie, którego większość ludzi nie miała. Właśnie dlatego argument „po prostu użyj API” wygrywał tak zdecydowanie przez dwa lata. Był słuszny.
Teraz to samo pytanie w sierpniu 2026 roku
Alibaba opublikowała Qwen3.8-27B 14 sierpnia 2026 roku na licencji Apache 2.0 i umieściła na karcie modelu bezpośrednie porównanie z Claude Opus 4.6 Max. Policzyliśmy każdy wiersz, w którym oba modele podają liczbę.
Qwen3.8-27B wygrywa 15 z tych 19 wierszy i przegrywa 4. Wśród zwycięstw są SWE-bench Pro (61,7 wobec 53,4), podążanie za instrukcjami w IFBench (79,5 wobec 62,5), programowanie zawodnicze w LiveCodeBench v6 (90,3 wobec 88,8), obsługa komputera w OSWorld-Verified (84,3 wobec 72,7), zadania agenta mobilnego w AndroidWorld (81,9 wobec 62,0) oraz długa seria benchmarków multimodalnych, w których marginesy nie są wcale wyrównane: 90,0 wobec 65,5 w MathVision, 83,7 wobec 66,0 w analizie wykresów w CharXiv, 65,5 wobec 40,8 w rozumowaniu ucieleśnionym w ERQA.
Cztery porażki znaczą więcej niż zwycięstwa, bo mówią, czego model o 27 miliardach parametrów wciąż nie potrafi. Przegrywa w Terminal Bench 2.1 (73,0 wobec 78,2), w generowaniu kodu na poziomie repozytorium w NL2Repo-Bench (42,3 wobec 47,6), nieznacznie w GPQA Diamond (89,2 wobec 91,3) i wyraźnie w HLE, benchmarku szerokiego rozumowania międzydziedzinowego: 30,8 wobec 40,0. To ostatnie to kształt całego ograniczenia. Wiedzy świata nie da się skompresować do pliku o wielkości 16,5 GB; ogromną ilość umiejętności — owszem.
Jeden wiersz zasługuje na gwiazdkę: wynik 79,0 wobec 63,8 pochodzi z QwenSWEBench, benchmarku zbudowanego przez samą Qwen. Przebieg dostawcy na własnym benchmarku to najsłabszy dowód w każdej karcie modelu i nie opieramy się na nim.
Niezależna tabela mówi to samo
Tabela dostawcy pozostaje tabelą dostawcy, więc oto strona trzecia. Artificial Analysis, która prowadzi własne ewaluacje zamiast przedrukowywać cudze, zmierzyła już 27B. Na 21 sierpnia 2026 roku przyznaje Qwen3.8-27B indeks inteligencji 52,0 — pierwsze miejsce wśród 135 modeli w klasie otwartych wag od 4 do 40 miliardów parametrów, wobec 44,9 dla Claude Opus 4.6 Max. To 7,1 punktu przewagi otwartego modelu, zmierzone przez podmiot bez interesu w wyniku, 190 dni po premierze Opus 4.6.
Prześledź to porównanie wstecz i tam właśnie jest cała historia. W lipcu 2023 roku najlepszy otwarty model poniżej 40 miliardów parametrów miał w tym samym indeksie 2,6. W lipcu 2024 roku — 7,4. W marcu 2025 — 13,4. W lutym 2026 — 34,6. W zeszłym tygodniu — 52,0.
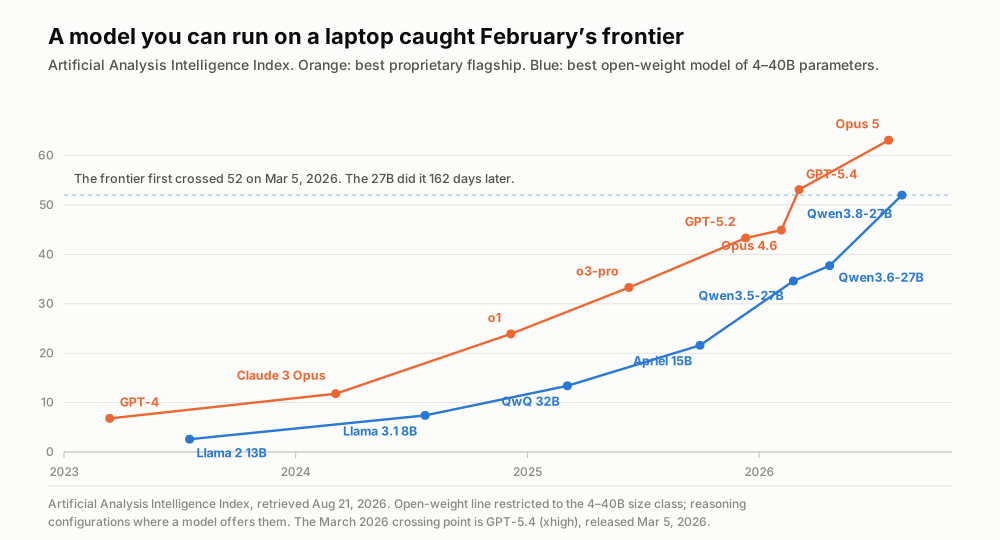
Obie linie rosną; interesująca jest pozioma odległość między nimi. Indeks inteligencji Artificial Analysis, dane z 21 sierpnia 2026 roku.
Oto liczba, która zasługuje na nazwę. Czołówka po raz pierwszy przekroczyła indeks 52 piątego marca 2026 roku, gdy GPT-5.4 przy maksymalnym wysiłku rozumowania osiągnął 53,1. Model dostatecznie mały, by działać na osobistej maszynie, dotarł tam 14 sierpnia — 162 dni później. Nazwijmy to opóźnieniem doganiania: czasem między pojawieniem się zdolności w czołówce a jej pojawieniem się na twoim sprzęcie.
Kiedyś to opóźnienie było znacznie dłuższe. Llama 3.1 8B potrzebowała 260 dni, żeby dojść do poziomu osiągniętego przez GPT-4 Turbo. GLM-4.7-Flash potrzebował 410 dni, by dorównać o1. Trzy ostatnie premiery w rozmiarze laptopowym to 201, 155 i 162 dni. Czołówka nie zwalnia — Opus 5 Max jest dziś na 63,1 — ale goniąca krawędź nadrabia mniej więcej dwa razy szybciej niż dwa lata temu.
Cena nie spadła, tylko runęła
Zdolności to połowa porównania. Druga połowa to rachunek.
Epoch AI opublikowała najczystszy pomiar tego zjawiska w marcu 2025 roku, a metoda jest warta zrozumienia: ustalamy wynik benchmarku, a potem śledzimy w czasie najtańszy model, który go osiąga. Ustaw próg na 86 punktach GPT-4 w MMLU, a drabina wygląda tak: 37,50 dolara za milion tokenów w marcu 2023, 15,00 w listopadzie 2023, 7,50 w maju 2024, 2,19 jeszcze w tym samym miesiącu i 0,18 w lutym 2025. Wynik ten sam. 208 razy taniej w 23 miesiące.
Główny wniosek Epoch jest taki, że tempo ogromnie zależy od zadania — od 9 do 900 razy rocznie, w zależności od tego, którą zdolność ustalimy — przy czym cena wydajności na poziomie GPT-4 w pytaniach naukowych na poziomie doktoratu spadała o mniej więcej 40 razy rocznie. Kierunek nie zmienia się nigdy.
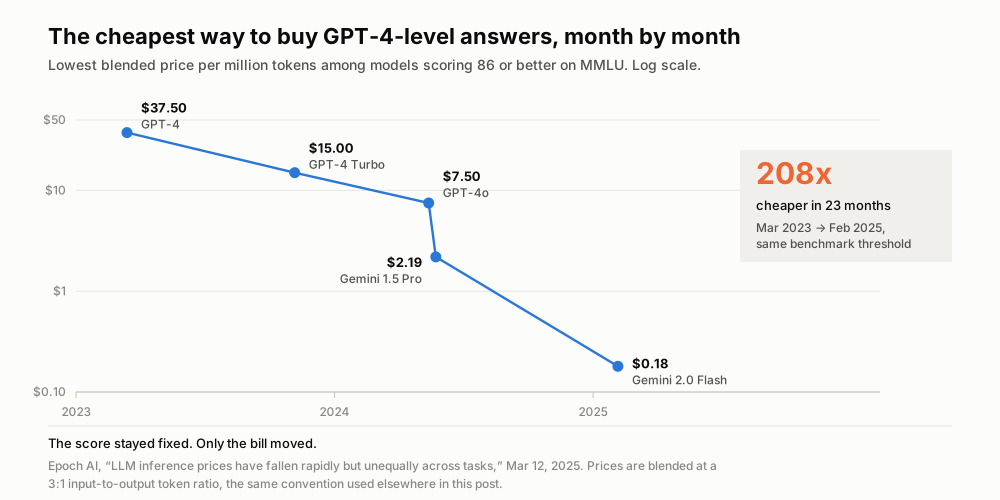
W każdym punkcie tej linii wynik benchmarku jest stały. Epoch AI, 12 marca 2025 roku.
Przedłuż serię do dzisiejszych cen, a ruch trwa dalej. W katalogu OpenRouter na 21 sierpnia 2026 roku Qwen3.8-27B kosztuje 0,45 dolara za milion tokenów wejściowych i 3,20 za milion wyjściowych; Claude Opus 4.6 kosztuje 5,00 i 25,00. Po zmieszaniu w stosunku 3 do 1 stosowanym przez Epoch daje to 1,09 wobec 10,00 dolara — otwarty model jest 9,1 razy tańszy i o 7,1 punktu indeksu lepszy od zamkniętego okrętu flagowego sprzed pół roku.
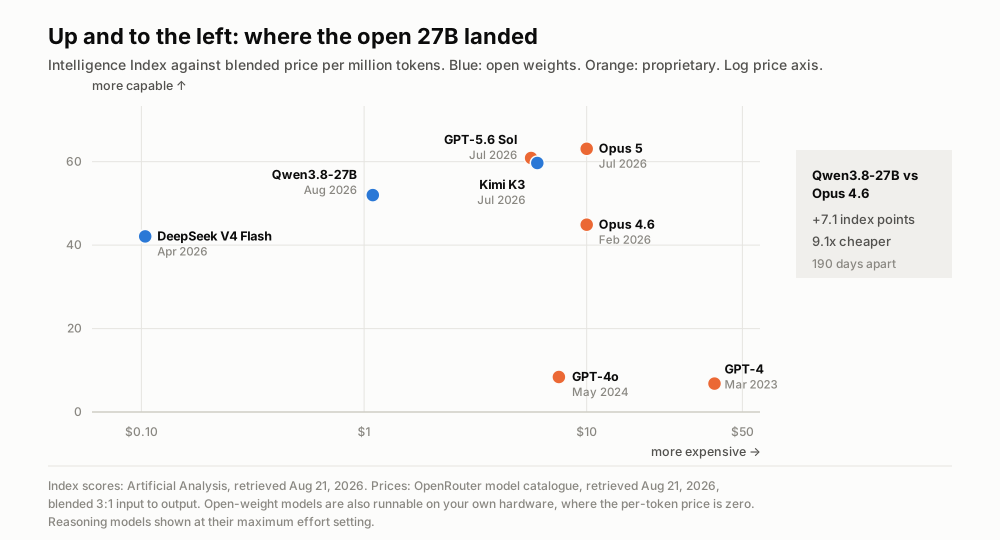
Wszystkie liczące się modele przesuwają się w lewy górny róg. Wyniki z Artificial Analysis, ceny z OpenRouter, dane z 21 sierpnia 2026 roku.
Jest jeszcze opcja, która w ogóle nie ma ceny za token. Uruchom 27B na własnej RTX 4090 przy około 48 tokenach na sekundę, o których donosili użytkownicy w wątku premierowym, przyjmij znamionowe 450 watów karty, a przy średniej cenie energii dla gospodarstw domowych w USA wynoszącej 18,44 centa za kilowatogodzinę (EIA, maj 2026) prąd wychodzi na około 0,48 dolara za milion tokenów wyjściowych — jeszcze bez wliczania karty i już bez wliczania czyjejkolwiek marży. To wyliczona estymacja z jawnie podanymi założeniami, a nie deklaracja producenta.
Przed i po, wiersz po wierszu
| Lipiec 2023 | Sierpień 2026 | |
|---|---|---|
| Najlepszy model do pobrania | Llama 2 70B (Meta, 18 lipca 2023) | Qwen3.8-27B (Alibaba, 14 sierpnia 2026) |
| Parametry | 70 mld | 27 mld |
| Standardowa wersja społecznościowa 4-bitowa | 41,4 GB | 16,5 GB |
| Najmniejsza użyteczna wersja | 7,9 GB (13B, MMLU 54,8) | 9,8 GB (2 bity, kontekst 128K na karcie 16 GB) |
| Realistyczny sprzęt | dwie karty 24 GB albo Mac 64 GB | jedna konsumencka karta 16 GB |
| Model czołówki z tamtego czasu | GPT-4 (14 marca 2023) | Claude Opus 4.6 Max (5 lutego 2026) |
| Wynik przeciwko niemu | −17,5 MMLU, −35,2 GSM8K, −37,1 HumanEval | wygrywa 15 z 19 opublikowanych benchmarków, +7,1 punktu indeksu |
| Mieszana cena tego modelu czołówki | 37,50 $ za milion tokenów | 10,00 $ za milion tokenów |
| Mieszana cena modelu otwartego | brak oferty w skali | 1,09 $ za milion tokenów |
| Licencja | Llama 2 Community License | Apache 2.0 |
Źródła do każdej komórki są na końcu. Wiersz, do którego wracamy najczęściej, to przedostatni: cena samej czołówki spadła przez trzy lata 3,75-krotnie, a otwarta alternatywa pojawiła się pod nią, na poziomie mniej więcej jednej dziesiątej. Zdarzyło się jedno i drugie. To drugie zmienia, kto w ogóle może budować.
Co nadal nie jest prawdą
Entuzjazm wokół tej premiery wyprzedza dowody w czterech konkretnych miejscach. Zaznaczmy je.
To nie jest czołówka. W tym samym indeksie Claude Opus 5 Max ma 63,1, a GPT-5.6 Sol Max 60,9 — obydwa wyraźnie powyżej 52,0. Jeśli twoja praca zależy od najtrudniejszego dostępnego rozumowania, czołówka nadal jest innym produktem i nadal jest zamknięta.
Jak na swój rozmiar nie jest tani. Samo podsumowanie Artificial Analysis nazywa Qwen3.8-27B „szczególnie drogim w porównaniu z innymi modelami otwartych wag o podobnym rozmiarze”: mediana w tej klasie to 0,05 dolara za milion tokenów wejściowych wobec 0,43 u Qwen. Płacisz za zdolności, nie za parametry.
Jest rozwlekły, a rozwlekłość to rachunek. Podczas ewaluacji indeksu inteligencji 27B wygenerował 160 milionów tokenów wyjściowych przy medianie 45 milionów. Jeden z użytkowników podał mu dwuwyrazowy prompt na Macu mini z 64 GB i patrzył, jak myśli przez 17 minut i 12 sekund. Modele rozumujące liczą sobie za czas zegarowy, nawet gdy tokeny są darmowe.
I jeszcze jedno: wyniki benchmarków należą do modelu w pełnej precyzji. Dwubitowa wersja 9,8 GB, która mieści się w twojej karcie graficznej, to nie ten model, który uzyskał 52,0. Silna kwantyzacja kosztuje dokładność, zwłaszcza przy długich kontekstach. Każde stwierdzenie „działa na laptopie”, również nasze, niesie tę gwiazdkę.
Dlaczego opóźnienie powinno dalej maleć
Od tego miejsca to nasza ocena i wyraźnie zaznaczamy przejście: wszystko powyżej to pomiar, a dalej idzie wniosek z niego.
Mechanizm ściągający opóźnienie w dół nie jest tajemniczy. Techniki dotrenowywania publikowane w czołówce są odtwarzane w otwartych laboratoriach w ciągu miesięcy. Sterowanie wysiłkiem rozumowania, półtora roku temu zastrzeżona sztuczka, dziś trafia na tę kartę modelu jako udokumentowany parametr. Kwantyzacja społecznościowa kończy się, zanim dokumentacja macierzystego laboratorium przestanie się zmieniać. Żadna z tych trzech pętli sprzężenia zwrotnego nie ma powodu zwalniać, a dwie przyspieszają wraz z liczbą uczestników.
Rozsądne oczekiwanie wobec kolejnej generacji nie brzmi więc: modele otwarte wyprzedzą czołówkę. Brzmi: te 162 dni będą się dalej kurczyć, podczas gdy bezwzględne zdolności rosną po obu stronach. Wtedy interesujący próg to już nie „czy modele otwarte mogą wygrać”, lecz „jak świeża musi być czołówka, żeby różnica przestała mieć znaczenie dla mojego zadania”. Dla transkrypcji spotkań, tłumaczenia, streszczania i większości pracy z dokumentami ten próg został przekroczony dawno temu. Dla badań na przedpolu i najtrudniejszej inżynierii agentowej — jeszcze nie.
To dużo lepszy świat niż ten z 2023 roku i warto powiedzieć to wprost. Koszt nadania komputerowi kompetentnego rozumienia języka spadł w trzy lata o dwa rzędy wielkości i wciąż spada. Najwięcej zyskują ci, których wcześniej odcinała cena: samodzielni programiści, zespoły w krajach, gdzie 10 dolarów za milion tokenów nie jest błędem zaokrąglenia, badacze z grantem zamiast budżetu i wszyscy, których dane z powodów prawnych muszą zostać na własnej maszynie.
Podsumowanie: czołówka przestała być miejscem, a stała się datą
Dawne pytanie brzmiało: do którego laboratorium masz dostęp. Nowe brzmi: ile miesięcy za czołówką jesteś gotów być, skoro kosztuje to jedną dziewiątą i działa na sprzęcie, który już masz.
Dla coraz większej liczby zadań szczera odpowiedź brzmi: około pięciu miesięcy, i coraz mniej.
Gdzie w tym Telli.sh: wszystko powyżej to powód, dla którego budujemy na otwartych modelach, a nie wokół jednego dostawcy. Telli.sh używa już otwartego modelu Qwen w ścieżce streszczania, więc każdy krok w dół tej krzywej dociera jako lepsza notatka ze spotkania, a nie jako komunikat o podwyżce. Nasza praca to ta część, której nie da żadne pobranie: niezawodnie zarejestrować godzinę dźwięku, rozróżnić mówiących, tłumaczyć na żywo na 15 języków i zamienić to wszystko w notatki, które da się przeszukać także po miesiącach.
Źródła
- Karta modelu Qwen3.8-27B i tabele benchmarków, Hugging Face — liczby z bezpośredniego porównania z Opus 4.6 Max, dostęp 21 sierpnia 2026
- Artificial Analysis: analiza inteligencji, wydajności i ceny Qwen3.8 27B — indeks inteligencji 52,0, cena i rozwlekłość, dostęp 21 sierpnia 2026
- Artificial Analysis: strona modelu Claude Opus 4.6 — indeks inteligencji 44,9 przy maksymalnym wysiłku rozumowania, dostęp 21 sierpnia 2026
- Epoch AI, „LLM inference prices have fallen rapidly but unequally across tasks”, 12 marca 2025 — drabina cenowa przy stałym progu i zakres od 9 do 900 razy rocznie
- Llama 2: Open Foundation and Fine-Tuned Chat Models (arXiv:2307.09288), 18 lipca 2023 — tabela 4, Llama 2 70B wobec GPT-4
- Lista plików TheBloke/Llama-2-70B-Chat-GGUF — wersja Q4_K_M o wielkości 41,4 GB, opublikowana 4 września 2023
- Lista plików unsloth/Qwen3.8-27B-GGUF — wersje 16,5 GB i 9,8 GB, liczniki pobrań z 21 sierpnia 2026
- Katalog modeli OpenRouter — ceny za token dla Qwen3.8-27B, Claude Opus 4.6 i Claude Opus 5, dostęp 21 sierpnia 2026
- Dyskusja na Hacker News o premierze Qwen3.8-27B, 14 sierpnia 2026 — raporty przepustowości na kartach 16 i 24 GB
- US Energy Information Administration, Electric Power Monthly, tabela 5.3 — 18,44 centa za kilowatogodzinę, średnia dla gospodarstw domowych, maj 2026
- Nasz wcześniejszy tekst o premierze otwartych wag Qwen3.8 i o szerszej fali otwartych wag
- Strona fotografii Cray Y-MP w Wikimedia Commons
