Chiński trzytygodniowy zryw otwartych wag: Kimi K3, Qwen3.8-Max i zwrot, który może to wszystko zakończyć
W trzy tygodnie największe chińskie laboratoria AI wydały lub zapowiedziały graniczne modele z otwartymi wagami — Kimi K3, Qwen3.8-Max i DeepSeek V4 w ogólnej dostępności. Przewodnik prostym językiem: czym jest każdy model, co naprawdę się ukazało, a co wciąż jest obietnicą, i dlaczego Pekin może teraz ograniczyć falę, którą sam wywołał.
Między 16 a 26 lipca trzy z największych chińskich laboratoriów AI położyły na stole otwarte modele z górnej półki. Moonshot AI ogłosiło Kimi K3 16 lipca i udostępniło wagi 26 lipca. Alibaba pokazała Qwen3.8-Max 19 lipca na WAIC w Szanghaju. Linia V4 od DeepSeek osiągnęła ogólną dostępność (GA) około 20 lipca. Trzy laboratoria, mniej więcej trzy tygodnie.
Wzorzec trudno przeoczyć i nie jest to ten, na którym chińska scena otwartych modeli zbudowała swoją renomę. Te laboratoria słynęły z modeli małych, szybkich i tanich, które biły powyżej własnej kategorii. Ta fala to zakład odwrotny: systemy z bilionami parametrów, wydane albo obiecane jako otwarte wagi.
To uczciwa analiza tej fali: co naprawdę się ukazało, co wciąż jest zapowiedzią lub obietnicą, oraz zwrot, który przyszedł wraz z nią — ten sam rząd, który umożliwił te premiery, waży teraz, czy ich nie ograniczyć. Żargon ograniczymy do minimum, a resztę wyjaśnimy po drodze, byś mógł śledzić tę historię, nawet jeśli „otwarte wagi” i „mixture-of-experts” są dla ciebie nowością. Jeśli czytałeś nasze lipcowe podsumowanie, to jest jego dalszy ciąg, a jeden z jego wątków zawieszonych właśnie się rozwiązał.
Image: OLCF at ORNL, Wikimedia Commons, CC BY 2.0.
Najpierw pięć pojęć, dzięki którym wszystko się układa
Jeśli dopiero zaczynasz w tym zakątku AI, pięć terminów dźwiga większość tej historii i warto poświęcić im minutę prostym językiem, zanim przejdziemy do modeli.
„Otwarte wagi” (open weights) to cały powód, dla którego ta fala się liczy. Wagi modelu to gigantyczna siatka liczb, których nauczył się podczas treningu — w praktyce gotowy mózg. Gdy laboratorium udostępnia wagi, możesz pobrać ten plik, uruchomić model na własnym sprzęcie, dostroić go i budować na nim produkty, nie prosząc nikogo o pozwolenie ani nie płacąc za zapytanie. Alternatywą jest model zamknięty, jak większość komercyjnych chatbotów, gdzie wagi pozostają zamknięte na serwerach dostawcy, a ty wynajmujesz dostęp przez płatne API. Otwarte wagi zmieniają model z usługi, którą wynajmujesz, w coś, czego masz kopię — i to właśnie ta różnica sprawia, że cała branża nadstawia ucha, gdy pojawia się dobry model.
„Parametry” to owe wyuczone liczby, a ich liczba to przybliżony wskaźnik tego, ile model potrafi pomieścić. Model o „2,8 biliona parametrów” ma ich 2,8 biliona. Większy nie znaczy automatycznie lepszy, ale na granicy zwykle oznacza więcej miejsca na rozumowanie — i, równie ważne, więcej sprzętu, by go uruchomić. Tu wchodzi „mixture-of-experts” (MoE). Zamiast odpalać wszystkie parametry dla każdego słowa, model MoE jest podzielony na wiele wyspecjalizowanych podsieci zwanych ekspertami, a router wybiera dla każdego tokena tylko garstkę. Więc gdy widzisz „2,8 biliona łącznie, 104 miliardy aktywnych”, znaczy to, że model jest ogromny, ale w danej chwili pracuje tylko około 104 miliardy parametrów — jak szpital z tysiącami specjalistów, w którym każdego pacjenta widzi tylko tych kilku właściwych. Suma podpowiada, jak zdolny może być; liczba aktywnych mówi, ile kosztuje jego obsługa. Ta różnica to najbardziej użyteczna pojedyncza liczba do oceny kosztu.
„Okno kontekstu” to ilość tekstu, którą model może naraz utrzymać w głowie, liczona w tokenach — a token to mniej więcej trzy czwarte słowa. Okno miliona tokenów to nie abstrakcyjna specyfikacja: to kilka długich powieści albo dziesiątki godzinnych transkrypcji spotkań w jednym przebiegu. To różnica między streszczeniem jednego e-maila a rozumowaniem nad całym ich kwartałem.
Na koniec licencja — i to jest część, którą praktycy powinni czytać jako pierwszą, przed benchmarkami. Licencja to prawniczy drobny druk mówiący, co wolno ci zrobić z wagami. MIT to złoty standard: używaj, modyfikuj, umieść w produkcie komercyjnym — nic nie jesteś winien. Licencja własna może wyglądać na otwartą, a jednocześnie wykrawać dokładnie to zastosowanie, które miałeś na myśli — na przykład każąc ci płacić, gdy zbudowany na niej biznes urośnie. Dwa modele mogą oba być „otwartymi wagami” i dzielić je przepaść w tym, co wolno ci zrobić zgodnie z prawem. Opłaca się więc przeczytać tę linijkę, zanim zakochasz się w wyniku. Z tymi pięcioma pojęciami w ręku fala czyta się jasno.
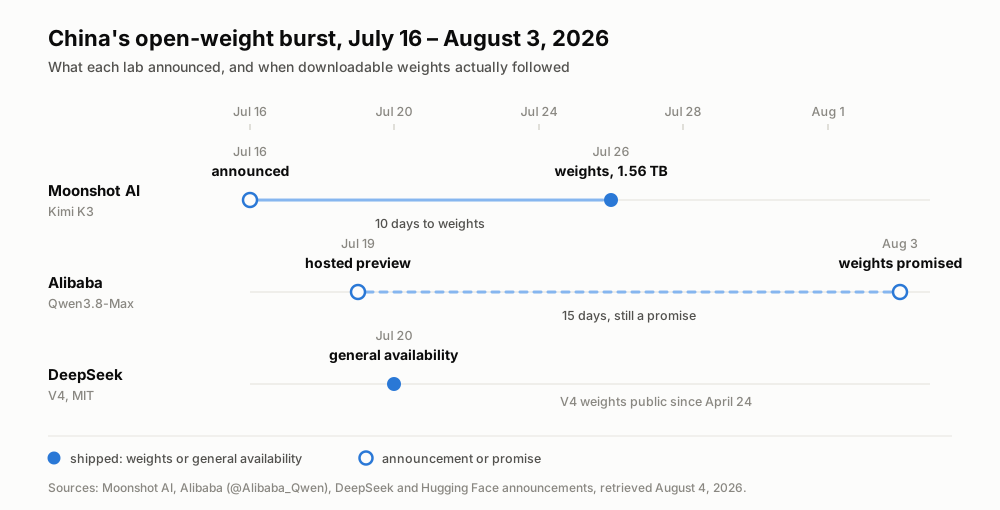
Trzy laboratoria, trzy tygodnie — i tylko dwa z tych pięciu momentów naprawdę oddały wagi w czyjeś ręce. Daty z ogłoszeń samych laboratoriów, sprawdzone 4 sierpnia 2026 r.
To Kimi K3 naprawdę się ukazało
Zacznijmy od Moonshot AI, pekińskiego laboratorium stojącego za asystentem Kimi, które przez ostatni rok budowało reputację na dużych, zdolnych modelach otwartych. Gdy pisaliśmy o Kimi K3 w lipcu, wagi były jedynie obietnicą — Moonshot mówiło „do 27 lipca”. Przyszły 26 lipca: 1,56 terabajta w 96 fragmentach na Hugging Face, pod moonshotai/Kimi-K3. To jest właśnie ta wiadomość. Zapowiedź to komunikat prasowy; wagi do pobrania to fakt, na którym można budować.
Mówiąc wprost, K3 to jeden z największych kiedykolwiek wydanych modeli otwartych — system mixture-of-experts o 2,8 biliona parametrów łącznie i około 104 miliardach aktywnych na token, kierujący około 16 z 896 ekspertów przez mechanizm, który Moonshot nazywa Kimi Delta Attention, z oknem kontekstu o długości miliona tokenów i deklarowanym wzrostem efektywności skalowania o około 2,5x względem poprzednika K2. Zdejmując język specyfikacji: jest bardzo duży, jak na swój rozmiar stosunkowo tani w uruchomieniu, bo na token odpala się tylko wycinek, i zdolny połknąć w całości wejścia długości książki.
Te liczby mówią też, kto naprawdę go uruchomi. 1,56 terabajta w 96 fragmentach to nie pobranie na laptop; to artefakt klasy centrum danych, który samo załadowanie wymaga klastra wysokiej klasy akceleratorów. W praktyce prawie nikt prywatnie nie będzie hostował K3 samodzielnie — sięgnie po niego przez dostawców, którzy już mają sprzęt, a ten rynek pojawił się pierwszego dnia: Together AI i Modal postawiły hostowane endpointy Kimi K3 w chwili, gdy wagi wylądowały. Tak też ciekawy czytelnik wypróbuje go dziś — nie pobierając 1,56 TB, lecz wywołując jeden z tych hostowanych endpointów albo używając aplikacji Kimi. „Otwarty” znaczy tu, że wagi są publiczne i każdy z odpowiednim sprzętem może je serwować, co właśnie utrzymuje konkurencję cenową; nie znaczy, że osobiście uruchomisz go na swoim biurku.
Czy jest dobry? Wedle jedynej niezależnej liczby, której ufamy w tej rundzie, tak. W rankingu Artificial Analysis zajął 4. miejsce na 189 modeli — za Claude Fable 5 i dwiema konfiguracjami GPT-5.6 „Sol”, przed Opus 4.8 i GPT-5.5. Jak na otwarty model, który da się pobrać, samo znalezienie się w takim towarzystwie jest już historią.
Potem przeczytaj licencję, bo to tu „otwarty” dostaje gwiazdkę. Kimi K3 nie jest MIT. Wychodzi na własnej licencji „Kimi K3 License”, niezatwierdzonej przez OSI, z klauzulą progu przychodów: uruchomienie K3 jako silnika dużego biznesu Model-as-a-Service wymaga osobnej umowy z Moonshot. Dla samodzielnego dewelopera czy zwykłej firmy używającej go wewnętrznie nic to nie zmienia. Ale dla każdego, kto buduje hostowany produkt na dużą skalę, „otwarte wagi” i „otwarta licencja” to dwa różne pytania — a tutaj jednoznaczne „tak” dotyczy tylko pierwszego.
Qwen3.8-Max to zapowiedź, nie pobranie
Qwen to rodzina modeli Alibaby, a jej zespół należy do najbardziej płodnych na świecie w wydawaniu modeli otwartych — i właśnie ta historia sprawia, że najnowszy jest mylący. Zaprezentowany 19 lipca na WAIC w Szanghaju, Qwen3.8-Max to największy nagłówek fali i zarazem najmiększy. To rzadki MoE o 2,4 biliona parametrów — liczba aktywnych nieujawniona — i pierwszy Qwen powyżej biliona parametrów, który jest multimodalny, czyli przyjmuje na wejściu nie tylko tekst, lecz także obraz, wideo i dokumenty.
Oto haczyk, który nowicjuszowi trzeba wyłuszczyć: mimo fanfar nie możesz go pobrać. W tej chwili istnieje tylko jako „hostowana zapowiedź” — qwen3.8-max-preview, dostępna przez własną usługę Alibaby (jej Token Plan i narzędzie Qoder) za około 10% ceny standardowej. Hostowana zapowiedź znaczy, że Alibaba uruchamia model na swoich serwerach i pozwala ci go wywoływać; to model wynajętego API, a nie model, którego masz kopię. Nazywanie tego dziś wydaniem otwartych wag jest przedwczesne.
Ten obraz zmienił się 3 sierpnia. Oficjalne konto Qwen na X, @Alibaba_Qwen, opublikowało, że otwarte wagi Qwen3.8-Max pojawią się „w przyszłym tygodniu” — i że mniejszy Qwen3.8-27B również przejdzie na otwarte wagi. Więc 27B to nie plotka, cokolwiek sugerowały wcześniejsze pogłoski: to zobowiązanie na piśmie, złożone przez własne konto Alibaby. I to rozmiar jest sednem. Tam gdzie Max o 2,4 biliona parametrów, jak K3, uruchomi tylko centrum danych, 27B jest na tyle mały, by obsłużyć go na jednej maszynie z wyższej półki — to poziom, który pojedyncza osoba lub mały zespół naprawdę może hostować u siebie. To realnie łagodzi obraz „obiecane bez konkretów”: teraz jest i rozmiar, i przybliżony termin.
Uczciwe zastrzeżenia i tak pozostają w mocy. „W przyszłym tygodniu” to kierunek, nie data wysyłki, a w chwili pisania tych słów, 4 sierpnia, w organizacji Qwen na Hugging Face nic się nie pojawiło — jej najnowsze modele są tam z czerwca. Licencji otwartych wag też nie opublikowano, a pierwsi czytelnicy warunków zapowiedzi zasygnalizowali możliwe ograniczenia regionalne, niepotwierdzone, dopóki nie pojawi się prawdziwa licencja — dokładnie lekcja „najpierw licencja” z elementarza. Twierdzenie Alibaby, że model jest „ustępujący tylko Fable 5”, pozostaje deklaracją własną bez liczb stron trzecich, więc traktuj je jak hasło marketingowe dostawcy, dopóki ktoś spoza Alibaby tego nie zmierzy. Jeśli chcesz wypróbować model dziś, hostowana zapowiedź to jedyne drzwi — ale po raz pierwszy czas oczekiwania na wagi do pobrania mierzy się w „przyszłym tygodniu”, a nie w „kiedyś”.
DeepSeek V4 po cichu osiągnął ogólną dostępność
DeepSeek to laboratorium, którego model R1 pomógł rozpalić obecny wyścig modeli otwartych na początku 2025 roku, i wierne sobie, tu ogłaszało najmniej, dostarczając rzecz najbardziej użyteczną. Jego linia V4, wydana już 24 kwietnia, jest tą, którą najłatwiej przyjąć, bo wychodzi na licencji, którą elementarz wskazał jako złoty standard.
V4 występuje w dwóch rozmiarach, oba na licencji MIT. V4-Pro to flagowiec, 1,6 biliona łącznie i 49 miliardów parametrów aktywnych; V4-Flash to lekki, 284 miliardy łącznie i 13 miliardów aktywnych. Przypomnij sobie, co znaczy liczba aktywnych: V4-Flash odpala tylko 13 miliardów parametrów na token, co czyni go tanim i szybkim w obsłudze, i to właśnie czyni go budżetowym wyborem do pracy o dużym wolumenie — takiego obciążenia „transkrybuj i streszczaj”, w którym koszt na token decyduje o wszystkim. Oba mają okno kontekstu o długości miliona tokenów i mogą wytworzyć do 384K tokenów wyjścia w jednej odpowiedzi, dość, by naszkicować długi raport, a nie tylko akapit. Około 20 lipca V4 osiągnął ogólną dostępność z cennikiem opartym na czasie, co wciągnęło wiosenną premierę w tę samą trzytygodniową ramę co K3 i Qwen.
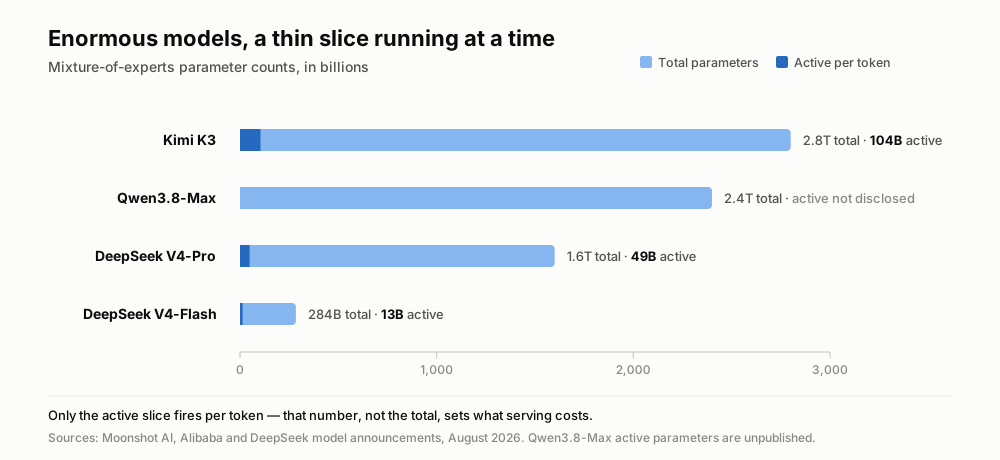
Jasny słupek to wielkość modelu, ciemny kikut to tyle, ile naprawdę włącza się przy każdym tokenie. Alibaba nie podała aktywnych parametrów Qwen3.8-Max.
Ponieważ jest na MIT, V4 to ten, na którym przyjmujący może budować z najmniejszą liczbą prawników: weź wagi (lub użyj hostowanego dostawcy), uruchom, wydaj komercyjnie, nic nie jesteś winien i nikogo nie pytasz. A żeby było jasno co do numerów wersji, bo młyn plotek je uwielbia — nie ma żadnego R2, żadnego V5, żadnego V4.1. Jest tylko rodzina V4 dojrzewająca do czegoś, na czym zespoły mogą polegać.
Dystans kurczy się szybciej, niż przyznają rankingi
Gdy się cofnąć, nachylenie liczy się bardziej niż pojedyncze premiery. Zdaniem Nathana Lamberta odległość między najlepszymi modelami otwartymi a najlepszymi zamkniętymi skurczyła się z około sześciu–dziewięciu miesięcy do trzech–pięciu — „modele otwarte nie były tak blisko granicy od czasu DeepSeek R1”. Mówiąc wprost: modele do darmowego pobrania są teraz tylko kilka miesięcy za najlepszymi modelami, które można wynająć, podczas gdy rok temu były o wygodne okrążenie z tyłu.
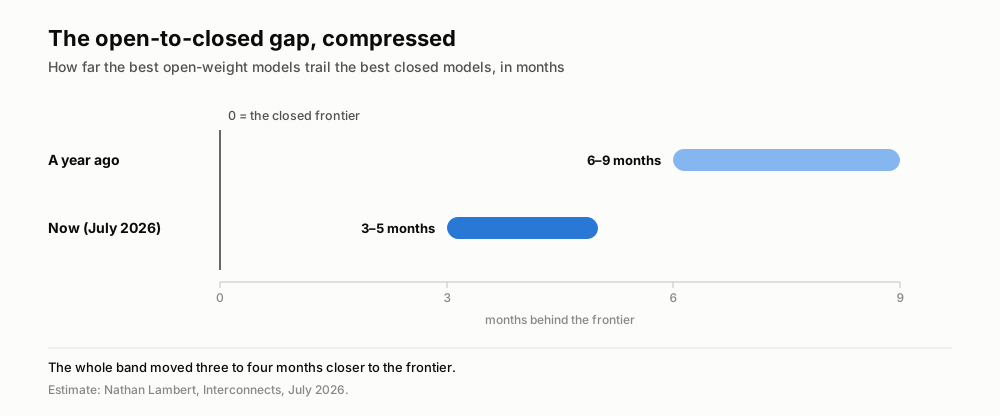
Szacunek Lamberta narysowany w skali: otwarta strona nie tylko się zbliżyła — zwęził się cały przedział.
Dane o użyciu wskazują w tę samą stronę. Na OpenRouter, rynku rozdzielającym zapytania między wiele modeli, udział tokenów modeli pochodzenia amerykańskiego spadł z około 70% w czerwcu 2025 roku do około 30% rok później, podczas gdy modele pochodzenia chińskiego regularnie przekraczają już 30%. W dużej mierze chodzi o cenę: chińskie modele otwarte są zwykle o 60–90% tańsze za token, a hosting pojawił się natychmiast, jak jasno pokazały te endpointy K3 w dniu zerowym.
Cichsza zmiana dotyczy skali. Marka chińskiego modelu otwartego brzmiała: mały, szybki, tani. K3 z 2,8 biliona parametrów i Qwen3.8-Max z 2,4 biliona to dokładne przeciwieństwo — zakład, że iść na dużo w otwartym teraz się opłaca. GLM-5.2 od Z.ai, wydany 16 czerwca na MIT i prowadzący w kategorii otwartych wag Artificial Analysis Index z wynikiem 51, to ten sam przekaz od czwartego laboratorium.
Zwrot: rząd, który to umożliwił, może to ograniczyć
Potem wiatr się odwrócił. Około 22–25 lipca Financial Times i Reuters doniosły, że chińskie Ministerstwo Handlu waży kontrolę eksportu modeli AI — w tym otwartych LLM — a w rozmowach mają brać udział Alibaba, ByteDance i Z.ai. Rozważane ramy są stopniowe: obowiązek zgłoszenia dla modeli słabszych, przegląd bezpieczeństwa dla silniejszych i możliwy zakaz publicznego udostępniania najzdolniejszych. Nic nie jest jeszcze prawem. Ale kierunek jest uderzający: fala osiąga być może swój szczyt dokładnie w chwili, gdy jej własny rząd zaczyna traktować te modele jak strategiczny eksport, a nie otwarty wkład.
Podsumowanie: gdy otwarte staje się aktywem strategicznym
Wygodna narracja mówi „Chiny nadgoniły”. Trafniejsza mówi, że otwarte wagi stały się aktywem strategicznym na tyle szybko, że rząd chce teraz trzymać rękę na kurku. W trzy tygodnie modele otwarte zmniejszyły dystans do granicy z dwóch–trzech kwartałów do jednego — i z małych oraz tanich stały się jednymi z największych modeli, jakie kiedykolwiek opublikowano w jakiejkolwiek formie. Otwarta granica nie tylko się przesunęła. Przesunęła się tam, skąd jej twórcy mogą nie mieć swobody dalszego wysyłania.
Dla zespołów budujących na tych modelach praktyczny wniosek pozostaje ten sam i staje się nieco ostrzejszy. Telli.sh już używa otwartego modelu Qwen3 w warstwie streszczeń, więc każdy zysk w jakości i cenie modeli otwartych płynie prosto do transkrypcji spotkań, tłumaczenia i podsumowań. Nową pozycją jest podaż: jeśli chińskie zasady eksportu przybiorą kształt sugerowany przez doniesienia, to które modele otwarte pozostaną swobodnie pobieralne, jest czymś do obserwowania, a nie zakładania z góry. To, że modele zasilające tę warstwę są coraz lepsze, to trend; skąd tym modelom wolno przybywać — to rzecz, z której nie należy spuszczać oka.
Źródła
- Simon Willison on Kimi K3 weights (July 27, 2026)
- Nathan Lambert, "Kimi K3: the open-weights escalation" (Interconnects, July 20, 2026)
- Kimi K3 announcement (Moonshot AI)
- Kimi K3 weights on Hugging Face
- Artificial Analysis on Kimi K3
- Qwen (@Alibaba_Qwen), Qwen3.8-Max & Qwen3.8-27B open-weights announcement on X (Aug 3, 2026)
- Latent Space / AINews, "Qwen 3.8 Max (2.4T) and 27B, new open weights models" (Aug 4, 2026)
- WinBuzzer on DeepSeek V4 (April 27, 2026)
- The Decoder on Chinese open-model adoption
- Tom's Hardware on China's proposed AI export controls (July 2026)
- Wikimedia Commons image page
