Qwen3.8-27B open weights: rozmiary, Q4_K_M i realne prędkości na 4090 i Macu
Qwen3.8-27B jest na licencji Apache 2.0. GGUF Q4_K_M waży 17,1 GB i mieści się w laptopie z 32 GB RAM; FP8 to 30,9 GB. Zmierzono: 48 tokenów/s na RTX 4090 i 12,75 na Mac mini M4 Pro.
3 sierpnia konto Qwen należące do Alibaby napisało, że otwarte wagi pojawią się „w przyszłym tygodniu”. To dokładnie ten rodzaj zdania, które branża AI nauczyła wszystkich czytać z dyskontem. Dwanaście dni później nie ma już czego dyskontować: wagi Qwen3.8-Max, modelu z 2,4 biliona parametrów, pojawiły się na Hugging Face 12 sierpnia, a mniejszy model — Qwen3.8-27B, na zwykłej licencji Apache 2.0 — dołączył 14 sierpnia.
Potem zaczęła się ciekawa część. Jeszcze w tej samej godzinie, w której Qwen kończył publikować kartę modelu 27B, trzy różne grupy społecznościowe zdążyły już przekonwertować go do formatów uruchamialnych na zwykłym komputerze osobistym. Dwa dni później te konwersje przekroczyły milion pobrań.
To ta liczba jest tu newsem, nie tabela benchmarków. Model z 27 miliardami parametrów z jednego z czołowych laboratoriów AI świata przeszedł od „zapowiedziany” do „działa na jakimś milionie biurek” w około 48 godzin. Ten tekst przystępnie wyjaśnia, co to naprawdę znaczy: co się ukazało i na jakiej licencji, czego trzeba, by uruchomić 27B na sprzęcie, który już masz, jak daleko zaszło to w trzy lata i to, co większość relacji pomija — czego lokalny 27B wciąż nie potrafi.
W skrócie:
- Obietnica została dotrzymana. Qwen3.8-Max (2,4 bln łącznie / 95 mld aktywnych) wyszedł 12 sierpnia, Qwen3.8-27B — 14 sierpnia. Oba to prawdziwe pliki do pobrania, a nie hostowane zapowiedzi.
- Licencje się różnią, a ta różnica waży więcej niż punktacje. 27B jest na Apache 2.0: bez progów, bez klauzul, użycie komercyjne za darmo i bez zobowiązań. Qwen3.8-Max wychodzi na własnej licencji z progiem przychodu dla biznesów typu model jako usługa.
- O tym, kto co uruchomi, decyduje rozmiar: Max to 4892 GB do pobrania; 27B skompresowany do 4 bitów waży 17,1 GB i mieści się na maszynie z 32 GB pamięci. Społecznościowe wersje 4-bitowe przekroczyły 1,07 miliona pobrań w dwa dni.
Zdjęcie: Dejan Krsmanovic, Wikimedia Commons, CC BY 2.0. Uruchamianie modelu czołowego laboratorium na własną rękę oznacza, że maszyna — i jej utrzymanie — stają się twoje.
Obietnica miała datę i data się obroniła
4 sierpnia opisywaliśmy samą zapowiedź i napisaliśmy, że czekanie mierzy się „przyszłym tygodniem”, a nie „kiedyś”. Dalej ówczesne dowody nie sięgały. Sprawa rozstrzygnęła się czysto.
Qwen3.8-2.4T-A95B — sprzedawany jako Qwen3.8-Max — pojawił się wraz z plikiem licencji 12 sierpnia. Qwen3.8-27B i zoptymalizowany wariant FP8 przyszły 14 sierpnia. Obie daty mieszczą się w oknie, na które wskazywał „przyszły tydzień”. W branży, w której zapowiedziane modele regularnie nigdy nie wychodzą, dotrzymanie przez laboratorium ustnego terminu sprzed dziewięciu dni samo w sobie zasługuje na odnotowanie.
Odbiór był natychmiastowy i szeroki. Wątek na Hacker News o 27B zebrał w jeden dzień 1351 punktów i 769 komentarzy. W ciągu godzin praktycy publikowali działające konfiguracje uruchomieniowe pod konkretny sprzęt; ktoś udostępnił ustawienia zarówno dla NVIDIA DGX Spark, jak i dla konsumenckiej karty graficznej RTX 4090. Dwa lata temu branża traktowała otwarte premiery inaczej — wtedy samo zmuszenie nowej architektury do działania było projektem na weekend.
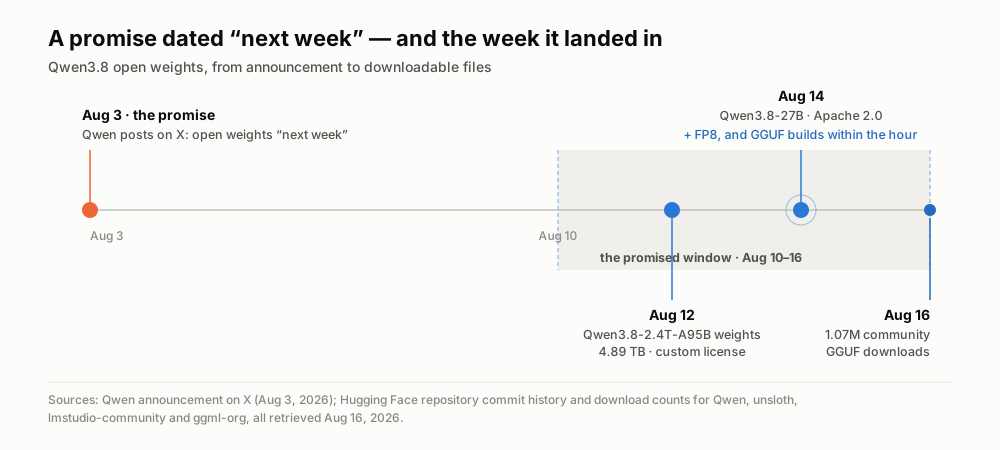
Obietnica z datą i dwie dostawy, które w nią trafiły. Daty z historii commitów repozytoriów Hugging Face, pobrano 16 sierpnia 2026 r.
Pięć pojęć, ustawionych pod pytanie „czy zdołam to uruchomić?”
Jeśli trafiłeś tu z naszych wcześniejszych tekstów, wiesz już, czym są otwarte wagi: laboratorium publikuje wielką siatkę wyuczonych liczb, z której składa się gotowy model, a ty możesz ją pobrać, uruchomić na własnym sprzęcie i budować na niej bez płacenia za każde zapytanie. Tu zajmuje nas pytanie następne, całkowicie praktyczne: ile uruchomienie kosztuje w sprzęcie?
Parametry to właśnie te wyuczone liczby, a ich liczba wyznacza surowy rozmiar modelu. Reguła kciuka jest brutalnie prosta: przy precyzji, w jakiej trenują laboratoria, każdy miliard parametrów to około 2 GB na dysku, i mniej więcej tyle pamięci potrzeba, by utrzymać model w trakcie pracy. Model z 27 miliardami parametrów to zatem 55 GB do pobrania. Model z 2,4 biliona to prawie 5 terabajtów. Dlatego jeden jest pytaniem o laptopa, a drugi o centrum danych.
Kwantyzacja domyka tę lukę i jest najużyteczniejszym pojęciem dla każdego, kto chce uruchamiać modele w domu. Parametry zapisuje się zwykle z precyzją 16 bitów. Kwantyzacja zaokrągla je do mniejszej liczby bitów — 8, 4, czasem 2 — a plik kurczy się mniej więcej w tej samej proporcji. Kwantyzacja czterobitowa zamienia te 55 GB w około 17 GB. Tracisz trochę dokładności, a zyskujesz możliwość uruchomienia całości. GGUF to po prostu format pliku, w którym te skompresowane wersje krążą; czytają go narzędzia takie jak llama.cpp, Ollama i LM Studio. Gdy widzisz „Q4_K_M”, czytaj to jako „czterobitowa wersja, z której korzysta większość”.
Model gęsty a mieszanka ekspertów decyduje o szybkości, gdy model już się zmieści. Qwen3.8-27B jest gęsty: przy każdym generowanym słowie odpalają wszystkie 27 miliardów parametrów. Qwen3.8-Max to model z mieszanką ekspertów — 2,4 biliona parametrów łącznie, ale router wybiera tylko około 95 miliardów na token spośród 512 wyspecjalizowanych podsieci. Liczba całkowita mówi o rachunku za przechowywanie; liczba aktywna — o rachunku za obliczenia. To rozróżnienie ma ostre praktyczne ostrze, do którego wrócimy.
Okno kontekstu to ilość, jaką model potrafi rozważyć naraz. 27B obsługuje natywnie 262 144 tokeny — stos godzinnych transkrypcji ze spotkań — i daje się rozciągnąć do miliona zmianą konfiguracji.
Licencję czyta się jako pierwszą
Oto ustalenie, które niesie resztę, i przeczy ono założeniu, że rodzina modeli dzieli rodzinę warunków.
Qwen3.8-27B jest na Apache 2.0. To najbardziej liberalny kraniec skali: używaj, zmieniaj, dostrajaj, wkładaj do produktu komercyjnego, buduj na tym firmę — nic nie jesteś winien i nikogo nie musisz pytać. Żadnych progów przychodowych, żadnego obowiązku pokazywania nazwy w interfejsie, żadnych wyłączeń zastosowań.
Qwen3.8-Max — nie. Wychodzi na własnej „Qwen3.8-Max License”, która zaczyna się jak MIT, a potem dokłada dwa warunki. Jeśli twój produkt przekroczy 100 milionów aktywnych użytkowników miesięcznie albo 20 milionów dolarów miesięcznego przychodu, musisz pokazywać nazwę modelu w interfejsie. A jeśli prowadzisz biznes typu model jako usługa albo asystent pracy z AI, którego przychód przekracza 50 milionów dolarów w dowolnych dwunastu kolejnych miesiącach, przed jakimkolwiek użyciem komercyjnym potrzebujesz osobnej umowy z Qwen.
Dla samodzielnego programisty albo firmy używającej modelu wewnętrznie nic z tego nie gryzie. Ale to ta sama gwiazdka, którą zaznaczyliśmy, gdy Kimi K3 wyszedł na własnej licencji zamiast MIT, i lekcja się powtarza: „otwarte wagi” i „otwarta licencja” to dwa osobne pytania, a laboratorium może odpowiedzieć na nie inaczej dla dwóch modeli wydanych w odstępie dwóch dni. Przeczytaj licencję, zanim zakochasz się w wyniku.
| Model | Parametry łącznie | Aktywne na token | Rozmiar pobrania | Licencja | Realne środowisko |
|---|---|---|---|---|---|
| Qwen3.8-Max (2.4T-A95B) | 2,4 bln | 95 mld | 4892 GB | Własna, próg przychodu | Klaster akceleratorów |
| Qwen3.8-Max, FP8 | 2,4 bln | 95 mld | 2496 GB | Własna, próg przychodu | Klaster akceleratorów |
| Qwen3.8-27B | 27 mld, gęsty | 27 mld | 55,6 GB | Apache 2.0 | Stacja robocza z kilkoma GPU |
| Qwen3.8-27B, FP8 | 27 mld, gęsty | 27 mld | 30,9 GB | Apache 2.0 | Jedna karta z górnej półki |
| Qwen3.8-27B, Q4_K_M GGUF | 27 mld, gęsty | 27 mld | 17,1 GB | Apache 2.0 | Laptop z 32 GB albo 4090 |
Czego naprawdę trzeba, by uruchomić 27B
Uczciwa odpowiedź: mniej, niż się wydaje, i więcej, niż sugerują nagłówki.
Najniższy szczebel to jedno polecenie. 27B jest w bibliotece Ollamy; ollama run qwen3.8 pobiera wersję 18 GB z oknem kontekstu 256K i wejściem obrazu, a wariantów jest dwanaście, w tym jeden dostrojony pod układy Apple. LM Studio, które daje okno czatu zamiast terminala, miało swoją wersję online kilka minut po premierze. Żadne z nich nie wymaga, byś zrozumiał poprzedni rozdział.
Potem wkracza rzeczywistość w postaci tokenów na sekundę. Pomiary, które praktycy publikowali w wątku premierowym, wypadły mniej więcej tam, gdzie każe sprzęt. Na RTX 4090 z wersją czterobitową ktoś zmierzył około 48 tokenów na sekundę — wygodnie szybciej, niż czytasz. Na Mac mini M4 Pro z 64 GB pamięci inny uzyskał 12,75 tokena na sekundę: da się używać, ale patrzysz, jak pisze. A na laptopie z AMD 7840U i zwykłymi 64 GB DDR5 ta sama wersja czterobitowa dała około 4 tokenów na sekundę — technicznie działa, praktycznie jest to zadanie wsadowe, które odpalasz i odchodzisz.
Ta ostatnia liczba pokazuje, po co jest rozróżnienie gęsty kontra eksperci. Ta sama osoba zmierzyła na tym samym laptopie starszy model z mieszanką ekspertów, nominalnie większy, na około 20 tokenów na sekundę — pięć razy szybciej niż mniejszy model gęsty, bo na każde słowo odpala tylko ułamek parametrów. Jeśli szukasz czegoś do uruchomienia na procesorze, kupuj po parametrach aktywnych, a nie całkowitych. To najmniej intuicyjna i najbardziej użyteczna lekcja lokalnej AI.
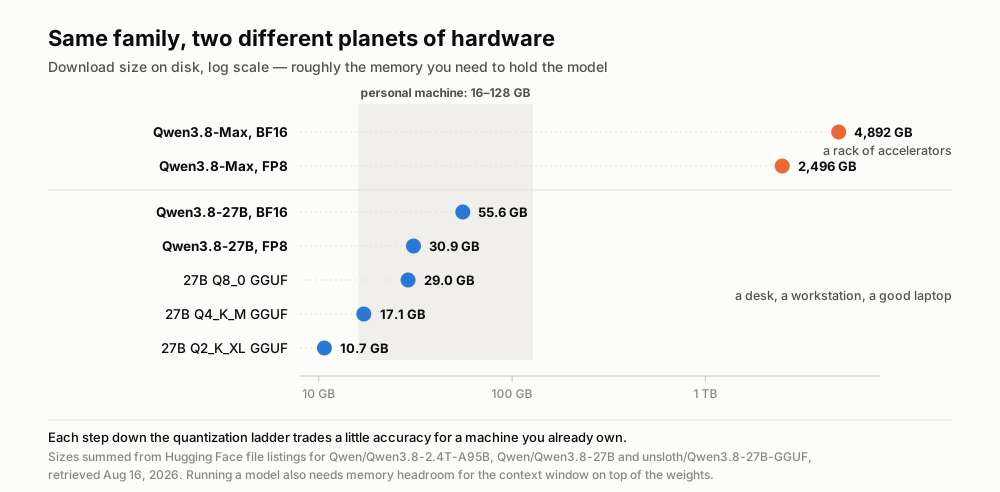
Dwaj członkowie tej samej rodziny modeli, dzieli ich 290-krotność rozmiaru pobrania. Rozmiary zsumowane z list plików Hugging Face, pobrano 16 sierpnia 2026 r.
Trzy lata temu trzeba było przecieku i weekendu
Żeby zobaczyć skalę skoku, zestaw go z punktem wyjścia modeli lokalnych.
W lutym 2023 roku Meta udostępniła wagi pierwotnej LLaMA wyłącznie zatwierdzonym badaczom. Wyciekły w mniej więcej tydzień, a cała amatorska scena modeli lokalnych powstała na pliku, którego nikt nie miał prawa mieć. 10 marca 2023 roku pewien programista opublikował llama.cpp — mały program w C++, którego popisowym numerem było uruchomienie modelu z 7 miliardami parametrów na MacBooku. To repozytorium ma dziś 124 tysiące gwiazdek i jest przodkiem praktycznie każdego dzisiejszego narzędzia do „uruchamiania lokalnie”.
Porównaj te dwa dni premiery. 2023: wyciekły 7B, licencji właściwie brak, tydzień pracy społeczności, by to uruchomić, i model raczej ciekawy niż użyteczny. 2026: 27B z czołowego laboratorium, opublikowany świadomie na Apache 2.0, z wejściem obrazu i wideo, oknem kontekstu 262K, a wersje społecznościowe były gotowe, zanim dokumentacja samego laboratorium przestała się zmieniać. Pierwszy commit konwersji unsloth przypadł na 14:56 UTC 14 sierpnia — cztery minuty przed ostatnią aktualizacją karty modelu przez Qwen.
Liczby adopcji mówią to samo dosadniej. Na 16 sierpnia społecznościowe wersje czterobitowe 27B miały 867 963 pobrania u jednego wydawcy, 171 518 u drugiego i 34 520 u trzeciego: 1,07 miliona w dwa dni. Oficjalne repozytoria 27B samego Qwena dokładają kolejne 215 tysięcy. Qwen3.8-Max, model o wiele sprawniejszy, stoi na 17 126 w obu swoich repozytoriach.
Przeczytaj tę proporcję jeszcze raz. Model w skali frontier dostał około 1,6 procent uwagi, która przypadła temu w skali laptopa. Rynek nie poszedł po możliwości. Poszedł po zasięg.
Czego lokalny 27B wciąż nie potrafi
Teraz korekta, bo entuzjazm wyprzedza dowody w przewidywalny sposób.
Własna tabela Alibaby stawia 27B przed Opus 4.6 Max w kilku miarach agentowego programowania i posłuszeństwa instrukcjom — 61,7 do 53,4 w SWE-bench Pro, 79,5 do 62,5 w IFBench — a za nim w innych, w tym 30,8 do 40,0 w HLE, które bada szeroką wiedzę. Każda z tych liczb pochodzi od samego producenta. W chwili pisania Artificial Analysis, niezależny ewaluator, na którym się opieramy, w ogóle nie ma wpisu dla 27B; plasuje za to Qwen3.8-Max na 10. miejscu wśród 188 modeli z wynikiem inteligencji 58 — świetnie, i to inny model.
Praktycy byli ostrzejsi niż arkusz. Najwyżej oceniony sprzeciw w wątku, od osoby przedstawiającej się jako długoletni użytkownik modeli otwartych, był bezpośredni: w prawdziwej pracy nie pokonują najlepszych modeli hostowanych; są „wystarczająco dobre” do mnóstwa zadań i działają na przystępnym sprzęcie — to twierdzenie inne i skromniejsze. Inny komentarz ujął pułap fizycznie: nie da się skompresować całej ludzkiej wiedzy do pliku 30 GB, więc małe modele pozostają względnie słabe w przypominaniu mało znanych faktów, choćby nie wiem jak wyostrzyły się w kodzie czy obsłudze narzędzi.
Dwa dalsze ograniczenia widać dopiero w użyciu. Kwantyzacja nie jest darmowa: mocno skompresowany model łatwiej gubi wątek przy długim kontekście i potrafi wpaść w pętle powtórzeń — dlatego każdemu, kto ma zapas pamięci, doradza się pełną precyzję. A ta generacja Qwena domyślnie myśli długo: użytkownik podał 27B na Mac mini z 64 GB dwa słowa „svg owl” i patrzył, jak przez 17 minut i 12 sekund generuje 21 769 tokenów rozumowania, zanim odpowiedział. Sowa wyszła dobra. Wyszedł też rachunek w czasie zegarowym, którego nie wystawiłoby żadne hostowane API.
I jest jeszcze pozycja, której nikt nie liczy: utrzymanie należy teraz do ciebie. Aktualizacje modelu, wybór kwantyzacji, zapas pamięci, wersje sterowników, wentylator w obudowie. To hostowane API, którego unikałeś, było też zespołem ludzi utrzymujących coś w ruchu.
Wniosek: fosa przesunęła się w dół stosu
Oto sedno, i jest większe niż jedna premiera.
Czołowe laboratorium opublikowało sprawny model 27B w czwartek. W sobotę ponad milion kopii wersji skompresowanych przez społeczność było na maszynach ludzi, w Ollamie dzieliło go od nich jedno polecenie, a budowanie na nim biznesu było prawnie wolne. Jakąkolwiek przewagę ten model reprezentuje, stała się ona dostępna wszystkim konkurentom naraz w jakieś dwa dni. Nazwijmy to dwudniową fosą: przewaga modelu ma dziś okres półtrwania około 48 godzin.
To nie prognoza. To pomiar, zrobiony w tym tygodniu, na tej premierze.
I redefiniuje on, co znaczy budować produkt AI. Kiedy warstwa modelu jest towarem, który każdy wymienia w jedno popołudnie, model przestaje być tym, o co się konkuruje. Przeżywa wszystko, co go otacza: niezawodność, gdy serwer inferencji przewraca się o trzeciej nad ranem; potoki danych, które przechwytują, czyszczą i odnajdują właściwy kontekst; ewaluacja, która mówi, czy działa na twoich danych, a nie na danych benchmarku; interfejs, którego ktoś naprawdę użyje; oraz ustalenia zaufania — prywatność, retencja, kto co widzi — od których zależy, czy ktokolwiek w ogóle powierzy ci swoje nagrania ze spotkań.
Żadna z tych rzeczy nie staje się towarem w dwa dni. Żadna nie ma przycisku pobierania.
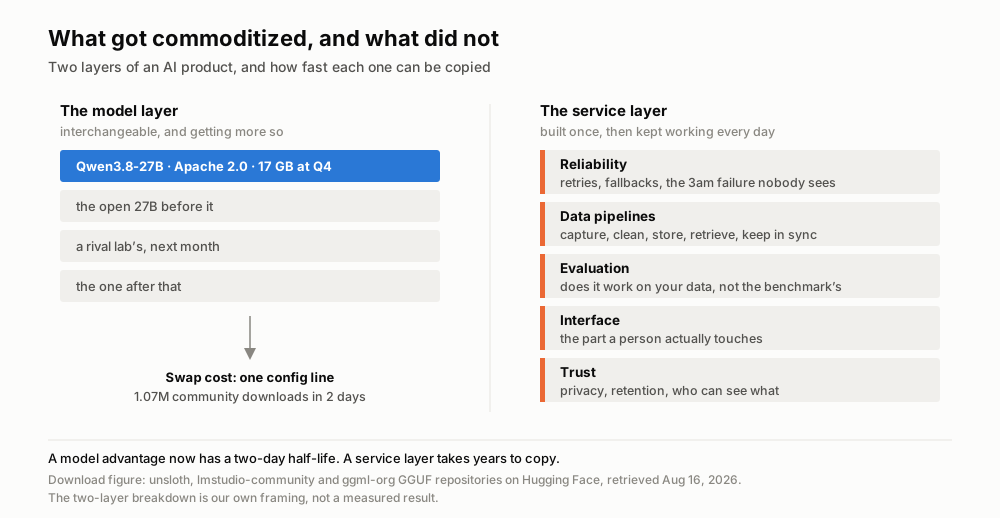
Warstwa, która w tym tygodniu staniała, i ta, która nie. Liczby pobrań z Hugging Face, pobrano 16 sierpnia 2026 r.; podział na dwie warstwy to nasze ujęcie.
Właściwą reakcją na to, że świetny otwarty model trafia na laptopy, nie jest więc ani „firmy od modeli wygrały”, ani „firmy produktowe przegrały”. Jest nią to, że ciekawa praca zeszła piętro niżej w stosie — tam, gdzie znacznie trudniej ją skopiować i znacznie mniej się z niej wyciska nagłówków.
Gdzie w tym jest Telli.sh: budujemy dokładnie tę warstwę usługi, na otwartych modelach. Telli.sh już korzysta z otwartego modelu Qwen w ścieżce streszczania, co znaczy, że każdy skok jakości modeli otwartych — ten również — trafia prosto w transkrypcję, tłumaczenie i podsumowania spotkań, bez zmiany ceny po twojej stronie. Nasz czas idzie w tę część, która nie przyjeżdża w pliku GGUF: rzetelnie przechwycić dźwięk, nie pomylić mówiących, zamienić 60-minutowe nagranie w notatki, które odnajdziesz po miesiącach, i jasno powiedzieć, gdzie mieszkają twoje dane.
Źródła
- Karta modelu i licencja Qwen3.8-27B, Hugging Face
- Karta modelu i licencja Qwen3.8-2.4T-A95B, Hugging Face
- unsloth/Qwen3.8-27B-GGUF: wersje skwantyzowane i liczniki pobrań
- Qwen3.8 w bibliotece modeli Ollamy
- Dyskusja na Hacker News o premierze Qwen3.8-27B (14 sierpnia 2026)
- Strona modelu Qwen3.8 Max w Artificial Analysis
- Ogłoszenie otwartych wag przez Qwen (@Alibaba_Qwen) na X (3 sierpnia 2026)
- Repozytorium llama.cpp, utworzone 10 marca 2023
- Strona zdjęcia w Wikimedia Commons
