一个匿名模型四天烧掉26万亿tokens。价目表姗姗来迟:混合价24美分
2026年8月20日,一个没有厂商、没有模型卡、没有价格的模型以 stealth/ox-alpha 的名字出现在 OpenRouter 上。四天后,OpenCode 用户已经在它身上跑掉了26万亿 tokens。六天后,Z.AI 认领了它:GLM-5.3-Flash,总参数320B,MIT 许可证,输入每百万 tokens 0.15 美元。为什么实验室开始不署名发布模型,那些流量数字究竟测量了什么,以及混合价24美分对语音处理管线的经济性意味着什么。
2026年8月20日,一个模型以 stealth/ox-alpha 的标识出现在 OpenRouter 上。没有署名的实验室。没有模型卡,没有基准测试表,没有发布贴。价格栏写着输入0美元、输出0美元。它有的是一个1,048,576 tokens 的上下文窗口,支持文本、图像和视频输入,以及一行关于长周期软件工程的描述。
四天后,OpenCode 说它的用户已经在这个模型上跑了26万亿 tokens。
六天后,Z.AI 向彭博社确认这是自家的模型,以 MIT 许可证放出权重,并附上了价目表:输入每百万 tokens 15美分,输出每百万 tokens 50美分。名字是 GLM-5.3-Flash。这句话里的"Flash"两个字承担了极重的分量,而这正是我们写这篇文章的原因。
这是一篇评论,不是发布报道。下面要讲的是:附带必要注解的六天时间线;关于实验室为何越来越倾向于不署名发布模型的论证;身份揭晓后的规格与第三方评测分数;我们无法核实的说法的明确清单;以及混合价24美分对语音处理成本意味着什么的一次算术。它是我们那篇关于本地模型反攻的前后对比的直接续篇,结论方向也一致:称职的机器智能价格仍在下降,而且比多数产品路线图假设的更快。
要点:
- 流量是真实的,而且破了纪录。 四天内 OpenCode 上26万亿 tokens,覆盖327,000名独立用户;OpenRouter 上三天11.6万亿 tokens,是该平台史上最大的一次模型上线,此前最高纪录为4.4万亿。
- 身份已由一手信源确认。 Z.AI 于2026年8月26日向彭博社确认 Ox Alpha 是 GLM 系列模型;OpenRouter 自己的页面现在写着该隐身模型"由 ZAI 开发和运营,已披露为 ZAI GLM-5.3-Flash"。
- 重点在价格。 总参数320B / 激活18B,MIT 许可证,每百万 tokens 输入0.15美元、输出0.50美元,混合价0.24美元。而半年前那个在 Artificial Analysis 智能指数上比它低 12.1 分的闭源旗舰,混合价是10.00美元。
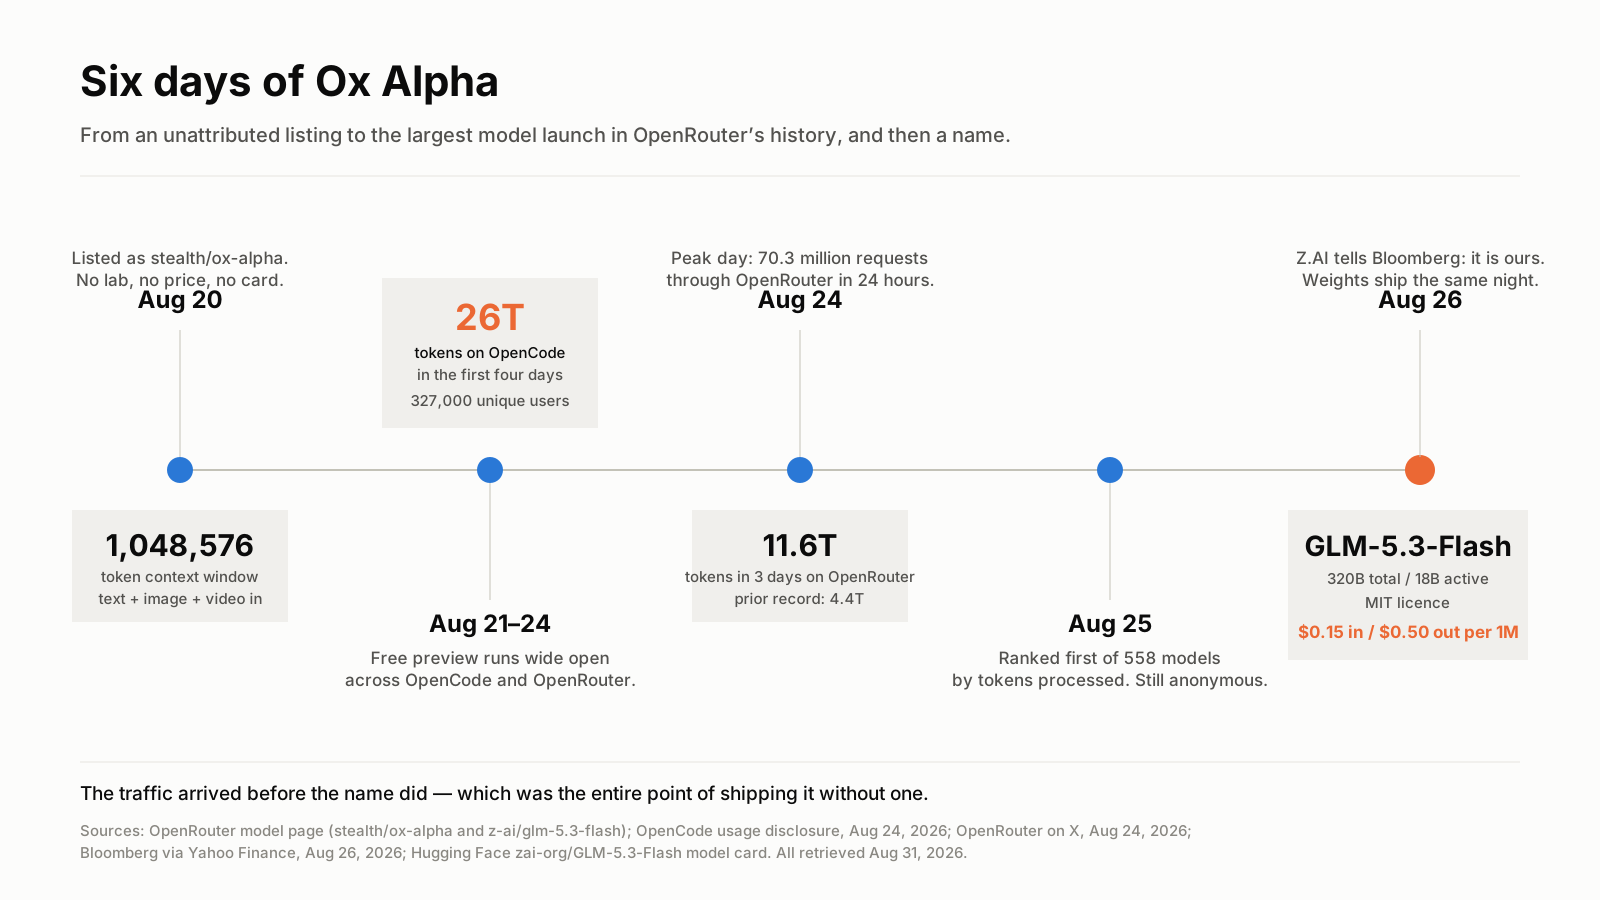
整件事从头到尾不到一周。出处见文末。
六天里发生的事,按顺序
8月20日。上线 OpenRouter 的同时,也出现在 Dax Raad 开发的开源终端编码智能体 OpenCode 里。OpenCode 将其标注为免费、实际上不限量、通过自家线路不保留数据,并称已经拿到每天最高100万亿 tokens 的服务容量。
8月21日到24日。用量每天都在涨。按 OpenRouter 的模型活动接口记录:8月21日2,700万次请求,8月22日5,440万次(环比增长101.2%),8月23日6,390万次,8月24日7,030万次。
8月24日。OpenCode 公布数字。前四天处理26万亿 tokens,覆盖327,000名独立用户和8,328,244个已完成会话,平均每个会话320万 tokens,每名用户约25个会话。这让 Ox Alpha 在 OpenCode 追踪的模型中排到第二,前面是33万亿 tokens 的 DeepSeek V4 Flash,后面是12万亿 tokens 的小米 MiMo-V2.5。OpenRouter 另行披露,该模型在头三个完整日内产生了11.6万亿 tokens,称其为平台史上最大的模型上线;同期此前的纪录保持者是4.4万亿。
8月25日。在按过去一周处理 tokens 排序的 OpenRouter 模型 API 中,Ox Alpha 在返回的558个模型里排第一。此时实验室之外仍然没人知道是谁做的。
8月26日。Z.AI 向彭博社确认 Ox Alpha 是其 GLM 系列的新模型。权重当晚放出。该公司自己的发布文章写道,为了收集用户反馈,他们把 GLM-5.3-Flash 以 ox-alpha 的名义在 OpenCode 和 OpenRouter 上做了匿名测试。OpenRouter 的隐身模型页面也被改为该模型"由 ZAI 开发和运营,已披露为 ZAI GLM-5.3-Flash"。
流量数字是真的,但它不是质量判决
大多数报道在这里翻了车,所以我们把26万亿 tokens 到底测量了什么说清楚。
它测量的是一个免费端点的吞吐量,这个端点带百万级窗口,消耗它的主要是编码智能体。OpenCode 自己的仪表盘显示,93% 的输入 tokens 来自缓存 —— 也就是同一份仓库上下文在长会话里被反复重读。任何按处理 tokens 排序的榜单,都会给免费且窗口巨大的模型带来巨大的机械性优势,因为智能体框架会反复重新灌入上下文、重试失败的工具调用、把工具输出再塞回提示词。会话越长,这个数字在设计上就越膨胀。
每天100万亿 tokens 这个数字也需要同样的处理。那是 OpenCode 描述的总服务容量,不是已交付的用量,也不是每个用户的额度。实际用量在头四天平均约为每天6.5万亿 tokens,是公布上限的6.5%。分析师 Teortaxes 指出,若按每秒80 tokens 计算,一天生成100万亿输出 tokens 大约需要相当于580,000块 GPU 的算力——这恰恰是那种在转述之前应该先问清楚"到底在数什么"的数字。
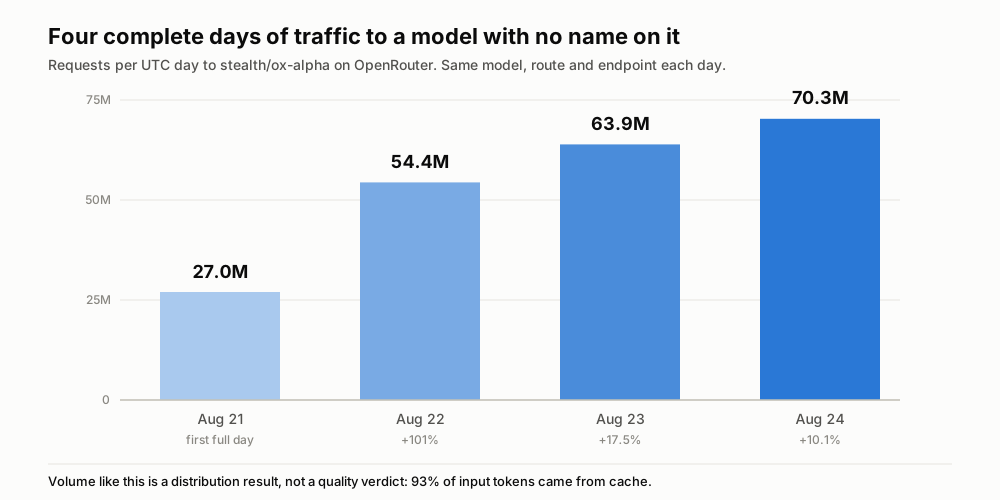
来自 OpenRouter 模型活动接口的日请求数,快照缓存于2026年8月25日。平台可能会修订这些数值。
那么这些流量究竟证明了什么?证明了:把一个带百万窗口的免费前沿级模型,投放到编码智能体本来就聚集的两个地方,需求会在24小时内饱和。这是一个分发结果,而分发结果本身值得研究。但它完全没有告诉你这个模型在你的仓库上表现如何。
实验室为什么开始不署名发布模型
观点要转弯了,我们把这个转折标出来:以上是测量,以下是我们的解读。
匿名发布给实验室买到了三样别处买不到的东西。我们把这个组合叫做 匿名红利。
第一样是干净的评估。每一次署名发布都降落在既有成见里。来自中国实验室的模型会被按"开源模型里算不错了"来打分;来自美国前沿实验室的模型会被按"这次涨价值不值"来打分。把名字摘掉,开发者能反应的就只剩输出本身。隐身那一周返回的所有评测,都出自完全不知道自己在夸谁家模型的人之手——这是 AI 营销里最昂贵的东西,却可以靠"什么都不说"最便宜地拿到。
第二样是飞轮。神秘本身就是营销活动。没人会为一次例行版本更新写一篇取证式的博客长文,但一整周的分词器指纹比对、服务层分析和猜测,产生了实验室不必花钱购买的巨量报道。而身份揭晓落在一群已经投入到答案里的读者身上。Z.AI 拿到了一周的免费关注,然后迎来了一个自带包袱的发布日。
第三样是钱不容易买到的规模化遥测。830万个真实、杂乱、贴近生产的已完成智能体会话,本身就是一个数据集。Ox Alpha 的 OpenRouter 页面写明提示词和补全由提供方保留但不用于训练——这一点我们马上会展开——但仅仅是保留,也能得到跨数十万个真实仓库的失败模式、延迟分布、工具调用错误率和长上下文衰减曲线。这些是内部评测集给不了的。
那行数据条款值得单独一说,因为它是这个故事里唯一真正反常的地方。OpenRouter 自2025年4月以来运营的十四个隐身模型条目中,有十三个写的是某种版本的"提示词和补全由提供方记录,可能被用于改进模型"。只有 Ox Alpha 写的是:保留,但不用于训练。你觉得这条是否让人安心,取决于你给一个路由平台模型页面上的一行字多少分量。至少,这是一个刻意的选择,而且是隐身条目里的头一回。
代号已经成了一种体裁
这不是新招数。这是一个有五次一手确认记录的模式,而了解这份履历,才是校准下一次的前提。
| 代号 | 实际身份 | 确认方 | 日期 | 证据等级 |
|---|---|---|---|---|
| Quasar Alpha | GPT-4.1,OpenAI 发布前快照 | OpenRouter 自家博客 | 2025-04-14 | 一手 |
| Optimus Alpha | GPT-4.1,更接近最终版的快照 | OpenRouter 自家博客 | 2025-04-14 | 一手 |
| Horizon Alpha / Horizon Beta | 早期 GPT-5 检查点 | OpenRouter "GPT-5 is now live" | 2025-08-07 | 一手 |
| Sonoma Dusk Alpha / Sonoma Sky Alpha | xAI Grok 4 Fast,非推理版与推理版 | 仅社区推断 | — | 有报道,未确认 |
| Hunter Alpha / Healer Alpha | 小米 MiMo | 小米 MiMo 团队 | 2026-03-18 | 一手 |
| Owl Alpha | 美团 LongCat-2.0-Preview | 美团博客与 @Meituan_LongCat | 2026-06-30 | 一手 |
| Cypher Alpha / Aurora Alpha | 始终未被揭晓 | — | — | 无 |
| Ox Alpha | Z.AI GLM-5.3-Flash | Z.AI 向彭博社确认,OpenRouter 页面已修订 | 2026-08-26 | 一手 |
这张表里有两点值得注意。十三个历史条目中有七个最终得到了一手信源的确认,这个揭晓率比流传的说法要好得多——而且其中三次确认来自实验室而非 OpenRouter,这正是那些只盯着 OpenRouter 博客的汇总一直漏算的原因。另一点是,这个体裁的舞台搬家了。2025年的行是 OpenAI 和 xAI。2026年的行是小米、美团和 Z.AI。中国实验室没有发明隐身发布,但把它工业化的是他们。
揭晓的规格:总参数320B、激活18B、MIT
现在说规格,直接引自 Z.AI 自己的模型卡,而不是任何人的转述。
GLM-5.3-Flash 被作者描述为"GLM-5 系列中第一个原生多模态模型",采用混合专家架构,总参数3,200亿、激活参数180亿,在30万亿 tokens 的多模态语料上训练。架构上首次在该系列中把稀疏注意力和线性注意力结合起来,并采用论文称为 Manifold-Constrained Hyper-Connections 的技术。上下文窗口为1,048,576 tokens,单次响应最长131,072 tokens。推理深度通过 reasoning_effort 参数暴露,有 low、high、max 三档,默认 max。许可证是 MIT——不是带用户数触发条款的定制社区许可证,就是 MIT。
Z.AI 自己的能力表述值得原样引用,因为它比围绕它的报道克制得多:该模型"以十分之一的价格在基准测试和真实工作负载上全面超越 GLM-5.2,并在编码和智能体基准上接近 Claude Opus 4.8"。是接近,不是超越。
第三方读数方面,Artificial Analysis 已经跑完了测评。GLM-5.3-Flash 在 Artificial Analysis 智能指数上得57分,而同类开源权重模型的中位数是29分。 跑完整套测评的 API 开销是138.02美元——我们引用这个数字,是因为它是全文中关于"用上接近前沿的智能到底要花多少钱"最诚实的单一数据点。同一份测评也点出了两个真实的弱点:每秒45个输出 tokens 的速度偏慢;完成整个指数生成了1.5亿 tokens,而中位数是1.1亿,也就是偏啰嗦。哪怕单 token 价格很低,啰嗦也是账单。
真正的新闻是:一个 Flash 档的模型拿到了57分
按 Epoch AI 做价格比较时使用的3:1输入输出混合口径并排看看。
| Claude Opus 4.6 Max | Qwen3.8-27B | GLM-5.3-Flash | |
|---|---|---|---|
| 发布日期 | 2026-02-05 | 2026-08-14 | 2026-08-26 |
| 权重 | 闭源 | Apache 2.0 | MIT |
| 智能指数 | 44.9 | 52.0 | 57 |
| 每百万输入 tokens | $5.00 | $0.45 | $0.15 |
| 每百万输出 tokens | $25.00 | $3.20 | $0.50 |
| 混合价 (3:1) | $10.00 | $1.09 | $0.24 |
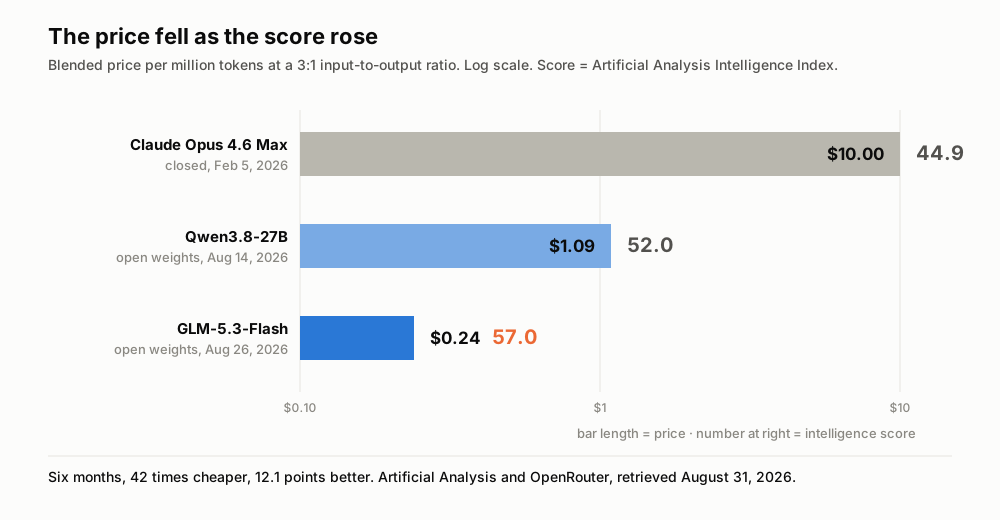
柱长代表价格,柱右侧的数字是智能分数。数据来自 Artificial Analysis 与 OpenRouter,2026年8月31日取得。
GLM-5.3-Flash 比二月那个闭源旗舰便宜42倍,在同一个独立指数上高出12.1分。 和我们十天前写过的那个开源27B相比,它便宜4.6倍、高出5分。这两个差距都是在半年之内拉开的。
这和我们那篇 Qwen3.8 文章从另一端测量的是同一条曲线。Epoch AI 那套固定阈值的时间序列——把基准分数固定住,追踪能达到该分数的最便宜模型——发现 GPT-4 级性能的价格从2023年3月的每百万 tokens 37.50美元降到2025年2月的0.18美元,23个月里便宜了 208 倍。GLM-5.3-Flash 就是这条曲线抵达当前前沿而非三年前前沿时的样子。
再看这个档位。这不是旗舰。在任何实验室的命名习惯里,"Flash"都指那个便宜、快速、面向大批量的兄弟型号,而不是他们真正想让你惊叹的那一个。有意思的事实不是某个中国实验室做出了一个强模型,而是那个廉价档的 SKU 如今已经足够接近前沿,以至于整整一周的匿名正面测试都没有立刻暴露身份。
四件我们无法核实的事,如实标注
围绕这次发布的热情在几个具体位置跑到了证据前面,我们把它们列出来。
关于 Ox Alpha 在百万上下文测试中"超越 GPT-5.6"的说法来自第三方文章,我们找不到可供审视的公开方法论;而且 Z.AI 自己的对标对象是 Claude Opus 4.8,不是 GPT-5.6。请把与 GPT-5.6 的比较当作未经核实的社区说法。
被广泛引用的 DeepSWE pass@1 80% 这个分数,和常被摆在同一张表相邻行里的 SWE-bench Verified 96% 以上的数字并不可比。框架不同、任务集不同、难度不同。任何把两者放在相邻行的表格,都在制造一个并不存在的排名。
Z.AI 声称整个隐身周的服务全部跑在国产加速器上,端到端服务性能提升3倍,每 token 成本与 NVIDIA 硬件相当——这是厂商自述,未经独立审计。如果属实,这将是整个故事里最有分量的细节;但目前它是一份新闻稿上的说法。
还有,免费预览是补贴而不是档位,而且已经结束了。当前价格是0.15美元和0.50美元,另有一个持续到2026年9月9日16:00 UTC 的50%促销折扣——也就是说诚实的稳态数字是折扣前的那个,你应该按0.15/0.50美元而不是按本周价格来做预算。
24美分对一条"听、译、总结"的管线意味着什么
语音产品对 token 价格格外敏感,因为它先生成转录文本,然后反复读它。后续的每一步——润色、翻译、总结、问答——都要把同一段文本重新灌进去。下面是把所有假设都摊开的算术。
- 从一个真实的工作单元开始。 一场两人参与、每分钟约130词的60分钟会议,大约产生7,800词。加上说话人标签和时间戳,把转录文本算作12,000 tokens。
- 加上总结这一步。 把完整转录喂进去,拿到结构化笔记:输入12,000 tokens,输出约800 tokens。
- 加上实时翻译成三种目标语言。 每一遍都要读一次转录并写出体量相当的文本:输入12,000、输出12,000,重复三次。
- 合计整场会议。 输入48,000 tokens,输出36,800 tokens。
- 算两次价。 按 GLM-5.3-Flash 的0.15/0.50美元,这场会议花 2.6 美分。按 Claude Opus 4.6 的5.00/25.00美元,同一场会议花 1.16 美元。
一小时音频上45倍的差距,不是某个成本行项的优化。它是"一个需要小心计量的功能"和"一个默认开着的功能"之间的差别。每场会议1.16美元,给所有用户提供三语翻译就是一个需要财务批准的决定。2.6美分,它就是一个勾选框。
这才是比代号活得更久的部分。隐身发布是一次营销操作,而且是一次漂亮的操作。持久的事实是:一个中型实验室产品线里的廉价档,如今以混合价24美分交付57分的智能,并且附带 MIT 许可证,万一将来价格朝错误的方向走,你可以自己跑。
结论:有意思的价格已经不在前沿了
三年来,模型选型的问题一直是"你能负担得起离前沿多近"。Ox Alpha 的六天回答了另一个问题:如今旗舰档以下究竟沉淀了多少能力、以商品价格摆在那里,以及实验室是否自信到敢摘掉自己的名字去测试它。
匿名红利只有在模型好到能撑过没有品牌的一周时才会兑现。Z.AI 兑现了。下一个出现在路由平台上的代号,值得得到和 Ox Alpha 一样的对待:在有人告诉你它是谁家的之前,先用你自己的任务跑一遍。因为那一周,是任何人能拿到的唯一一次诚实评估。
Telli.sh 的位置: 这条曲线正是我们把语音管线建在引擎提供层之上、而不是围着某一家厂商 API 打转的原因。Telli.sh 把转录、翻译和总结路由到可替换的引擎上,所以这样的价格曲线又下一个台阶时,它抵达用户的形式是"同样的价格、更好的笔记",而不是一封调价通知。任何模型发布都替代不了的,是这份工作的其余部分:把一小时音频稳稳地录下来不掉数据、把说话人分开、跨15种语言实时翻译,并留下一份你下个季度还能搜到的笔记。
出处
- OpenRouter 的
stealth/ox-alpha模型页面 — 2026年8月20日上线日期、百万级上下文,以及确认为 ZAI GLM-5.3-Flash 的表述;2026年8月31日取得 - OpenRouter 的
z-ai/glm-5.3-flash模型页面 — 当前价格与持续到2026年9月9日的促销折扣窗口;2026年8月31日取得 - Hugging Face 模型卡 zai-org/GLM-5.3-Flash — 总参数320B / 激活18B、30万亿 tokens 多模态语料、MIT 许可证、
reasoning_effort设置,以及"接近 Claude Opus 4.8"的表述 - 匿名的 Ox Alpha 在 OpenCode 上处理26万亿 tokens,打破 OpenRouter 上线纪录 — RuntimeWire,2026年8月26日 — 26万亿 tokens、327,000名用户、8,328,244个会话、93%缓存比例,以及 OpenRouter 的11.6万亿 tokens 纪录
- Ox Alpha 的用量、规格与身份线索 — LLM Rumors,2026年8月25日 — 日请求数与558个模型中排名第一
- 前沿级隐身模型 Ox Alpha 免费出现在 OpenRouter 和 OpenCode 上 — WinBuzzer,2026年8月24日 — 每天100万亿 tokens 的容量说法与 Teortaxes 的 GPU 估算
- 中国的 Z.AI 做出了可与 DeepSeek 匹敌的隐身模型 Ox Alpha — 彭博社,经雅虎财经,2026年8月26日 — 一手身份确认
- 打败 DeepSeek 的隐身模型属于智谱 — The Next Web — 身份揭晓报道与开源权重承诺
- OpenRouter 的隐身模型最后都是谁 — Digital Applied,2026年8月22日 — 十四个条目的完整普查、揭晓日期、证据等级与数据条款对比
- Artificial Analysis: GLM-5.3-Flash 的智能、性能与价格分析 — 智能指数57、评测开销138.02美元、每秒45 tokens、生成1.5亿 tokens;2026年8月31日取得
- Epoch AI,《LLM inference prices have fallen rapidly but unequally across tasks》,2025年3月12日 — 208倍这一数字背后的固定阈值价格阶梯
- 我们关于本地模型反攻的前后对比 — Qwen3.8-27B 的数据、价格曲线与追赶时差