语音识别悄悄开源了权重 —— 只有 1.56GB
阿里巴巴的 Qwen3-ASR 采用 Apache 2.0 许可,覆盖 52 种语言和方言,下载体积不到两个 GB。这是一份关于开放权重转写层的通俗指南:现在有哪些模型,在自己的笔记本上跑起来到底能得到什么,以及闭源 API 依然占优的地方在哪里。
现在,笔记本电脑也能运行开放权重语音识别。阿里巴巴 Qwen 团队发布了 Qwen3-ASR-0.6B、Qwen3-ASR-1.7B,以及配套的 Qwen3-ForcedAligner-0.6B,均采用 Apache 2.0 许可。最小模型下载体积为 1.56GB,支持 52 种语言和方言;从 6 月 26 日起,用三行标准 Python 代码即可运行。在自己的机器上运行,就无需按请求支付转录费用。
关注过开放语言模型的人会觉得这场转变很熟悉:自行托管能更好地掌控成本、隐私和离线使用,托管 API 则更容易运维。语音识别也正在出现同样的选择,而且已有足够小、可在本地运行的模型。
本指南说明开放权重语音识别的用途、现有模型及许可差异、小型模型可以运行在哪些设备上,以及托管 API 仍具优势的方面。
TL;DR:
- 开放权重的转写已经可以真用了:Qwen3-ASR 是 Apache 2.0、52 种语言和方言,Whisper 是 MIT,英伟达的 Parakeet 与 Canary 是 CC BY 4.0,Mistral 的 Voxtral 是 Apache 2.0。
- 自建带来隐私、离线运行和成本控制。在独立基准 Artificial Analysis 上,托管一个开放模型每 1,000 分钟 1.50 美元,微软 MAI-Transcribe-1.5 是 6.00 美元,Gemini 3.1 Pro Preview 是 18.15 美元。
- 准确率第一名仍然是一个无法下载的闭源预览端点。但 Apache 2.0 的开放模型 Voxtral Small 已经排到第五,与第一名的差距约为一个百分点的词错误率。
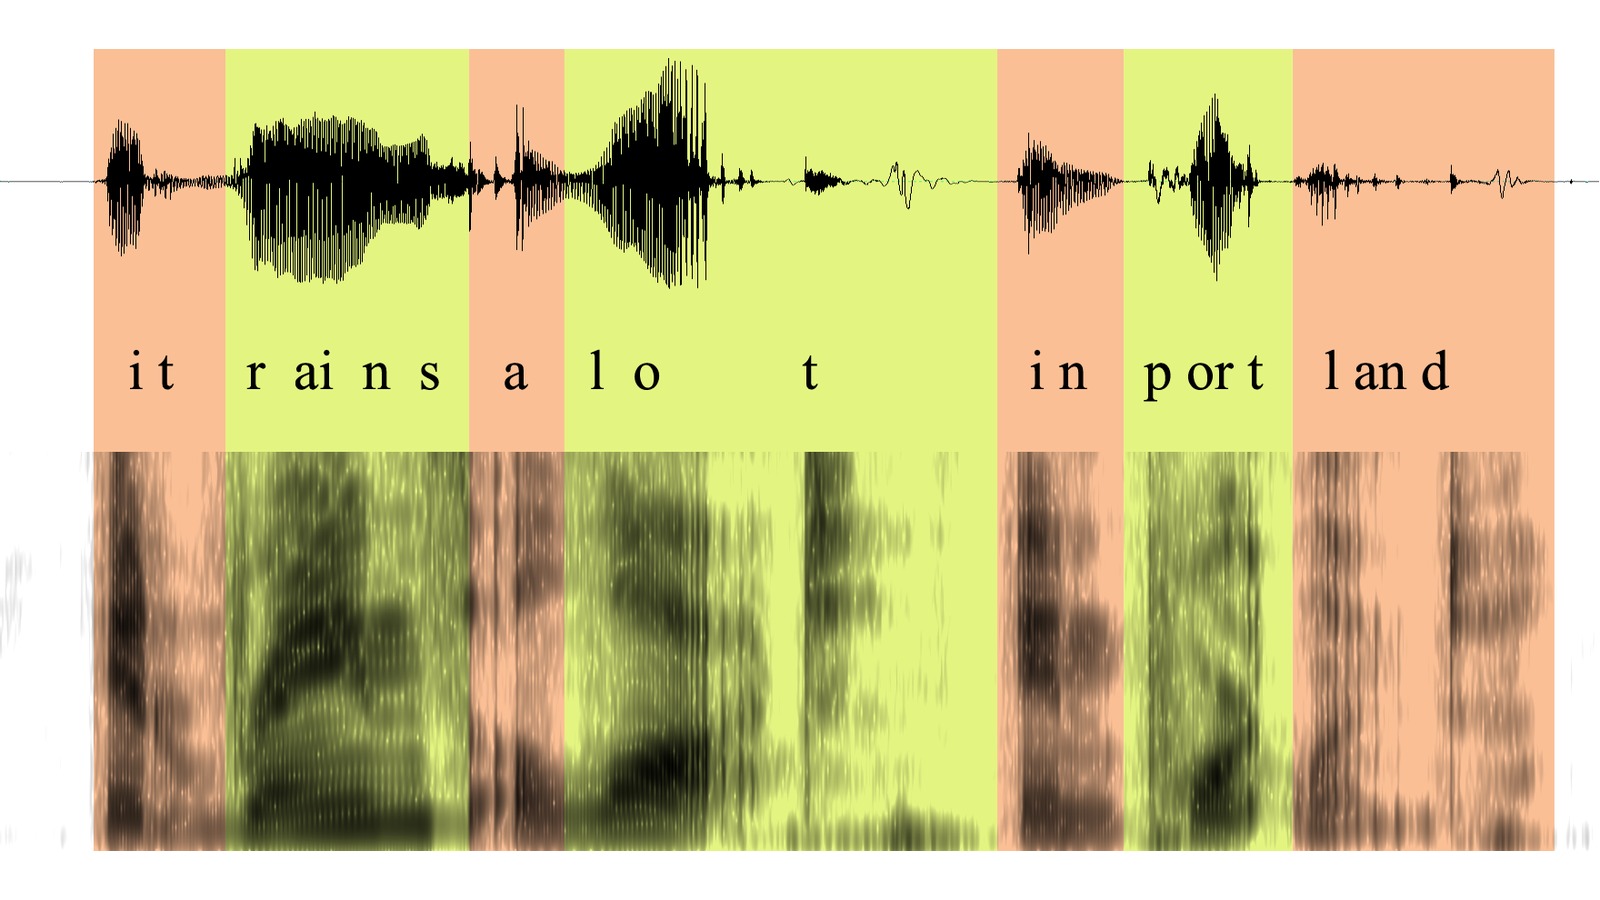
图片:Aaron Parecki,Wikimedia Commons,CC BY 2.0。这是句子"it rains a lot in Portland"的波形与语谱图,字母摆放在它们对应的音频区段上方。每一个语音识别模型面对的原材料就是它。
下载一个转写模型时,你到底下载了什么
ASR 模型,也就是自动语音识别模型,与 STT、语音转文字是同一件事:输入音频,输出文本。工作就这些。它不判断谁在说话,不做总结,也不知道你的会议在讲什么。它听见词,然后写下来。
"开放权重"意味着实验室把成品模型文件本身公开了。模型的权重是它在训练中学到的那一大片数字网格,公开权重就等于你可以下载这个文件、在自己的硬件上运行、在它之上做产品,不必征得谁的同意,也不必按次付费。另一边是闭源模型:权重留在厂商的服务器上,你通过 API 租用访问权,音频传上去、文本传回来,按分钟计费。
名字里的数字是参数量,而在语音模型上这个数字格外实在。"0.6B"意思是大约六亿参数,落到实处就是 Qwen3-ASR-0.6B 是一个 1.56GB 的文件,Qwen3-ASR-1.7B 是 4.08GB,两个都小到能躺在笔记本固态硬盘里而无人察觉。对比一下我们在中国开放模型综述里写过的语言模型:那边的主角是分成 96 个分片的 1.56 TB,光是加载就需要一个集群。语音模型比前沿文本模型小上千倍,正是这一点让这次的变化比那次更打得着人。
我们把这个尺寸范围称为笔记本档位:模型小到试用它只需下载,而不必先讨论硬件预算。大多数前沿文本模型不属于这一档,许多语音模型则可以。
采用模型前先检查许可证。Apache 2.0 和 MIT 允许使用、修改和商业分发;英伟达模型使用的 CC BY 4.0 也允许商用,但要求署名。
Qwen 一月就发了,六月才变简单
Qwen3-ASR 最早于 2026 年 1 月 28 日发布,技术报告次日登上 arXiv。6 月 26 日,Qwen 发布了三个模型的 -hf 版本,兼容 Hugging Face Transformers v5.13.0 及之后版本。
这次打包调整让设置方式更熟悉:使用 Transformers 的开发者无需安装 Qwen 自己的 qwen-asr 包或 vLLM 后端,就能用标准 Python 加载 -hf 检查点。它降低了配置成本,但没有改变模型能识别的内容。
模型卡列出两种尺寸都支持 30 种语言的识别,包括英语、中文、韩语、日语、西班牙语、阿拉伯语、印地语、泰语、越南语和波兰语等,另加 22 种中文方言,合计 52 种语言和方言。两个模型都支持同一模型上的流式与离线推理、长音频,也将歌唱和带背景音乐的歌曲列为支持的音频类型。
Qwen3-ForcedAligner-0.6B 增加了强制对齐功能:给定音频和转写文本,它会在 11 种语言中标出每个词的起止时间,精确到毫秒,单段最长 5 分钟。这让转写稿可以点击跳转、字幕可以精确计时,也能直接跳到某个词被说出的时刻。识别器与对齐器一同发布,使这套模型适合构建转写产品,而不只是运行演示。
Qwen 的模型卡引用 2026 年 6 月 26 日 Hugging Face Open ASR Leaderboard 的结果:1.7B 模型平均词错误率为 5.59%,0.6B 为 6.31%;在 AMI 会议音频子集上,两者分别为 9.26% 和 10.57%。词错误率越低,错词越少。Qwen 称 1.7B 在开放 ASR 模型中达到先进水平,并可与商用 API 竞争;这些属于厂商报告的结果。下文的独立榜单使用不同音频,因此不能直接比较。
是 Whisper 起的头,而且大家现在跑的还是它
如果没有 OpenAI 的 Whisper,眼下这个局面不会是这个样子。仓库在 2022 年 9 月 16 日以 MIT 许可公开,代码和权重一起放出——那时候要做像样的语音识别,意味着跟云厂商签合同。此后它攒下了 106,679 颗 GitHub 星。
真正让 Whisper 重要起来的,与其说是模型本身,不如说是社区在几个月内在它之上盖起来的东西。whisper.cpp 用纯 C/C++ 重写了它,不需要 Python 也不需要 GPU 就能在笔记本和手机上跑,MIT 许可,52,591 颗星。faster-whisper 把它重建在 CTranslate2 上,速度和内存都大幅改善,同样是 MIT,24,750 颗星。模型是种子,生态才是树。
四年后,Whisper 仍被广泛使用。在截至 2026 年 8 月 5 日的 30 天内,whisper-large-v3-turbo 在 Hugging Face 上下载了 872 万次,whisper-large-v3 为 550 万次;Qwen3-ASR-0.6B 达到 429 万次。在 Artificial Analysis 榜单的该次快照中,Whisper Large v3 的 AA-WER 为 4.07%,首位模型为 1.73%。

开放语音这一层分两波抵达,中间隔了三年,几乎空无一物。发布日期来自 GitHub 与 Hugging Face,2026 年 8 月 5 日取得。
开放这一侧不止一家实验室
除了 Qwen,还有别人,而且各自擅长的地方差别很明显。
英伟达的 Parakeet 系列侧重速度。parakeet-tdt-0.6b-v3 于 2025 年 8 月以 CC BY 4.0 发布,拥有 6 亿参数,覆盖 25 种欧洲语言,并支持自动语种检测、标点、大小写和词级时间戳,每次可处理最长 24 分钟的音频。同样采用 CC BY 4.0 的 Canary 系列——canary-1b-v2 和 canary-qwen-2.5b——提供相关能力。Mistral 的 Voxtral 模型于 2025 年 7 月以 Apache 2.0 发布,在下方的独立对比中排名靠前。
把开放这一侧并排放一起看,最后一行是用作对照的托管 API。
| 模型 | 下载体积 | 许可证 | 语言 | 跑在哪 | 最擅长 |
|---|---|---|---|---|---|
| Whisper Large v3 | 3.09GB | MIT | 99 种 | 笔记本或单张 GPU | 所有工具都已支持的默认项 |
| Qwen3-ASR-0.6B | 1.56GB | Apache 2.0 | 含方言 52 种 | 笔记本 | 以最小体积做多语种 |
| Qwen3-ASR-1.7B | 4.08GB | Apache 2.0 | 含方言 52 种 | 笔记本或单张 GPU | Qwen 系里最高的准确率 |
| Parakeet TDT 0.6B v3 | 2.51GB | CC BY 4.0 | 欧洲 25 种 | 笔记本或单张 GPU | 速度与词级时间戳 |
| Voxtral Small | — | Apache 2.0 | — | 服务器 GPU,240 亿参数 | 独立榜单上开放模型的最高分 |
| 托管 API | 不可下载 | 闭源 | 各家不同 | 厂商的云 | 说话人分离、流式、可用性 |
下载体积为各 Hugging Face 仓库的默认检查点大小;"—" 表示本次比较使用的来源材料未提供该值。快照于 2026 年 8 月 5 日取得。
再往下,是把这些模型送上真实设备的那层封装工作,也是"笔记本档位"不再停留在嘴上的地方。为苹果硬件编译的 Whisper,也就是 whisperkit-coreml,过去 30 天被下载 831 万次。面向 Apple Silicon 的 Parakeet MLX 构建是 187 万次,两个 GGUF 转换版——那是让模型跑在普通 CPU 上的量化格式——加起来分别是 204 万和 187 万次。每个月有几百万人,专门去下载为在自己机器上运行而打包好的语音识别。这不是研究上的新奇玩意,这是一条分发渠道。
第一名仍然是一个你下载不到的预览端点
这份比较将识别准确度与自行运行模型的运维优势分开来看。
Artificial Analysis 的语音转文字榜单快照取于 2026 年 8 月 5 日,使用相同音频测试开放与闭源模型。其 AA-WER v2 结果包括:
| 排名 | 模型 | AA-WER | 能否下载 |
|---|---|---|---|
| 1 | Fun-Realtime-ASR-preview | 1.73% | 不能 —— 预览端点 |
| 2 | Scribe v2,ElevenLabs | 2.18% | 不能 —— 托管 API |
| 3 | MAI-Transcribe-1.5,微软 | 2.38% | 不能 —— 托管 API |
| 4 | Smallest AI Pulse Pro | 2.43% | 不能 —— 托管 API |
| 5 | Voxtral Small,Mistral | 2.77% | 能 —— Apache 2.0 |
| 6 | Gemini 3.1 Pro Preview,High | 2.82% | 不能 —— 托管 API |
| 11 | Whisper Large v3 | 4.07% | 能 —— MIT |
来源:Artificial Analysis 语音转文字榜单,AA-WER v2,2026 年 8 月 5 日取得。能否下载依据各模型公开的许可证判断。
前四行显示,这份快照中得分最高的模型由云端托管,榜首是预览端点,而不是可下载模型。
Voxtral Small 采用 Apache 2.0,在榜单上以 2.77% 排名第五,与榜首闭源预览模型相差约一个百分点。对于一场约 6,300 词的一小时会议,这相当于约 66 个词。差距确实存在,但对重视本地部署的团队来说并非不可逾越。
对于许多工作负载,开放语音模型已经够用;接下来要权衡的是,值得为自行托管的控制力接受小幅准确率差距,还是付费使用托管服务附带的功能。
自己跑能换来什么,又要付出什么
把团队推向自建的理由有三个,其中没有一个是准确率。
第一是隐私,而且通常是决定性的。如果你转写的是问诊、法律访谈或人事谈话,"音频不离开我们自己的硬件"不是偏好,而是采购要求,只有自建的模型能干净地满足它。第二是离线运行:装在设备里的模型在飞机上、地下室里、车间地面上、没有信号的野外都能工作。whisper.cpp 和那些 GGUF 构建的下载量之所以是那个量级,原因正在于此。
第三是成本,这里的数字很不客气。还是同一份 Artificial Analysis 快照,每 1,000 分钟音频的价格:托管在 fal.ai 上的 Whisper Large v3 是 0.50 美元,Replicate 上的英伟达 Canary Qwen 2.5B 是 0.74 美元,Together AI 上的 Parakeet TDT 0.6B V3 是 1.50 美元。闭源这边,Deepgram 的 Nova-3 是 4.30 美元,MAI-Transcribe-1.5 是 6.00 美元,Gemini 3.1 Pro Preview 是 18.15 美元。仅仅是把开放模型托管在别人的服务器上,相对微软就是 4 倍差距,相对谷歌是 12 倍——这还没算你在自己机器上跑的情况,那种情况下第一千个小时的边际成本是电费。
同一快照中的速度数据显示,由 Together AI 托管的 Parakeet TDT 0.6B V3 达到实时速度的 885 倍,处理一小时音频约需四秒。Deepgram Nova-3 为 512 倍,Together 上的 Whisper Large v3 为 478 倍,MAI-Transcribe-1.5 为 189 倍。榜单中最快的是开放权重模型,不过该结果测量的是 Together AI 托管服务,而非本地硬件。

这场取舍从来不是准确率对准确率,而是控制权与成本,对上包裹在识别外面的那些功能。
那么托管 API 还在卖什么?卖的是识别之外的一切。Deepgram 的文档就是一份诚实的清单:说话人分离、实时流式、格式化、自定义词表、实体脱敏、语种检测,以及你睡觉时它照样在线的保证。下载 Qwen3-ASR,你得到的是词和时间戳。没有说话人标签,没有 SLA,GPU 账单、扩容和凌晨三点的告警都归你。
这个类目下载量最高的模型,根本不是转写模型
下载趋势也显示,除了转录,人们还需要说话人识别。
把 Hugging Face 整个自动语音识别类目按下载量排序,排在最上面的既不是 Whisper,也不是 Qwen 或 Parakeet,而是过去 30 天被下载 891 万次的 pyannote/speaker-diarization-3.1;另一个 pyannote 说话人分离模型以 526 万次排第五。说话人分离,就是判断谁在什么时候说话的那套机制,正好是转写紧邻的上一层。

开放权重如今覆盖了这一叠里最下面的两层。决定一份记录有没有用的那几层,在它们之上。
语音识别类目中下载量最高的模型并不识别语音,而是识别谁在何时说话。这种需求指向转录之上的一层:说话人标签能帮助把识别出的文字变成有用的会议记录。这也呼应了我们对闭源市场的分析中提到的产品缺口。
结论
关于开放权重语音识别,真正有意思的问题从来不是"它有没有闭源模型好"。它已经追到词错误率一个百分点以内,更快,便宜四到十二倍,而且装得下一台笔记本。有意思的问题是:当转写不再是一项租来的开支,空出来的那块地方你要盖什么——因为一个能听懂 52 种语言的 1.56GB 文件不是产品,它是一个刚刚变免费的零件。
对于在选会议记录工具而不是在选模型的团队来说,要读的东西很短。一个产品用的是开放模型还是闭源 API,如今大体上只是实现细节,而且会越来越是两者兼有:跑量的部分用开放权重,说话人分离、流式和规模值回票价的地方用托管 API。Telli.sh 的摘要层本来就跑着一个开放模型,所以开放这一侧的进步会不涨价地一路流进转写、翻译和会议记录。判断工具,看最后出来的东西:那份记录有没有告诉你,谁答应了做什么。
来源
- Qwen3-ASR-0.6B-hf 模型卡 (Hugging Face) —— 许可证、语言列表、2026 年 6 月 26 日的榜单数据
- Qwen3-ASR-1.7B-hf 模型卡 (Hugging Face)
- Qwen3-ForcedAligner-0.6B (Hugging Face)
- Qwen3-ASR Technical Report, arXiv:2601.21337(2026 年 1 月 29 日提交)
- OpenAI Whisper 仓库(MIT,2022 年 9 月 16 日公开)
- whisper.cpp / faster-whisper
- NVIDIA parakeet-tdt-0.6b-v3 模型卡 (CC BY 4.0)
- Mistral Voxtral-Small-24B-2507 (Apache 2.0)
- Artificial Analysis 语音转文字榜单 —— AA-WER v2,速度与价格数据于 2026 年 8 月 5 日取得
- Hugging Face Open ASR Leaderboard
- Deepgram 说话人分离文档
- Wikimedia Commons 图片页面
