40+ języków tłumaczonych na żywo i kasowanych po rozłączeniu: transkrypcja wielojęzyczna to warstwa, która zachowuje spotkanie
DeepL uruchomił Voice-to-Voice 16 kwietnia 2026 r. w ponad 40 językach, a FAQ tego samego produktu mówi, że dane spotkania są «przetwarzane tymczasowo w pamięci i usuwane po zakończeniu połączenia». 28 sierpnia Open ASR Leaderboard dodał pierwszy język Globalnego Południa i pokazał, że dwa modele idące łeb w łeb na poziomie 4,9 WER różnią się niemal czterokrotnie tym, jak bardzo ich dokładność zależy od tego, skąd pochodzi mówiący. Tłumaczenie spotkań w czasie rzeczywistym staje się towarem masowym. Zapis nie.
16 kwietnia 2026 roku DeepL uruchomił z Kolonii Voice-to-Voice: pakiet do tłumaczenia mowy w czasie rzeczywistym obejmujący cztery powierzchnie — spotkania wirtualne, rozmowy na urządzeniach mobilnych i w przeglądarce, sytuacje grupowe dla pracowników pierwszej linii oraz firmowe API. Obsługuje ponad 40 języków, w tym wszystkie 24 języki urzędowe UE, a obok nich wietnamski, tajski, arabski, norweski, hebrajski, bengalski i tagalski. W ślepych ocenach przeprowadzonych przez Slator na zlecenie DeepL 96% lingwistów wybrało go zamiast tłumaczenia wbudowanego w Google, Microsoft i Zoom; DeepL Voice dla Zooma uzyskał 96,4 na 100 wobec 87–89 u konkurencyjnych platform.
FAQ DeepL wyjaśnia też, co dzieje się z danymi spotkania po zakończeniu rozmowy:
„DeepL nie przechowuje trwale danych transkrypcji ani tłumaczenia. Dane spotkania są przetwarzane tymczasowo w pamięci i usuwane po zakończeniu połączenia".
Przeczytajcie te dwa fakty obok siebie. Tłumaczenie jest znakomite — i tego tłumaczenia nie ma już przed kolacją.
W skrócie
- Tłumaczenie spotkań w czasie rzeczywistym przeszło w 2026 roku z kategorii trudnego problemu do kategorii dostarczonego towaru masowego: ponad 40 języków w DeepL, 58 pojedynczych języków w Nova-3 od Deepgram, tłumaczenie na żywo wewnątrz Google Meet.
- To, że nic nie zostaje, jest zwykle świadomą decyzją o prywatności, a nie wadą — ale oznacza, że samo spotkanie nie zostawia żadnego artefaktu do przejrzenia.
- Transkrypcja wielojęzyczna to osobna warstwa poniżej. Trzyma razem, w jednym możliwym do przejrzenia zapisie, transkrypt w języku źródłowym, tłumaczenie, oznaczenia mówiących i podsumowanie. Ten tekst wyjaśnia, dlaczego przetrwać musi właśnie język źródłowy — i jak prowadzić spotkanie, żeby przetrwał.
W czerwcu Google Meet i Tłumacz udostępniły konsumentom tłumaczenie mowy na żywo (dlaczego wielojęzyczne spotkania nadal potrzebują notatek do przejrzenia). W miarę upowszechniania się tłumaczenia na żywo praktyczne pytanie brzmi: co pozostaje po spotkaniu?
Tłumaczenie spotkań w czasie rzeczywistym przestało być trudną częścią
Przez mniej więcej dekadę wielojęzyczna mowa na żywo była tym demem, które nigdy nie przeżywało zderzenia z prawdziwym spotkaniem. Opóźnienie zjadało wymianę zdań, akcenty łamały rozpoznawanie, a wszystko choć trochę techniczne wychodziło poszatkowane. Ta epoka skończyła się w jakieś dziesięć miesięcy.
Nova-3 od Deepgram wymieniała 31 języków w nocie wydania z 10 grudnia 2025 roku, a w dokumentacji z sierpnia 2026 roku — 58: 39 udokumentowanych dodań w mniej niż dziewięć miesięcy, mniej więcej jeden nowy język co siedem dni. Prześledziliśmy tę ekspansję i drobny druk pod nią w tekście co naprawdę ukrywa słowo „obsługiwany" w pokryciu językowym rozpoznawania mowy. Google wstawił tłumaczenie mowy na żywo do Meeta. DeepL dostarczył w kwietniu pakiet głosowy o czterech powierzchniach.
Zamówiona przez DeepL ocena Slatora podaje wskaźnik błędu 4% dla DeepL Voice wobec średnio 17% u konkurencyjnych platform spotkaniowych oraz wyniki 96,4/100 dla Zooma i 96,3/100 dla Teamsów. Relacja The Next Web z ogłoszenia z 17 kwietnia 2026 roku opisywała demo w Seulu z opóźnieniem jednego–dwóch zdań; dyrektor produktu DeepL zauważył, że różnice szyku zdania ograniczają szybkość tłumaczenia mowy na mowę.
Opóźnienie jednego–dwóch zdań wystarcza. Nie wystarcza, by zastąpić zawodowego tłumacza ustnego przy negocjacjach traktatu i nikt tego nie twierdzi. Z zapasem wystarcza natomiast na wtorkową synchronizację produktową między Warszawą, Seulem i São Paulo — czyli na spotkanie, które większość z nas naprawdę odbywa.
Wraz z poprawą tłumaczenia na żywo kolejnym wyzwaniem staje się to, co zostaje po spotkaniu.
Z założenia tłumaczenie nie przeżywa połączenia
Ta polityka przechowywania odzwierciedla wybór dotyczący bezpieczeństwa. DeepL podaje, że dane są szyfrowane podczas przesyłania, nie są używane do trenowania modeli i „pozostają wyłącznie na lokalnym urządzeniu uczestników spotkania". W organizacjach prowadzących poufne rozmowy ograniczone przechowywanie może uprościć ocenę prywatności.
Narzędzia do napisów na żywo często stawiają na ograniczone przechowywanie. Może to chronić prywatność, ale zespoły powinny sprawdzić, czy po spotkaniu zostaje materiał do późniejszego przeglądu.
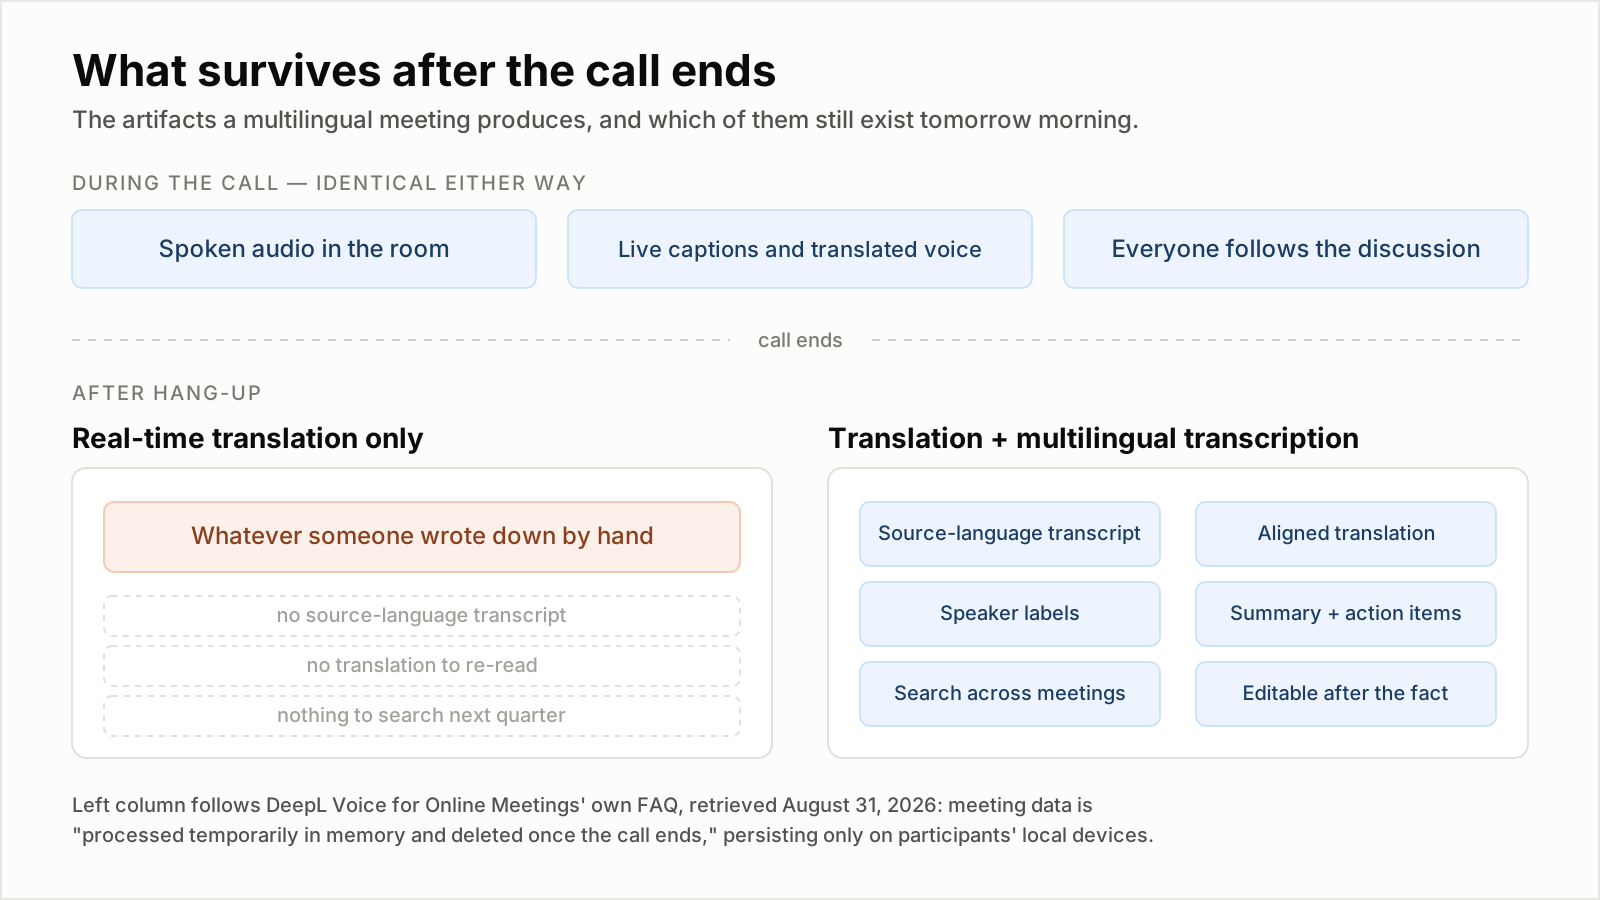
W trakcie połączenia obu podejść nie da się odróżnić. Różnica leży w całości po drugiej stronie rozłączenia. Lewa kolumna odwzorowuje FAQ samego DeepL Voice for Online Meetings, sprawdzone 31 sierpnia 2026 roku.
Tryb awarii, który to wytwarza, ma swój kształt i potrzebuje nazwy. Nazwijmy go dryfem decyzji: wszyscy zrozumieli spotkanie doskonale, a trzy tygodnie później nikt nie potrafi udowodnić, co zostało ustalone. To nie jest nieporozumienie — tłumaczenie na żywo zrobiło swoje. Rzecz w tym, że jedyna zachowana kopia decyzji podjętej w dwóch językach mieszka w pięciu pamięciach, w pięciu różnych sformułowaniach, w co najmniej dwóch językach, a pamięć rekonstruuje, zamiast odtwarzać.
Dryf decyzji kosztuje w sposób, który nigdy nie pojawi się na fakturze za narzędzie. Pojawia się jako funkcja zbudowana po raz drugi, jako renegocjowany termin, jako pytanie o zgodność, na które nikt nie umie odpowiedzieć, jako nowa osoba w zespole, która nie ma jak się dowiedzieć, co zespół ustalił w zeszłym kwartale.
28 sierpnia: benchmark, który tłumaczy, po co wam język źródłowy
Jakość transkrypcji nie jest jednakowa. Niedawna ewaluacja rozpoznawania mowy po hindi pokazuje, dlaczego warto zachować zapis w języku źródłowym, który można później zweryfikować.
28 sierpnia 2026 roku Hugging Face i Voice Arena dodały pierwszy język Globalnego Południa do Open ASR Leaderboard: hindi, którym mówi ponad pół miliarda ludzi, trafił do zakładki wielojęzycznej obejmującej dotąd wyłącznie języki europejskie. Wnieśli cztery zestawy ewaluacyjne — Monsoon en-IN i hi-IN, w wersji publicznej i prywatnej — z 4888 rozłącznymi mówiącymi, 12 zapisanymi atrybutami na osobę, zebranymi w 428 dystryktach i na setkach realnych modeli telefonów, a nie w studiu.
Potem puścili na tym modele z samej tablicy wyników. Rezultat jest najbardziej użyteczną rzeczą opublikowaną w tym miesiącu o rozpoznawaniu mowy.
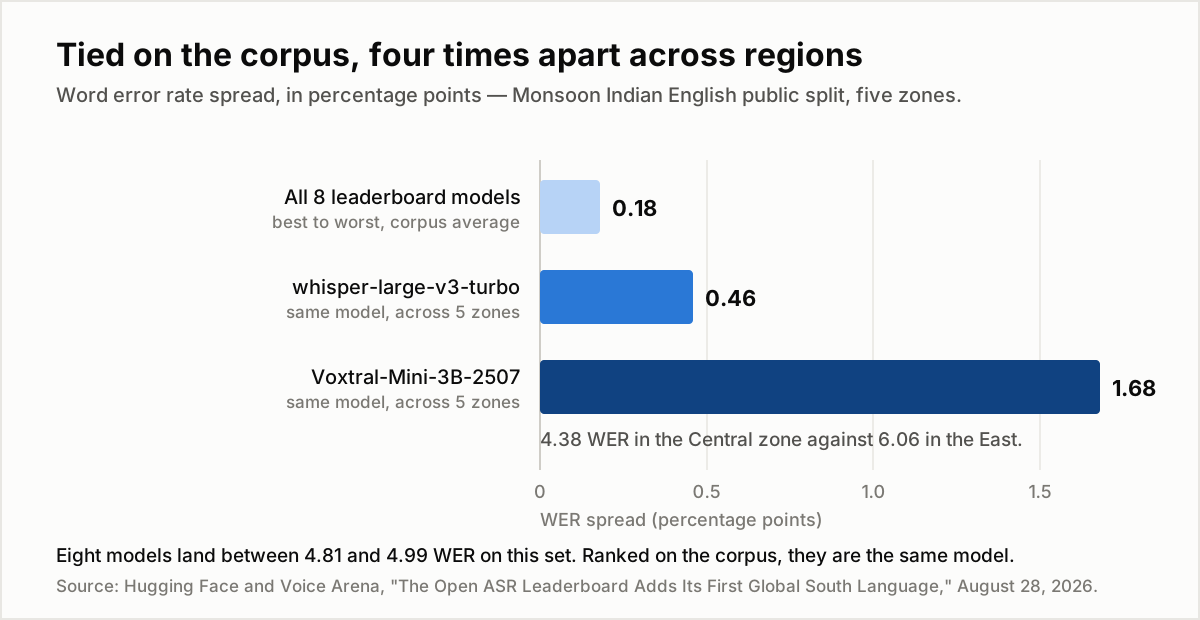
Jedna oś, jedna jednostka: ile punktów WER dzieli porównywane wielkości. Źródło: Hugging Face i Voice Arena, 28 sierpnia 2026 roku.
Osiem modeli z tablicy mieści się między 4,81 a 4,99 WER na publicznym zestawie indyjskiego angielskiego. To 0,18 punktu od najlepszego do najgorszego — w granicach tego, co pięć godzin nagrań w ogóle jest w stanie rozróżnić. Uszeregowane po korpusie, jak ujmuje to publikacja, są tym samym modelem.
Pogrupujcie mówiących według regionu, a przestają nim być. Po podniesieniu rodzinnego dystryktu każdej osoby do jej rady strefowej openai/whisper-large-v3-turbo waha się o 0,46 punktu między pięcioma strefami. mistralai/Voxtral-Mini-3B-2507, ustępujący mu w średniej korpusowej ledwie o 0,14 punktu, waha się o 1,68: 4,38 WER w strefie Centralnej wobec 6,06 na Wschodzie. Dwa systemy nierozróżnialne na tablicy wyników różnią się niemal czterokrotnie tym, jak bardzo ich dokładność zależy od tego, gdzie mówiący dorastał.
I nie jest tak, że któryś region jest po prostu trudniejszy. ibm-granite/granite-speech-3.3-2b wypada najgorzej na Północy, microsoft/VibeVoice-ASR-HF na Południu, Voxtral na Wschodzie. Gdyby któraś strefa była trudna z natury, wszystkie modele uszeregowałyby strefy tak samo. Nie robią tego, a to wskazuje na modele, nie na nagrania.
Odczyt operacyjny dla każdego, kto prowadzi wielojęzyczne spotkania: wasza jakość transkrypcji nie jest liczbą, którą można sprawdzić. Jest funkcją tego, kto siedzi w pokoju. Kolega, którego akcent wasz dostawca próbkował najmniej, to ten kolega, którego zdania wyjdą błędnie — i ani tablica wyników, ani strona dostawcy was o tym nie uprzedzą. Jedyną obroną jest transkrypt, który człowiek może przeczytać i poprawić, a to wymaga, żeby transkrypt istniał.
Hindi zapisuje to samo wyrażenie na dziesięć poprawnych sposobów. Tłumaczenie wybiera jeden.
Drugie ustalenie z tej samej publikacji jest subtelniejsze i trafia bliżej sedna tego tekstu.
Wariancja ortograficzna angielskiego jest ograniczona: brytyjski kontra amerykański, interpunkcja, cyfry kontra słowa. Normalizator sprowadza większość do jednej formy. Hindi nie jest ograniczone w ten sposób. Mowa codzienna jest mocno przemieszana z angielskim, słowa pochodzenia angielskiego nie mają ustalonego zapisu w dewanagari, a złożenia pisze się łącznie albo rozdzielnie wedle upodobania. Jedno wyrażenie może mieć dziesięć albo więcej poprawnych form pisanych i nie istnieje kanoniczna strona, do której dałoby się je sprowadzić.
Dlatego zestawy hindi są dostarczane z kratą: dla każdego odcinka transkryptu zbiór zapisów uznawanych za poprawne. Ocenia się je nie zwykłym WER, lecz OIWER — wskaźnikiem błędu słów uwzględniającym ortografię, zaproponowanym przez AI4Bharat. Gdy te same hipotezy przeliczono względem wersji spłaszczonej do pojedynczego odniesienia, wskaźniki błędu wzrosły w każdym systemie, wzrosły nierównomiernie, a pary systemów zamieniły się miejscami. Przy pojedynczym odniesieniu model jest częściowo nagradzany za odtworzenie ortografii wybranej przez anotatora; przy kracie ocenia się wyłącznie rozpoznanie.
Zatrzymajcie się przy tym, co z tego wynika. Nawet na poziomie „co zostało zapisane" często nie ma jednego poprawnego ciągu znaków — jest zbiór dopuszczalnych, a wybranie jednego z nich wyrzuca informację.
Tłumaczenie to dokładnie ta sama redukcja, tylko poziom wyżej i o wiele bardziej stratna. Każda przetłumaczona linijka to rozstrzygnięcie między odczytaniami, którego oryginał wcale nie musiał podejmować.
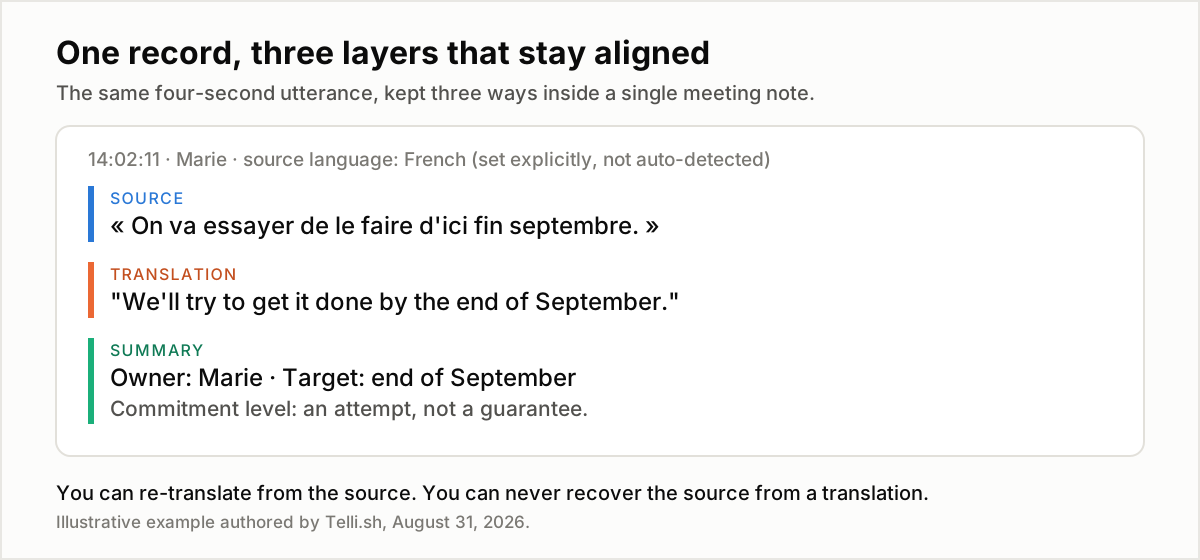
Linijka w języku źródłowym jest jedyną z trzech, której nie da się odtworzyć z pozostałych.
Gdy „On va essayer de le faire d'ici fin septembre" staje się „Spróbujemy to zrobić do końca września", zmienia się coś realnego: francuskie essayer niesie specyficzny rejestr złagodzenia, który „spróbujemy" spłaszcza. Czy to była deklaracja, czy zamiar? Przetłumaczona linijka tego nie powie. Źródłowa powie. Sześć tygodni później, gdy termin się przesunie, a dwa zespoły zapamiętają zdanie inaczej, źródłowa linijka jest całym argumentem.
Oto asymetria w samym środku tematu. Tłumaczenie działa w jedną stronę. Ze źródła można tłumaczyć ponownie dowolną liczbę razy, za rok lepszym modelem. Z tłumaczenia źródła nie odzyskacie nigdy.
Co zostaje po zakończeniu połączenia: tłumacz czasu rzeczywistego kontra tłumacz spotkań z notatkami
Oto porównanie powiedziane wprost, dla trzech sposobów, w jakie zespoły obsługują dziś wielojęzyczne spotkanie.
| Co macie następnego ranka | Warstwa tłumaczenia w czasie rzeczywistym | Tłumacz ustny | Tłumacz spotkań z notatkami |
|---|---|---|---|
| Zrozumienie na sali | Tak | Tak, najwyższa jakość | Tak |
| Nagranie audio spotkania | Tylko przy osobnym nagrywaniu | Tylko przy osobnym nagrywaniu | Tak |
| Transkrypt w języku źródłowym | Nie | Nie, o ile nie spisany osobno | Tak |
| Tłumaczenie wyrównane do oryginału | Nie | Nie | Tak |
| Kto wypowiedział którą linijkę | Nie | Nie | Tak, z oznaczeniem mówiących |
| Podsumowanie i zadania | Nie | Notatki tłumacza, jeśli są | Tak, generowane z transkryptu |
| Wyszukiwalne po trzech miesiącach | Nie | Nie | Tak |
| Błędną linijkę da się poprawić | Nie | Po fakcie nie | Tak, edytując zapis |
| Typowy koszt za godzinę | Abonament na oprogramowanie | 100–200 USD i więcej, przy długich sesjach dwoje tłumaczy | Abonament na oprogramowanie |
Zachowanie kolumny ulotnej odwzorowuje opublikowane FAQ DeepL Voice for Online Meetings, sprawdzone 31 sierpnia 2026 roku; stawki tłumaczy to szeroko publikowany przedział rynkowy dla profesjonalnego tłumaczenia konferencyjnego i zmieniają się zależnie od pary językowej i rynku. Trzecia kolumna opisuje kategorię „tłumacz spotkań z notatkami" w ogólności, a nie konkretnego dostawcę.
Kształt tabeli jest argumentem. Kolumna pierwsza i trzecia są identyczne w jedynym wierszu, który kupujący zwykle ocenia — zrozumienie na żywo — i rozchodzą się w każdym wierszu, który liczy się po spotkaniu. Porównania dostawców niemal zawsze rozgrywają się w pierwszym wierszu.
Tłumacz na żywo to okno. Tłumacz spotkań z notatkami to okno i księga rachunkowa. Zespoły kupują okna, bo to jest ta część, której doświadczają, a potem prowadzą kwartał na księdze, której nigdy nie kupiły.
Jak prowadzić wielojęzyczne spotkanie, żeby zapis pozostał użyteczny
Sześć kroków w kolejności, w jakiej występują. Żaden nie jest egzotyczny; porażka polega niemal zawsze na tym, że nikt nie zdecydował.
- Ustawcie język źródłowy wprost. Nie polegajcie na autodetekcji. Autodetekcja musi się zadeklarować w pierwszych sekundach, na najuboższym kontekstowo materiale całej sesji, a pomyłka pogarsza wszystkie kolejne etapy naraz. Jawny wybór pozwala też silnikowi skierować was do dedykowanego modelu jednojęzycznego, który zwykle jest mocniejszy od wielojęzycznego — Nova-3 dokumentuje przecież 58 języków pojedynczo, ale przełączanie kodów w dokładnie 10.
- Oddzielcie języki, którymi ludzie będą mówić, od tych, w których będą czytać. To dwie różne listy, a traktowanie ich jak jednej jest najczęstszym błędem konfiguracji w tej kategorii. Centrum pomocy DeepL dzieli je dokładnie tak: „języki mówione" to te, które przyjmuje rozpoznawanie, „języki tłumaczenia" to te, w których mogą się wyświetlać napisy — i druga lista jest znacznie dłuższa.
- Przed połączeniem zdecydujcie, gdzie zamieszka zapis, i sprawdźcie, że nie jest to platforma spotkań. Jeśli wasz dostawca tłumaczeń kasuje dane spotkania przy rozłączeniu — a to zachowanie domyślne i całkiem obronne — to żadne ustawienie wewnątrz tego narzędzia zapisu nie wytworzy. Przechwycenie musi być świadomym, osobnym wyborem.
- Zostawcie włączone oznaczanie mówiących. Przetłumaczona linijka bez atrybucji jest bezużyteczna dla każdej decyzji, którą miałaby później podeprzeć. „Zrobimy to do września" staje się faktem dopiero wtedy, gdy wiadomo, kto to powiedział.
- Poprawiajcie nazwy własne i terminy branżowe w pierwszych pięciu minutach, na żywo. Nazwy własne, kryptonimy produktów i skróty to miejsce, w którym transkrypcja zawodzi niezawodnie, a zarazem miejsce, w którym błędna linijka najmocniej psuje wygenerowane później podsumowanie. Poprawka w trakcie spotkania kosztuje sekundy; poprawka w dokumencie, którego nikt nie czyta ponownie, nie kosztuje nic, bo nikt tego nie robi.
- Generujcie podsumowanie z transkryptu w języku źródłowym, a nie z tłumaczenia, jeśli tylko się da. Streszczanie tłumaczenia układa dwa stratne kroki jeden na drugim. To nasza rekomendacja, a nie zmierzony wynik, ale mechanizm jest prosty: każdy etap odrzuca informację, a złożone razem odrzucają jej więcej.
I trzymajcie te trzy artefakty w jednym zapisie. Transkrypt w jednym narzędziu, tłumaczenie w historii czatu i podsumowanie w dokumencie to trzy pliki, które w ciągu miesiąca zaczną sobie przeczyć — a właśnie tej sprzeczności chcieliście uniknąć.
Sedno: zrozumienie było problemem przepustowości, zapis jest problemem pamięci
Tłumaczenie spotkań w czasie rzeczywistym pomaga przekazywać sens między rozmówcami na tyle szybko, by mogli kontynuować rozmowę. Demonstracja DeepL w Seulu i zlecona przez firmę ocena jakości pokazują postęp, ale podane opóźnienia i wyniki nie są gwarancją dla każdego produktu ani każdej pary językowej. Przed wyborem narzędzia przetestuj używane języki, dźwięk i sposób zabierania głosu.
Transkrypcja wielojęzyczna rozwiązuje problem pamięci, a rozwiązanie przepustowości w ogóle go nie dotyka. Inny artefakt, inna polityka przechowywania, inny tryb awarii. Zespół, który kupi tylko pierwsze i uzna, że dostał drugie, będzie dalej odbywał znakomite spotkania, z których nie potrafi się rozliczyć.
Pytanie na następną rozmowę z dostawcą nie brzmi więc „na ile języków tłumaczycie". Na to każdy poważny dostawca odpowiada dziś liczbą większą niż 40. Pytanie brzmi: gdy połączenie się skończy, co dalej istnieje — i w czyim języku?
Gdzie w tym Telli.sh: wszystko powyżej dotyczy warstwy pod tłumaczeniem na żywo i to właśnie tę warstwę budujemy. Telli.sh prowadzi transkrypcję na żywo z tłumaczeniem na 44 języki docelowe, przy interfejsie dostępnym w 15, więc osoba w Warszawie czyta koreański standup po polsku w trakcie jego trwania. Następnego ranka liczy się to, że wszystkie trzy artefakty zostają w jednej notatce: tekst w języku źródłowym tego, co naprawdę padło, wyrównane do niego tłumaczenie i wygenerowane na tym podsumowanie. Do przejrzenia, do poprawienia i do wyszukania długo po zakończeniu połączenia.
Zacznij notatkę ze spotkania z tłumaczeniem na żywo
Źródła
- Hugging Face i Voice Arena, "The Open ASR Leaderboard Adds Its First Global South Language", 28 sierpnia 2026 — zestawy Monsoon en-IN i hi-IN, 4888 mówiących, rozrzut WER między strefami, OIWER i krata dla hindi.
- DeepL, "DeepL unveils real-time spoken translation, breaking the next language barrier with Voice-to-Voice", PR Newswire, Kolonia, 16 kwietnia 2026 — ponad 40 języków, cztery powierzchnie produktu i ślepa ocena Slatora zamówiona przez DeepL.
- The Next Web, "DeepL launches real-time voice-to-voice translation in 40+ languages", 17 kwietnia 2026 — opóźnienie dema w Seulu i ograniczenie szyku zdania.
- DeepL, strona produktu i FAQ DeepL Voice for Online Meetings, sprawdzone 31 sierpnia 2026 — sformułowanie o przechowywaniu danych, wyniki Slatora oraz informacja, że tryb mowa-na-mowę dla spotkań online jest wciąż wdrażany.
- Centrum pomocy DeepL, DeepL Voice languages, sprawdzone 31 sierpnia 2026 — rozdział na języki mówione i języki tłumaczenia.
- AI4Bharat, Orthographically-Informed Word Error Rate — metryka użyta dla zestawów hindi.
- Pokrycie językowe Nova-3 od Deepgram zestawione w naszym tekście analiza ekspansji językowej w rozpoznawaniu mowy, 31 sierpnia 2026.