Cztery modele frontier w trzy dni, a nikt nie powie ci, którego potrzebowałeś
Między 1 a 3 września 2026 roku Anthropic, Meta, Google i OpenAI wypuściły modele frontier, a CNBC nadała powstałemu wyczerpaniu nazwę: zmęczenie modelami. Liczba premier to nudna część. Ciekawa jest ta, że każda premiera tworzy ewaluację, którą ktoś niżej w łańcuchu musi przeprowadzić, a firmy je wypuszczające nie mają żadnego powodu, żeby pomóc ci ją ominąć. Ile naprawdę kosztuje zmiana modelu, dlaczego taniej za token nie znaczy taniej za zadanie i dlaczego w pełni zarządzane oprogramowanie zbudowane do jednej wąskiej roboty to jedyny układ, w którym decyzję może podjąć ktoś inny.
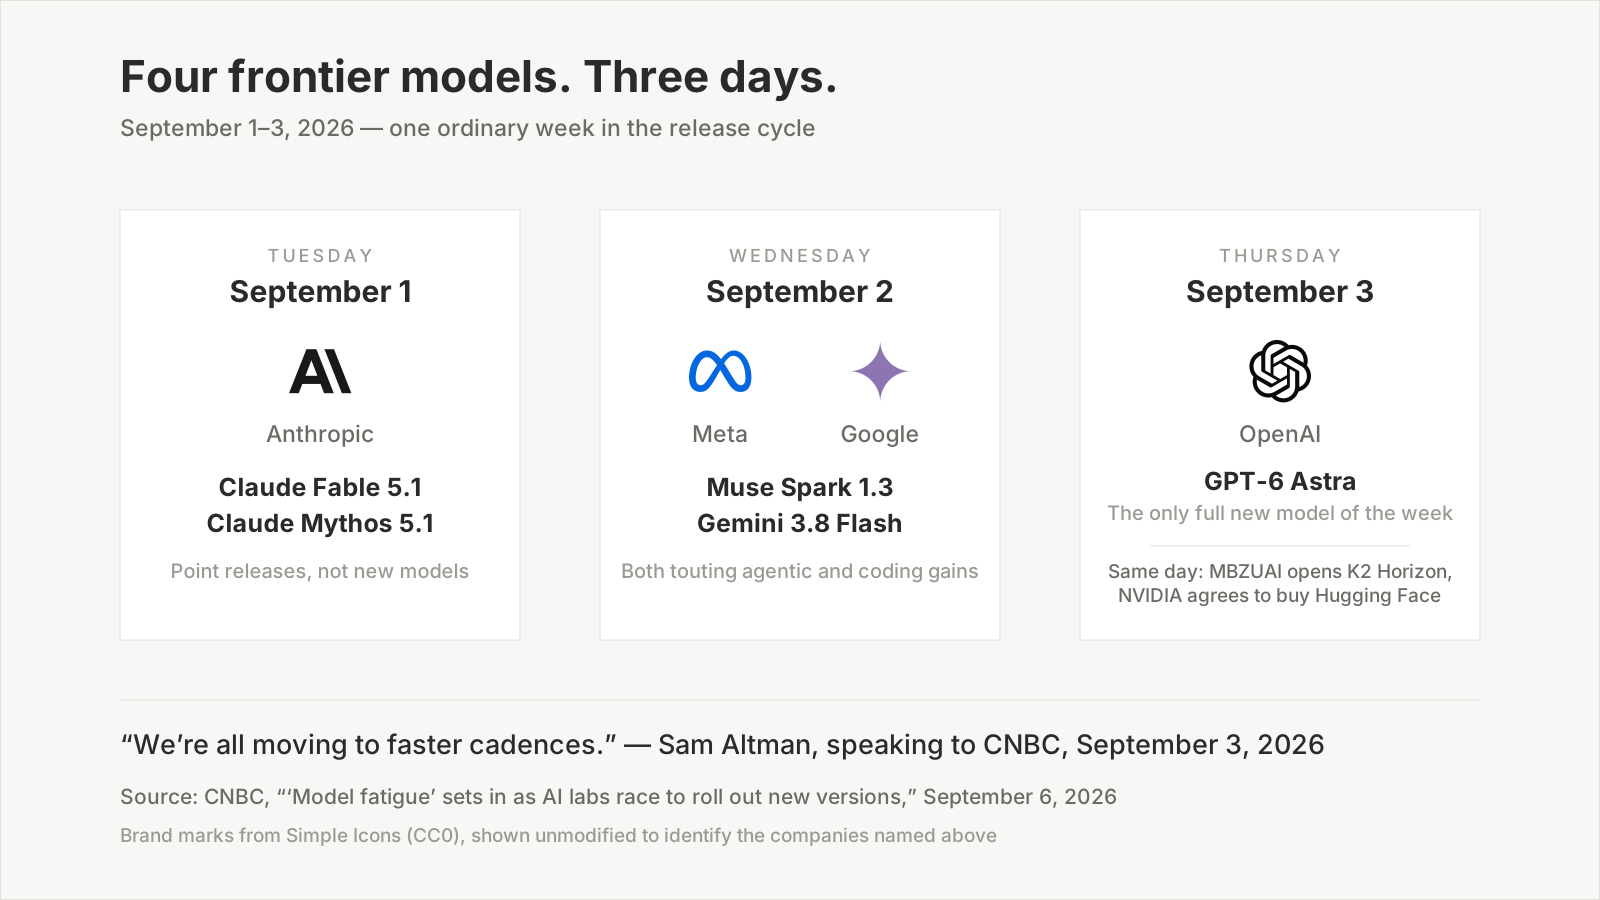
Znaki marek pochodzą z Simple Icons (CC0) i zostały pokazane bez modyfikacji, aby zidentyfikować wymienione firmy. Daty premier i cytat Altmana za CNBC, 6 września 2026.
Między wtorkiem a czwartkiem pierwszego tygodnia września 2026 roku Anthropic wypuścił Claude Fable 5.1 i Claude Mythos 5.1, Meta wypuściła Muse Spark 1.3, Google wypuściło Gemini 3.8 Flash, a OpenAI wypuściło GPT-6 Astra. W ten sam czwartek Mohamed bin Zayed University of Artificial Intelligence w Abu Zabi udostępnił światu rodzinę K2 Horizon, a NVIDIA zgodziła się kupić Hugging Face za 12 930 300 000 dolarów.
Sześć ogłoszeń. Trzy dni. CNBC opublikowała tekst w niedzielę 6 września pod hasłem, które od tygodni krążyło wśród praktyków: zmęczenie modelami.
Oczywista lektura brzmi tak: branża porusza się szybciej, niż ktokolwiek jest w stanie nadążyć. Ta lektura jest prawdziwa i w większości nieciekawa. Oto część warta twojej uwagi: każda premiera przenosi koszt, a przeniesienie biegnie dokładnie w jedną stronę. Każdy model, który wypuszcza laboratorium, staje się ewaluacją, którą ktoś niżej w łańcuchu musi przeprowadzić — i nikt wyżej nie ma najmniejszego powodu, żeby pomóc ci ją ominąć.
TL;DR
- Cztery premiery modeli frontier w trzy dni (1–3 września 2026); 6 września CNBC nazwała powstałe wyczerpanie „zmęczeniem modelami”.
- Prawdziwym kosztem nie jest uwaga, tylko praca ewaluacyjna. Prezes pewnej firmy z branży AI powiedział CNBC, że gdy jego zespół chce ocenić 10 modeli pod zadanie, testuje około 5.
- Cena za token to kiepski wskaźnik zastępczy kosztu zadania — mocniejszy i droższy model potrafi skończyć trudniejszą robotę taniej, bo robi mniej kroków.
- Dostawcy modeli strukturalnie nie są zainteresowani mówieniem ci, kiedy wystarczyłby tańszy model. Ta luka to cały powód istnienia zarządzanego, wyspecjalizowanego oprogramowania.
6 września zmęczenie modelami dostało nazwę
„Mam wrażenie, że zmęczenie modelami to rzecz jak najbardziej realna” — powiedział CNBC Zhen Lu, prezes Runpod, startupu infrastruktury AI. „Nie zrozumcie mnie źle, jestem ogromnie podekscytowany całą innowacją, która się dzieje, ale naprawdę uważam, że jesteśmy w środowisku, w którym jest tyle piany, że trzeba robić hałas”.
W tym samym tygodniu Sam Altman zaproponował CNBC łagodniejsze ujęcie: „wszyscy przechodzimy na szybsze kadencje” — powiedział, przypisując część przyspieszenia temu, że wszyscy wrócili „z wakacji”.
Obie rzeczy mogą być prawdziwe. Kadencja faktycznie przyspiesza, a przyspieszenie faktycznie po części jest teatrem. Ahmed Abbasi, profesor Mendoza School of Business w Notre Dame z 25 latami w AI, wyłożył logikę handlową wprost: laboratoria „wszystkie grają w grę o udział w portfelu”. Anthropic i OpenAI naciskają najmocniej, zmierzając na giełdę, a prywatni inwestorzy wyceniają już każdą z nich blisko 1 biliona dolarów.
Portfel, o którym mowa, jest ogromny. Gartner prognozował w maju 2026 roku, że światowe wydatki na AI sięgną w tym roku 2,59 biliona dolarów, czyli o 47% więcej niż w 2025. Największą część zabiera infrastruktura, ale znacznie ponad 1 bilion dolarów trafia do usług, oprogramowania, bezpieczeństwa, modeli i narzędzi — czyli do decyzji, które ktoś musi podjąć.
Oto sedno: rynek tej wielkości, rosnący w tym tempie, nagradza głośność. Nie nagradza mówienia klientom, że poradziliby sobie mniejszym.
Kosztem nie jest uwaga. Kosztem jest ewaluacja, której nie kończysz
Zapytaj praktyka, jak zmęczenie modelami czuje się naprawdę, a nie usłyszysz „czytam za dużo wpisów premierowych”. Usłyszysz arytmetykę.
Suresh Vasudevan, prezes Clockwork Systems, startupu AI dla przedsiębiorstw, podał CNBC najużyteczniejszą liczbę w całym tekście. Jeśli jego firma chce ocenić 10 modeli AI pod konkretne zadanie, powiedział, może po prostu wybrać pięć. „Naprawdę trudno jest pójść i ocenić każdy z tych, które teraz wychodzą”.
Zatrzymaj się na chwilę przy tej proporcji, bo to nośny fakt całego tematu. Firma, której biznesem jest AI dla przedsiębiorstw, z ludźmi robiącymi to zawodowo, z budżetem obliczeniowym przydzielonym dokładnie na ten cel, ocenia połowę kandydatów, których sama uważa za wartych oceny.
Nazwijmy tę drugą połowę niesprawdzoną piątką. Nie zostali odrzuceni. Nikt nie uznał ich za niewystarczających. Po prostu nigdy ich nie uruchomiono — i dlatego pytanie, czy któryś z nich byłby szybszy, tańszy albo dokładniejszy na twoim konkretnym obciążeniu, zostaje otwarte na zawsze. Każdy tydzień premier dokłada do tej sterty.
A przerobienie sterty jest drogie, bo zmiana modelu to nie podbicie wersji. To rekwalifikacja. Oto co naprawdę musi się wydarzyć, zanim nowy model trafi na produkcję:
| Co trzeba sprawdzić od nowa | Dlaczego nowy model to psuje |
|---|---|
| Prompty i instrukcje systemowe | Dostrojone do przyzwyczajeń starego modelu; sformułowanie, które jeden model prowadziło niezawodnie, drugi może poprowadzić gdzie indziej |
| Stabilność formatu wyjścia | Parsery po drugiej stronie zależą od kształtu — JSON, nagłówki, separatory — a nawyki formatowania zmieniają się między modelami |
| Dokładność na twoich prawdziwych danych | Różnice w benchmarkach mierzy się na publicznych zbiorach, nie na twoich spotkaniach, twoich zgłoszeniach, twoim kodzie |
| Zachowanie narzędzi i API | Modele agentowe różnią się tym, kiedy wywołują, jak często ponawiają i co robią, gdy wywołanie zawiedzie |
| Opóźnienie i przepustowość pod obciążeniem | Model szybszy przy pojedynczym żądaniu potrafi być wolniejszy za twoimi limitami przepustowości |
| Całkowity koszt przy twoim wolumenie | Cena za token razy zużyte tokeny razy liczba prób — patrz niżej |
| Bezpieczeństwo i zachowanie przy odmowach | Granice przesuwają się między wersjami w obie strony |
| Przypadki regresji | Dokładnie te awarie, które już naprawiłeś, a o których żaden cudzy benchmark nie wie |
Osiem kategorii, każda wymagająca prawdziwych przykładów, przebiegu porównawczego i czyjegoś osądu. To projekt, nie zmiana konfiguracji. Pomnóż to przez liczbę premier frontier w dowolnym miesiącu, a powód proporcji 10 do 5 staje się oczywisty.
Napisaliśmy osobny tekst o tym, jak mierzyć to na własnym obciążeniu zamiast ufać rankingowi, a uczciwe podsumowanie brzmi: zrobienie tego porządnie zajmuje dni, nie godziny.
Taniej za token to nie taniej za zadanie
Najbardziej sprzeczne z intuicją odkrycie w całej tej historii przyszło nie z laboratorium, lecz od inżyniera, który próbował zautomatyzować wybór.
Moe Khalil, inżynier produktu w otwartoźródłowej bramce AI LiteLLM, opublikował 4 września wpis zatytułowany „Model Fatigue is Real”. Pracuje nad autorouterem LiteLLM — oprogramowaniem, którego całą robotą jest wybieranie modelu za ciebie — i ujawnił tę afiliację na samym początku, co jest więcej, niż robi większość piszących o tym temacie.
Wyjściowe założenie jego zespołu było intuicyjne. Weź dwa modele, które oba potrafią rozwiązać zadanie; ten, który według karty modelu kosztuje o połowę mniej za token, powinien rozwiązać je za mniej więcej połowę ceny.
Testy pokazały co innego. Mocniejszy, droższy model rozwiązywał trudniejsze zadania za ułamek kosztu tańszego. Wyjaśnienie Khalila: „Ponieważ był mądrzejszy, obierał mądrzejsze podejście i docierał do gotowego produktu znacznie szybciej”.
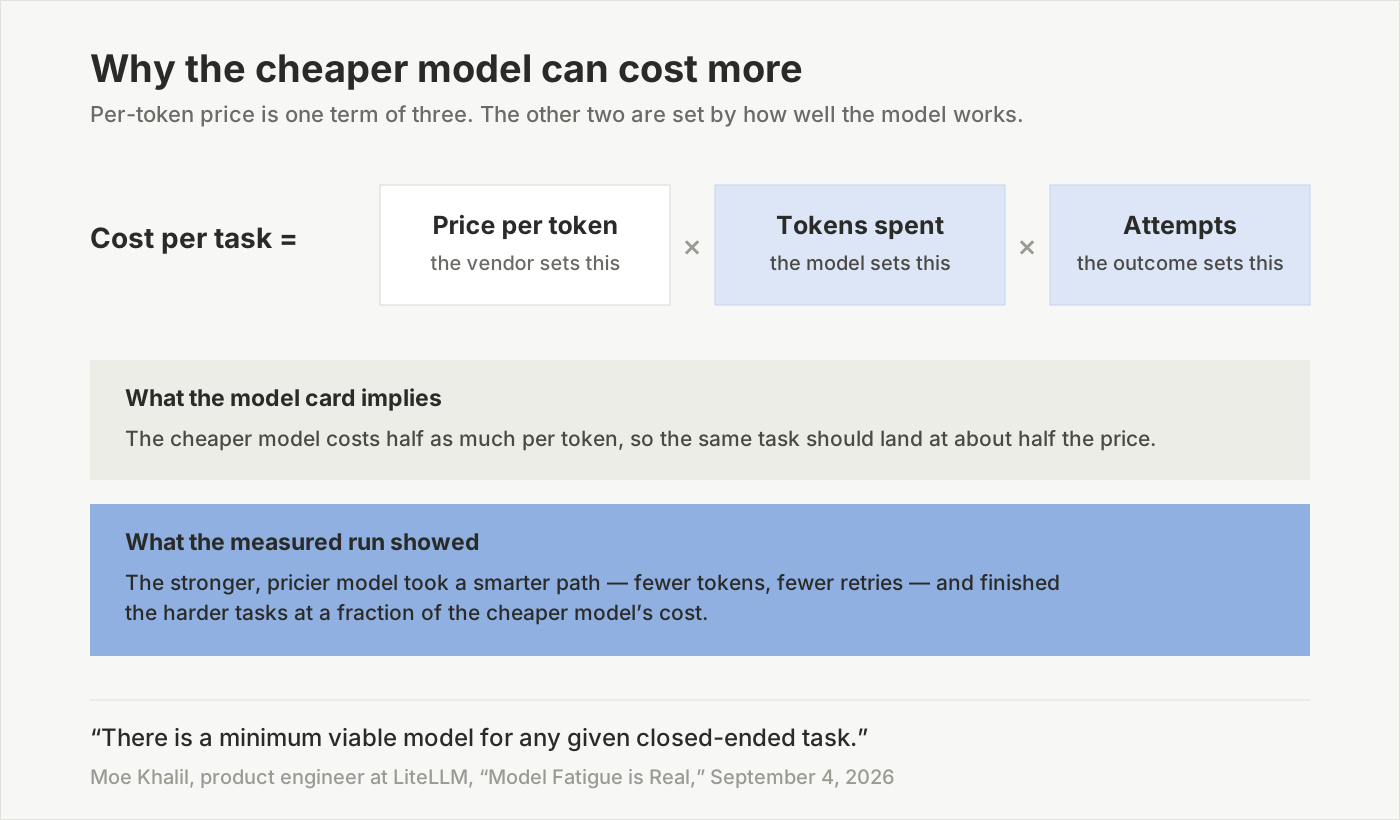
Z trzech czynników tylko cena za token pojawia się na stronie cennika. Dwa pozostałe to właściwości kompetencji modelu i ujawniają się dopiero wtedy, gdy uruchomisz prawdziwą robotę.
To całkowicie przestawia sens strony cennika. Liczba, którą reklamuje dostawca, jest jednym z trzech czynników iloczynu: cena za token, zużyte tokeny i liczba prób do faktycznego sukcesu zadania. Pierwszy ustala dostawca. Drugi i trzeci ustala sam model i żadnego z nich nie da się poznać, zanim nie przepuścisz przez niego własnej pracy.
Co oznacza, że porównanie, którego cię nauczono — przelecieć wzrokiem kolumnę cen, wziąć tanie — nie jest jedynie niepełne. Przy prawdziwych zadaniach potrafi wskazywać w złą stronę.
Wyżej w łańcuchu nikt nie ma bodźca, żeby ci powiedzieć
Khalil mówi potem to, co zwykle się przemilcza, i jest to najostrzejsze zdanie napisane o tej sprawie w tym roku:
„Dla firm modelowych to lenistwo jest funkcją, a nie błędem. Wolą, żebym używał [modelu z najwyższej półki] do streszczania mojej poczty, i nie mają żadnego bodźca, żeby mi powiedzieć, kiedy tańszy model zadziałałby równie dobrze. Ich robotą jest dalej przesuwać granicę. Ustalenie, kiedy granicy używać nie należy, zostawiono mnie”.
Przeczytaj to jeszcze raz z liczbą Gartnera w głowie. Rynek wart 2,59 biliona dolarów, rosnący 47% rocznie, w którym dostawcy zyskują na każdym kliencie sięgającym domyślnie wyżej i nie ponoszą żadnego kosztu, gdy klienci przepłacają.
To nie spisek i nie wymaga, żeby ktokolwiek zachowywał się źle. Tak po prostu wygląda gradient bodźców. Robotą laboratorium frontier jest przesuwać granicę. Powiedzenie ci, że zeszłoroczny model ze średniej półki obsłuży 80% twojego obciążenia, jest robotą kogoś innego, a do niedawna nie było robotą nikogo.
Druga obserwacja Abbasiego też należy do tego miejsca. Zasugerował, że to „nie przypadek”, iż wszyscy więksi deweloperzy ogłosili premiery w tym samym tygodniu, a Noah Faro, szef technologii w AI-owym fintechu Farsight, zgodził się, zauważając, że rywale częściowo odczytują swoje plany z dostępności mocy obliczeniowej w chmurze, bo wszyscy konkurują o pojemność u tej samej garstki dostawców. Faro dorzucił też uwagę studzącą zapał: w odróżnieniu od GPT-6 Astra premiery Anthropic, Mety i Google'a z tamtego tygodnia były wydaniami cząstkowymi, ulepszeniami istniejących modeli, a nie nowymi modelami. W jego ocenie dwie ostatnie premiery, które naprawdę ruszyły wskazówkę, to Fable 5 od Anthropic w czerwcu i Kimi K3 od Moonshot AI w lipcu.
Czyli: sześć ogłoszeń, jeden autentycznie nowy model frontier i pełen cykl ewaluacyjny pracy wygenerowany dla wszystkich niżej w łańcuchu.
Dwa sposoby, na jakie branża to wchłania, i nie są takie same
Jeśli laboratoria nie podejmą decyzji, ktoś musi. Wyłoniły się dwie odpowiedzi i są strukturalnie różne.
Odpowiedź pozioma to routing. Bramki takie jak LiteLLM ustawiają wszystkie modele za jednym kluczem API i próbują wybierać przy każdym żądaniu. Khalil opisuje problem techniczny precyzyjnie: dla każdego zadania zamkniętego istnieje minimalny wystarczający model — najtańszy, który jeszcze daje radę — a trudność polega na przewidzeniu, który to, zanim zadanie ruszy. Najlepsze obecne podejście jego zespołu wnioskuje to z publicznych danych benchmarkowych plus heurystyk w promptcie; próbowali też klasyfikacji przez LLM i rozwiązań hybrydowych. Jego własny werdykt: „Wszystko wciąż niedoskonałe, ale o szczebel lepsze niż nic”.
Routing to prawdziwa inżynieria i pomaga. Ale zauważ, co przesuwa, a czego nie. Wchłania hydraulikę: jeden klucz, jeden interfejs, automatyczny dostęp do nowych modeli. Nie wchłania odpowiedzialności. Gdy router wybierze źle, zły wynik nadal jest twój, w twoim produkcie, przed twoim użytkownikiem. Ocena tego, czy odpowiedź była dobra, wciąż należy do ciebie.
Odpowiedź pionowa to w pełni zarządzane oprogramowanie zbudowane do jednej roboty. Tutaj dostawca nie routuje między modelami w twoim imieniu; zabiera ci całe zadanie z rąk i dostarcza gotowy wynik. Nie widzisz nazwy modelu. Widzisz transkrypcję, streszczenie, tłumaczenie, złożony wniosek o zwrot kosztów.
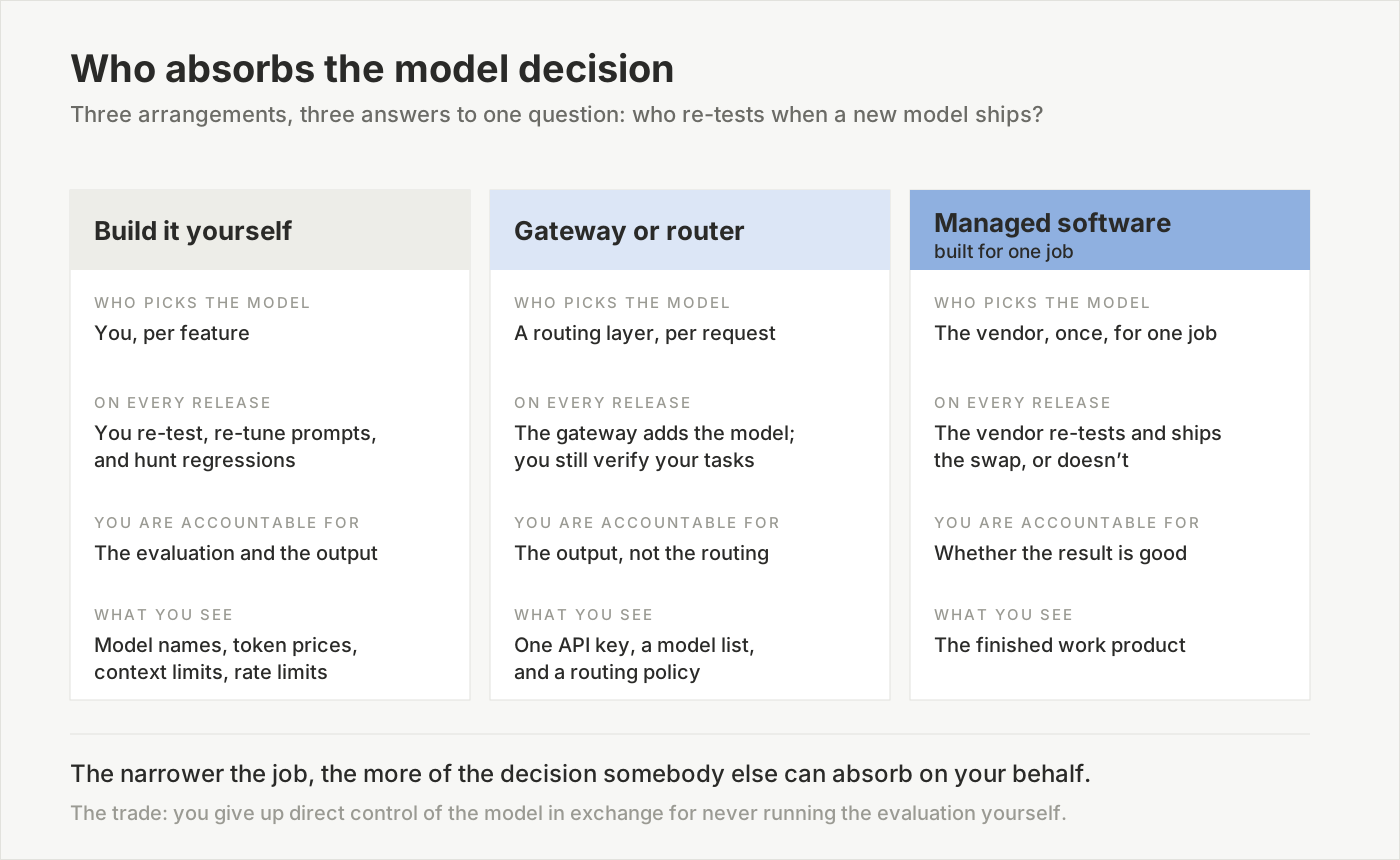
Im dalej w prawo, tym mniej decyzji zostaje przy tobie — i tym bardziej zależysz od tego, czy dostawca przeprowadził ewaluację uczciwie.
Społeczność lokalnego AI doszła do podobnego wniosku z przeciwnej strony. Opublikowana w tym roku analiza opisała scenę małych modeli jako bieżnię: pobierz, skonfiguruj, odpal kilka promptów, oceń połowicznie, przejdź do następnej premiery. Rekomendacja brzmiała: przestać — ustandaryzować się na jednym sprawdzonym zestawie do codziennej pracy i przyjmować nowy model dopiero po przetestowaniu go wystarczająco długo na prawdziwych, reprezentatywnych zadaniach, by potwierdzić, że jest naprawdę lepszy dla twojego konkretnego obciążenia. Ten sam wniosek, do którego doszli hobbysta z dwiema kartami GPU i prezes z budżetem obliczeniowym: wybrać raz, porządnie, i przestać rozgrzebywać to w każdy czwartek.
Dlaczego to wąskość roboty sprawia, że decyzję da się wchłonąć
Oto nasze stanowisko i zarazem powód, dla którego ta kategoria w ogóle istnieje.
Decyzję o modelu może podjąć wyłącznie ktoś, kto zna zadanie. Brzmi banalnie. Nie jest, bo wyklucza to prawie wszystkich.
Ogólnego przeznaczenia interfejs czatu nie może zdecydować za ciebie, bo dowolnego ranka może zostać poproszony o napisanie sonetu, zdebugowanie wyścigu wątków albo streszczenie umowy najmu. Dla „czegokolwiek, co użytkownik wpisze za chwilę” nie istnieje minimalny wystarczający model. Jedynym bezpiecznym ustawieniem domyślnym jest najmocniejszy dostępny model — dokładnie to ustawienie, które służy interesom dostawcy, i dokładnie to, od którego, jak mówi Khalil, nikt nie ma bodźca cię odwodzić.
Bramka potrafi zgadnąć lepiej, bo widzi prompt. Ale widzi go bez wiedzy o tym, jak w twojej dziedzinie wygląda dobra odpowiedź, i bez konsekwencji, gdy się pomyli.
Wyspecjalizowane zarządzane oprogramowanie zajmuje zupełnie inną pozycję. Gdy robota jest ustalona — przepisać 60-minutowe spotkanie z czterema mówcami przełączającymi się między polskim a angielskim, a potem wygenerować listę zadań — zadanie jest zamknięte dokładnie w sensie Khalila. Istnieje dla niego minimalny wystarczający model. I, co decydujące, jest to ten sam minimalny wystarczający model dla każdego klienta z tą robotą, co znaczy, że ewaluację trzeba przeprowadzić raz, a jej koszt rozkłada się na wszystkich.
To cały argument ekonomiczny tej kategorii i warto zapisać go jako regułę: im węższa robota, tym większą część decyzji o modelu ktoś inny może wchłonąć za ciebie. Dostawca obsługujący jedno obciążenie może sobie pozwolić na przetestowanie wszystkich 10 kandydatów, bo testuje ich raz, dla tysięcy klientów, wobec ustalonej definicji dobrego wyniku. To, że ty testujesz pięciu, dla siebie samego, wobec definicji, którą musisz dopiero wymyślić, jest drogim sposobem na gorszą odpowiedź.
Wymiana jest realna i zasługuje na uczciwe nazwanie. Oddajesz bezpośrednią kontrolę nad tym, który model wykonuje twoją pracę. W zamian przestajesz prowadzić ewaluację, przestajesz śledzić kalendarze premier, a przedmiotem oceny staje się wynik — jedyna rzecz, na której naprawdę ci zależało.
Jak rozpoznać, który układ kupujesz
Przed następnym zakupem AI cztery pytania po kolei:
- Czy robota jest zamknięta? Umiesz w jednym zdaniu powiedzieć, jak wygląda poprawny wynik? Jeśli tak, zarządzane narzędzie wertykalne może przejąć decyzję. Jeśli odpowiedź brzmi „zależy, o co zapytamy”, kupujesz model ogólny, a ewaluacja zostaje przy tobie.
- Kto testuje ponownie, gdy wychodzi nowy model? Zapytaj dostawcę wprost. Zarządzany dostawca powinien umieć opisać swój zestaw ewaluacyjny i proces podmiany. Jeśli odpowiedź brzmi, że dostaniesz „dostęp do najnowszych modeli”, kupiłeś hydraulikę, a nie osąd.
- Co ci się pokazuje — model czy wynik? Jeśli produkt wystawia nazwy modeli, okna kontekstu i ceny za token, oddaje decyzję z powrotem tobie. To prawomocny produkt, ale wyceń go odpowiednio.
- Jak wygląda koszt całkowity przy twoim wolumenie? Cena za token razy tokeny faktycznie zużyte na twojej pracy razy liczba prób do skutku. Uruchom własne zadania. Strona cennika nie odpowie na to pytanie.
Podsumowanie: granica to ustawienie domyślne, nie decyzja
Zmęczenie modelami opisuje się zwykle jako problem uwagi — za dużo wiadomości, za szybko. Nie jest. To koszt, który najszybciej rosnący rynek w technologii po cichu przesunął na swoich klientów, gdzie leży nieopłacony i w dużej mierze niezmierzony.
Laboratoria będą wypuszczać dalej, bo wypuszczanie to ich robota, a rynek za to płaci. Ciężar ewaluacji będzie dalej rósł, bo rośnie mechanicznie z każdą premierą. A większość zespołów będzie to rozstrzygać jedynym sposobem, jaki ma zajęty zespół: sięgając po najnowszy, największy i najdroższy model — jedyną opcję, której nikt nie musi bronić na spotkaniu.
Każde oprogramowanie, które zabiera ci robotę w całości i nigdy nie pokazuje nazwy modelu, jest zakładem o to, że tak prowadzić firmy nie warto. Zakład wygląda lepiej z każdym tygodniem premier.
Gdzie w tym Telli.sh: to kategoria, w której budujemy. Telli.sh nagrywa spotkania, rozdziela mówców, tłumaczy w czasie rzeczywistym między 15 językami i tworzy streszczenia oraz listy zadań — i nigdy nie pyta, którego modelu użyć, bo to nasza robota, nie twoja. Nasze rozszerzenie do przeglądarki owszem oferuje dziewięć silników tłumaczeniowych, w tym opcję w pełni na urządzeniu, dla tych, którzy naprawdę chcą takiej kontroli; produkt do spotkań celowo tego nie robi, bo „dobrze przepisać to spotkanie” jest zadaniem zamkniętym, a my wolimy być oceniani po transkrypcji niż po modelu, który za nią stoi.
Nagraj następne spotkanie i pozwól, żeby model wybrał ktoś inny
Źródła
- CNBC, „'Model fatigue' sets in as AI labs race to roll out new versions at dizzying pace”, 6 września 2026 — chronologia premier z 1–3 września 2026; cytat Zhen Lu o tym, że „zmęczenie modelami to rzecz realna”; uwaga Sama Altmana o „szybszych kadencjach”; Ahmed Abbasi o „grze o udział w portfelu” i prywatnych wycenach bliskich 1 bilionowi dolarów; Noah Faro o wydaniach cząstkowych oraz o Fable 5 i Kimi K3 jako dwóch ostatnich, które ruszyły wskazówkę; i liczba Suresha Vasudevana: pięć ocenionych modeli z dziesięciu. Współpraca reporterska: Kate Rooney i MacKenzie Sigalos; pobrano 8 września 2026
- Moe Khalil, „Model Fatigue is Real”, 4 września 2026 — argument o „braku bodźca, żeby mi powiedzieć, kiedy zadziałałby tańszy model”; rama minimalnego wystarczającego modelu dla zadań zamkniętych; oraz zmierzony wynik, że mocniejszy, droższy model rozwiązywał trudniejsze zadania za ułamek kosztu tańszego. Khalil ujawnił we wpisie, że jest inżynierem produktu w LiteLLM, które buduje autorouter; pobrano 8 września 2026
- Gartner, „Gartner Forecasts Worldwide AI Spending to Grow 47% in 2026”, 19 maja 2026 — światowe wydatki na AI w wysokości 2,59 biliona dolarów w 2026 roku, o 47% więcej rok do roku, z infrastrukturą AI jako największym segmentem
- MindStudio, „Local AI Model Fatigue: Why One Setup Beats Chasing Every Release” — opis cyklu premier lokalnych małych modeli jako bieżni i argumentacja za ustandaryzowaniem się na jednym sprawdzonym zestawie do codziennej pracy
- AI타임스, „[9월7일] '일주일에 4개나 출시'...커지는 '모델 피로감'”, 7 września 2026 — koreańskojęzyczna relacja, która rozniosła tekst CNBC i towarzyszące mu komentarze deweloperów
- Nasze odczytanie przejęcia Hugging Face przez NVIDIĘ — drugie ogłoszenie tego samego tygodnia i warstwa dystrybucji pod każdym wymienionym tu modelem
- Jak mierzyć dokładność transkrypcji na własnym obciążeniu — ile kosztuje prawdziwa ewaluacja, gdy przeprowadzić ją porządnie