同じ10.0%のエラー率、正反対の判断 — 会議文字起こしの精度を測る手順
単語誤り率は「not」という語と「the」という冠詞をまったく同じ重みで採点します。だからこそ、2本の文字起こしがそろって10.0%になり、そのうち片方しか使い物にならないという事態が起きます。会議の仕様に合わせた12分のテスト音声、正規化ルールを固定した参照文字起こし、cpWERとDERの具体的なコマンド、そして生のWERに100点中10点しか与えない5項目のスコアカード。測定手順のすべてをまとめました。
プロダクト会議で出た20語の一文を、機械が文字起こしした2つの結果です。
A — "Priya said Helios migration slips to Q3 and we should not sign the vendor contract before security review"(プリヤいわく、Helios の移行は第3四半期にずれ込み、セキュリティレビュー前にベンダー契約に署名してはいけない)
B — "Priya said the Helios migration slips to Q2 and we should sign the vendor contract before the security review"(プリヤいわく、Helios の移行は第2四半期にずれ込み、セキュリティレビュー前にベンダー契約に署名すべきだ)
実際に話された内容と比べると、どちらもエラーはちょうど2つずつです。そしてどちらも単語誤り率 10.0% を記録します。文字起こしAは冠詞 "the" を2回落としました。文字起こしBは締め切りを1四半期前倒しし、約束から "not" という語を削除しました。
この2つのシステムを同点だと判定する評価プロセスなら、問題はモデルではなくプロセスの側にあります。
この記事は、「金曜までに文字起こしツールを1つ選んでおいて」と言われた人にそのまま渡せる測定手順です。単語誤り率が正確に何を数えているのか。なぜその数値が会議音声にかぎって人を欺くのか。そして、オープンソースのパッケージ2つと12分の録音があれば午後いっぱいで回せる5ステップのプロトコル。文字起こしの精度はそもそも成果物ではなかったという主張は別の記事で展開しました。こちらはその対になる記事で、主張ではなく方法です。
要約:
- WERは
(substitutions + deletions + insertions) ÷ reference wordsであり、すべての単語が同じ重みを持ちます。否定の "not" と冠詞の "the" が同じ値段です。- 公開リーダーボードはすでに圧縮されています。2026年8月31日に参照したArtificial Analysisの独立評価では、上位5モデルがAA-WER 1.7%から2.6%の間に収まっています。勝者を選ぶには狭すぎる幅です。
- 代わりに5つの項目を重み付きで採点してください。要となる語に30点、話者の帰属に25点、数値と金額に20点、区切りに15点、生のWERに10点。難しい項目のツールはすでに存在します。
cpWERとDERは、CHiMEチャレンジのために作られたMeetEvalに同梱されています。
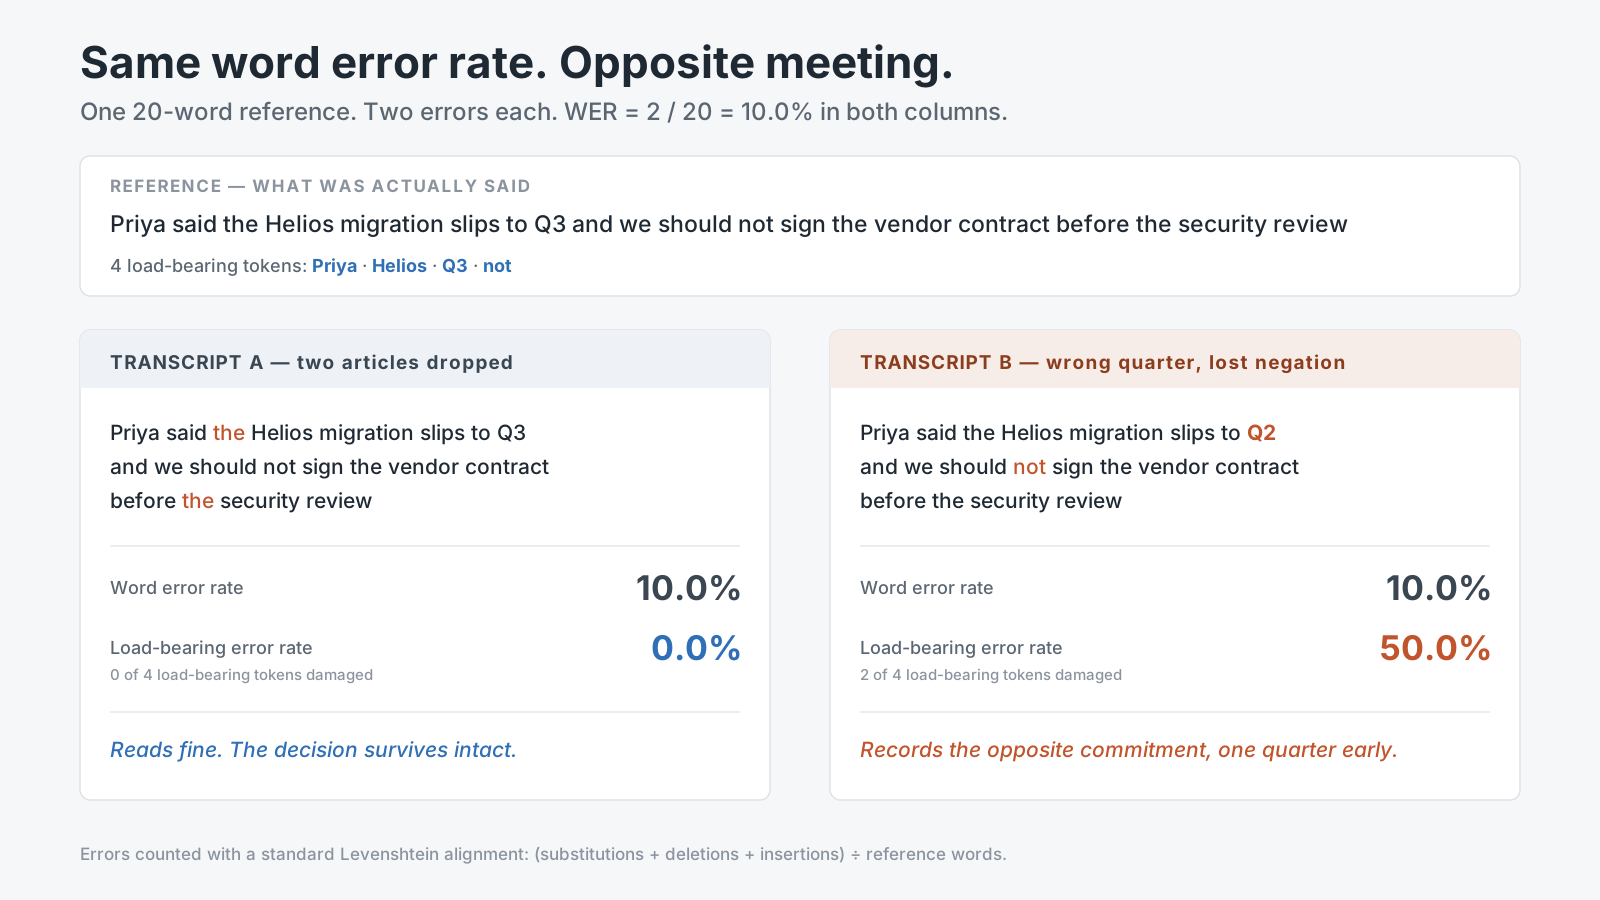
どちらの列も、20語の参照文字起こしに対してエラーは2つです。しかし、会議室で実際に下された判断を記録に残しているのは片方だけです。
単語誤り率が数えているものを、省略せずに書き出す
WERはたった1つのアライメントから出てきます。人間が「こう話された」と合意した参照文字起こしを用意し、機械の出力を用意します。古典的なレーベンシュタイン・アライメントで、一方をもう一方に変換する最も安い編集列を求め、それぞれの編集にラベルを付けます。
- モデルが別の語を書いたなら 置換 substitution です。"deploy" を "delay" と聞き取った場合ですね。
- 参照側の語が出力のどこにも対応しないなら 削除 deletion です。
- 誰も言っていない語をモデルが生み出したなら 挿入 insertion です。
そのうえで、こう計算します。
WER = (substitutions + deletions + insertions) ÷ reference words
分母は仮説の長さではなく参照の長さです。WERが100%を超えうるのはこのためで、自由に幻覚を起こすモデルは、もともと存在した語数を上回る挿入を積み上げられます。
計算を公開済みの出力と突き合わせられるよう、MeetEval自身のドキュメントに載っている例をそのまま使います。参照は "The quick brown fox jumps over the lazy dog" で9語。仮説は "The kwick brown fox jump over lazy" で7語。アライメントは置換2つ(quick→kwick、jumps→jump)と削除2つ(the、dog)を見つけ、挿入はありません。つまり (2 + 2 + 0) ÷ 9 = 0.4444、WERは 44.4% で、MeetEvalはまさにこう出力します。ErrorRate(error_rate=0.4444…, errors=4, length=9, insertions=0, deletions=2, substitutions=2)
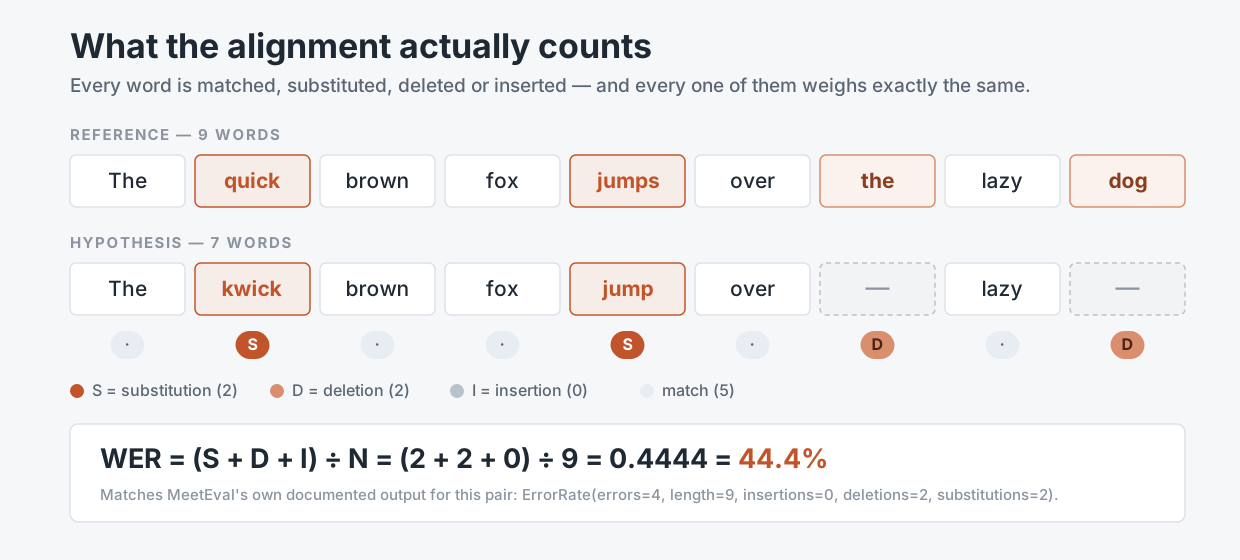
アライメントは機械的で再現可能です。ただし重み付けはされていません。出典: MeetEvalドキュメント、2026年8月31日参照。
この式には、ベンダーのランディングページに書かれたどんな文言よりも重要な性質が2つあります。第一に、この指標は フラット です。ある語が会議を支え、別の語は文法だけを担っているという概念そのものを持ちません。第二に、この指標は 話者を見ていません。標準的なWERはすべての発話を1本の流れに連結するため、語をすべて完璧に書き取りながらその半分を別人に割り当てたシステムでも、非の打ちどころのないスコアを出せます。
公開された数値では、もう候補を切り分けられない
リーダーボードを開くと、問題が算数として現れます。ベンダーの主張を転載せず自前で評価を回しているArtificial Analysisは、2026年8月31日時点のAA-WER上位5モデルをこう挙げています。Fun-Realtime-ASR-previewが1.7%、ElevenLabs Scribe v2が2.2%、マイクロソフトのMAI-Transcribe-1.5が2.4%、Smallest AI Pulse Proが2.4%、Gemini 3.5 Transcribeが2.6%。オープンウェイト最強のミストラルのVoxtral Smallは2.8%です。
市場の上位はすべて1.1ポイントの帯に収まっています。 発話語数がおよそ6,300語の45分の会議で、1位と5位の差はおよそ57語。文字起こし1画面あたり1語に満たない差です。
もう1つ問題があります。ベンチマークの音声は、あなたの音声ではないということです。AA-WER v2は3つの出典から集めたおよそ8時間分を、音声長で重み付けして平均した値です。内訳はAA-AgentTalkが50%、VoxPopuli-Cleaned-AAが25%、Earnings22-Cleaned-AAが25%。議会演説と決算説明会は録音状態がよく、順番に話され、社内会議を定義づけるあの要素をほとんど含みません。当事者しか知らないプロジェクトについて4人が互いの発言を遮り合う、あの状況です。
本当に会話的な音声を扱う研究は、これを何年も前から別分野として扱ってきました。2020年4月20日に渡辺、マンデル、バーカーと18名の共著者が発表したCHiME-6チャレンジは、評価の土台をディナーパーティの録音に置きました。発話が重なり、マイクが遠い自然な会話は、朗読音声で高得点を取るシステムを壊すからです。近接マイクのヘッドセットと遠方の室内マイクの両方で100時間を収録したAMI Meeting Corpusも、同じ理由で存在します。
ここが要点で、言葉を濁さずに書きます。公開されたWERは、そのベンダーのモデルが壊れていないことを教えてくれます。どのベンダーを買うべきかは教えてくれません。
WERが捉えるものと、構造的に捉えられないもの
| 失敗のかたち | 生のWERは捉えるか | 何を失うか | 実際に測る方法 |
|---|---|---|---|
| ありふれた語の聞き違い("their"/"there") | 捉える、満額の重みで | ほぼ何も失わない | WER |
| フィラーや言い直しの脱落 | 捉える、削除として計上 | 何も失わない — むしろ改善であることが多い | WER、ただし誤解を招くかたちで |
| 固有名詞の崩壊("Xochitl" → "Societal") | 捉える、ただし1語分の重みで | 責任者の名前 | 要となる語のエラー率 |
| 数値や日付の誤り("Q3" → "Q2") | 捉える、1語分の重みで | 守れなかった締め切り | 数値の正確さ、別枠で採点 |
| 否定語の削除("should not" → "should") | 捉える、1語分の重みで | 反転した判断 | 要となる語のエラー率 |
| 語は正しいが話者が違う | 捉えない — WERは話者を見ない | 誰が約束したのか誰も分からない | cpWER、DER |
| 話者の交替が1つの塊に潰れる | 捉えない | 読めない文字の壁 | collarを付けたtcpWER、人による通読 |
| 文の境界が消える | 捉えない — 句読点は正規化で除去される | 構造を推測しにいく要約 | 区切りのスコア、人による通読 |
| 無音区間で段落まるごと幻覚する | 部分的に — 挿入として | 作り話が記録として残る | WERに加えて挿入数を単独で確認 |
文字起こしが使える議事録になるかどうかを決めているのは、この表の下半分です。そして標準のWERはそのどれも見ていません。これは指標の欠陥ではありません。WERは1990年代の口述筆記研究が立てた問いに正確に答えています。欠陥は、2026年にそれだけを使うことのほうにあります。
ステップ1: 本物の会議のように振る舞う12分のクリップを作る
ベンダーのデモ音声で評価しないでください。かといって自社アーカイブの8時間で評価するのも違います。必要なのは、手で書き取れるほど短く、システムを壊せるほど密度の高いクリップが1本です。
目標は 12分 です。1分あたり約140語という通常の会話速度に、発話密度75%程度を掛けると、参照語数はおよそ 1,260語 になります。エラー率2%の差が統計的ノイズではなく25語として現れる程度には多く、2人で午後いっぱいかけて丁寧に書き取れる程度には少ない量です。
雰囲気ではなく仕様に沿って作ってください。私たちの仕様はこうです。
- 話者は4人以上。 圧縮された音声チャネル越しにリモート参加する人を最低1人、業務言語の非ネイティブなまりを最低1つ含めます。
- 本物の重なりが90秒以上。 2人が同時に話す、誰かの文を別の誰かが引き取って終わらせる、判断の上に咳が重なる。話者分離はクロストークで静かに崩壊するので、それがないクリップは何も測っていません。
- ドメイン用語が25個以上。 プロダクトのコードネーム、社内の略語、顧客名、参加者名。会議室において1文字あたりの意味量が最も高く、どの学習コーパスでも頻度が最も低い語です。
- 数値が15個以上。 日付、四半期、金額、バージョン番号、パーセンテージ。一部は意図的に紛らわしく発音してください。同じ1分の中に "fifteen" と "fifty" を入れる、といった具合です。
- 否定を含む決定が3つ以上。 自然な言い回しで。「今回のリリースではそれは出しません」「契約はいったん保留にしましょう」といった発言です。
- 同時録音を2系統。 可能なら、ノートPC内蔵マイクと話者ごとのヘッドセットトラックを同時に残します。AMIコーパスの設計そのもので、「モデルが弱い」のか「部屋がうるさい」のかを切り分けられます。
録音は一度きりです。WAVは16kHz以上で無圧縮のまま保存します。これ以降に評価するすべてのツールが、永久にこの同一ファイルを受け取ります。
ステップ2: 参照文字起こしを書き、採点の前に正規化ルールを凍結する
参照文字起こしは測定器であり、それ自体に誤差があります。Artificial Analysisが公開評価セットの「クリーン化」版をわざわざ維持しているのは、元の参照文字起こしに文字起こしの誤りが含まれていたからです。彼らの注記は率直で、クリーン版は「参照テキストから文字起こしの誤りを取り除き、モデル評価により正確な正解データを提供する」と書かれています。ベンチマークの運営者ですら公開済みの正解を訂正しなければならないのなら、あなたの一次稿も聖典ではありません。
ですから、2人が独立に書き取り、そのうえで差分をすべて突き合わせて解消します。2人合わせて実時間の5〜8倍を見込んでください。12分のクリップなら、合計でおおよそ1営業日分の労力です。この手順全体で最大のコストであり、迂回路はありません。
そしてスコアを1つでも計算する 前に、正規化ポリシーを書き出してください。この選択だけで最終的な数値が数ポイント動くからです。
- 数値: "Q3" と "Q three" は同じトークンですか。"forty thousand" と "40,000" は等しいですか。
- 短縮形: "we're" は "we are" と一致しますか。
- フィラー: "um"、"uh"、言い直しは参照にそもそも含めますか。含めるなら採点対象ですか。
- 大文字小文字と句読点: 通常は採点前に除去されます。つまり句読点を美しく打つツールはここでは一切評価されず、その分はステップ3で別途採点する必要があります。
結果はSegLSTで保存してください。CHiMEチャレンジが使い、MeetEvalの既定でもあるJSON形式で、セグメントごとに session_id、words、speaker、start_time、end_time を持つオブジェクトが1つずつ並びます。話者とタイミングのフィールドがあってはじめて話者を考慮した指標が使えるようになり、これを後から遡って埋める作業は非常に苦しいものになります。
ステップ3: 5つの項目を採点し、生のWERには100点中10点だけ与える
ツールを入れて — pip install jiwer meeteval — 同じクリップで項目ごとに採点します。JiWERはRapidFuzzの最小編集距離実装を使い、WERに加えてマッチ誤り率、単語情報損失、単語情報保持、文字誤り率を計算します。会議固有の指標はMeetEvalが担当します。
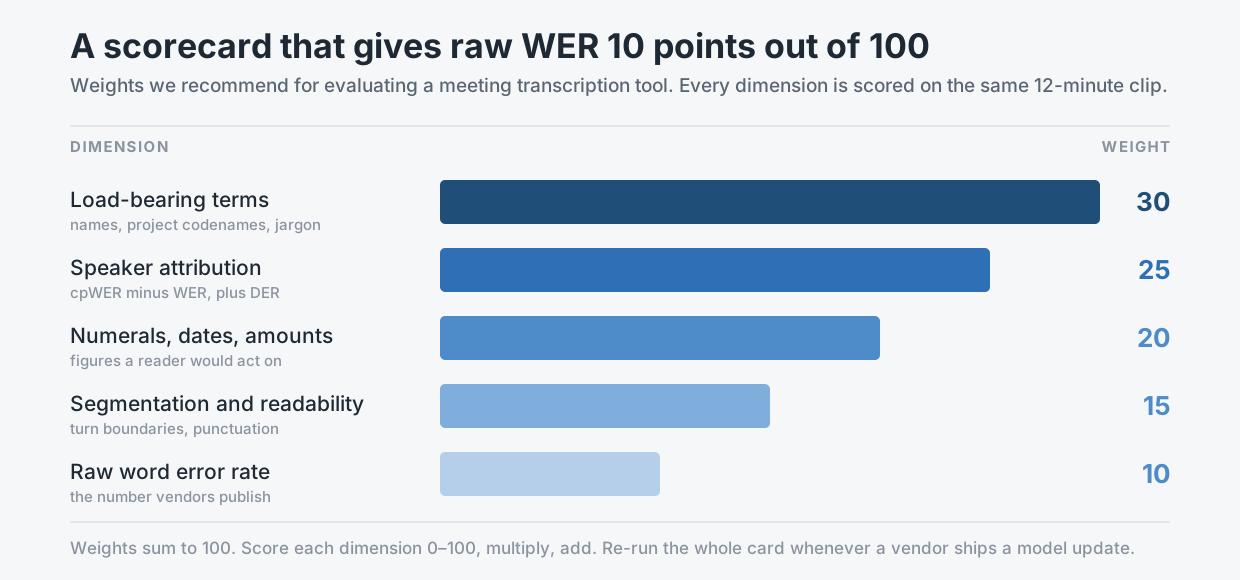
私たちが推奨する重み付けです。すべてのベンダーが宣伝する項目が、最も配点の低い項目になっています。
要となる語 — 30点。 参照文字起こしの中の固有名詞、コードネーム、ドメイン専門用語をすべて印を付けます。そのうえで、それらのトークンだけを対象に同じWERの式を回します。私たちはこの結果を 要となる語のエラー率 と呼んでいて、この演習で最も予測力の高い単一の数値です。冒頭の2本の文字起こしでは、要となるトークンは Priya、Helios、Q3、not の4つです。文字起こしAはどれも損なっていません。0.0% です。文字起こしBは2つを損なっています。50.0% です。全体のWERは同じ10.0%なのに、本当に重要な指標では50ポイントの開きが出ます。
話者の帰属 — 25点。 meeteval-wer cpwer -r ref.stm -h hyp.stm を実行します。連結最小順列WERは参照側と仮説側の話者の最適な対応付けを探し、話者ごとに語を連結してから採点します。したがって別人に割り当てられた語はエラーになります。そこで引き算をします。cpWERから素のWERを引いた値が帰属ギャップ であり、誰が話したか分からないことだけに由来する損害の取り分です。時間軸の視点としては話者分離誤り率を加えます。DERは話者誤り、誤検出音声、検出漏れ音声を採点対象時間に対する百分率として合計したもので、NIST RT-09評価計画書の6.1節に定義され、MeetEvalがラップしRTTMファイルを読むdscoreに実装されています。候補ツールがタイムスタンプに対応しているなら、cpwer ではなく tcpwer --collar 5 を使ってください。正しい語が誤った時刻に貼り付いている状態が黙って見逃されないようにするためです。
数値・日付・金額 — 20点。 参照から数値トークンをすべて抽出し、書き出した正規化ポリシーを適用したうえで、仮説との完全一致率を採点します。報告はパーセンテージではなく「15個中13個正解」といった素の分数にしてください。母数が小さいところにパーセンテージを使うと、実際には持っていない精度を示唆してしまいます。
区切りと読みやすさ — 15点。 ここは人間の仕事です。その会議に出ていない2人の読み手に生の出力を読ませ、1分あたりの件数として印を付けてもらいます。誤った位置の文境界、1つの塊に潰れた話者の交替、読み返さないと分からない段落です。句読点はWERの計算で正規化により消えているので、ここが句読点が採点される唯一の場所になります。
生の単語誤り率 — 10点。 jiwer を回して数値を記録します。これは本物の下限チェックです。クリーンな近接マイク音声でおよそ12%を超えるなら、掘り下げる価値のある実際の音響上の問題があるということです。その下限を越えてしまえば、この指標はほとんど何も区別しません。80点ではなく10点である理由がまさにそこにあります。
各項目を0〜100で採点し、重みを掛けて合計します。その結果はツール間でも時点間でも比較できます。それがこの作業の目的のすべてです。
ステップ4: すべての候補を完全に同一のファイルで回し、「同一」の中身を書き残す
チームが飛ばしがちなのがこのステップで、ここを飛ばすと上流の作業がすべて無効になります。
同じWAV、同じサンプルレート、候補間での再エンコードなし。同じ参照、同じ正規化ポリシーを同じスクリプトで適用。話者分離はすべてのツールで明示的にオンかオフにし、どちらであれ記録します。話者分離をオフで評価したツールは、オンで評価したツールと比較可能ではありません。キーワードやエンティティのバイアシングは1回目のパスではオフ、2回目のパスではオンにして、両方を記録してください。マイクロソフトはMAI-Transcribe-1.5にキーワードリストを与えるとWERが最大30%低下すると報告しています。バイアシングありとなしの実行を混ぜた比較が無意味になるほど大きな幅です。
とくに長尺音声の扱いに注意してください。Artificial Analysisは、フル尺の入力を安定して扱えないモデルのためにEarnings22の音声をおよそ9分単位に、制限がより厳しいモデルにはおよそ30秒単位に分割しています。彼ら自身の注記は、該当するシステムとしてGPT-4o Mini Transcribe、Amazon Nova 2 Pro、NVIDIA Canary Qwen 2.5B、アリババのQwen3 ASR Flashを名指ししています。エラーは境界に集まるため、チャンク分割は結果を変えます。ベンダーがあなたのファイルを分割するなら、それは補正して消すべきアーティファクトではなく、その製品の性質であり、スコアカードに載るべき項目です。
最後に、すべての実行について正確なモデルバージョン文字列と日付を記録してください。「Whisper large-v3」はバージョンではありません。whisper-large-v3, run 2026-08-31 がバージョンです。
ステップ5: 思い出したときではなく、ベンダーが出したときにスコアカードを回し直す
ホスト型の音声モデルは、あなたの足元で変わります。エンドポイント名は変わらないまま、その裏の重みは変わり、議事録が固有名詞で少し悪くなったことを知らせるメールは誰も送ってくれません。
ステップ1で作ったのと同じクリップで、スコアカード全体を回し直す引き金は3つです。
- ベンダーが変更履歴を公開したとき。 モデル、話者分離器、句読点と整形のレイヤーのいずれかに触れている項目が対象です。
- カレンダー上の期間が経過したとき。 多くのチームには四半期ごとで十分ですが、文字起こしの出力が下流の自動処理に流れ込むなら毎月にしてください。
- 要となる語のエラー率が2回の実行間で5ポイント以上動いたとき。 この場合は乗り換えを決める前に、まず原因の調査を始めるべきです。
すべての実行を1つの表にまとめてください。日付、モデルバージョン文字列、5項目のスコア、重み付き合計。3回か4回積み上がれば、どんなリーダーボードにも与えられないものが手に入ります。特定の製品が、自分たちの実際の会議のように聞こえる音声でどう振る舞ってきたかという時系列です。
結論: 精度はモデルの性質ではなく、あなたの会議室の測定値である
単語誤り率は、あるコーパス上でのモデルの性質です。実際に必要なのは、あなたの音声で、あなたの語彙で、互いに話を遮り合うあなたの同僚たちとともに 測ったモデルの性質であり、その量は測るまで存在しません。誰も代わりに公表できません。他の誰の参照文字起こしにも、あなたのコードネームは入っていないからです。
幸いなのは、この測定が安いことです。12分の録音1本、丁寧な書き起こしに1営業日、pipインストール2回、そして1ページに収まるスコアカード。高くつくほうの選択肢は、多くのチームが既定で選んでいるやり方です。公開された百分率で決めて、その差を半年後に知ること。チームが明確に拒否したことに合意した、と書かれた議事録の中で。
あなたはどちらで間違えたいでしょうか。小数点以下1桁でしょうか、それとも判断でしょうか。
Telli.shの位置づけ: 私たちは、このスコアカードが実際に重みを置いている層を作っています。Telli.shは音声認識の上に、話者分離、区切り、推敲、要約を載せ、翻訳は44言語、インターフェースは15言語で提供しています。あのスコアカードのうち生のWERではない90点分こそ、文字起こしが誰かの行動につながる議事録に変わる場所だからです。ベンチマークではなく本物のデータポイントが欲しいなら、自分で作った12分のクリップを通して、上の手順で結果を採点してみてください。
出典
- MeetEval — 会議文字起こし評価ツールキット — cpWER、tcpWER、ORC-WER、MIMO-WER、DI-cpWERの各コマンド、SegLST形式、および
ErrorRate(errors=4, length=9, insertions=0, deletions=2, substitutions=2)の実例、2026年8月31日参照 - JiWER — 音声認識評価パッケージ — RapidFuzzの最小編集距離によるWER、MER、WIL、WIP、CER
- dscore — 話者分離のスコアリングツール — NIST RT-09評価計画書6.1節に基づく、話者誤り+誤検出音声+検出漏れ音声としてのDER
- Artificial Analysis 音声認識リーダーボード — AA-WER v2の方法論(AA-AgentTalk 50%、VoxPopuli-Cleaned-AA 25%、Earnings22-Cleaned-AA 25%からなる約8時間)、上位5モデルの数値、クリーン化参照の注記とEarnings22のチャンク分割の注記、いずれも2026年8月31日参照
- CHiME-6 Challenge: Tackling Multispeaker Speech Recognition for Unsegmented Recordings (arXiv:2004.09249)、2020年4月20日 — 分割済みトラックと未分割トラック、およびディナーパーティ録音の設計
- The AMI Meeting Corpus — 近接マイクと遠方マイクを同期収録した100時間の会議録音
- Azure SpeechのMAI-Transcribe — Microsoft Learn — キーワードバイアシングと文書化された制限事項
- 文字起こしの精度はそもそも成果物ではなかったという以前の記事