Anthropic が Claude の文章に電子透かしを導入 — 1,922 件の判決から分かる限界
Claudeのテキスト電子透かしは、モデルが関与した可能性を示しますが、事実の正しさは検証しません。検出の限界、誤認による冤罪、記録された1,922件のハルシネーション事例が示す来歴と真実の違いを解説します。
2026年8月14日、Anthropic は今後の Claude モデルでテキスト電子透かしをどのように機能させるか説明しました。FAQ は、8月2日に適用が始まった EU AI 法の透明性要件に触れています。FAQ公開時点ですでに提供されていたモデルは、移行期間中に更新されます。この発表は、すべての Claude の応答にすでに透かしが付いているという意味ではありません。
有用なのは、モデルの単語選択に埋め込まれた信号という考え方です。条件が整えば、読者に見える文章を変えずに、モデルが関与した可能性を特定する手掛かりになります。
生成テキストに架空の証拠が含まれる場合、この違いは重要です。以下で取り上げる公開データベースのある時点の記録には、AI のハルシネーションに関わる 1,922 件の裁判例 が含まれていました。これは電子透かしの検出テストではなく、特定の検出器がその文章を識別できたかを示すものでもありません。示しているのは別の問題です。来歴を示す信号があっても、引用された判例や研究、事実が実在するとは確認できません。この隔たりを理解すれば、透かしの結果をより有効に、そして誤用しにくく扱えます。
要点
- テキストに何かを付け足しているわけではありません。 秘密鍵で単語選択のランダム性を変える仕組みで、見た目の書式は変わりません。Anthropic は世界規模での展開を予定しており、旧モデルには段階的に追加します。
- 検出成功は弱い証拠であり、検出失敗はほとんど何の証拠でもありません。 Anthropic 自身が、この印では「Claude が書いた」と「Claude が大幅に手を入れた」を区別できず、短い文章・コード・事実の羅列では弱く、書き直せば消えると述べています。2024年には研究者が、50ドル未満でこの印を消すことも、人間が書いた文章に偽装して付けることも可能だと示しました。
- 来歴は検証ではありません。 検出結果はモデルが関与した可能性を示せても、文章中の判例、引用、書籍が正しいかは確認しません。
画像: Jon Rawlinson, Wikimedia Commons, CC BY 2.0. 真正性の印で埋まった一ページ。スタンプの一つひとつが国境を越えた事実を証明します。そのどれも、この旅行者が真実を語ったかについては一言も述べていません。
Anthropic が実際に変えたもの、変えなかったもの
まず仕組みから見ていきます。その後の誤解のほとんどが、ここを取り違えることから始まるからです。
言語モデルが文章を書くとき、単語は一つずつ出てきますが、大半の位置では正解は一つではありません。「会議は 生産的だった」も「会議は 有益だった」も問題ありません。モデルは受け入れられる次単語のリストを持ち、ランダムな抽選で一つを選びます。同じプロンプトを二度入れると少しずつ違う答えが返るのはこのためです。
テキスト電子透かしは、その抽選を秘密鍵で駆動する 疑似 ランダムな抽選に置き換えます。モデルは依然として自分が同等に良いと判断した単語の中からしか選ばないので、品質はそのままです。しかし数百語が積み重なると、毎回どの単語が選ばれたかのパターンはもはや偶然に見えなくなり、鍵を持つ側はそれを測定できます。
隠し文字や削除可能なテキストメタデータはありません。信号は単語選択にあり、Anthropic によればトークンは追加されず、速度への影響もごくわずかです。提供方針は地域別ではなく世界共通ですが、どのモデルが対象かは展開状況によります。方針だけでは、特定の応答に透かしが付いているとは判断できません。
新しい科学ではありません。Scott Aaronson が2022年にこの手法を提案し、Kirchenbauer らが2023年の ICML で動作する方式を発表し、Google DeepMind が2024年10月に Nature で SynthID-Text を公開しました。Anthropic の実装はその一種です。Google は2024年から Gemini でこれを動かしており、約2,000万件の実応答で品質の差は検出されなかったと報告し、その後100億点以上のコンテンツに電子透かしを入れたと主張しています。
更新、2026年10月12日: Anthropicの9月1日付FAQによると、検出APIは対象組織向けのプライベートプレビュー中で、より広い提供が予定されています。これは、APIが近日公開予定だった8月時点の記述を更新するものです。電子透かしが推定するのはClaudeの関与であり、文章の真偽ではありません。
印はコピー&ペーストには耐える。書き直しには耐えない。
信号は どの単語が選ばれたか に宿ります。ですから単語の選択を保つ操作は印も保ち、単語を入れ替える操作は印を壊します。Anthropic は上限をはっきり述べています。「すべての単語を置き換える完全な書き直しは」 これを除去する、と。ただし、多くの人が引っかかる例外が二つあります。
短い文章と事実中心の文章はほとんど何も担えません。 電子透かしには隠れる選択肢が必要です。一、二文では模様を成すだけの決定が集まりませんし、事実中心の内容ではそもそも選択の余地がないこともあります。Anthropic が挙げる例が分かりやすい。「ニュートンの プリンキピア」の次に来る単語は「マテマティカ」しかありえず、どんな鍵にも口を挟む余地がありません。同じ理屈で、構文が大半のトークンを決めてしまうコードも弱く、モデルが触る単語が少なすぎる校正作業も同様です。
翻訳は完全な電子透かしを帯びます。 これは直感に反します。Claude に文書を日本語へ訳させると、その日本語は Claude が普段どおりの選択の自由をもって一語ずつ 新たに生成した ものです。ですから元が印のない人間の文章でも、出力にはしっかり印が入ります。これは DeepMind の研究者が Nature で述べている内容、つまり印の付いたテキストを別の言語に訳すと検出信頼度が大きく下がるという話と正反対に見えます。どちらも本当です。状況が違うからです。印の付いたテキストを 外部で 訳せば印は洗い流され、モデル自身に 訳させれば 新しい印が押されます。
| テキストに対してすること | 印は残るか |
|---|---|
| どこへでもコピー&ペースト | 残る — 貼り付けで剥がれるものが元々ない |
| 軽い編集: 誤字直し、見出し変更、削除 | 残る — 単語の選択はほぼそのまま |
| モデルに翻訳させる | 残る — 訳文は新たに生成されるため完全に印が入る |
| 自分の言葉で大きく言い換える | 残らない — 信号を担っていた選択そのものを入れ替える |
| 全単語を置き換える完全な書き直し | 残らない — Anthropic が除去されると明記 |
| 一、二文の短い抜粋 | ほぼ残らない — 模様を成す選択肢が足りない |
| コード、または事実の羅列 | 弱い — 構文と事実がモデルに自由を残さない |
| モデルに自分の原稿を校正させる | ほぼ残らない — 変わる単語が少なすぎる |
2026年8月14日の Anthropic の FAQ と、2024年10月 Nature 掲載の SynthID-Text 論文著者らの記述に基づく。
検出成功は弱い証拠。検出失敗はほとんど何の証拠でもない。
検出器が結果を返したとき、合理的にどんな結論を導けるでしょうか。
陽性の場合、分かるのは、その事業者のモデルがテキストの一部に関与した可能性があるということです。それ以上ではありません。Anthropic はこの印では 「Claude が書いた」と「Claude が大幅に手を入れた」を区別できない と明記しており、内容のどの主張が真かについても何も示しません。また、自社の鍵しか知らないため、別の AI が書いた文章は認識できません。
陰性の結果から分かることも、ほとんどありません。陰性だからといって、人が書いたとは証明できません。
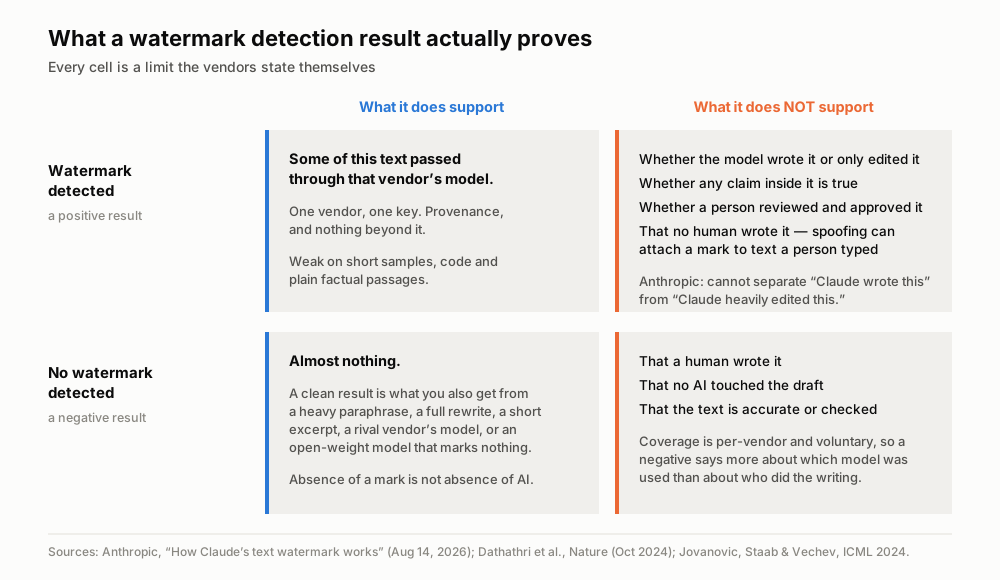
ここにあるセルはすべて、事業者自身が公表した限界です。出典: Anthropicの電子透かしFAQ(2026年8月14日公開、9月1日更新)、Dathathri et al., Nature(2024年10月)、Jovanović・Staab・Vechev, ICML 2024。
誰も備えていない攻撃は、向きが逆である
除去は誰もが思い浮かべるリスクです。誰かが AI テキストを洗浄して出自を隠す。それはそうでしょう。しかし矢印が逆を向いた二つ目の攻撃があり、本当に心配すべきなのはこちらです。
なりすまし とは、人間 が書いた文章に他人の電子透かしを載せることです。何かを隠すのではなく、植え付けるのです。標的になるのは、AI を使ったと疑われることになる人か、作った覚えのない出力の責任を負わされる事業者です。
2024年の ICML で Jovanović、Staab、Vechev の三氏は、最新方式を相手に両方の攻撃を 50ドル未満の計算コストで80%を超える成功率 で実演しました。DeepMind の著者らも自らの Nature 論文で同じ地点を認めています。電子透かしは 「完全な解決策を提供するものではなく」、存在するにはモデル提供者の協力が必要で、誰でもそのまま動かせるオープンウェイトモデルには強制できず、「窃取・なりすまし・除去の攻撃に対して脆弱である」と。最後の一節がこの議論のすべてです。しかもその技術を作った当人たちが書いています。
初期のAI検出器は学生を誤ってAI利用者と判定した
検出ツールはすでに存在します。そしてそれは、被害の記録が残る別の技術です。電子透かし は、モデルの所有者が生成時に鍵を使って埋め込むもの。分類器 は、第三者が事後に文章そのものの特徴から推測するものです。単語の選択がどれだけ予測可能か、語彙がどれだけ多様か、といった特徴から。前者は何かを知っています。後者は文体をパターンマッチしているだけです。測定とプロファイリングの違いです。
OpenAI は2023年1月31日に AI テキスト分類器を公開し、同じ年の7月20日に 「精度が低いため」 取り下げました。自社の数字では、AI テキストの26%しか捕まえられず、人間の文章の9%を誤って表示していました。
そして2023年7月、Liang らが Patterns に、この分野を終わらせるべきだった結果を発表します。英語を母語としない人が書いた TOEFL エッセイに検出器7種をかけたところ、平均誤検知率は 61.3%。ある検出器はそのうち97.8%を機械が書いたものと判定しました。ところが同じエッセイをより豊かな語彙で書き直させると、誤検知率は11.6%まで下がりました。検出器は最初から著者性を測っていなかったのです。流暢さを測り、英語が素朴な人を罰していました。
ヴァンダービルト大学は2023年8月16日に Turnitin の AI 検出器を停止しました。同大学の説明には仮定に基づく計算があり、主張されていた誤検知率1%を年間約75,000本の提出論文に当てはめると、約 750本の論文が誤って判定される 可能性があるとしました。これはリスクの推計であり、実際に誤って告発された学生数ではありません。ヴァンダービルト大学の発表。
電子透かしの検出は、文章の文体から著者を推測するのではなく、定義された生成パターンを調べます。それでも結果は確率的で、短い文章や大幅に編集された文章では判定できないことがあります。モデルの関与を示す結果を特定の人物への告発に変えてはいけません。なりすましに関する研究も、検出だけでは著者を確定できないことを示しています。
規制は道具より先に到着した
これらが2週間のうちに重なったのは、立法が先に動いたからです。
EU AI 法は義務を二つに分けます。第50条2項 は提供者を縛ります。生成システムを作った側は、テキストを含む出力を機械可読な形で表示しなければなりません。第50条4項 は利用する側を縛ります。「公共の利益に関する事項について公衆に情報を提供する」 AI 生成テキストを公開する導入者は、その旨を開示しなければなりません。
そしてこの二つ目には、多くの読者にとってこの制度の実質的な核心である免除規定が付いています。当該コンテンツが 人間によるレビューまたは編集上の管理を経ており、それについて編集責任を負う者がいる場合 には適用されません。二度読んでください。AI 生成テキストに対するヨーロッパの答えは検出器ではありません。それをレビューし、責任を負う、名前のある人間です。
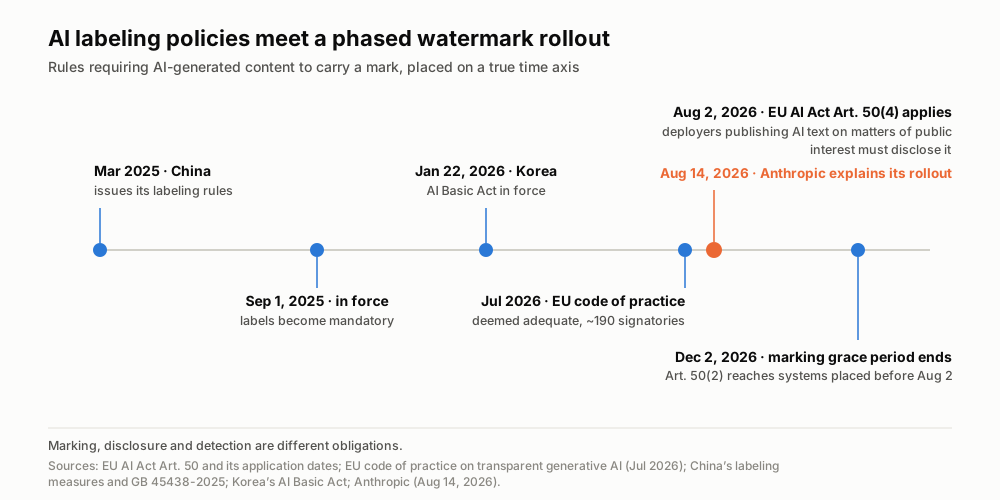
表示義務は予定どおり到着しましたが、使える検出手段はそうではありませんでした。出典: EU AI 法とその適用日程、EU 透明性実践規範(2026年7月)、中国の表示措置と GB 45438-2025、韓国の AI 基本法、Anthropic の発表。
欧州委員会は、透明性実践規範を法律の代替ではない自主的な遵守枠組みと説明しています。2026年7月末までに約190の組織が署名しました。委員会のFAQによれば、8月2日より前に市場に出たシステムには2026年12月2日までの移行期間があります。重要なのは、署名者の実施日程と法的義務は同じではないという点です。欧州委員会の概要、欧州委員会のFAQ。
他の地域では異なる規則が使われています。中国の表示措置は2025年9月1日に発効し、GB 45438-2025 のもとで可視・埋め込み両方の表示を定めています。韓国の AI 基本法は2026年1月22日に施行されました。遵守状況を評価するには、単一の「世界共通」の表示規則ではなく、該当する法域とコンテンツの種類を確認する必要があります。
もう一つ、ここに置くべき不在があります。ウォール・ストリート・ジャーナル は2024年、OpenAI が社内で精度およそ99.9%と説明していたテキスト電子透かし手法を作っていたと報じました。これは事実ではなく報道として扱うべきものです。その数字は独立に検証されたことがなく、OpenAI はテキストへの表示を出荷したことがありません。2026年6月11日の EU 対応に関する自社の投稿でも扱っているのは画像の来歴だけで、一般的な限界は自らの言葉で認めています。「メタデータは削除されうるし、電子透かしは劣化しうる」 と。
電子透かしでは幻覚を含む引用を検証できない
Damien Charlotin 氏は、裁判官が AI のハルシネーションを含む内容に対処せざるをえなかった世界各地の判決を、公開データベースとして管理しています。2026年8月16日に取得した時点で 1,922 件 でした。推移はこうです。2025年半ばに約200件、2026年1月に719件、4月に1,227件、6月9日に1,598件、そして今日1,922件。直近10週間だけで324件増えています。
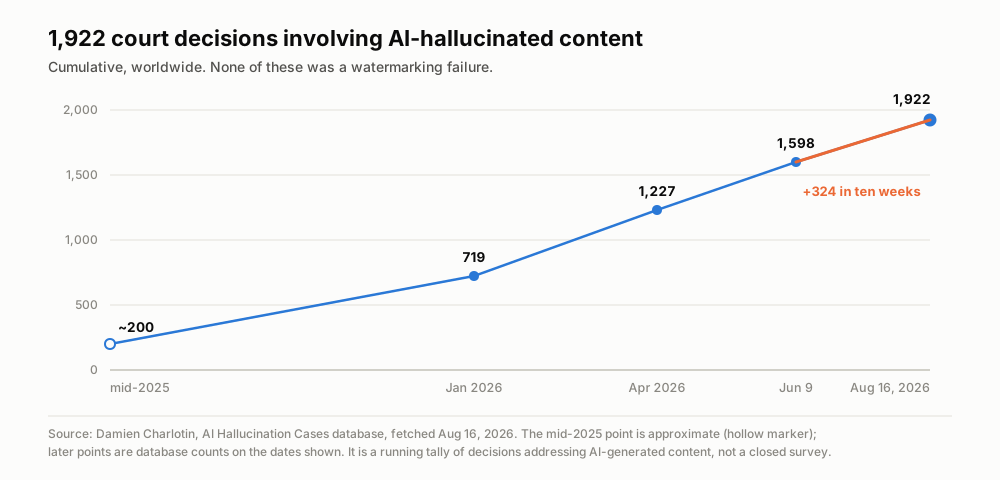
これらの事例はハルシネーションを記録したもので、電子透かしの検証結果ではありません。来歴を示す印では事実の正しさを確認できません。出典: Damien Charlotin 氏の AI ハルシネーション事例データベース、2026年8月16日取得。
原型は2023年6月22日にニューヨーク南部地区連邦地方裁判所が下した Mata v. Avianca です。存在しない判例を6件引用した準備書面と、5,000ドルの制裁金。
しかし最も重く受け止めるべき事例は Anthropic 自身のものです。2025年5月、Concord Music v. Anthropic において、同社の弁護団は Claude が捏造した研究を引用した専門家宣誓書を提出しました。手作業の確認はそれを見逃し、弁護人は法廷で謝罪しました。いまテキスト電子透かしを出荷しているその会社が、自社モデルの出力を無批判に引用したことで、自社の訴訟で、自社の弁護士のレビューを経て、痛い目を見たのです。陽性の結果が出ても、引用された研究が実在するかどうかは分かりません。
法廷の外にも広がります。Deloitte Australia は2025年10月、存在しない参考文献と判決文からの捏造引用を含む44万豪ドルの政府報告書について、一部返金に合意しました。2025年5月18日には シカゴ・サンタイムズ と フィラデルフィア・インクワイアラー が夏の推薦図書リストを配信で掲載しましたが、15冊のうち実在したのは5冊だけでした。Liang らは arXiv:2404.01268 で論文950,965本を分析し、LLM が手を入れた内容がコンピュータ科学の抄録で最大17.5%に達する一方、数学と Nature 系列では6.3%以下にとどまることを示しました。
量の問題にも、煽る数字ではなく正直な数字が要ります。2025年10月公開の Graphite による Common Crawl 分析は、2025年5月の新規記事サンプルの約51.7%が AI 作成だったとしています。そしてこれを報じた Axios が付けた但し書きが重要です。その比率は上がり続けているのではなく、半分あたりで頭打ちになっている というのです。洪水ではありません。新しい常態です。
ここが要点です。この一覧のどれ一つとして電子透かしの失敗ではありません。どの事例でも来歴は最初から争点ではありませんでした。モデルが関わったことは皆が知っていたか、言われれば即座に受け入れたでしょう。失敗したのは、誰もその引用を開いて、その判例が、その研究が、その書籍が実在するかを確かめなかったことです。
結論: 来歴は検証ではない
これを 消印の錯覚 と呼びましょう。消印はどの郵便局がその手紙を扱ったかを証明します。手紙の中身が真実かどうかについては、一度も意見を持ったことがありません。私たちはいま相当な工学的努力を注いで非常に優れた消印を作ったところで、世間の議論の一部はそれをファクトチェッカーと取り違えようとしています。
三つの点を同時に押さえてください。陽性の検出はモデルが関与した可能性を示すもので、著者や真偽を証明しません。陰性の結果も、人が書いた証明にはなりません。対象範囲は事業者、その鍵、透かしを使うモデルに左右され、普遍的ではありません。Anthropicの更新後のプライベートプレビューAPIにも利用資格の条件があり、誰でも自由に使えるわけではありません。
本当に検証に耐えるのは、出力に押された印ではありません。源から辿り直せる記録です。いまも残っている録音、いつでもその瞬間に戻れるタイムスタンプ付きの文字起こし、実際にそれを言った人に帰属された一行、直接開ける一次資料まで辿れる根拠。私たちは 流暢な出力より見直せるノートが大切なリアルタイム翻訳 について、また 誰かが異議を唱えたときに記録が持ちこたえねばならない警察の取調べの文字起こし について、同じことを述べてきました。電子透かしの時代はその主張を変えるのではなく、鋭くします。表示が普遍化すれば「AI が関わった」という言葉は何も区別しなくなるからです。
電子透かしは、テキストがどこから来たかに答えます。それが真実かに答えるものは、まだ誰も作っていません。それは検出器ではないからです。戻って確かめられる源です。
Telli.sh の立ち位置: 私たちは、戻って確かめられる源を作っています。Telli.sh は会議を録音し、話者が区別されたタイムスタンプ付きの文字起こしを作り、要約をその元になった音声につなぎ止めます。だからノートのどの一行も、数か月後に誰かがそう言ったその瞬間まで辿れます。これは AI を検出するという主張ではありません。問題のもう半分です。要約が何かを主張したとき、その一文を信じる代わりに録音と照らし合わせられる、ということ。
出典
- Anthropic, "How Claude's text watermark works"(2026年8月)
- Dathathri et al., "Scalable watermarking for identifying large language model outputs," Nature(2024年10月)
- Kirchenbauer et al., "A Watermark for Large Language Models," ICML 2023
- Jovanović, Staab & Vechev, "Watermark Stealing in Large Language Models," ICML 2024
- Liang et al., "GPT detectors are biased against non-native English writers," Patterns(2023年7月)
- Liang et al., "Mapping the Increasing Use of LLMs in Scientific Papers," arXiv:2404.01268
- Damien Charlotin, AI Hallucination Cases データベース
- 欧州委員会、AI法第50条: 透明性義務
- Wikimedia Commons 画像ページ
