Jevは会話するより選ぶ:3つのデモと実運用での限界
TypeSafeのJevが実際に行うことを、Browser UseのGIFと再生可能なデモ、1,500通のメールを扱ったX投稿、公式ゲームデモから解説します。型付きの判断が役立つ場面と失敗する場面を知り、実際のワークフローを評価しましょう。
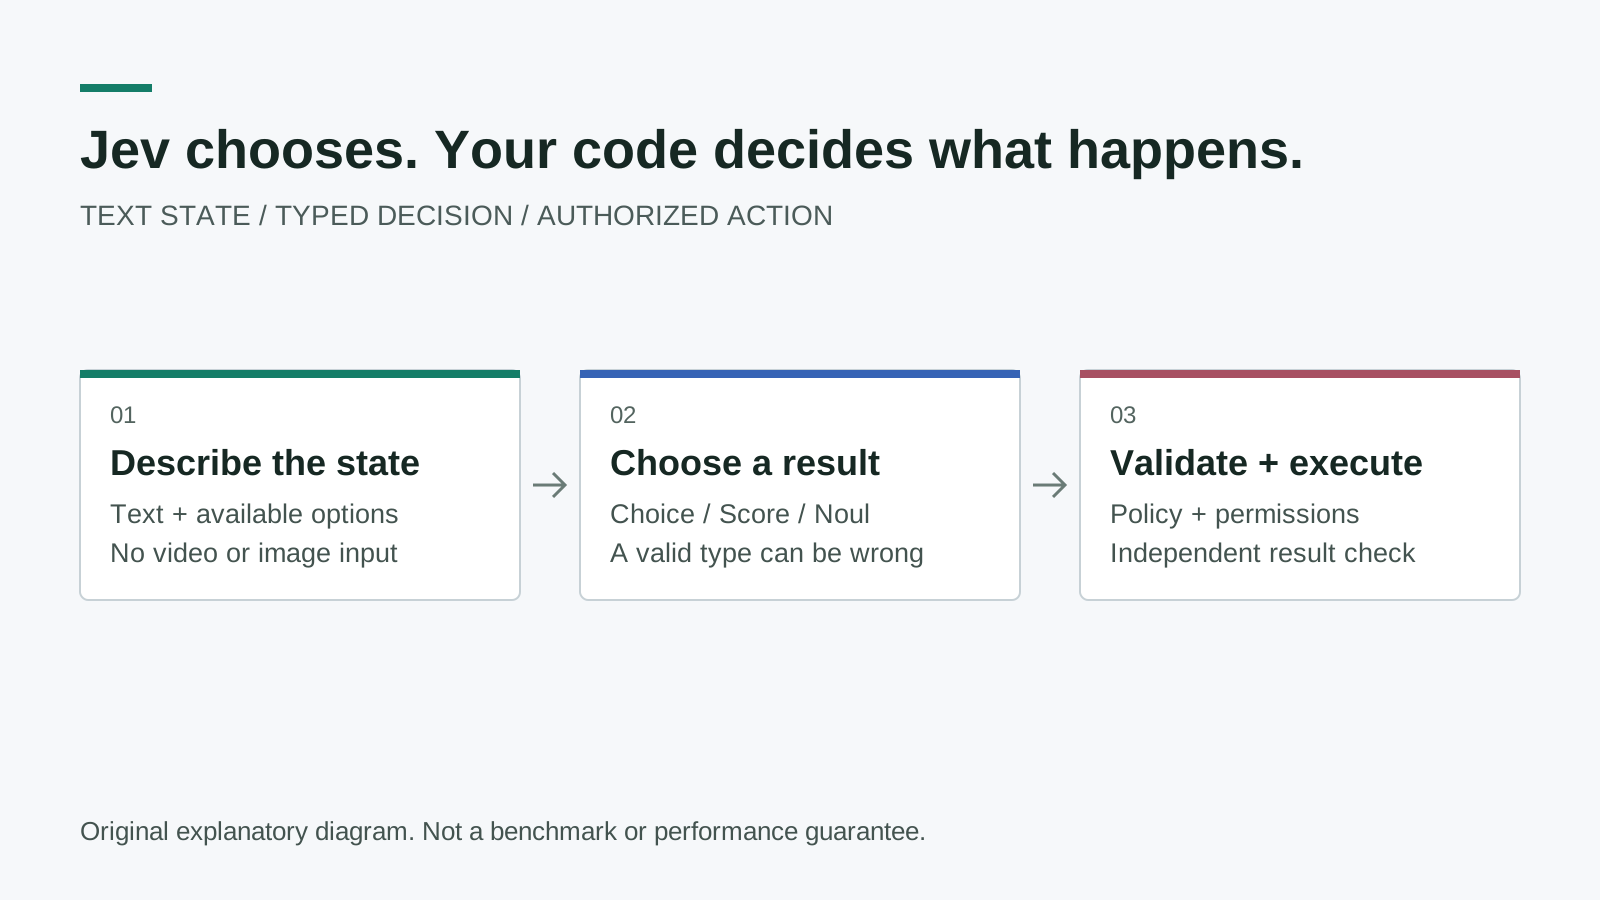
ベンダーのベンチマークではなく、説明用に作成した図です。モデルは定義された選択肢の中から選びますが、権限、検証、実行の責任は引き続きアプリケーションコードにあります。
受信トレイの分類器は、フォルダーを選ぶ前に長い論文を書く必要はありません。ブラウザーを操作するシステムが必要とするのも、新しいコマンドを発明することではなく、表示中のボタンからひとつ選ぶことかもしれません。TypeSafe AI初のSystem OneモデルであるJevが最も興味深い主張を示すのは、こうした小さな判断です。
TypeSafeがJevを発表したのは2026年9月15日です。注目点は単に、またひとつ高速なモデルが登場したことではありません。自由形式の文章ではなく、制約された判断を返します。それによって周辺プログラムの設計は変わりますが、誤った選択をする可能性までなくなるわけではありません。ベンダーによる位置づけは公式発表をご覧ください。
この記事では、公開されている3つのデモを取り上げます。ダウンロード可能なGIFと動画があるブラウザー操作、執筆者が1,500通のメールを分類したという報告、そしてTypeSafeのゲームデモです。さらに、それらを具体的な評価計画に落とし込みます。9月18日公開のTistoryのユースケース記事を調査の出発点としましたが、そこに挙げられた用途を、独自に検証済みの導入事例として扱ってはいません。
要点:
- Jevはテキストから選択、採点、命題の判定を行えますが、任意の文章を書くモデルの代替ではありません。
- 型に合った結果でも、意味的には誤っていることがあります。検証と最終的な許可判断はコード側に残してください。
- ブラウザーの録画は実際のものですが、ひとつのタスクは汎用ベンチマークではありません。メールの例は執筆者の報告であり、公開された精度調査ではありません。
- まずは元に戻せる分類から始め、自分のデータで誤りを測り、判断保留も可能な結果として用意してください。
短い答えには明確な問いが必要
APIの中核となるプリミティブはChoice、Score、Noulの3つです。Choiceは名前の付いた選択肢から選びます。Scoreは説明付きで順序づけられた段階を評価します。Noulは「はい」か「いいえ」で答えられる命題の確率を返します。値が中間に近い場合、それは命題への不確かさを表し、中程度の深刻度を意味するわけではありません。プリミティブのドキュメントに各契約が定義されています。
実務上の変化は、モデルに判断を求める前に、可能な結果を定義することです。受信したサポートメッセージについて説明文を出力させる代わりに、請求、アカウントへのアクセス、製品の不具合、未分類のいずれに当たるかを尋ねられます。その後、どのキューに表示するかはアプリケーションが決めます。これは線路上の分岐器のようなもので、作業の向きを決める助けにはなりますが、列車を目的地まで運ぶ機能すべてを備えているわけではありません。
| プリミティブ | 役立つ問い | アプリケーション側の責任 |
|---|---|---|
| Choice | このメッセージに最も合うキューはどれですか? | 確認用の経路を含め、選択肢を漏れなく定義する |
| Score | 説明された緊急度の段階に、このメッセージはどの程度当てはまりますか? | 段階を定義し、評価者の判断が一致するかテストする |
| Noul | このメッセージは、明示的にキャンセルを求めていますか? | どの確率なら確認や取り消し可能な操作につなげるかを決める |
選択肢を適切に作ることもエンジニアリングの仕事です。ラベル同士が重なっていると、自信ありげな選択の裏に分類体系の問題が隠れることがあります。どのラベルにも当てはまらないのに選択を強制すると、網羅性の欠如を確実性に見せかけてしまいます。狭いカテゴリをさらに追加するより、確認用の選択肢を設けるほうが、判断契約の改善が必要な場所を明らかにできる場合があります。
2026年9月30日に確認したところ、モデルのリファレンスにはjev-1.13.0、テキスト入力のみ、入力100万トークンあたり0.042米ドルと記載されています。出力トークンは無料です。これはモデルのトークン料金であり、エージェント運用全体の費用ではありません。ブラウザー操作、情報抽出、補助モデル、再試行、人による確認も運用予算に含めてください。
ブラウザーのGIFが示すのは実際の検索であり、航空券の予約ではない
Browser Useが公開しているjev-ultrafastリポジトリには、チューリッヒからロンドンへのGoogle Flights検索を記録したタスクがあります。Jevは現在のページ表現から操作と対象を選びます。選択された操作で文字入力が必要な場合には、別の生成型ヘルパーがテキストを用意します。これは複数要素を組み合わせたシステムであり、Jev自身がすべての文字列を生成したり、動画のフレームを解釈したりする証拠ではありません。
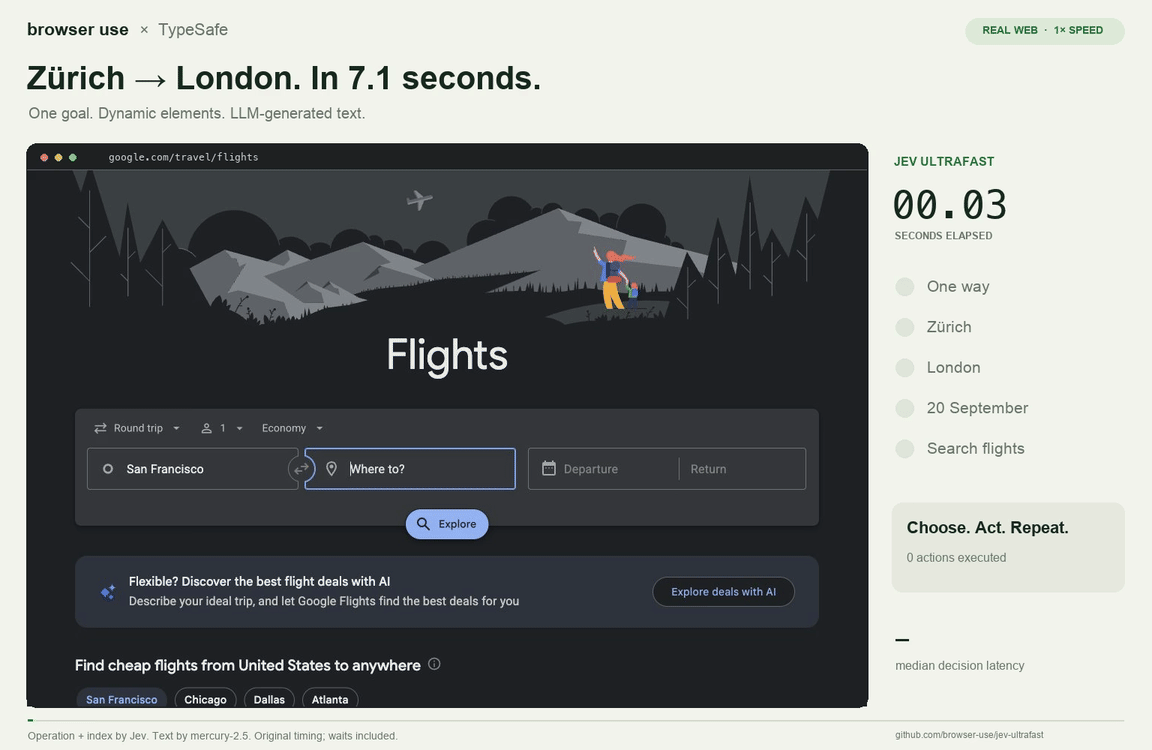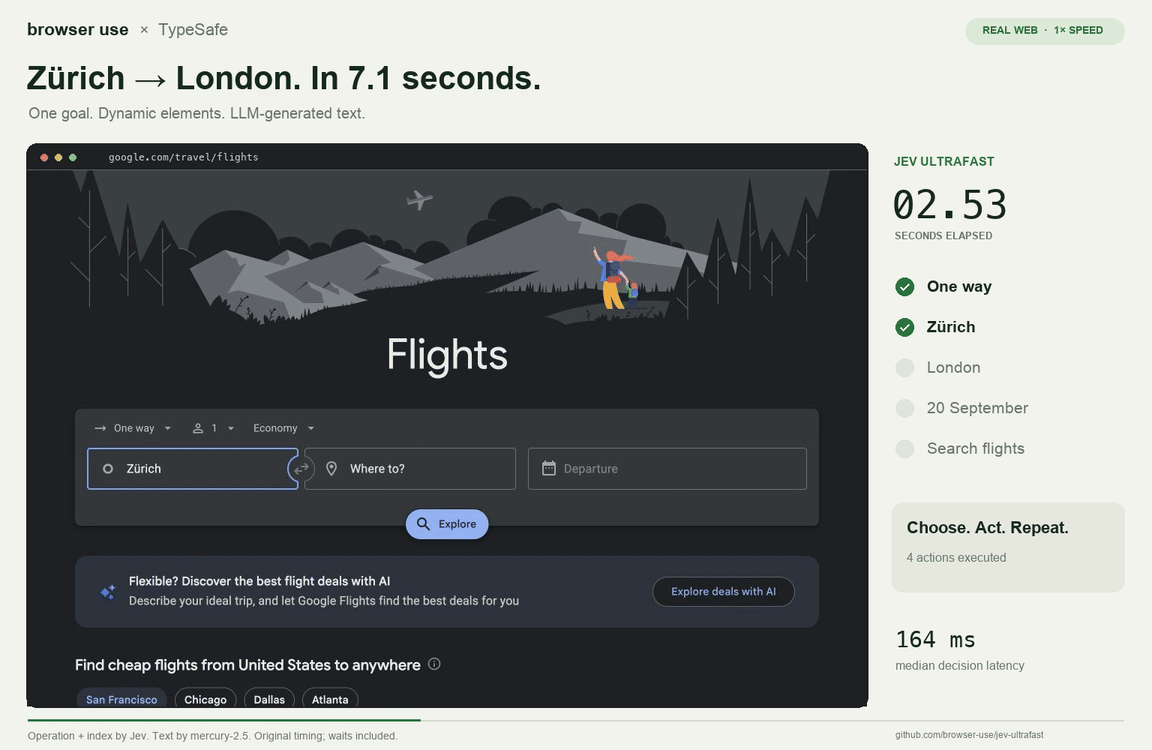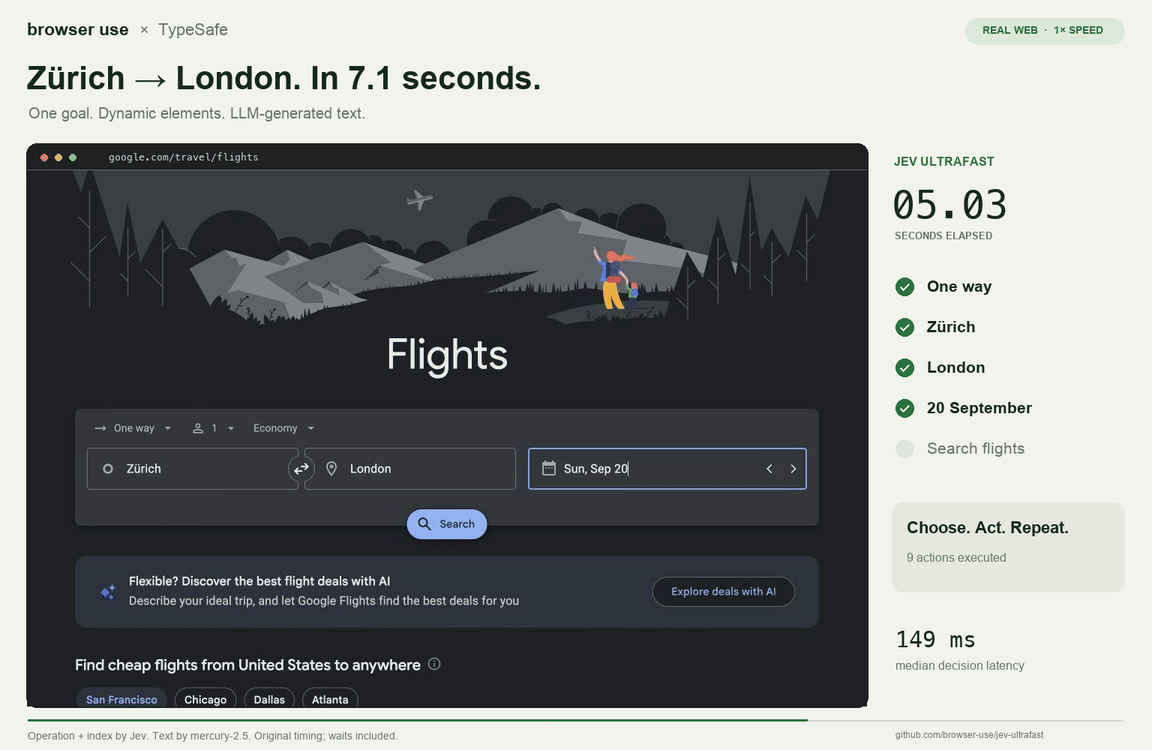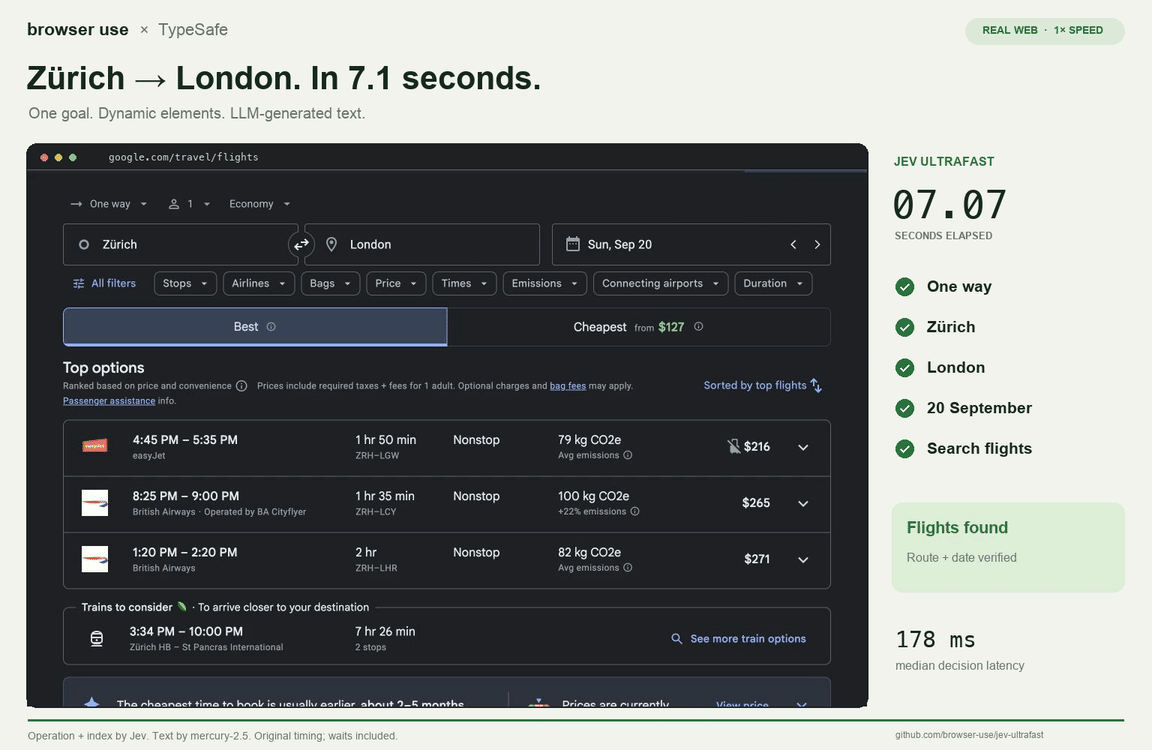
Browser Useの執筆者が実際に記録したGIF。コミット1231850a0bf1a0c0341fe408ef1668dbbfdfac46に固定されています。著作権2026年 Browser Use、MITライセンス。検索フローを示すもので、購入ではありません。同じ録画を下で再生できます。
執筆者のMP4です。録画時の速度のまま、ブラウザーの操作ボタン付きで表示しています。元の録画と計測メモ、保持されているMITライセンス。公開資料を確認しましたが、このベンチマークを再実行したわけではありません。
執筆者が測定したこの録画の完了時間は7.073秒です。計測はブラウザーを新たに起動した時点ではなく、最初のトップページ観測後に行った最初の予測から始まります。セットアップ、最初のページ遷移、終了後の独立した再確認は、この計測区間に含まれません。検索結果は確認しますが、航空券の選択や購入は行いません。この数字の意味を理解するには、こうした範囲の違いが欠かせません。
同じ報告では、2つのランタイムを交互に各3回、合計6回実行して比較しています。タスク時間の中央値は9.450秒から7.092秒に、ブラウザープロトコル呼び出しの中央値は1,092回から101回に減りました。両方の条件で同じJevとテキストヘルパーを使っているため、これは主としてランタイムの比較であり、モデル群同士の対決ではありません。執筆者はパフォーマンス報告で、サンプル数の少なさと、実際のWeb環境の変動を明記しています。
私たちの見立てでは、モデルと同じくらい周囲のブラウザーループにも注目する必要があります。ページを何度も収集し、対象を特定し、判断を無効化する処理は、クリックという見た目の単純さから想像する以上にコストがかかる場合があります。判断エンジンが速くても、選ぶ対象となるボタンの説明が不正確なら補えません。リポジトリが独立した結果検証を行うのは、モデルが完了したと言うだけでは、実際に完了した証拠にならないからです。
デモの限界を把握することも役に立ちます。文書化された実装は、あらゆるフレーム、キャンバス、アップロード操作、任意のキーボードウィジェットをカバーしてはいません。導入を評価するチームは、自分たちにとって典型的なタスクや失敗経路を再現すべきであり、航空券検索の成功だけから汎用的なブラウザー操作能力を推測すべきではありません。この録画は、動作する構成のひとつを確認できる資料として扱いましょう。
1,500通のメールを扱った投稿は有望だが、分母が分からない
2026年9月16日、vogel(@ryanvogel)はXに、自分のメール1,500通でJevを試し、分類結果に感心したと投稿しました。元の投稿には動画もあります。処理対象が具体的で、仮想的な用途を列挙した匿名の一覧ではなく、実験を報告した本人による情報であるため、実ユーザーの例として参考になります。
ただし、これは精度報告ではありません。公開されたラベル付きテストセット、測定済みの誤り率、評価者同士の一致度、誤分類のコストは示されていません。処理したメッセージ数から分かるのは実験の規模であり、正しさではありません。Xの元のデモを見る際は、この違いを意識してください。動画へのリンクはありますが、再配布ライセンスがない動画を複製してはいません。
それでも、メール分類は評価を始める用途として理にかなっています。元に戻せる形にできるからです。既存の受信トレイは変更せず、提案ラベルを横に表示して修正内容を記録します。請求書と支払いのリマインダー、キャンセルの依頼とキャンセルに言及しただけの苦情など、紛らわしい組み合わせを比較してください。そうしたケースから、カテゴリが実際のワークフローに合っているかが分かります。
分類の確信度が高く見えるからといって、初期導入時にメールを自動削除したり、返信を送ったり、取引を承認したりするべきではありません。こうした操作には、別の権限と結果が伴います。まずは提案または確認キューから始め、誤りの傾向を測定してから、範囲を絞った操作だけを有効にしてください。これは私たちが提案する評価手順であり、X投稿者が実際に使った仕組みについての主張ではありません。
DoomとWikiracingは判断ループを見える形にする
TypeSafeの発表には、DoomのデモとWikiracingのデモが含まれ、どちらも公式発表記事からリンクされています。繰り返される判断を目で理解するのに役立ちます。ただし、Jevが汎用的な視覚モデルであることや、あらゆる計画問題を解けることの証拠ではありません。
Doomの例でモデルが受け取るのは、スクリーンショットではなく、構造化されたテキストによる状態の説明です。Wikiracingでは、行き先のURLを創作するのではなく、利用可能なリンクから選びます。注目すべき仕組みは、観測、制約された選択、操作を繰り返すサイクルです。ゲームのデモではこのサイクルが分かりやすく見えますが、別の環境にどれほど応用できるかは分かりません。
TypeSafeのスマートホームデモのドキュメントにも同じ役割分担があります。複数の問いでリクエストの側面を分類し、自由形式の会話や複合リクエストの分割は別のコンポーネントが担う場合があります。ひとつのモデルが言語を生成し、あらゆる判断を実行している、とこの構成を説明してはいけません。実装が境界を明示しないと、assistantやagentといった名前がその違いを見えにくくすることがあります。
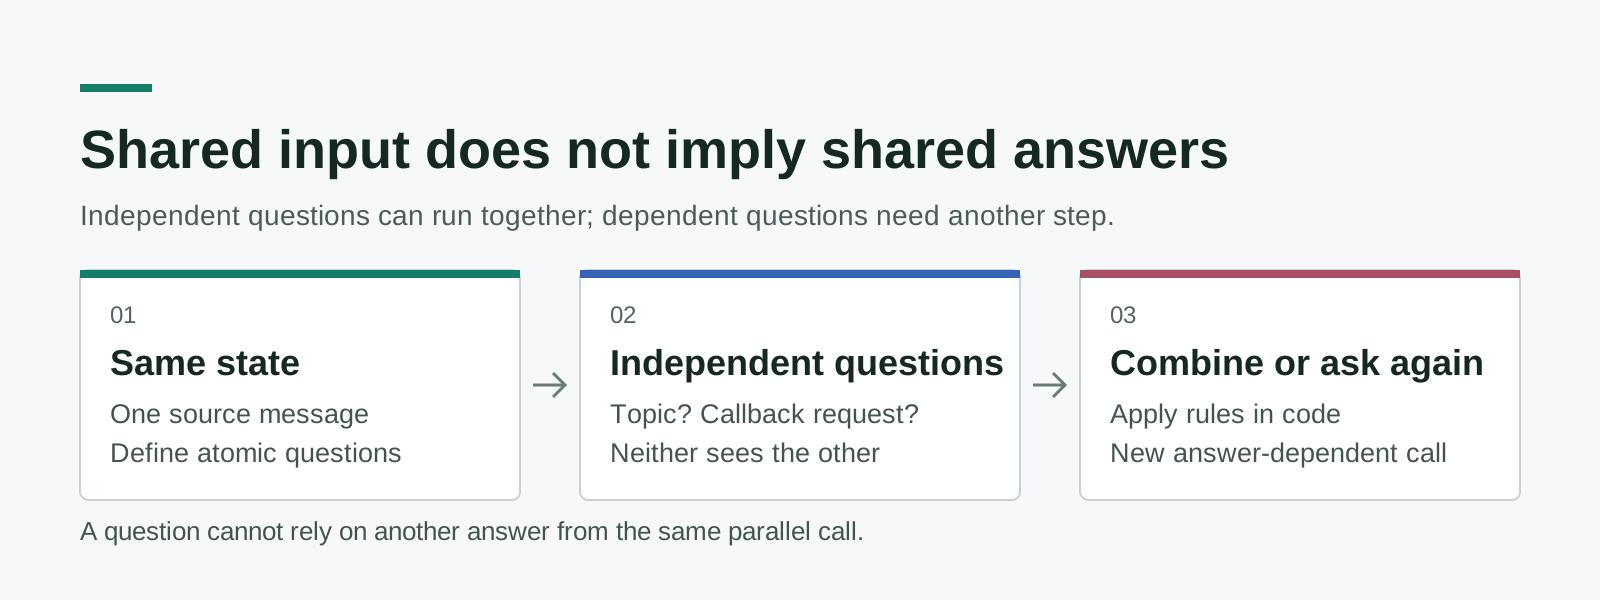
文書化されたfan-out契約に基づくオリジナル図。同時に実行する問いは状態を共有しますが、互いの回答をひそかに参照するわけではありません。
fan-outパターンを使うと、同じ情報源に基づく複数の問いを並行処理し、逐次的な待ち時間を短縮できます。たとえば、メッセージの話題と、折り返し電話を明示的に求めているかは、別々に評価できます。新たに選ばれた話題に依存する問いは、同じ呼び出しの中ですでにその回答が得られている前提にはできません。その依存を後続の手順に分けるか、独立した結果をコードで決定的に組み合わせてください。
型に合う回答でも、正解とは限らない
制約付きモデルについて最も危険なのは、形式の整った回答なら間違いようがないと解釈することです。実際には間違うことがあります。分類器は許可された選択肢から不適切なラベルを選ぶことがあり、操作選択モデルは有効なボタンを選んでも、それが別のフォームにあるかもしれません。インターフェースから形式不正な文章をなくすことには価値がありますが、タスクの誤解とは別の種類の問題です。
TypeSafeのJev 1.13のjaggednessに関する注記は、最終確認日が9月17日で、算術、数え上げ、日付比較、注意をそらす文脈、敵対的入力に関する弱点を説明しています。正確な比較では、日付の解析や数量計算を通常のコードで行ってください。モデルが質問に答えられるという理由だけで、決定的なルールを意味判断に置き換えてはいけません。
確信度のドキュメントも重要です。ChoiceとScoreは確率分布とそこから導いた確信度を示しますが、Noulには独立した確信度フィールドがありません。その数値は、回答が正しい確率を普遍的に表すものではありません。特に、偽陽性と偽陰性の影響が異なる場合、しきい値を自分たちのタスクで検証する必要があります。
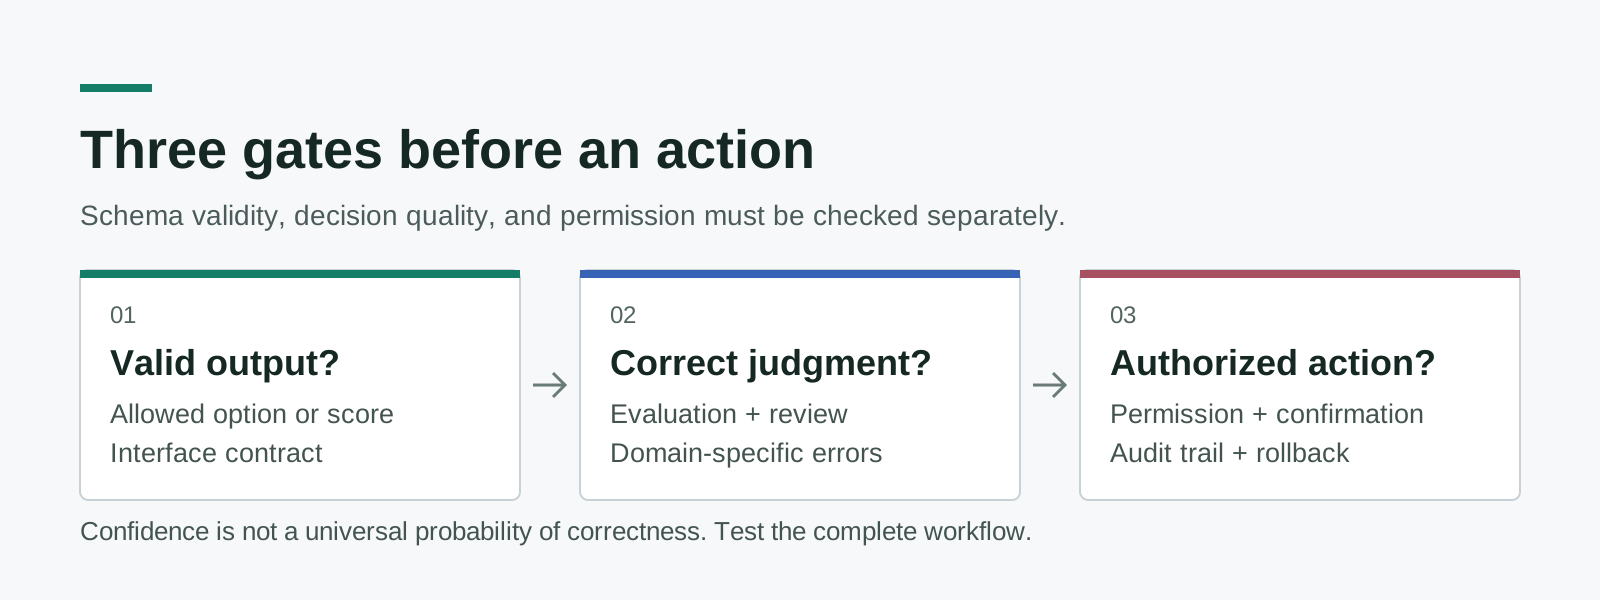
オリジナルの評価図。ひとつの関門を通過しても、次を通過するとは限りません。出力が許可されていても、解釈が正しく、操作が認可されていることを別途確かめる必要があります。
多言語のタスクでは、実際に提供する言語ごとにテストしてください。モデルのドキュメントによれば、主な学習言語は英語で、CJK文字を含む他言語で品質は一様ではありません。したがって、韓国語のサポートキューや複数言語が混在するニュースレターのアーカイブは、英語のスコアをそのまま当てはめず、独立した評価対象にするべきです。翻訳によって根拠が変わることもあるため、翻訳済みの表現を評価するときも原文を残してください。
正直に失敗を測れる試験を作る
有効な試験導入は、チームが一貫してラベル付けできる判断から始まります。サポート窓口の提案、重複の可能性の検出、後で確認する書類へのラベル付けなど、元に戻せるタスクを選びます。デモが滑らかに見えることを成功の定義にしてはいけません。気づける誤り、見落とす可能性がある誤り、それぞれがユーザーにもたらすコストを明確にしてください。
- 判断契約を書く。 可能な結果、必要な入力フィールド、確認用の選択肢を列挙します。意味の解釈と計算、権限を分けます。
- 評価セットを作る。 処理する権限のあるデータを使います。典型例、境界が曖昧な例、複数言語の例、空欄、原文に含まれる悪意ある指示を含めます。
- 別枠の検証データを保持する。 ひとつのセットで評価基準を調整し、文言作成に使わなかったデータで測定します。期待回答を暗黙に変えず、意見の不一致も記録します。
- ワークフローを測る。 カテゴリ別の誤り、確認率、エンドツーエンドの遅延、再試行、総コストを追跡します。遅い検索ループの中に高速なモデル呼び出しがあっても、製品全体は遅いままです。
- 提案モードで実行する。 選択結果、関連する確率、モデルのバージョン、人による修正を記録し、影響の大きい操作を自動実行しないようにします。
- 範囲を限定した操作をひとつ有効にする。 必要に応じて明示的な許可を求め、監査記録と、情報源やモデルのバージョンが変わったときのロールバック手段を用意します。
この手順は、録画を見るだけの場合より意図的に厳しくしています。扱いにくいケースも含め、自分たちのデータ分布でモデルが役立つかを問うためです。少数の高コストな誤りが黙って発生するくらいなら、確認率が高くても許容できるかもしれません。インシデントが起きてからではなく、しきい値を選ぶ前にその兼ね合いを決めてください。
再現可能な評価のためにバージョンを固定し、各結果で返されるバージョンも記録してください。エイリアスの自動更新は試行時には便利ですが、アプリケーションのソースコードを変えずに動作が変わる可能性があります。別の人が評価基準、入力、期待結果、実行境界を再構成できる成果物を残しましょう。そうすれば、有望な実験を、印象的な動画の寄せ集めではなく保守可能な機能にできます。
要点:判断を範囲の明確な契約に収める
Jevの最も興味深い使い方は、すでにルールを把握しているプログラムの中で、小さく確認可能な判断を行わせることです。ブラウザー動画は動作する構成を示し、メールの投稿は試す価値のある具体的な実験を紹介し、公式デモは判断のループを見せています。次に問うべきなのは、モデルが回答を選べるかではありません。判断が重要な結果につながる前に、システムが誤りを見つけられるかです。
出典とメディアのクレジット
- TypeSafe:System One Models and Jevの紹介、2026年9月15日。公式発表とゲーム動画の説明。
- Browser Use:jev-ultrafast、2026年9月30日に確認した固定コミットのソース。GIFとMP4の著作権は2026年 Browser Use、MITライセンス。提携関係を示すものではありません。
- Browser Use:録画と条件をそろえた実行の計測、2026年9月30日確認。執筆者の計測結果であり、こちらで再現したものではありません。
- Xのvogel:1,500通のメール分類実験、2026年9月16日。動画付きの自己申告によるユースケース。
- TypeSafeのプリミティブ、モデル、確信度、fan-out、スマートホームデモ、2026年9月30日確認。
- Jev 1.13のjaggedness、最終確認日2026年9月17日。9月30日確認。
- TistoryのJevユースケース記事、2026年9月18日。調査の出発点であり、導入を検証した資料ではありません。
根拠をノートと一緒に残す
新しいモデルを調べるときは、情報源と日付、デモが実際に示す内容を一緒に保存してください。Telli.shのアカウントを作成すると、要約と原資料を混同せず、自分の調査資料と派生ノートを整理できます。