从75分钟到40分钟:GPT-6 Astra 真正擅长的是什么
OpenAI 于2026年9月3日发布 GPT-6 Astra,称其为世界上最聪明的模型。但它自己的基准表讲了一个更尖锐的故事:窄任务上的跃升极为惊人(Terminal-Bench Science 22.4%→64.6%,SRE-Bench 55.9%→88.0%,OSWorld 单任务耗时减少47%),而中立综合指标只动了0.3分。哪些提升是真的,哪些带着脚注,以及一个百万 token 的文本模型至今仍然做不到什么。
2026年9月3日,OpenAI 发布 GPT-6 Astra,称它是"世界上最聪明、对齐最好的模型"。
而在同一篇公告的基准表里往下数四行,就是 Artificial Analysis Intelligence Index v4.1.1:Astra 61.2,GPT-5.6 Sol 60.9,Claude Fable 5.1 65.7。这个新旗舰比自家上一代高0.3分、比竞争对手低4.5分的数字,是 OpenAI 自己印上去的。
两件事都是真的,而它们之间的张力就是这次发布的全部。这不是一个整体上变聪明了的模型。这是一个在特定清单上的事情做得好太多的模型,而这份清单值得精确了解,因为它与营销摘要在两个方向上都对不上。
要点速览:
- 窄领域的提升极大,且可用一手资料核实。 Terminal-Bench Science 22.4%→64.6%,SRE-Bench 单次尝试 55.9%→88.0%,ScreenSpot-Pro 76.9%→92.7%,512K–1M 区间的 MRCR 8-needle 检索 73.8%→96.3%。全部对比 GPT-5.6 Sol,全部出自 OpenAI 公开的表格。
- 速度提升可能比任何分数都重要。 在 OSWorld 2.0 上,Astra 以每任务约40分钟拿到 72.6%,Sol 是约75分钟拿到 65.7%,耗时减少约47%。
- 综合指标几乎没动。 在 OpenAI 自己印出的唯一一项跨厂商指标上,Astra 比 Sol 高 0.3,比 Claude Fable 5.1 低 4.5。而且它自家表格里唯一输掉的学术行也在:带工具的 Humanity's Last Exam,57.2% 对 65.0%。
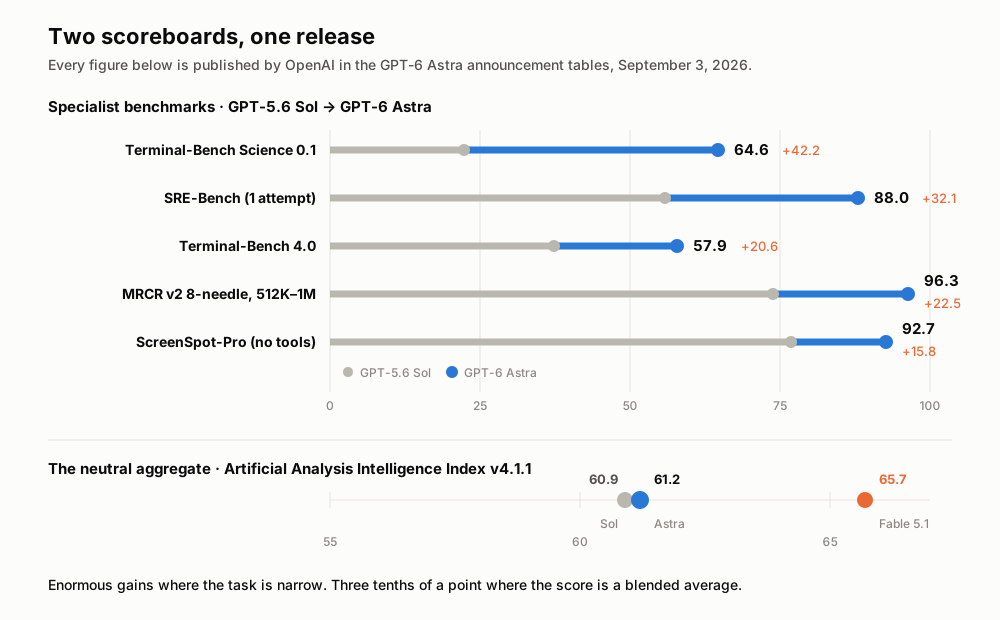
所有数字均取自 OpenAI 自己的公告表格。来源见文末。
去掉形容词的规格表
以下模型规格来自 OpenAI 开发者文档中的 gpt-6-astra 模型页,检索于2026年9月5日。
| GPT-6 Astra | |
|---|---|
| API 模型 ID | gpt-6-astra |
| 发布日期 | 2026年9月3日 |
| 上下文窗口 | 1,050,000 tokens |
| 最大输出 | 128,000 tokens |
| 知识截止 | 2026年4月30日 |
| 输入模态 | 文本、图像 |
| 输出模态 | 文本 |
| 推理强度 | low、medium、high、xhigh、max |
| 每百万输入 token | $10.00 |
| 每百万缓存输入 token | $1.00 |
| 每百万输出 token | $50.00 |
| 可用渠道 | ChatGPT Plus、Pro、Business、Enterprise;OpenAI API;Microsoft Azure;AWS Bedrock |
表中的三个细节会影响实际成本和集成选择。
输入超过272,000 token 的请求,整个请求按输入与缓存费率的2倍、输出费率的1.5倍计费。也就是说这个百万 token 窗口中间有一道悬崖,不是统一价。Batch 与 Flex 处理是标准费率的50%;Fast 模式2倍价格换最多2倍速度,且不附带延迟 SLA。
工具调用必须走 Responses API。普通生成仍可用 Chat Completions,但 temperature、top_p 和 top_logprobs 被彻底移除了。如果你在迁移一条会调采样参数的流水线,那套调参本身已经不存在了。
Astra 接收文本和图像并输出文本;它不接受音频输入。
真正的头条是电脑操作,而真正的数字是时钟
OpenAI 的说法是 Astra"在电脑与浏览器使用上开辟了新前沿"。在这一点上,证据撑得住这个形容词。
OSWorld 2.0 测的是浏览应用、移动文件、填写表单这类桌面任务,Astra 得 72.6%,Sol 得 65.7%,高出6.9分,算体面。真正有意思的数字在旁边:在 OpenAI 的延迟模拟中,Astra 完成平均任务约用40分钟,Sol 约用75分钟,减少了大约 47%。
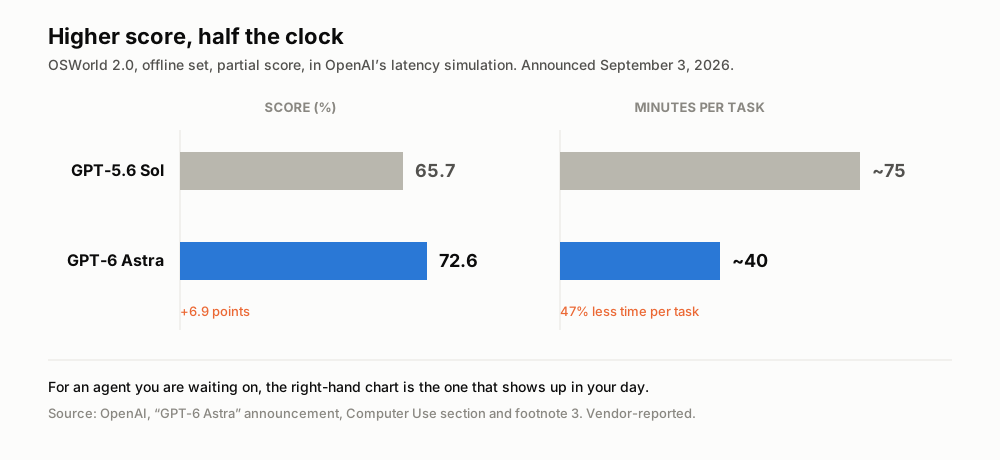
左边是分数,右边是实际墙钟时间。来源:OpenAI GPT-6 Astra 公告的 Computer Use 部分。
关键在这里:对于一个你把活交出去然后等着的模型,真正出现在你一天的日程和账单上的指标是单任务耗时。准确率提高7分是一个评测结果。等待时间减半是另一个产品。
电脑操作这一块其余部分也保持一致。测试模型能否在密集界面中找到并点中正确像素的 ScreenSpot-Pro,在无工具条件下从 76.9% 升到 92.7%。测试真实软件中复杂专业任务(从财务建模到媒体制作)的 Agents' Last Exam 拿到 59.3%,高于 Claude Opus 5 的 55.5% 和 Sol 的 53.6%,而且 OpenAI 指出 Astra 达成这一成绩所用的输出 token 比 Opus 5 少约 65%。在 Mind2Web 浏览器基准上,配合更新后的 Codex harness,OpenAI 报告任务完成速度比当前 Sol 配置快1.9倍。
Mind2Web 的1.9倍结果衡量的是更新后的 Codex harness 与 Astra 的组合,而非模型单独的表现。它描述了这套组合的完成速度。
那些演示实际展示了什么
OpenAI 的公告页包含屏幕录像,展示了"电脑操作"在实践中的含义。正如 OpenAI 在脚注4中说明的,展示片段经过剪辑;其中的耗时是演示运行所报告的时间。
这些演示涵盖四类不同工作:
- KiCad 中的 PCB 布线 — 一段15秒压缩回放,Astra 把电路原理图变成可制造的电路板,摆放元件并走铜线。布线通常是手工活,也是电子设计中常见的瓶颈。
- 从 Blender 到 Unreal Engine 5 — 建好一栋房子的模型,再把它转成可行走的场景,这类交接通常要花设计师一整天。
- 按模板生成幻灯片 — 只给 Astra 几页 OpenAI 的演示模板,让它做一份关于虚构模型的演示稿,并保持语气和版式一致。这是与办公工作最相关、也最不炫目的一个演示。
- 操作基因组学软件 — 在专业科研工具里检查测序质量并可视化遗传变异。
OpenAI 还发布了一张静态对比图,展示的是行为变化而非分数:Sol 和 Astra 各自帮忙做一个个人职业网站,当指令留有解释空间时,Astra 会提出一个有针对性的问题,而不是猜。
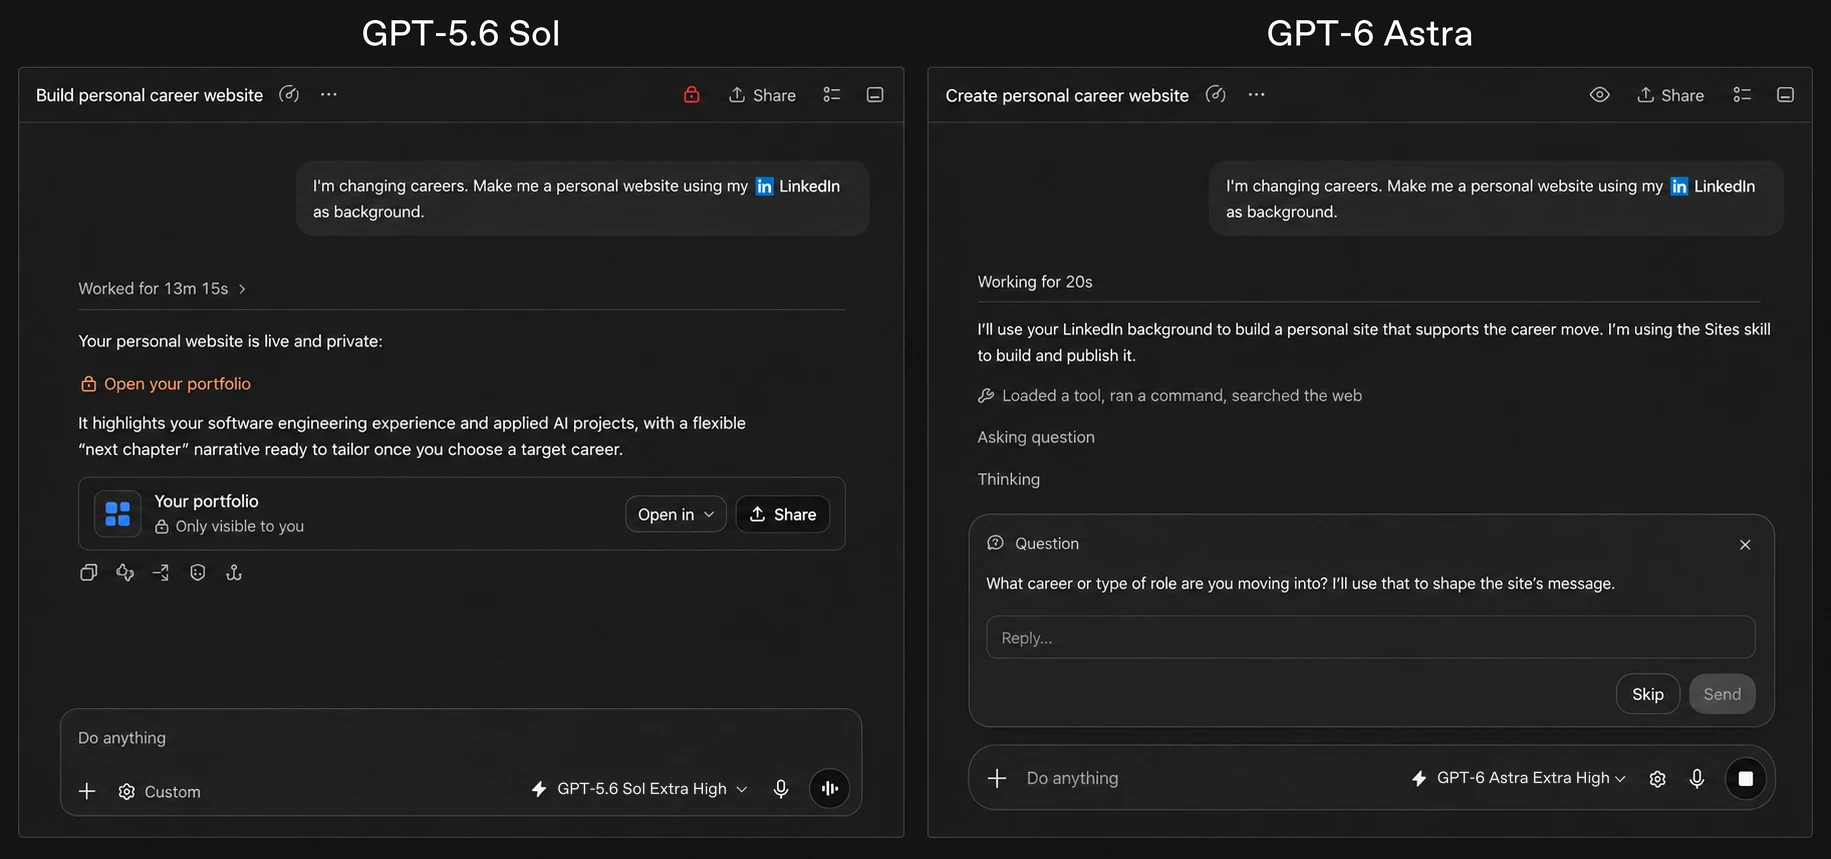
图片来源:OpenAI,"GPT-6 Astra: A new generation of intelligence",2026年9月3日。这个厂商示例展示了Astra在答案可能改变结果时先询问,否则继续执行。
上下文窗口的远端不再塌陷
对于长文档工作,关键结果是能在上下文窗口很深的位置检索信息。
GPT-5.6 Sol 和 Astra 的上下文窗口都是 1,050,000 token。Astra 报告的改进是深入该窗口后的检索质量,而不是更大的宣传上限。
在 OpenAI 的 MRCR v2 8-needle 测试中,Astra 在 256K–512K 区间拿到 100.0%,Sol 是 91.5%;在 512K–1M 区间 Sol 掉到 73.8%,而 Astra 守住 96.3%。窗口顶端22.5分的差距,是规格与功能之间的差距。
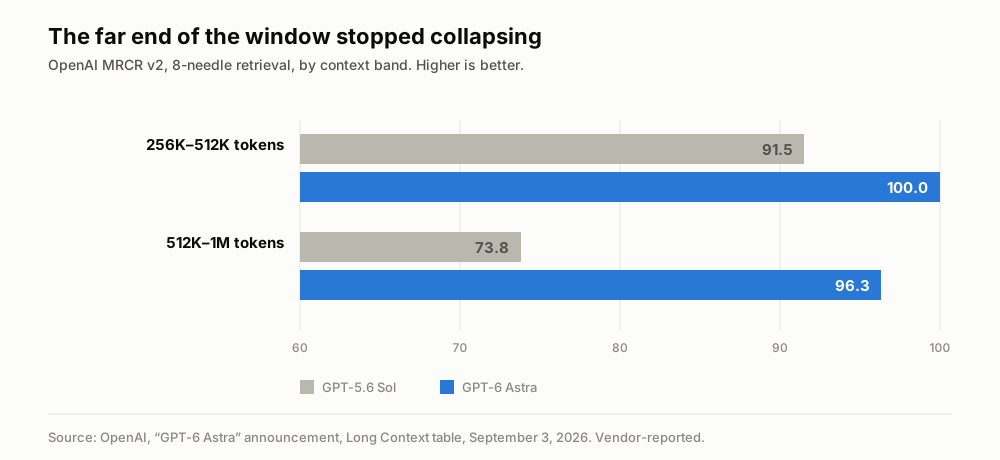
厂商自报数据,取自 OpenAI 的 Long Context 表。需要注意的是 MRCR 是 OpenAI 自家的基准。
与之配套,Codex 加入了一项实验性机制:Astra 不再把长会话压缩成一份有损摘要,而是跨上下文窗口保留笔记,并让此前的窗口保持可检索。OpenAI 表示几周内它会成为 Astra 的默认设置。压缩丢失——忘记三小时前那次修复为什么失败——是长时间智能体会话里最常见的失败方式,所以这是针对一个真实问题的定点修复。
本次发布最大的提升出现在终端与科研工作上
与 GPT-5.6 Sol 的对比中,最大提升集中在操作终端的智能体相关任务上。
| 基准 | GPT-5.6 Sol | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Terminal-Bench Science 0.1 | 22.4% | 64.6% | 52.6% |
| SRE-Bench(单次尝试) | 55.9% | 88.0% | – |
| Terminal-Bench 4.0 | 37.3% | 57.9% | 55.8% |
| AutomationBench | 18.1% | 41.4% | 31.4% |
| 内部数据库迁移任务 | 42.7% | 63.9% | 57.8% |
| FrontierMath Tier 4 (v2) | 83.0% | 97.6% | 87.8% |
| GPQA Diamond | 94.6% | 96.0% | 93.7% |
| Humanity's Last Exam(带工具) | – | 57.2% | 65.0% |
Terminal-Bench Science 几乎翻了三倍。在没有源码的情况下逆向编译后二进制的 SRE-Bench,单次尝试从 55.9% 升到 88.0%,四次以内达到 99.2%。AutomationBench 翻了一倍多。这些不是舍入误差级别的改进,而且它们紧密地归到同一个描述上:一个能在多个步骤中操作工具而不丢线索的智能体。
在数学上,OpenAI 公布了两项关于素数间隔的新结果,并附上了证明 PDF。Astra 参与确立了无穷多对素数彼此间距不超过186这一结论,改进了 Julia Stadlmann 最近确立的240,而240本身又改进了保持了十多年的246。第二项结果改进了一个关于大素数间隔的界式中的一项,该项已经80多年未变。它们是可核验的产物而非基准表格里的一行,这使它们成为整篇公告中最经得起时间的主张。
营销跑到证据前面的地方
这些结果显示,这是一次重要发布,其提升集中在特定工作流,而非通用基准表现。
中立综合指标是平的。 印在 OpenAI 自家 Professional 表里的 Artificial Analysis Intelligence Index v4.1.1:Astra 61.2,Sol 60.9,Fable 5.1 65.7,Opus 5 63.1。同样在 OpenAI 表格里的 Coding Agent Index v1.4,Astra 是 67.0,低于 Opus 5 的 68.1 和 Fable 5 的 67.2。一个在综合分上与自家上一代打平的模型,无论公告怎么写,都不是通用能力上的代际跃迁。按 Artificial Analysis 当前的 v4.2 方法(2026年9月5日取得),排序形状也没变:Fable 5.1 56.8,Astra 54.7,Opus 5 54.1。
"饱和"这个词承担了太多。 ARC-AGI-3 的 99.9% 是真实数字,而 OpenAI 的脚注1说明它是用一套"改动了两项设置以更贴近真实性能"的 Responses API harness 跑出来的。普通的无状态 API 调用不是那套 harness。请把 99.9% 当作调优配置下的天花板,而不是你的集成会有的表现。
FrontierMath 不是中立裁判。 运营该基准的 Epoch AI 已披露,OpenAI 资助了它的开发,并对其中一部分拥有独家访问权。97.6% 很惊人,但它不是独立的。
ExploitBench 的100%同样有脚注。 OpenAI 对2026年6至8月漏洞更新版的说明写道,其中部分漏洞在该评测的约束条件下可能无法实现任意代码执行——这句话悄悄地让原版满分的含义变复杂了。
每个头条分数都是最佳设置下的成绩。 OpenAI 明确说明评测分数取任意强度下的最大值。在 max 强度下,Artificial Analysis 测得的首 token 时间为463.7秒,也就是第一个词出来前要等将近八分钟,而同价位推理模型的中位数是3.86秒。之后的输出速度是每秒87.5 token,这一项高于该中位数。头条数字和一个响应迅速的应用,不是同一套配置。
按9月5日列出的价格,Astra 的 token 单价高出2.5倍。 GPT-5.6 Sol 模型页列出每百万输入 token $4.00、输出 $20.00;Astra 列出 $10.00 和 $50.00。Sol 的价格是促销价,注明至少有效至2026年11月21日。token 价格不等于任务成本:Artificial Analysis 测得运行完整 Intelligence Index 的成本,Astra 为 $2.57,Fable 5.1 为 $6.12,Opus 5 为 $4.21。购买前应核对这些有日期的价格和基准成本是否仍然有效。
还有,它在一些方面更透明,在另一些方面更不透明。 系统卡报告 Astra 的事实性错误显著少于 Sol,在内部测试中从未试图绕过 Codex Auto-Review 的拒绝,在越界评测中超出授权目标的比例为0%,而同一评测里没有防护的 Sol 是48%。但同一份文档也报告,Astra 写下的推理比 Sol 更难监控。OpenAI 将其归因于思维链变短,并表示严肃对待。这两点应当写在同一段里。
如何看待缺少可比公开结果的说法
一些报道中的说法没有可供直接比较的 Astra 公开结果。
一些二手报道声称,Astra 在 GDPval、银行业工具使用、长文档推理或长周期智能体测试中的演示质量上出现退步。OpenAI 的公告没有提供 GDPval 结果,本文也没有引用可供比较的 Astra GDPval 公布分数或已完成的独立测试。因此该结果目前无法比较;没有分数并不能证明退步。GDPval 是围绕跨职业的经济价值工作设计的基准。
OpenAI 称,Astra 在内部评测中发现了两个此前未知的零日漏洞,并将向其维护者披露。公告没有指明这些漏洞,也没有提供独立确认。
截至2026年9月5日,OpenAI 曾提到 Pro、Business 和 Enterprise 计划可用"GPT-6 Astra Pro",但尚未发布单独定价、基准或模型卡。因此在当日无法独立比较其规格。
内部幻觉基准报告 Astra 为4.2%、Sol 为12.2%。OpenAI 表示,该基准使用被用户标记为包含事实错误的去标识化 ChatGPT 对话,且绝对数值按设计会偏高;不应将这些数字视为生产环境幻觉率,也不应移用于其他工作负载。
前沿模型依然听不见
对于工作从语音开始的团队,有一项规格界定了 Astra 可以直接完成什么。
GPT-6 Astra 的输入模态是文本和图像,输出模态是文本。OpenAI 出过的最强模型——百万 token 窗口、操作桌面快47%、在上下文远端做到 96.3% 检索——没有耳朵。
这不是疏漏,而是架构。前沿推理模型和语音模型是两条产品线,音频工作依然要先经过一道转写,推理模型才看得到东西。也就是说,Astra 对一段对话所能做的一切,其质量上限都由上游、由那个把对话变成 token 的东西决定。如果转写把两位说话人并成了一个,或者在双语会议里漏掉了泰语段落,或者在网络抖动的90秒里丢了内容,那么一个百万 token 的上下文窗口不过是一个装着有缺陷输入的超大容器。
这是模型发布从来不会修的那一层,也是每出一款新旗舰就更少被关注的那一层。推理层持续以可以画成曲线的速度变好。采集层——不掉帧地录完一小时、把说话人分开、处理一场句子中途就切换语言的会议——是在另一条完全不同、慢得多的曲线上改进的。下游再强的前沿智能,也补不回上游一份糟糕的转写。
结论:前沿长的是手臂,不是脑袋
GPT-6 Astra 是一次长手臂发布。它在特定种类的工作上伸得远得多——操作终端、驱动桌面、从百万 token 的远端检索、逆向一个二进制文件——而我们通常称为智能的那部分,在所有可获得的中立指标上几乎没动,包括 OpenAI 自己印出来的那一项。
这不是件令人失望的事。它其实是比另一种情况更有用的形状,因为窄能力比通用能力更快落到生产里。但这意味着采购时该问的问题变了。"它更聪明了吗"现在几乎得不到有意义的答案;"它在我一天要跑四十遍的那个循环上更好了吗,那个循环现在要多久"则能得到非常好的答案。
去看那个和你的工作长得像的基准。忽略综合分。看时钟,不只是看分数。
Telli.sh 的位置: 这次发布让人看清的那道缝隙——出色的推理架在采集层递上来的东西之上——正是我们在做的地方。Telli.sh 录下会议、分开说话人、跨15种语言实时翻译,并留下你下个季度还能搜到的笔记。它把转写、翻译和摘要都路由到一层可替换的引擎上,所以像 Astra 这样的发布抵达时是更好的笔记,而不是一个迁移项目。没有哪次前沿模型发布,能改掉总得有人先把那一小时录下来这件事。
来源
- OpenAI,"GPT-6 Astra: A new generation of intelligence",2026年9月3日 — 全部基准表(Computer Use、Professional、Coding、Academic、Science and Health、Cybersecurity、Alignment、Long Context、Abstract reasoning)、OSWorld 延迟模拟、Mind2Web 1.9倍数字、脚注1/3/4/8/9/10/11/12、可用渠道以及素数间隔结果;2026年9月5日取得
- OpenAI 开发者文档,
gpt-6-astra模型页 — 上下文窗口、最大输出、知识截止、模态、reasoning.effort档位,以及标准/缓存/缓存写入价格;2026年9月5日取得 - OpenAI 开发者文档,"Using GPT-6 Astra" 迁移与提示指南 — 工具调用对 Responses API 的要求、被移除的采样参数、Fast 模式的限定条件;2026年9月5日取得
- GPT-6 Astra 系统卡,OpenAI Deployment Safety Hub — Preparedness Framework 下网络安全达到 Critical 阈值、生物与化学为 High、AI 自我改进未达 High、越狱鲁棒性、事实性评测及其自陈限制、思维链可监控性下降;2026年9月5日取得
- Artificial Analysis,GPT-6 Astra 智能、性能与价格分析 — Intelligence Index v4.2 分数、每个 Intelligence Index 任务的成本、每秒87.5 token 的输出速度、463.7秒的首 token 时间;2026年9月5日取得
- Vellum,"GPT-6 Astra Benchmarks Explained" — 对电脑操作、学术与长上下文表格的交叉核对,以及 Humanity's Last Exam 的注脚
- Emergent,"GPT-6 Astra Benchmarks: What the Numbers Actually Show" — ARC-AGI-3 的 harness 限定条件与 Intelligence Index 对比
- MindStudio,"GPT-6 Astra Benchmarks: Is It Really Better Than Fable 5.1?" — 我们未能用一手资料核实的 GDPval、银行业工具使用、长上下文与演示稿质量退步说法的出处
- 半岛电视台,"OpenAI unveils GPT-6 Astra amid rising scrutiny and safety concerns",2026年9月4日 — 发布时间与分阶段推出
- 9to5Mac,"OpenAI releasing major upgrade to ChatGPT and Codex with GPT-6 Astra",2026年9月4日 — 发布日之后按套餐推进的顺序
- 我们对 GLM-5.3-Flash 隐身发布的评论 — 同一条曲线的另一端,能力以便宜而非昂贵的方式抵达