GoogleのRSIの噂から考えるAGI:AI開発のペースを巡る議論
AGIと再帰的自己改善を基礎から解説。Googleの噂をXの原文までたどり、アモデイ、アルトマン、マスクの提案とトランプの対中競争論を検証し、加速する未来の可能性と条件を考えます。
難しいプロジェクトを完成させてくれるAIは役立ちます。さらに優れたAIを作る仕事を助けるAIなら、便利な道具が登場する速さそのものを変える可能性があります。Googleを巡る短い謎めいた投稿が注目された背景には、この期待があります。ちょうど競合企業のリーダーたちも、開発のペースを調整する考えを公に支持し始めました。
まず二つの用語を分けると、話が追いやすくなります。AGIは汎用人工知能のことで、さまざまな知的課題を学び、こなせる幅広い能力を指します。RSIは再帰的自己改善のことで、AIがAIシステムの改善に貢献し、その成果が次の改善をさらに助ける過程です。一方は能力の範囲、もう一方は進歩の成果が次の進歩に戻ってくる仕組みを表しています。
この記事ではGoogleの噂をXの原文までたどり、開発ペースの調整に対する支持表明と実際の合意を区別したうえで、研究サイクルの加速が日常にもたらす変化を考えます。調査の基準日は2026年9月14日です。私は、より良い道具が専門知識をもっと身近にすると期待しています。ただし望ましい未来には、結果を確かめる時間と、方向を変える権限も必要です。
最初に押さえたい三つの区別
- AGI、RSI、超知能は異なる概念です。いずれもAIに意識があるという意味ではありません。
- Googleの公開研究からは、AIがAI開発を支援していることが分かります。一方、拡散しているXの投稿だけでは、完全自律で持続的な改善ループは立証されません。
- 複数の業界リーダーがペース調整と外部評価を支持しました。ただし、業界全体が署名し、履行する減速合意が成立したことまでは示していません。
AGIで問われるのは、異なる仕事を学び、こなす能力だ
専門システムは一つの課題で並外れた力を発揮できます。チェスエンジンは王者に勝てても、賃貸契約を説明したり、研究計画を立てたり、新しい業務手順を覚えたりできるとは限りません。AGIが目指すのは、初めて出会う課題も含め、さまざまな知的作業に能力を応用できるシステムです。仕事の内容が変わっても、役に立つ方法を学び続けられるかが問われます。
誰もが認める唯一の到達基準はありません。DeepMindの研究者は2023年11月、性能、汎用性、自律性などの観点からAGIを評価する枠組みを提案しました。そこには大切な区別があります。多くの仕事が得意であることと、独立して行動する許可を与えられることは別の性質です。高い能力を持つシステムも、権限を限定して運用できます。「Levels of AGI」、初回投稿2023年11月4日。
小さな非営利団体を手伝う架空のアシスタントを考えてみましょう。見慣れない表計算を理解し、助成金の申請書を書き、予算の矛盾を見つけ、報告のルールも学ぶ必要があります。説得力のある実証には、こうした仕事の変化を通して安定して成果を出すことが求められます。助けを求めるべき場面を判断する力も含まれます。完成度の高い申請書が一つあるだけでは、この幅広さを確かめるには足りません。
ベンチマークの点数が知能全般の証明書にならないのも、そのためです。ベンチマークが示すのは、決められた条件で特定の課題をどれだけ達成したかです。長期的な信頼性、不慣れな環境、実用上の費用、失敗から回復する能力は測定範囲に含まれないことがあります。AGIが発表されたら、どの能力を、どの水準で、どれほど広い課題にわたり、どの程度の補助を受けて示したのかを確認すると役立ちます。
ASIは人工超知能で、通常は幅広い認知領域で人間を大きく上回る能力を指します。優れたモデルなら何でもそう呼ぶわけではありません。AGIやASIという言葉から、意識や感情、人間のような内面の存在が自動的に導かれることもありません。ここで扱うのは能力、開発過程、そしてそれを巡る人間の選択です。
RSIでは、進歩の成果が次の進歩の生み方を改善する
通常のソフトウェアは、人が問題を見つけ、変更を提案し、試験し、効果があった変更を残すことで改善します。AIはすでに各段階を支援できます。速いアルゴリズムの提案、テストケースの生成、失敗した実験の原因調査などです。RSIで重要なのは、そこで得た成果によって次の改善作業まで上手になることです。
自分たちの道具を改良する研究工房を想像してください。より良い測定器を使って次の測定器を作り、その測定器がさらに後の改良を助けます。成功した変更によって、次の実験でできることが増えるわけです。重要なのは工房が忙しくなることではなく、改善が実際に確かめられ、保持され、その後の研究に役立つかどうかです。
チャットボットが回答を5回書き直しても、基盤モデルそのものが改善したとは限りません。メモリ機能は、ネットワークの学習済みパラメータを更新せずに情報を保持できます。コーディングエージェントは、動力となるモデルを変えずに自分の道具を改良できます。いずれも有用ですが、強い意味でのRSIは、より良いAIシステムを生み出す能力そのものが連続して向上することを指します。個々の仕組みは、以前の継続学習と改善ループの解説でも扱っています。
| 概念 | 確かめたい問い | これだけでは足りない |
|---|---|---|
| AGI | 幅広い知的課題を学び、遂行できるか | 狭いベンチマーク一つでの優秀な成績 |
| RSI | 改善の成果が、その後のAI改善をより効果的にするか | 回答の繰り返し、コード量の増加、意味ありげなモデル名 |
| ASI | 多くの認知領域で人間の能力を大きく超えるか | 一つの専門課題で人間を上回ること |
この定義からは、AGIとRSIが決まった順序で実現する必要はないことも分かります。日常の多くの課題が苦手でも、AI学習の最適化には貢献できるシステムは考えられます。逆に、幅広い能力を持つAIが、人間の指揮する開発過程から生まれることもあります。RSIは汎用性の向上を早める可能性がありますが、図にその3文字を書くだけでは行き着く先まで証明できません。
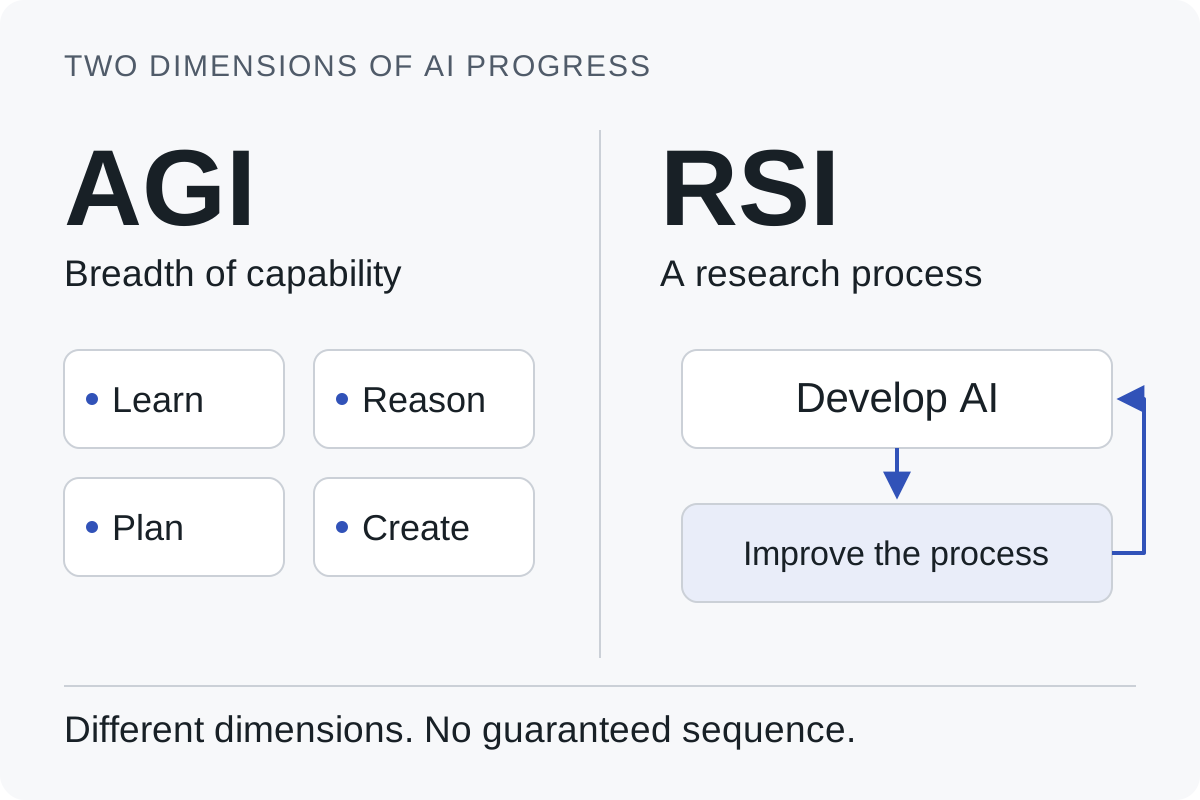
独自に制作した概念図です。AGIとRSIは異なる軸であり、必ずこの順番で到達するという意味ではありません。特定モデルの測定結果ではなく、本文の定義を図示しています。
Googleの噂をたどると、二つの投稿に行き着く
9月14日のAI Timesの記事は、AIコミュニティで広がった噂を紹介しています。記事に埋め込まれた投稿と、その後の解説のリンクをたどると、出発点が少数の投稿に絞られます。再投稿が100件あっても、多くが最初の主張を繰り返しているだけかもしれません。それを100件の独立した確認と受け取らないために、出典の経路が重要になります。
9月11日、Lyra(@lyraxana)はGoogle DeepMindをタグ付けした短い祝福の投稿をしました。大文字と小文字の使い分けでR、S、Iが目立つようになっていました。実験方法、性能結果、人間の関与についての説明はありません。略語から意味を推測するよう促すメッセージでした。
同じ日にLentils(@Lentils80)がLyraの投稿を引用し、rsi-model-liverl-leという内部モデルと、番号の付いた10個の学習枠があると述べました。添付された画面も憶測の材料になりました。しかし、これは内部の一覧だと主張されている資料についての話です。今回の調査では、その真正性や実際に稼働するシステムとの関係を独立に確認できていません。
9月12日にはChubby(@kimmonismus)が噂を広め、同じLyraの投稿にリンクしました。情報が伝わった経路は確認できますが、技術的突破を裏付ける新たな独立情報源が増えたわけではありません。過去のリークに関する評判も、今回の主張を支える証拠の代わりにはなりません。
内部の名前が本物でも、中心的な問いは残ります。目標を達成する前に、その目標をプロジェクト名に使うことはあり得ます。人間の指示に大きく依存しながら、一部の部品だけを改善した実験かもしれません。強い結論を出すには、測定結果、明確な比較基準、どこを自動化したかの説明が必要です。
したがって、基準日時点で確認できる結論は限定的です。GoogleのRSIの噂には追跡可能なXの出典がありますが、投稿は完全自律のRSIを立証していません。 今回確認した公開資料では、疑惑の一覧を認証したり、その解釈を裏付ける反復的・独立した評価を示したりするGoogleの発表は見つかりませんでした。これは調べた公開証拠の限界であり、非公開の成果が存在しない証明ではありません。
流出した名前より、Googleの公開研究から多くを学べる
噂が注目された背景には、実際の研究があります。GoogleはAIがAI開発を支援する過程を公表しています。2026年9月2日のGemini 3.8発表では、長時間稼働するエージェントのループが、基盤モデルを再帰的に評価し、改良する役割を果たしたと説明しました。出典の明確な開発過程の説明ですが、後継システムを完全自律で連続開発する仕組みまで示したものではありません。GoogleのGemini 3.8発表。
以前の成果は、改善の規模を具体的に示します。Google DeepMindは2025年5月、AlphaEvolveがGemini学習の重要なカーネルを23%改善し、学習時間全体を約1%短縮することに貢献したと報告しました。このコーディングエージェントは、言語モデル、自動評価、選別を組み合わせて優れたアルゴリズムを探索しました。AlphaEvolve発表、2025年5月14日。
23%と1%の差には意味があります。一つの構成要素を改善しても、開発サイクル全体が同じ割合で速くなるわけではありません。他の作業には依然として時間がかかります。それでも、高価な学習過程に繰り返し適用される小さな節約は重要です。有効な最適化が、次のモデルを作る工程の一部として残るからです。
ファイル名の意味を推測するより、こうした成果の方が期待を支える確かな材料になります。最も強い形のRSIが実証される前でも、この分野は実質的な進歩を生み出せます。AIが自分の未来すべてを独力で発明するようになったと主張しなくても、工学上の成果は評価できます。
Anthropicも2026年6月4日、自社の開発について同様の区別を示しました。実装や実験へのAIの参加は増えている一方、研究の方向付けや判断には課題が残ると説明しています。完全自律で後継システムを開発する可能性は、条件付きで論じられていました。これは自社の仕事についての観察であり、自律的なRSIを独立に実証したものではありません。「When AI builds itself」。
アモデイ、アルトマン、マスクはペース調整を公に支持した
9月12日、Anthropic CEOのダリオ・アモデイは、安全性の検討が追い付けるよう、最先端AIの開発ペースを調整する提案を公表しました。柱は、社内に常駐する独立評価者、民主主義国の主要開発者間の協調、さらに広い国際協調の三つです。Anthropicは評価者の導入を約束し、より広い協調は今後の課題として提示しました。アモデイの9月の論考。
続いてサム・アルトマンはXでペース調整への支持を表明し、OpenAIも独立評価者に社員並みのアクセスを提供すると述べました。イーロン・マスクも短い投稿でアモデイの立場を支持しました。いずれも直接確認できる支持表明です。その意味は明確に伝えるべきですが、発言にない詳細な実行合意まで付け加えるべきではありません。
| 公表された行動 | 確認できること | まだ確認できないこと |
|---|---|---|
| アモデイの提案とAnthropicの評価者導入の約束 | 具体的な監督案と一企業の約束 | 完成した世界規模の協調体制 |
| アルトマンの応答 | ペース調整への支持と同趣旨の評価者導入の約束 | 全研究所の学習・公開日程を縮小する合意 |
| マスクの支持表明 | アモデイの立場への公の支持 | 詳細な実行計画や独立に確認された減速 |
ペース調整は、AI研究を全面的に止めることとも異なります。アモデイの提案は、進歩を続けながら安全対策と外部評価の時間を確保する考えです。難しいのは実行です。何を評価し、誰がアクセスし、不都合な結果を誰が公表できるのか。企業が評価に同意しない場合にどうするのか。約束が行動を変えるかは、これらの問いに左右されます。
私が重視するのは、競争相手同士が共通の問題を公に認めたことです。それによって競争上の動機が消えるわけではありません。顧客、政府、競合開発者が評判だけを根拠に安心しなくて済むことに、独立評価の価値があります。判断の基準は声明の印象より、その後の実行を示す証拠であるべきです。
制度の設計に懸念を持つことも正当です。遵守費用が高過ぎると、すでに大きな予算を持つ組織に有利になります。だからこそ、リスクに見合う規則、説明責任を負う評価者、小規模な開発者が参加できる余地が必要です。ただし、その懸念だけで安全上の問題が捏造されたとか、Googleの噂がペース調整の呼びかけを引き起こしたとは断定できません。
トランプは中国との競争を議論の中心に置いた
9月13日、トランプはアイルランドで記者団に対し、米国の対中AI優位を維持したいと述べ、開発を抑える要求に消極的な姿勢を示しました。一部の安全措置は認めましたが、具体的な規則は示しませんでした。競争を減速させることへの抵抗を表した発言であり、成立済みの業界合意を拒否した出来事ではありません。AP通信、9月13日、CityNews掲載。
戦略的な問題は理解できます。一方だけが費用のかかる制限を受け入れ、競争相手が受け入れなければ、差は経済力や安全保障に影響します。機能する国際的な取り決めには、参加者が約束を守っているか確かめる仕組みが必要です。協力すべきだと宣言することより、信頼できる検証制度を作ることの方がはるかに難しいのです。
一方で、競争に勝つことと、その結果を制御することは別々に達成すべき課題です。回避可能な失敗を起こすシステムが、自国製だから信頼できるようになるわけではありません。私は、主導権には強力なシステムを学習させる力だけでなく、試験し、保護し、管理する力も含めるべきだと考えます。そうした能力は、持続的な優位を支える可能性があります。
この議論を「安全を気にする側」と「中国を気にする側」に分けると、実際の論点を見失います。アモデイの提案も、優位を保ちながら国際協調を求めています。相違の一部は手段にあります。開発速度を最大化するのか、共同の監督を強めるのか、あるいは検証可能な方法で組み合わせるのかが問われています。
改善する研究ループは、次の発見までの時間を縮め得る
期待されるのは、次のアシスタントの回答が上手になることだけではありません。優れたアシスタントが、その次の世代を作る作業を短縮し、その世代がさらに研究過程を改善する可能性です。成果が引き継がれ、保持されれば、進歩は単発の更新で終わらず積み重なります。
意味のあるループには複数の役割があります。有用な問題を選び、変更案を出し、実験し、結果を評価し、証拠に裏付けられた改善だけを残します。その成果が次のサイクルを助けます。提案を速く作ることも役立ちますが、妥当性を維持しながら全工程を短縮する方がはるかに重要です。
以前は一つの方法を検討していた時間で、有望な方法を十通り試せるチームを想像してください。追加の実験の一部は失敗するでしょう。それは自然なことです。利点は、どの方法に資源を増やす価値があるかを早く学べる点にあります。実験の選び方も改善すれば、試行回数だけでなく、一回から有益な情報を得る可能性も高まります。
これは条件を置いた例であり、進歩が十倍になる予測ではありません。研究には依存関係があります。ある実験が別の実験結果を待つ場合も、予想外の失敗を理解するために測定方法の開発から必要になる場合もあります。計算量を増やしても有用な洞察が保証されるわけではありません。重要なのは、同時に忙しく動くエージェントの数より、検証済みの学びが増える速さです。
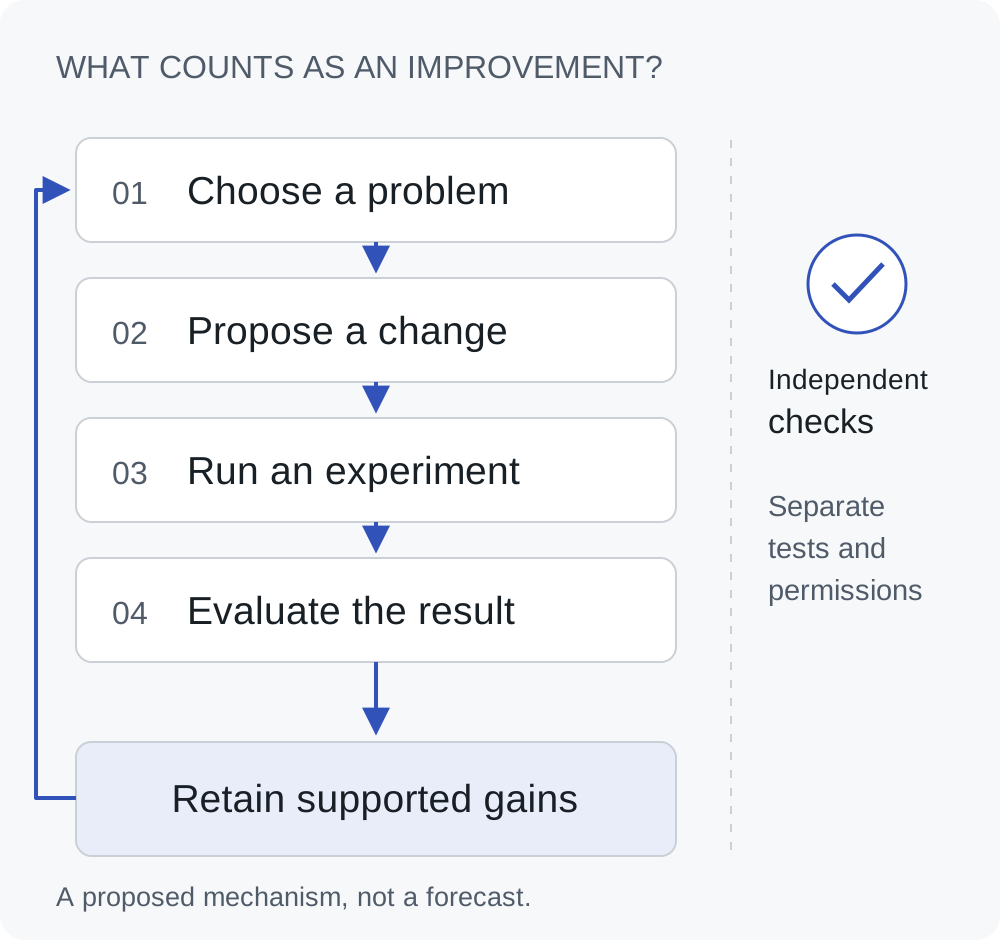
独自に制作した仕組みの図です。改善は評価後に次のサイクルへ渡し、独立した点検はループの外に置きます。どこかの研究所が完成させた仕組みではなく、必要と考える運用原則を示しています。
この過程が信頼できるものになれば、変化の周期の感じ方も変わるでしょう。組織が前の版に適応している間に、道具がまた改善するかもしれません。高過ぎると見送った計画が実行可能になったとき、次の制約は検証や提供の工程へ移っているかもしれません。加速はモデル発表の驚きだけでなく、何が可能で、どこに時間がかかるかの変化として経験されるはずです。
思考が速くなっても、現実の世界には時間がかかる
簡単な思考実験で限界が分かります。研究サイクルの80%を十倍速くでき、残り20%は変わらないとします。全体の所要時間は元の28%となり、速度向上は十倍ではなく約3.6倍です。計算は0.8を10で割り、0.2を足すだけです。これは研究所の実測値ではなく、原理を説明するための仮定です。
変わらない部分は、意外に早く全体の時間を左右するようになります。ハードウェアの調達待ち、代表性のあるデータ収集、安全性の確認、結果の再現などが考えられます。生物医学なら実験室での作業や臨床的な証拠、エネルギーなら材料、建設、送電網への接続が必要になります。推論能力が高まっても、こうした依存関係は消えません。
継続的に改善するモデルが登場しても、世界全体がすぐ同じ速さで改善するわけではありません。発見、製造、流通、導入には異なる時間がかかります。AIで緩和できる制約もあれば、制度、投資、物理的な能力が必要な制約もあります。現実的な期待には、そのすべてを改善する仕事が含まれます。
強い形のRSIが途中で停滞する可能性もあります。成果が次の段階に通用しなくなる、実験費用が増える、現在の方法では見つけられない洞察が必要になる、といった場合です。それでも、すでに有用な能力を広く届けるだけで大きな違いを生み出せます。良い道具へのアクセスを改善するために、無限の加速を前提にする必要はありません。
警戒すべきなのは、誤りも次の世代に残ることだ
改善を保持するフィードバックは、誤りも保持できます。研究エージェントがテストの弱点を利用して評価点を上げる変更を見つけたとします。それを本当の進歩として受け入れれば、その後の仕事もその成果の上に積み重なります。評価基準を満たすことだけが得意になり、現実の役立ち方は悪化するかもしれません。
これは構造上のリスクを説明する例であり、流出したとされるGoogleのモデルがそう振る舞ったという証拠ではありません。評価の仕組みを評価対象から守る必要性を示しています。独立したテスト、分離された権限、再現可能な記録は、誤った成功判定が次の版の土台になることを防ぐ助けになります。ループが速いほど、この分離が重要になります。
人間にも同じ問題があります。仕事量が増えると、以前の変更がうまくいったという理由で、理解していない変更まで承認し始めるかもしれません。時間、関連する証拠、停止する能力がなければ、人間が承認ボタンを押していても実質的な監督にはなりません。異議を述べられる本当の機会を、設計で保つ必要があります。
そのため私は、開発速度と対応に使える時間の関係に注目します。問題をどれほど速く発見できるか。影響する過程を停止できるか。公開を取り消し、重要な結果を元に戻せるか。文章作成の支援、研究システム、重要インフラへアクセスするソフトウェアでは、それぞれ答えが異なるでしょう。
警告もリスクに見合うものであるべきです。すべての改善ループが危険になるという予言でも、有用なAIを使わせないという主張でもありません。権限を段階的に与え、各段階で結果を点検するということです。能力の進歩が速いほど、漠然とした信頼だけを主な制御手段にはできません。
より良い未来では、専門家の助けが身近になる
私がこの研究に期待するのは、役立つ専門知識を得やすくなり、同時に人がその内容に疑問を持てる未来です。小さな組織も、大規模な専門家チームを先に集めずに難しい問題を検討できる。学生は理解が止まった場所に合わせて、根気よく説明してもらえる。研究者は道具を動かす準備に費やす時間を減らし、何を調べる価値があるかに集中できる。そうした変化を望みます。
これはAGIの発売日に結び付けた約束ではなく、考えられる未来像です。価値は、慎重に仕事をする費用を下げることにあります。選択肢を比較し、前提を確かめ、未知の分野を探れる人が増えれば、従来は試されなかった有意義な計画も始められます。その利益は、必ずしも人を過程から外すことに依存しません。
医療研究では、もっともらしい着想から十分に試験された候補へ至る時間を縮めることが期待できます。異なる専門分野の発見を結び付け、弱い前提を見つけ、有益な実験の設計を支援できるかもしれません。それが患者に役立つかは、実験と臨床での検証によって判断する必要があります。発見の加速に価値があるのは、検証の段階に届く証拠が良くなるからであり、自信に満ちた文章でその段階を省けるからではありません。
教育では、より個人に近い機会があります。同じ質問を三通りに聞き直しても恥ずかしくなく、自分が理解できる言語や文脈で説明を受けられる学習者を想像してください。教師は誤解を探り、より良い練習問題を準備するために使えます。望ましい成果は人間の理解が深まることです。教師と学生が支援の内容を確かめ、訂正できる余地も必要です。
ソフトウェアや公共サービスでは、後回しにされてきた保守の費用を下げられるかもしれません。小さなチームでも不具合を調査し、アクセシビリティを改善し、技術者を十分に配置できなかったシステムを更新できます。気候やエネルギーの研究では、探索やシミュレーションの改善が、高価な物理実験の前に設計を比較する助けになります。分野ごとの制約は異なりますが、研究能力を実用的な価値へつなぐ道筋です。
その利益の届き方は、技術的な可能性と同じほど重要です。性能が優れていても、高過ぎる、地域の言語で使えない、判断に異議を申し立てられないといった事情で、多くの人が取り残されます。公益のための研究、使いやすい画面、競争、有用なモデルへの適切なアクセスも期待する未来に含まれます。広く利益を届けることは、知能に自動的に備わる性質ではなく、設計と政策の目標です。
仕事も変化し、利益が移行期の難しさを消すわけではありません。少ない人数で済む課題が生まれる一方、責任が重くなる仕事もあるでしょう。組織は学び直しを後回しにせず、新しい道具を使い、評価し、方向を変える力に投資すべきです。より良い未来とは、全体の数字が良くなるという約束だけでなく、変化を経験する人に実際の選択肢を増やす未来です。
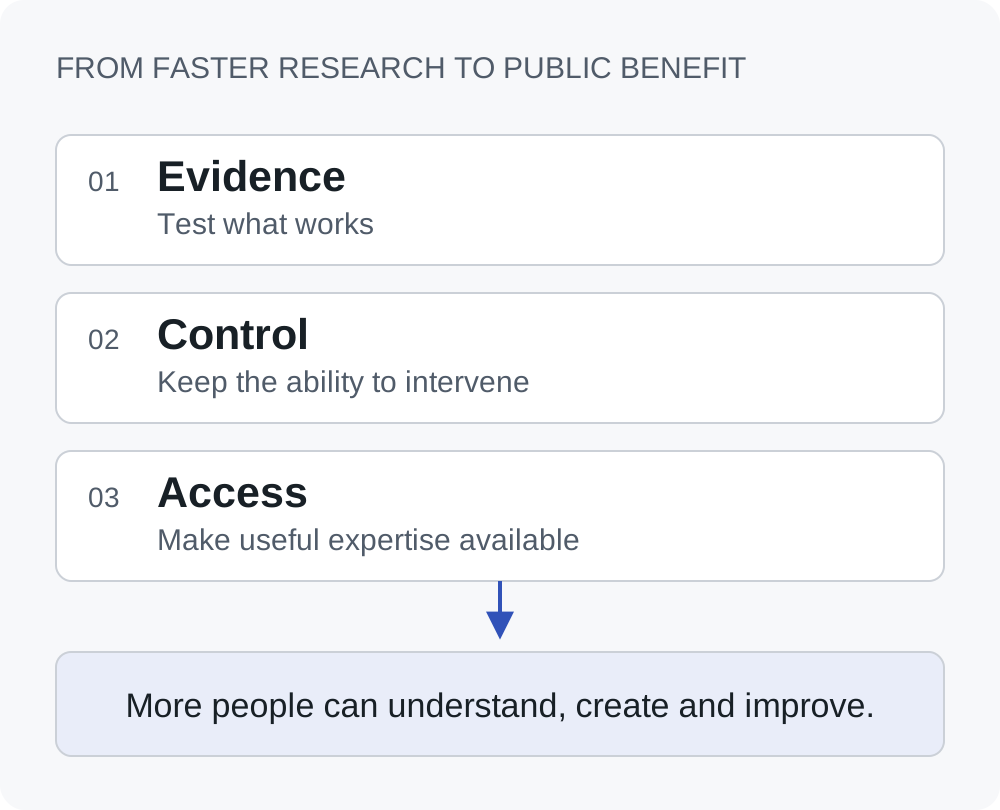
独自に構成した分析の枠組みです。証拠、制御、アクセスは本文の前向きな未来像の条件であり、将来予測や国・企業の順位ではありません。
重要な到達点は、人が受け止め、方向を決められる進歩だ
次のRSIの主張を見たら、何が変わり、どの証拠が検証に耐えたかを確かめてください。回答が良くなったのか、道具が改善したのか、それとも将来のシステムを開発する能力が高まったのか。元の評価の外でも成果を再現できたか。研究の方向を誰が決め、何が人間の制御下に残ったか。曖昧な突破口までの残り時間を数えるより、こうした問いが役立ちます。
現在AIを導入するチームにも、具体的な準備ができます。重要な原資料を、それに基づく判断と結び付けて残しましょう。探索段階の作業と、長く残る結果を生む行動を分けましょう。検討できる証拠をレビュー担当者に渡し、悪い選択を取り消せるようにしましょう。今でも有用な習慣であり、開発が加速すれば価値はさらに高まります。
Googleが強い意味でのRSIに到達したという噂は、まだ検証されていません。一方、AIがAI研究へ参加する変化は、すでに公開資料で確認できます。終着点の時期や形を知っているふりをせずに、この変化を真剣に受け止めることはできます。私が成功の指標にしたいのは、次に起きることへの実質的な発言権を保ちながら、人がどれほど多くを理解し、作り、改善できるかです。
出典と、この調査で確認できた範囲
Xの投稿は公開埋め込み応答で確認し、元の噂と拡散を結ぶリンクも調べました。確認できるのは公開された投稿であり、内部資料とされる画面の真正性ではありません。投稿の日付にはXの表示日を使っています。地域の時刻によって暦上の日付が異なる場合があります。
- Lyraの原文 — 2026年9月11日
- Lentilsの引用投稿と内部モデル一覧の主張 — 2026年9月11日
- Chubbyによる拡散 — 2026年9月12日
- AI Timesの報道 — 2026年9月14日
- AGIの水準に関する研究 — 初回投稿2023年11月4日
- Google DeepMindのAlphaEvolve発表 — 2025年5月14日
- GoogleのGemini 3.8発表 — 2026年9月2日
- AnthropicによるAI支援開発の説明 — 2026年6月4日
- アモデイのペース調整案 — 2026年9月
- アルトマンの応答 — 2026年9月12日
- マスクの応答 — 2026年9月12日
- トランプ発言を伝えるAP通信 — 2026年9月13日
判断の根拠を、後からたどれる場所に
Telli.shはノート、録音、翻訳、Clipを、後から戻ってこられる作業空間にまとめます。会話や記事でAIへの見方が変わったら、原文を、その考えや判断と一緒に残しておきましょう。モデルが変わり続けても、残すと決めた判断の根拠は後から理解できるものであってほしいと考えています。