没有人说过九月:每份 AI 会议纪要都需要的九分钟复核
关于会议转录摘要的研究发现,市议会会议转录稿的生成摘要中有 30.4% 至少含一处事实错误,背后是七种可命名的错误类型。这是一份把 AI 会议纪要与转录稿对照复核的实用指南:先查什么、按什么顺序查,以及在会议室里说哪几句话,能让复核只花九分钟而不是三十分钟。
那份摘要有三段,条理清晰,只有一句话是错的:团队已同意在九月上线迁移。
没有人同意过。有人说的是,如果供应商及时回复,九月大概可以——一句条件句,在另一个话题的岔路中只说了一次。模型删掉了条件,把猜测升格为决定,这份纪要发给了十一个不在会议室里的人。其中两个人开始按九月排期。
这件事一点也不离奇。它是自动摘要系统中被记录得最清楚的行为之一,在研究文献里有专门的名字,而且不会因为下一代模型更大就消失。本文给你三样东西:摘要偏离真实发言的七种固定方式、一套能全部抓住它们的九分钟复核流程,以及在会议中说出口就能缩短复核时间的那几句话。
要点速览
- 在 TofuEval 基准(NAACL 2024)中,真实市议会会议转录稿的生成摘要有 30.4% 至少含一处事实错误;如果是边缘话题,这个比例升到 43.6%。
- 错误不是随机噪声。研究者把它们归为七种命名类型,其中对会议伤害最大的两种是把意见陈述为事实和时态与情态漂移——也就是"可能会"变成"将会"的那一步。
- 你也没法把检查交回给模型。在 FaithBench(2024 年 10 月)上,最好的幻觉检测模型准确率接近 50%;在 TofuEval 中,大模型评判者输给了更小的专用指标。
图片:Shixart1985,Wikimedia Commons,CC BY 2.0。重点是那副眼镜。终究还得有人去读。
采集被解决了,核对压根没开始
在 Hacker News 上数一数过去半年发布的会议纪要工具,2026 年 3 月 1 日到 8 月 13 日之间至少有十五个:端侧转录器、不派机器人入会的记事本、Obsidian 导入插件、开源的 Granola 克隆。每一个都装了同样的两个功能:录下音频,生成摘要。
没有一个装上第三步——唯一需要判断力的那一步。摘要抵达你的收件箱时已经排好版、已经语气笃定、已经发给了整个会议室。这套流程隐含的主张只有一句:这份产物已经完成了。
关键在这里:生成的摘要不是会议的记录,而是关于会议的一份陈述,由一个不为准确性负责的系统写成。它应当像任何转述一样被对待——对着它的来源去读。
好在来源就在旁边。生成摘要的那个工具同时也生成了转录稿,把两者对照一遍所花的时间,比这场会议用在自我介绍上的时间还短。
一个应该改变你读纪要方式的数字
TofuEval 由 Salesforce AI 的研究者及合作者发表于 NAACL 2024,是我们目前对这个问题最接近受控测量的东西。他们取了两个对话语料——一个是新闻访谈,另一个叫 MeetingBank,由美国市议会真实会议转录稿构成——让五个语言模型写主题摘要,再请专业语言学标注员逐句对照原文标注事实一致性。
在会议转录稿上,五个模型平均下来,主要话题摘要中有 30.4% 至少含一处事实不一致,边缘话题则升到 43.6%。论文写得很直白:除 GPT-3.5-Turbo 外,"约 40–50% 的摘要至少含一处事实不一致"。
该说的保留意见是:这五个模型是 2023 年那一代——Vicuna、三个尺寸的 WizardLM,以及 GPT-3.5-Turbo——今天的前沿模型在事实性上确实好了不少。但同一篇论文里有两个发现能挺过这个反驳,而且正是它们会影响你的周二。
第一,规模并没有可靠地解决问题。在会议数据上,WizardLM-30B 的错误率只比 WizardLM-7B 低 3.8 个百分点,尽管体量是它的四倍多;在某些对比里,同系列的更大模型反而出更多错。第二,错误数量与摘要长度没有实质关系(皮尔逊 ρ = 0.18)。更长、更详细的摘要并不更安全。等一个更大的模型,不是一套复核流程。
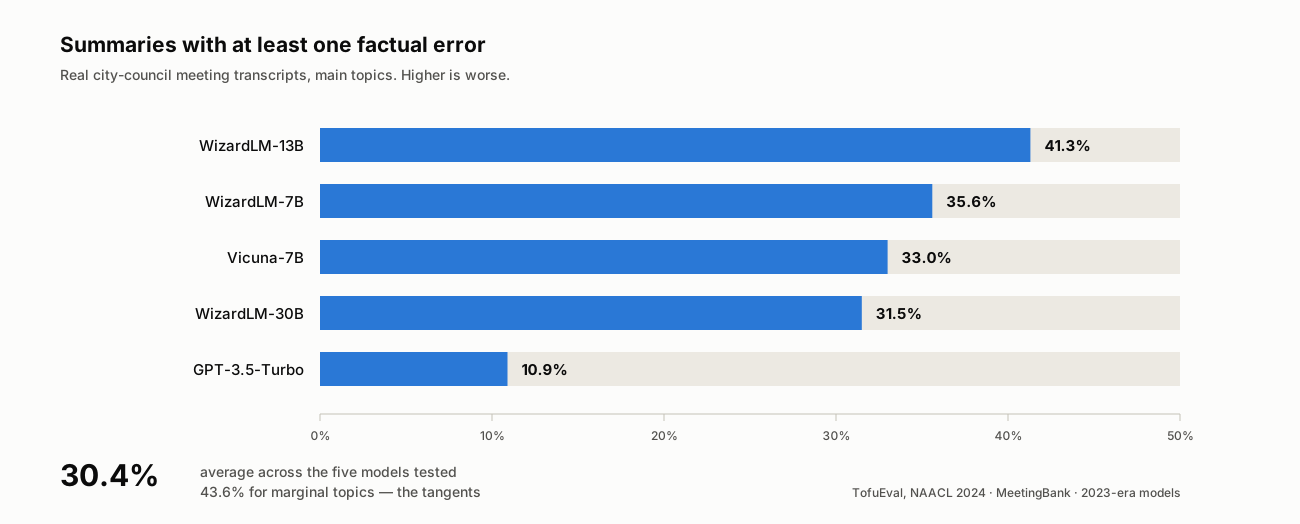
真实市议会会议转录稿的生成摘要中至少含一处事实错误的比例,仅主要话题。来源:TofuEval,Tang 等,NAACL 2024(arXiv:2402.13249)。受测模型为 2023 年一代;下文的错误类型比它们活得更久。
摘要偏离会议室的七种方式
那篇论文里最有用的不是百分比,而是那套分类:标注员从数千条被标记的句子中归纳出七种错误类型,扩展了此前针对短对话建立的分类。
读过一遍,你就会在自己的纪要里看到它们。因为它们不是随机故障,而是把口语压缩成书面语时,会议室原本依赖的那些区分被抹掉的具体、可重复的路径。
| 错误类型 (TofuEval) | 在会议纪要里的样子 | 怎么抓出来 |
|---|---|---|
| 外源信息 | 摘要里有、音频里没有的细节——某个数字、某个客户名、没人给过的理由 | 在转录稿里搜这个专名或数值;搜不到就是编的 |
| 指代错置 | 正确的决定挂到了错的人头上,或把甲的反对记成乙的 | 跳到时间戳,看当时是谁在说话 |
| 意见事实化 | 有人只是担心可能会,写成"这次调价将提高流失率" | 在原文里找缓和词:认为、担心、怀疑 |
| 推理错误 | 算错了数,或推出一个会议室从没画过的因果关系 | 把每个数字重算一遍;追问那个"因为"是说出来的还是推出来的 |
| 时态/体/情态 | "我们可能九月上线"变成"我们将在九月上线" | 逐个核对将来时动词与原文的情态词 |
| 矛盾 | 否定被丢掉——"我们不改截止日期"变成"我们改截止日期" | 在该论断附近搜不、绝不、除非 |
| 细微语义漂移 | "提出建议"被改写成"提出要求" | 把摘要里的动词和原文里的动词并排比对 |
其中三种放成实物最容易认出来。把转录稿和摘要里的那句话并排摆一下就清楚了。
否定被丢掉,矛盾错误。 会议室里的原话:
丹尼尔 (00:31:12): 所以上线日期我们不改。别的怎么变,这个日期不动。
摘要写下的句子:
团队同意改动上线日期。
少了一个字,这句话现在指示的是完全相反的动作。而且它语法完美,这正是通读会滑过去的原因,也是在决定附近搜一下"不"能在四秒内抓住它的原因。
张冠李戴,指代错置。 会议室里的原话:
普里娅 (00:18:40): 按席位计价我反对。上个季度有两家企业客户跟我们说,
这么做单子就谈不成了。
米娜 (00:18:55): 嗯,同意。
摘要写下的句子:
米娜以企业客户反馈为由,反对按席位计价。
这句话里的每一个事实都在转录稿中。只有人不在。难处正在于此:你没法靠追问这些说法是否属实来抓住它,只能追问这些说法是否属于被安上的那个人。
被抬升的猜测,情态错误。 会议室里的原话:
山姆 (00:44:02): 只要供应商及时回复我们,九月大概是可以的。
摘要写下的句子:
团队同意在九月上线迁移。
两个限定词被拿掉了——"大概"这个词,以及整个条件从句。于是一次共同的猜测变成了一份带日期的承诺。这中间不需要任何人说谎。是压缩干的。
其中两种值得特别注意,因为它们是真会让团队付出金钱代价的。
意见事实化就是本文开头那起九月事故。会议里的大多数句子都是带缓和的——人们正在出声思考,而缓和词承载了全部含义。摘要模型按设计就会剥掉缓和词,因为压缩书面语时最先被砍的就是它。结果读起来比会议室笃定得多,也正因如此没人质疑。
情态漂移对日期造成同样的伤害。"可能""应该""大概""如果供应商回复我们",是计划与承诺之间的分界线,同时也是最容易被丢掉的词。一份写着团队将在九月做某事的摘要,等于悄悄制造了一个无人认领的截止日期。
看看这两者的共同点:模型并没有凭空造事实,它删掉的是限定词——这是它能做的最不显眼的一处编辑,也是读者手边没有原文时根本无法察觉的一处编辑。
编造发生在岔路上
数据里还有第二个模式,和真实会议的走法精确重合。
边缘话题——那些被一带而过、没有展开的内容——的摘要明显更差:在会议语料上是 43.6% 对 30.4%。研究者解释了机制:当某个话题在原文中几乎没被覆盖时,模型会"依赖自身知识对该话题作出推断,把没有依据的信息带进摘要"。证据稀薄的地方被通识填满,而这些填充在语气上与有依据的部分毫无区别。
你的会议里全是边缘话题:关于安全评审的那两分钟、只被提过一次的供应商、某人半记得的数字。这些句子讨论得最少、最可能出错,读起来却和其余部分一样流畅。
再往下一层,形状相同。在 ACM FAccT 2024 发表的《Careless Whisper》中,Koenecke 等人发现 Whisper 转录稿中约有 1% 含有整段在原音频中根本不存在的短语或句子,而这些幻觉里有 38% 带有明确危害——编造的关联、虚假的权威、凭空的暴力描述。有意思的是触发条件:幻觉在非发声时长更长的说话者身上出现得不成比例地多。
换句话说,是沉默。而会议正是由沉默构成的:思考时的停顿、有人解除静音的间隙、屏幕共享加载的时间、一个难题之后的四秒钟。这恰恰是转录模型最可能拿从未说过的话去填补的原料。这也意味着转录错误与摘要错误并不独立:一句编造出来的转录,对摘要来说是一份完全"有据可依"的输入。
你没法把检查交回给模型
一个自然的想法是让第二个模型去验证第一个。测量结果并不鼓舞人心。
在同一项 TofuEval 研究中,作者把大模型当作事实一致性的二元评判者来评估,结果发现包括 GPT-4 在内的所有模型"在检测大模型生成摘要中的错误上表现很差",输给了专门为该任务构建的、更小的非大模型事实性指标。即便 GPT-4 正确地标出了一个句子,它对为什么错的解释也只有约 80% 是对的;其他评判者大约只有一半。
Vectara 于 2024 年 10 月发布的 FaithBench 给这个天花板标了数字。它收集了八个模型家族、十个现代大模型产生的、现有检测器意见不一的幻觉样本,报告称最好的幻觉检测模型准确率接近 50%。在最要紧的那些案例上,等于抛硬币。
所以复核归你。这听起来像负担,直到你注意到一处不对称:检测器必须拿一份陌生文档去判断任意文本,而你当时就在会议室里。哪句话看着不对劲,你早就知道,只需要去核实。
三种产物,三种职责
大多数"AI 纪要 vs 人写纪要"的争论都是范畴错误。一场会议产出三种东西,它们互不替代,而只保留其中一种的团队,总会丢掉某样具体的东西。
| 原始转录稿 | AI 摘要 | 决策日志 | |
|---|---|---|---|
| 保留原话 | 是——逐字 | 否——被压缩,缓和词被丢弃 | 否 |
| 谁说的 | 若做了说话人分离则是 | 有时;指代错置是一种命名错误类型 | 是——责任人就是重点 |
| 什么时候说的 | 是——带时间戳 | 很少 | 只有截止日期 |
| 带责任人与期限的决定 | 埋在约 9,000 个词里 | 部分,且不可靠 | 是——这是它唯一的职责 |
| 排除了什么、为什么 | 若有人说出口则是 | 通常当冗余删掉 | 是,一行写清 |
| 60 秒读完 | 否 | 是 | 是 |
| 可与证据对照 | 它本身就是证据 | 仅当转录稿还在 | 仅当两者都还在 |
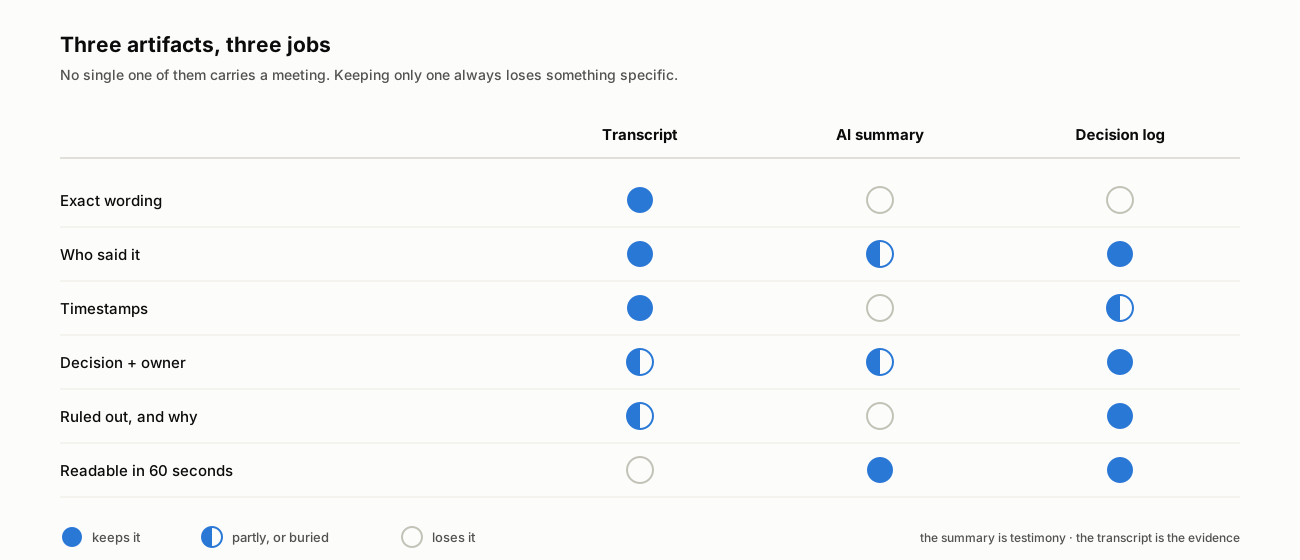
每种产物保住了什么、只保住一半什么、又丢了什么。决定另外两者价值的,是最底下那一行。
最后一行就是全部论点。没有转录稿留存的摘要是不可证伪的——当同事说"我们当时不是这么定的",你手上有的是两种意见和零份记录。恰恰在这一点上,AI 纪要比人写的更脆弱:人写的会议记录自带可见的易错性,大家会带着适度的怀疑去读;机器写的散文则以整洁的小标题和肯定的陈述句抵达,借走了它并未挣得的权威。
那就照实说:摘要是证词,转录稿是证据。证词有用。证词也正是那种需要拿去核对的东西。
九分钟复核,按顺序来
这是我们推荐的流程,按一场 60 分钟的会议计时。顺序很重要:把出错代价最高的检查放在前面,这样即便你在第四分钟被打断,昂贵的错误也已经被抓住了。
- 0:00–1:30 — 只读决定句。 第一遍完全忽略叙述性摘要。找出所有声称结果、承诺或日期的句子。一场 60 分钟的会议通常有三到六句,只有它们会被人拿去执行。
- 1:30–3:00 — 把情态还原。 对每一句,跳到转录稿的对应位置核对动词。当时说的是将会,还是可能、应该、大概?如果原话带缓和,就把缓和词加回摘要句;更好的做法是把它标成一个带责任人的待决问题。
- 3:00–4:30 — 核对每一个专名和数字。 人名、公司、版本、价格、日期、百分比。逐个在转录稿里搜索。搜不到的就是外源信息:删掉,或者到会外去确认。这是搜索框的活儿,不是通读的活儿。
- 4:30–5:30 — 验证归属。 对每个决定和每个反对意见,确认那个时间戳上说话的是谁。指代错置更可能引发人际问题而非排期问题,而它是最快能查清的一种。
- 5:30–6:30 — 猎捕被丢掉的否定。 在每个决定附近搜不、绝不、别、除非、而不是。矛盾错误会在句子语法完全通顺的情况下把意思整个反过来,靠通读发现不了,只能靠搜索。
- 6:30–8:00 — 问问缺了什么。 这是没有工具能替你做的一步,因为摘要无法标出自己的遗漏。两个问题:我们排除了什么、为什么?还有哪个问题没答上?两者都活不过压缩,而两者恰恰是六个月后让这份纪要还有用的东西。
- 8:00–9:00 — 写决策日志并发出去。 三到六行,每行写清决定了什么、下一步归谁、期限是哪天。链接到转录稿。这个链接让整套复核变成别人也能复查的东西。
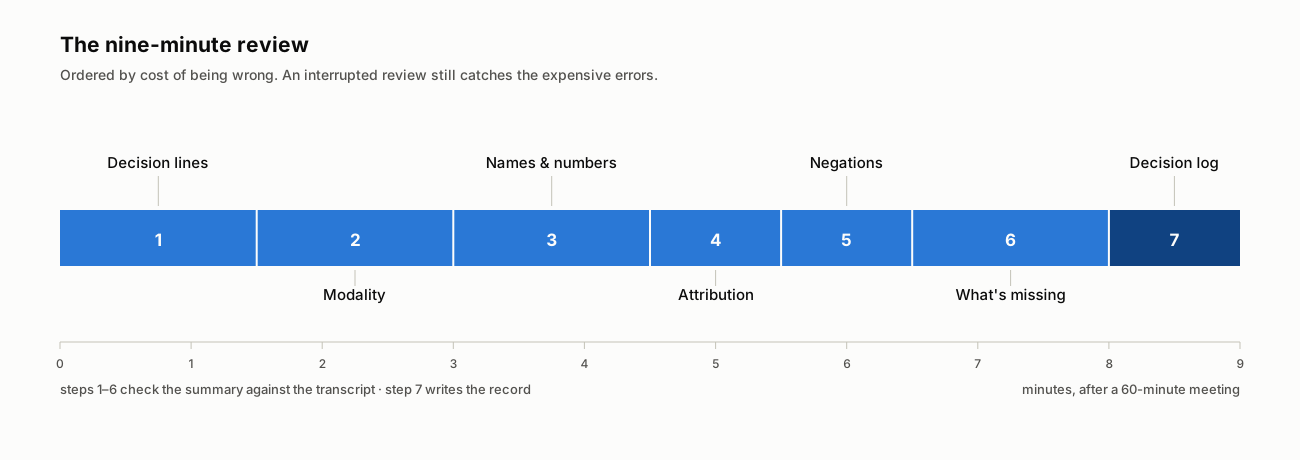
顺序本身就是设计:情态与编造的细节放前面,遗漏放最后。被打断的复核仍然抓住了昂贵的错误。
关于把它做成日常的两点说明。如果会议只有 30 分钟,这就是四分钟的活。如果你在同时持有摘要和带时间戳转录稿的工具里做,第 2 到第 5 步全是搜索和点击,而不是来回切窗口——能在忙碌的一周里活下来的习惯和活不下来的习惯,差别就在这儿。
会议中的十秒,省下复核里的五分钟
如果原始录音里本来就有那条信息,复核会短得多。模型无法还原没人说过的话,而让纪要含混的东西,大多从一开始就不在音频里。
- 把问题说出口作为开场。 "我们今天要决定的是:迁移在大会前上线还是大会后上线。"一个被说出来的问题,会给摘要模型一个主要话题,而不是一堆边缘话题——边缘话题正是 43.6% 的那一侧。
- 散会前用一句话说出决定,带名字和日期。 "决定:供应商跟进由 Mina 负责,九月这个日期我们在 25 号前确认。"市面上每一个纪要工具都能完美记下这句话,但没有一个会替你把它想出来。
- 把否定明说出来。 "我们不改上线日期"比耸耸肩点点头更安全,因为否定被丢掉是一种有据可查的错误类型,而一个从未被说出口的否定,压根没得丢。
- 用一行说清你们否掉了什么、为什么。 "我们考虑过按席位计价,但上个季度有两家企业客户反对,就放弃了。"就是这句话能阻止六个月后同一场辩论重开。
- 不常见的专名念清楚一遍。 供应商名、内部代号、缩写,正是转录会弄糊、摘要又会自信复述的那类词。
- 别让沉默替你说话。 如果全场安静下来是因为大家在读文档,就说一句。长时间的非发声区间,正是转录模型最容易产生幻觉的条件。
这些都不是会议表演,而是在向记录口述——一项在记录开始被自动书写之后,价值反而上升的技能。
结论
AI 会议摘要不是记录,而是关于记录的证词:由一位流利的证人给出,他对准确与否没有利害关系,并且有据可查地倾向于丢掉"大概"这个词。
这样重新定义之后,"人工还是 AI"的争论就散了——它本来就不是一场真正的争论。把录音留下,因为那是唯一的证据。让模型写摘要,因为它比你快,而且到第四十分钟也不会走神。然后花九分钟,做那件只有在场者才能做的事:拿那些笃定的句子去对照真实发言,并写下需要有人去执行的那三行。
2026 年被烫伤的团队,不是那些没用 AI 纪要工具的团队,而是那些把它的输出当转录稿读的团队——它其实是转述,而能显出这个差别的转录稿,他们没有留。关于一份好纪要必须承载什么,我们写过会议纪要仍然必须包含的六件事;关于词错误率为什么几乎说明不了转录稿好不好用,我们写过准确率本身并不够。
Telli.sh 在其中的位置:九分钟复核只有在摘要和来源住在同一个地方时才成立。Telli.sh 把带说话人标注的时间戳转录稿放在可编辑的 AI 摘要旁边,于是核实一条论断变成一次搜索加一次点击,而不是在两套系统之间翻找;当会议室不止说一种语言时,译文与原文并排呈现,而不是取而代之。摘要抵达时是一份你去修改的草稿,而不是一份你必须接受的输出。
来源
- Tang et al., "TofuEval: Evaluating Hallucinations of LLMs on Topic-Focused Dialogue Summarization," NAACL 2024 (arXiv:2402.13249,2024 年 2 月 20 日)
- Koenecke et al., "Careless Whisper: Speech-to-Text Hallucination Harms," ACM FAccT 2024 (arXiv:2402.08021,2024 年 2 月 12 日)
- Bao et al., "FaithBench: A Diverse Hallucination Benchmark for Summarization by Modern LLMs," Vectara (arXiv:2410.13210,2024 年 10 月 17 日)
- Hu et al., "MeetingBank: A Benchmark Dataset for Meeting Summarization," ACL 2023 (arXiv:2305.17529,2023 年 5 月 27 日)
- Wang et al., "Analyzing and Evaluating Faithfulness in Dialogue Summarization," EMNLP 2022 (arXiv:2210.11777,2022 年 10 月 21 日)
- Wikimedia Commons 图片页面
