五个阶段,四份产物:Telli.sh 到底拿一段会议录音做了什么
逐段拆解 Telli.sh 的完整流水线:实时录音与音频上传、带说话人识别的 AI 会议转写、覆盖 44 种目标语言的实时会议翻译、10 种格式的 AI 摘要,以及可分享的笔记。同时给出诚实的边界、准确的价格,以及会议转写准确率真正需要什么。
八个人站在办公室里。一个人在解释迁移为什么延期,两个人只听了一半。站在后排的某人说出了三周后才会变得重要的那句话,没有人把它记下来。
那就是原材料。这篇文章讲的是我们的系统怎么处理这份原材料,从音频开始流动的那一刻,到你把链接粘进频道的那一刻,一个阶段一个阶段地讲。
先说明白:这是一篇产品文章,由开发 Telli.sh 的团队撰写。我们会在研究类文章之外定期发布这类产品文章。但这里想做的,是把机器内部讲得足够具体,让一个抱有怀疑的读者能自己去核对——真实的模型名称、真实的数字、真实的限制,而不是"AI 驱动"这种雾一样的形容词。
要点:
- 一段录音会经过五个处理阶段,并单独留下四类产物:原始转写稿、说话人映射、精炼脚本,以及你所应用的每一种格式对应的摘要。
- 说话人识别跑在
pyannote/speaker-diarization-community-1上,按音频块逐段处理,并把声纹向量一路带下去,因此同一个人在第 5 分钟和第 50 分钟会保持同一个标签。- 翻译目标覆盖 44 个语言代码,界面本身支持 15 种语言,摘要有 10 种内置格式,另外还可以用名称、指令和章节列表自定义格式。
- 免费额度为每月 60 分钟,无需信用卡。付费方案为每月 5 美元、8 美元、10 美元,分别对应 300、500、1,000 分钟。
图片:Klean Denmark,"Daily sprint meeting",Wikimedia Commons,CC BY-SA 2.0。这整条流水线之所以存在,就是为了熬过这种会议。
音频进来的路只有两条,而这两条并不一样
入口正好两个,两者的差别决定了下游的一切。
第一条是实时录音。浏览器打开一个采样率固定为 16,000 Hz 的 AudioContext,加载 AudioWorklet,把麦克风输入按 4,096 个采样点缓冲——在 16 kHz 下就是每 256 毫秒一个数据包。每一帧从 32 位浮点转换为 16 位整型 PCM,通过 WebSocket 推送到 /ws/audio/{sessionId}。第二条 socket /ws/session/{id} 承载控制通道:语言切换、上下文更新、SUMMARIZE 命令,以及关闭会话并写入笔记的 FINISH 命令。
第二条是文件上传。你把录音拖进上传弹窗,它会流式传到 POST /upload,服务端以换行分隔的 JSON 回应——是流,不是转圈图标——所以界面能显示带名字的真实步骤,而不是假的百分比。这里的硬性上限值得如实写出来:单个文件 500 MB,并且文件选择器只接受 audio/*。 如果你的会议藏在一段 MP4 屏幕录制里,需要先把音轨提取出来。这件事我们今天不替你做。
两条路径汇入同一条处理主干。从第一阶段开始,实时录音和上传文件被同等对待。
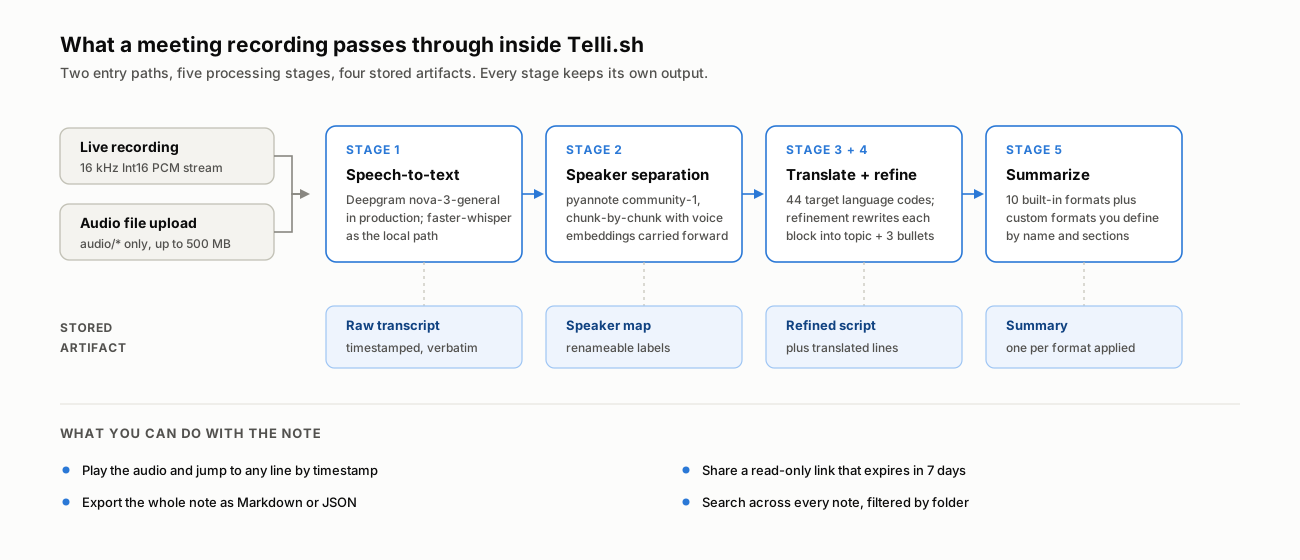
每个阶段都保留自己的输出。后一个阶段不会覆盖前一个。
第 1、2 阶段:先听清词,再判断这些词是谁说的
先跑语音识别。生产环境中批处理路径和流式路径都使用 Deepgram 的 nova-3-general 模型;代码库里同时内置了一条基于 faster-whisper 的本地路径,供自托管部署使用,靠一个提供方配置项切换。但这个选择远没有大多数人预期的那么重要,原因我们写过长文:独立基准榜单上排名靠前的语音模型,词错误率如今挤在大约 1.5 个百分点的区间内。 引擎的选择已经不是质量差异发生的地方。
质量差异发生在说话人识别上。
说话人分离跑在 pyannote/speaker-diarization-community-1 上。真正起作用的实现细节,是它怎么处理长录音。流水线不是把整个文件一次性分离,而是把音频切成块,在每一块处理完后立即分配说话人;同时维护一份按说话人累积的声纹向量字典,并在之后的每一块上对照这份累积集合做重新识别。经典的失败模式——一段两小时的录音里,同一个人悄悄从 SPEAKER_00 变成 SPEAKER_03,再变成 SPEAKER_07——正是被这个机制挡住的。
当一个片段跨在两个说话人的发言之间时,标签归给重叠更多的那一方;重叠很少时,声纹相似度充当决胜规则。
你拿到的是通用标签——SPEAKER_00、SPEAKER_01——因为模型没有办法知道 SPEAKER_01 是你们的工程负责人。你在笔记里改一次名字,这份映射就会随笔记保存,之后处处生效,包括导出和分享链接。分工是诚实的:机器负责把声音分开,你负责给出名字。
每个阶段实际留下了什么
我们坚持的设计规则只有一条:任何一个阶段都不能销毁前一个阶段的输出。你必须能随时回到真正说出口的那些词。
| 产物 | 由哪个阶段生成 | 内容 | 用途 |
|---|---|---|---|
| 原始转写稿 | 第 1、2 阶段 | 带时间戳的逐字行,每行带说话人标签 | 核对到底说了什么;点击某行跳转音频 |
| 说话人映射 | 第 2 阶段 + 你的编辑 | 这条笔记里标签与姓名的对应关系 | 让其余所有视图可读——在笔记、导出和分享中生效 |
| 精炼脚本 | 第 4 阶段 | 每个块被改写成一行加粗主题加最多 3 个要点 | 不逐字读完就能扫完一场长会 |
| 翻译行 | 第 3 阶段 | 附在每一行原文旁边的译文 | 读一场用你不工作的语言开的会 |
| 摘要 | 第 5 阶段 | 你应用的每种格式各生成一份结构化文档 | 真正发给别人的那份东西 |
在笔记界面里它们表现为三类标签页:历史(原始转写稿)、脚本(精炼版),以及你生成的每一种摘要格式各一个。如果录音的音频被保存了,上方会有一个播放器,点击转写稿的任意一行即可把音频定位到那个时间戳。
第 3 阶段:翻译这件事上,重要的数字是 44
实时会议翻译是把我们早期用户拉进来最多的功能,值得把它的范围说清楚,因为在这个品类里,"支持 100 多种语言"是最难核实的一句话。
有两个不同的数字,而且它们不是同一个数字:
- 翻译目标接受 44 个语言代码。这个集合在后端配置里被显式列出,并且把
zh-TW与zh分开——如果你的工作跨越台湾与中国大陆,这个区别比听上去重要。 - 界面本身以及 AI 撰写摘要所用的语言是 15 种:英语、韩语、日语、中文、德语、法语、西班牙语、意大利语、葡萄牙语、俄语、波兰语、越南语、泰语、印尼语、马来语。
在实时会话中,翻译是增量进行的,而不是最后一次性批处理。转写稿里每到达一个标点边界,该片段的译文就会流入原文旁边,而按会话维护的缓存会避免重复翻译没有变化的文本。文件上传时改为按批处理:没有人盯着屏幕的时候,吞吐量比延迟更重要。
此外还有一个与笔记模式并列的翻译工作流模式,用于翻译本身就是交付物的场景——你需要实时跟上的双语对话,而不是需要产出纪要的会议。
第 4 阶段:没人要求、但所有人都需要的那一步
这里从描述转向观点,而且这个观点我们不打算加限定词:精炼是这条流水线里最被低估的阶段。
人类说话的逐字转写稿几乎不可读。人会重启句子、把话说到一半没了下文、连说四遍"对对对",并把一个决定埋在九十秒的清嗓子里。把这些一字不差地记下来,仍然是九十秒的清嗓子。
所以精炼阶段把对话切成块,在严格约束下重写。这些约束定义在提示词模板而非代码里,因此不用发版就能调整。每个块变成一行从内容中提炼出的加粗主题——不是角色名,不带方括号——后面跟最多三个要点,每个块目标约 300 个字符。说话人名字和时间戳会被显式剥离,因为原始转写稿里已经有了,重复只会让本该好扫的视图更难扫。
模板里有一条约束值得单独点名:模型被要求匹配它听到的内容的语域,并且明确要求不要把商务会议腔硬套到一场随意的对话上。把走廊闲聊总结成董事会纪要,产出的东西比完全没有摘要更糟。
我们把这个结果叫作脚本——你一眼能读完的版本,而争议时可以引用的版本就在隔壁一个标签页里原样躺着。
第 5 阶段:十种摘要格式,因为"摘要"不是一件事
最后一个阶段生成你真正要发出去的文档。让大模型给"一份摘要",你得到的是一份关于不特定内容的摘要,所以格式在这里是一等选择,而不是隐藏的默认值。
内置十种格式:AI 摘要(通用)、会议纪要、汇报摘要、课堂笔记、讲道 / 演讲、咨询记录、通话摘要、访谈、灵感笔记、演示提纲。每一种都有自己的章节结构:会议纪要产出会议概况、主要讨论、决定事项、后续步骤与行动项;演示提纲产出发表概要、幻灯片流程、核心信息、演讲者备注、下一步行动。章节标题本身是按语言本地化的,而不是在生成时翻译——这就是为什么一份日语摘要读起来像日语文档,而不像被翻译过的英文文档。
十种都不合适时,你可以定义自定义格式:一个名称、一组指令、一份你想要的章节列表,保存后可重复使用。"包含风险与待决事项的每周董事会更新"是一种只需写一次的格式。
任何格式都可以事后应用到一条笔记上,并各自生成一个标签页。为三类读者把同一段录音摘三遍,在这里是正常用法,不是绕路。
会议转写准确率是一个栈,不是一个数字
如果你正在比较这个品类的工具,这一节最值得你来反驳。
行业公布的是一个数字——词错误率——而这个数字在选产品这件事上已经不管用了,因为大家都挤在地板附近。我们在只有 STT 准确率是不够的里把这个论点完整拆解过,包括一个案例:漏掉一个"不"字就把决定整个反过来,而它只花掉准确率预算的 0.016%。
实务版本是这样的:能在真实会议里活下来的转写准确率由五层构成,声学模型只是最底下那一层。
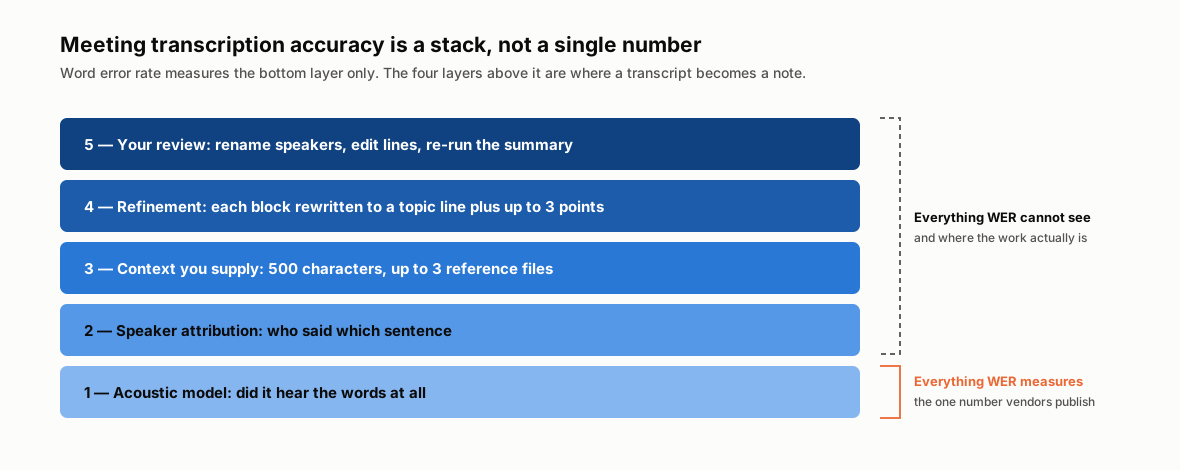
词错误率测的只有第 1 层。决定这份转写稿是否可用的,是第 2 到第 5 层。
第 3 层是用户能直接控制、却被大多数人跳过的一层。开始录音或上传之前,你可以填一段最多 500 个字符的上下文——主题、参会者姓名、产品代号、缩写——并附上最多 3 个参考文件(PDF、图片或文本),其文字会在浏览器端被提取并折进同一份上下文预算里。这段上下文会传给各个 AI 阶段。
这不是锦上添花。专有名词在任何会议里都同时是信息量最高、出现频率最低的词:内部项目名、罕见的姓氏、产品 SKU。提前告诉系统"红隼"是产品、"拉维"是人,花你十五秒,省下你原本要手动修十分钟的错误。如果你读完这篇只改一件事,请把上下文框填上。
从零到一条可分享的笔记,十一步
具体来说,从第一次运行到可分享产物:
- 注册。免费额度是每月 60 分钟,无需信用卡,跑的是和付费方案完全相同的流水线——这是额度差异,不是功能差异。
- 选路径:开始实时录音,或打开上传弹窗拖入音频文件(
audio/*,小于 500 MB)。 - 设置语言对。源语言可以保持自动检测;目标语言决定译文和摘要用什么语言产出。
- 填上下文框:主题、姓名、缩写,最多 500 字符。如果有材料或议程,附上最多 3 个参考文件。
- 想归到特定位置就选个文件夹。之后也可以移动。
- 开始录音,或等待上传流。实时会话里,转写稿随着大家说话逐句出现;如果设了目标语言,译文会在旁边流入。上传过程中你会看到带名字的步骤:语音识别、分析、精炼、摘要、收尾。
- 结束会话。这会触发
FINISH控制消息,刷出最后一个片段、等待进行中的精炼、保存音频、生成摘要并写入笔记。 - 给说话人改名。把 SPEAKER_00 改成真名一次,这份映射就会传播到每个视图和每一次导出。
- 看脚本标签页了解这场会讲了什么;哪里看着不对,就切到历史点那一行,听那个时刻的原始音频。
- 如果一拨读者要会议纪要、另一拨要汇报摘要,就再生成一种摘要格式。
- 分享或导出。分享链接是只读的,7 天后过期,可以选择加密码。导出给你 Markdown 或 JSON,摘要、精炼块和完整转写稿都在同一个文件里。
价格,用准确的数字说
额度按处理的音频分钟数计算,而这也是各档之间唯一的区别。
| 方案 | 每月分钟数 | 月付 | 年付 | 每 100 分钟实际成本 |
|---|---|---|---|---|
| 免费 | 60 | USD 0 | — | — |
| Plus | 300 | USD 5.00 | USD 51.00 | USD 1.67 |
| Pro | 500 | USD 8.00 | USD 81.60 | USD 1.60 |
| Pro+ | 1,000 | USD 10.00 | USD 102.00 | USD 1.00 |
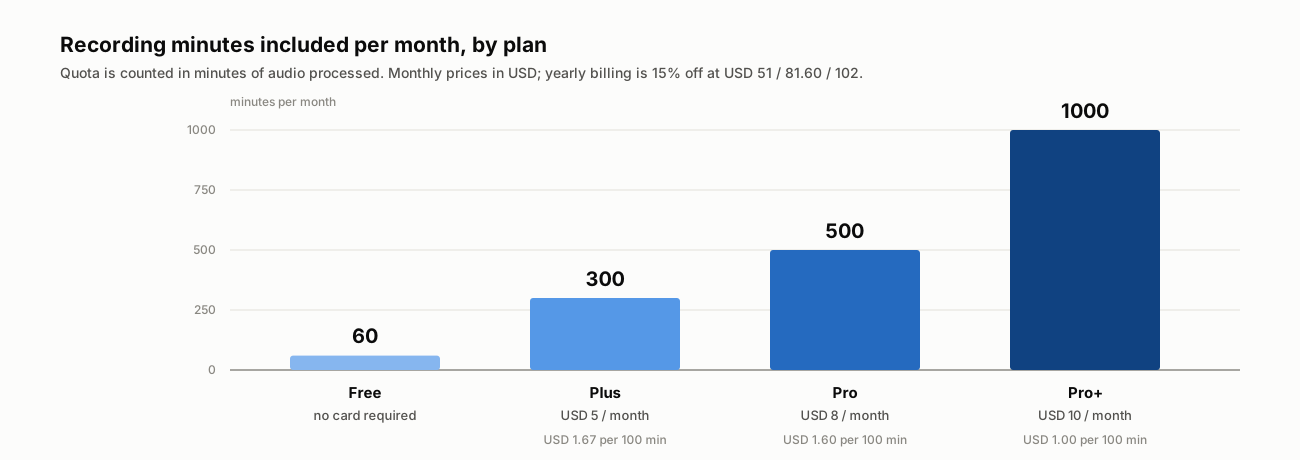
年付为月付 × 12 × 0.85。档位越高,每分钟单价越好,而流水线不变。
免费的 60 分钟是一场长会,或者三次站会。足够回答唯一重要的那个问题:这东西能不能产出一份你真的会发出去的笔记?用你自己的音频,而不是厂商的演示。
Telli.sh 不做什么
只罗列功能的产品文章是广告。这是另一栏。
不接受视频文件。 上传器只收 audio/*。请先提取音轨。
不替你参加通话。 没有拨进 Zoom、Meet 或 Teams 并坐在参会者列表里的机器人。你录会议室、录自己机器的声音,或者事后上传文件。
不修复糟糕的音频。 这是整个品类诚实的边界。一支全向笔记本麦克风摆在十二人长桌的一端、房间墙面又硬,那么无论跑谁家的模型,说话人分离质量都会下降——重叠说话和远处的说话人,正是说话人归属最先崩掉的地方。放在桌子正中间的一部手机,每一次都赢过桌尾的笔记本,而且不花钱。
你不说,它就不知道你的行话。 见上面的第 3 层。罕见专有名词是最常见的错误来源,上下文框就是解法。
说话人标签从通用名开始。 没有任何系统能猜出 SPEAKER_01 是普里娅。每条笔记改一次名字即可。
分享链接有时限。 七天,然后链接失效。这是针对会议内容的有意默认,不是我们忘了做的功能——但也意味着分享链接不是归档。需要长期保存就导出 Markdown。
结论
我们早期犯的错误,是把它当成一个转写产品。它不是。转写是五个阶段中的第一个,而且是最接近被解决的那一个。
我们真正在造的,是录音与决定之间的那段距离:知道谁在说话;把九十秒的清嗓子压缩成藏在里面的那一句;把那句话换成读者工作时使用的语言;再把它放到同事打得开的地方。录音是证据。笔记是改变下周会发生什么的那个东西。
如果你电脑里此刻就有一段会议录音,那才是唯一值得跑的基准测试。我们那次花了六十秒配置,产出的笔记发给了四个人。
来源
- 只有 STT 准确率是不够的 — Telli.sh 博客,2026 年 8 月 4 日 — 词错误率论点全文,含榜单分布
- pyannote/speaker-diarization-community-1 — Hugging Face — 本流水线使用的说话人分离模型
- Deepgram Nova-3 模型文档 — 生产环境使用的语音识别模型
- Telli.sh 定价 — 上文引用的方案额度与价格
- Wikimedia Commons 图片页 — 头图,Klean Denmark,CC BY-SA 2.0
