[AIアイデアノート 02] Timestral:明日の数値は、チャットの推測ではなく予測モデルに
Mistralの小型時系列モデルを紹介。確率的予測の意味、役立つ場面、CPUでの実験と公平な比較の始め方を解説します。
AIアイデアノートは、新たに登場するAIモデルやツールの発想と、実用につながる可能性を探るシリーズです。
明日の問い合わせ件数は、文章になる前にまず数値です。担当者を増やすべきか、サーバー容量を足すべきか、いつもの仕入れで週末を乗り切れるかを知りたいことがあります。流暢な説明が役立つのは、予測に確かな根拠があってこそです。
Mistral AIが2026年10月15日に発表したTimestralは、数値の系列を予測するモデル群です。チャットの返答ではなく確率的な予測を出力し、関連する複数の系列を扱います。公開サイズは5M、28M、123M、209Mパラメータの4種類です。Mistralの発表
この記事では、その説明から最初の有用な実験へ進みます。何を入力し、予測の幅をどう読み、単純な基準とどう比較するかを見ていきましょう。例は実験の提案であり、実測結果と取り違えずに試せるようにしています。
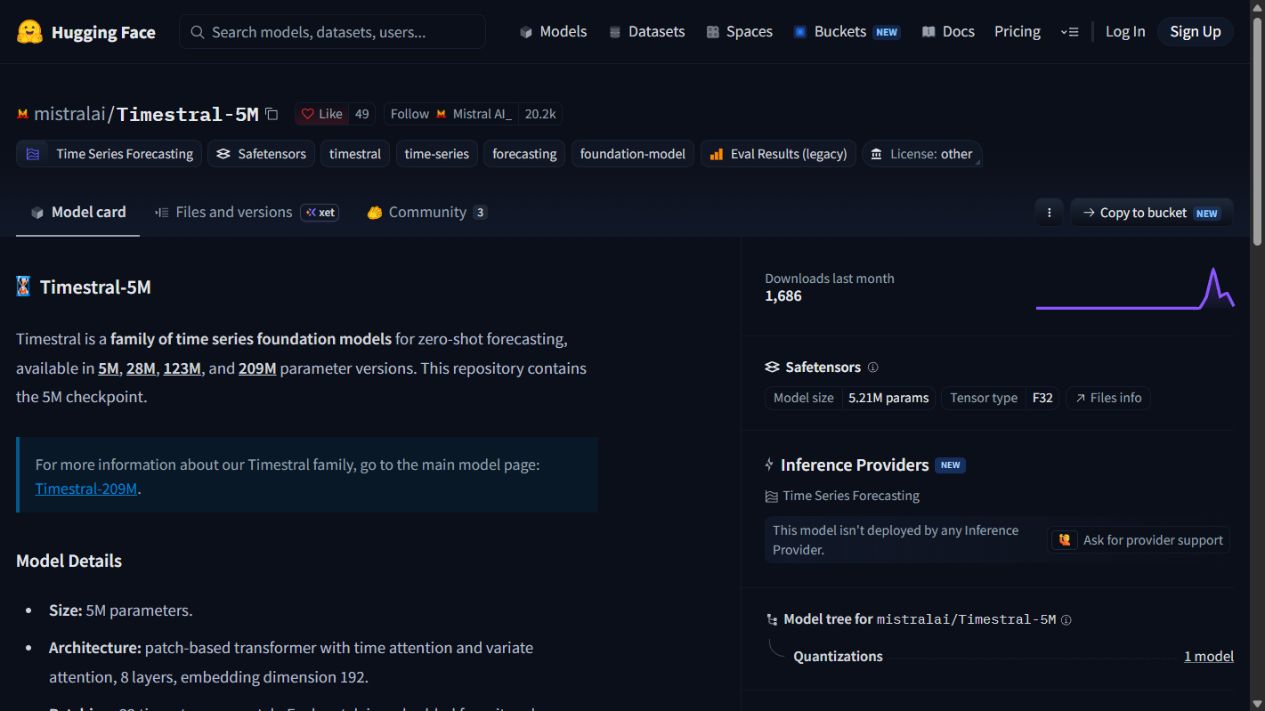 2026年10月20日に撮影したMistral AIのTimestral-5Mページ。予測用チェックポイントを示す画面であり、この記事で実施した実験のグラフではありません。
予測は、時間と数量の定義から始まる
時系列は、連続する時間ごとの数量を記録したものです。毎分のリクエスト数、1日の注文数、一定間隔で測る気温などが該当します。間隔も意味の一部で、毎分100件と毎時100件では、まったく違うシステムを表します。
モデルを選ぶ前に、意思決定を1文で書きます。「明日の問い合わせ件数を予測して人員配置を考える」は、「データから洞察を得る」より明確です。対象、予測期間、変えられる行動を指定しているからです。
次に、1観測が何を意味するか決めます。今日作成された問い合わせと、今日解決した問い合わせは別の出来事です。便利だからと同じ列に混ぜると、理解したかったボトルネックが隠れます。
Timestralを使うのは、この定義の後です。数値の履歴は処理できますが、その意味はチームが管理します。途中からリクエスト数が完了件数へと変わるような対象の問題を、モデルは修復できません。
役に立つ出力は、行動を決められる予測幅
点予測は数値を1つ示します。確率的予測は、将来の値の複数の水準を表し、中心値の周囲にどの程度の幅があるかを見せます。Timestralの公開出力には、予測時点ごとに21個の分位点が含まれます。推論リポジトリ
架空の演習で、明日の中央値予測が100件、上位の分位点が140件だとします。通常の配置は中心値をカバーし、予備計画は忙しい日に備えます。予測が準備の仕方を変えるからこそ、価値があります。
分位点は、現実が必ずその線以下に収まるという約束ではありません。過去に戻った予測を繰り返し、較正を確認する必要があります。90パーセンタイル予測を実績が想定以上の頻度で超えるなら、その値は手元のデータで信頼できる計画上の境界になっていません。
適切な境界は意思決定にもよります。品切れと、少し余分な在庫を抱えることでは費用が異なります。そのため中央値より高い分位点で動くチームもあれば、より安価で保守性の低い計画を許容できる仕事もあります。
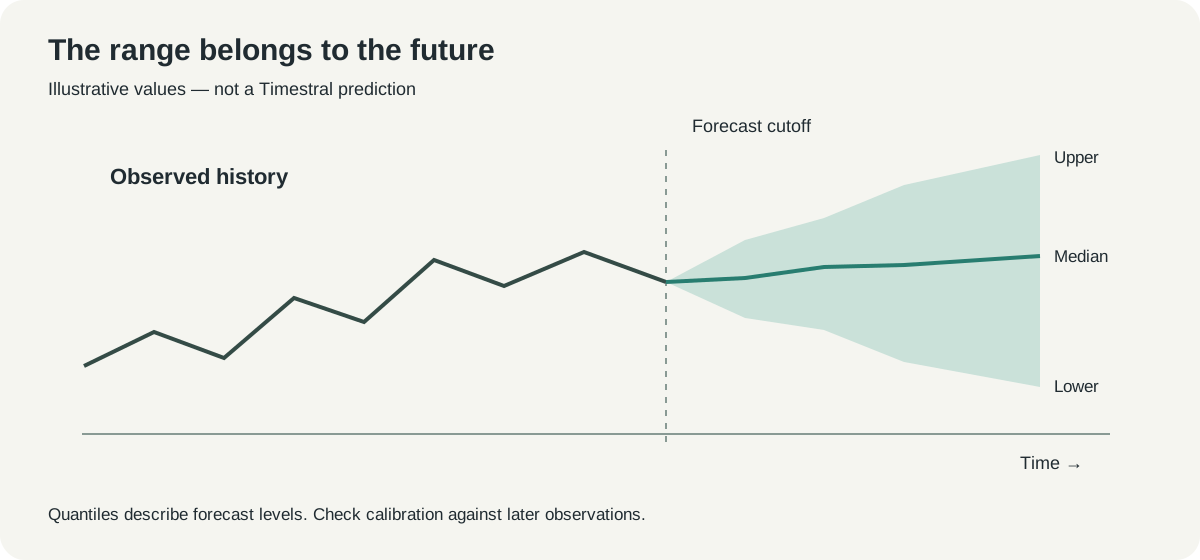 独自の解説図。曲線と幅は予測期間を説明するための架空例で、Timestralの出力ではありません。
関連する信号は、時点を正しく扱ってこそ役立つ
MistralはTimestralを、過去のみの共変量と、将来値が既知の共変量に対応する多変量モデルと説明しています。つまり、関連する複数の数値信号や、先の値がすでに分かっている情報を使えます。発表の説明
店舗の営業カレンダーは明日になる前から分かります。明日の実際の売上は分かりません。完成済みの表に両方の列が便利にそろっていても、予測実験はこの違いを守る必要があります。
サーバー容量の演習なら、製品公開の日程は事前に分かっても、正確なリクエスト量は分かりません。注文数なら、祝日フラグは既知で、最終的な注文数が予測対象です。これは区別の使い方を示す例で、実際の連携導入を主張するものではありません。
天気は、陥りやすい誤りの例です。履歴ファイルには実際の天候があっても、その時点の予測で使えたのは当時の天気予報だけです。後から判明した観測値で評価すると、意思決定時にはなかった情報を与えてしまいます。
問いに答えられる最小の実験から始める
公式リポジトリはCPU・GPUでの単独推論を提供します。CPUなら最初の試行を始めやすくなりますが、モデルのサイズだけでハードウェア要件は決まりません。依存関係、読み込むテンソル、履歴の長さ、系列数も実行時メモリに影響します。インストールと利用方法
入門では、5Mチェックポイントがインターフェースを学ぶ候補になります。小さな演習向けの提案であり、手元のデータで大きなモデルに勝つという主張ではありません。サイズを比較する前に、一連の処理を動かしましょう。
- 公式リポジトリのインストール手順とライセンスへのリンクを確認し、独立したPython環境で作業します。
- 等間隔の系列を1つ準備します。モデルへ数値配列だけを渡す場合も、元ファイルには時刻と単位を残します。
- 最後の数点をテスト用の予測期間として取り分け、予測に使う履歴には含めません。
- チェックポイントを読み込み、期間を指定して、中心予測と分位点を確認します。
- 同じ履歴による単純な予測と比べ、過去の複数の基準時点で繰り返してから判断します。
リポジトリは、Python 3.10以上、PyTorch 2.4以上を要件として、次のインストール方法を説明しています。インストールはコードを取得するため、再現可能な環境には確認済みのリビジョンを固定してください。
python -m venv .venv
# Activate the environment using your shell's activation command.
python -m pip install "git+https://github.com/mistralai/timestral.git"
以下は公開推論インターフェースを応用した小さな例です。値は合成した日次件数であり、記事内で実行して特定の結果を得たことを示すものではありません。
import numpy as np
from timestral import TimestralForecaster

history = np.array([
    80, 83, 85, 88, 96, 61, 58,
    82, 84, 87, 91, 99, 64, 60,
    85, 86, 89, 94, 102, 66, 63,
], dtype=np.float32)

model = TimestralForecaster.from_pretrained("mistralai/Timestral-5M")
forecast = model.forecast(history, prediction_length=7)
print(forecast.median)
print(forecast.quantile(0.9))
架空の3週間分でAPIは説明できても、業務の予測性能は判断できません。意思決定に使う前に、十分な長さの、意味を理解した系列へ置き換えてください。欠測を無条件にゼロにせず、欠けた観測や特殊な出来事を確認します。
3つの仕事で、文章生成との違いが見える
日々のサポート計画では予測を人員配置につなげます。日次の問い合わせ作成件数と、週末・休業日を示すカレンダーなどが入力になります。単純な平均では見落とす繁忙日も含め、必要な対応力の準備に役立つかが確認事項です。
サーバー計画では技術的な上限につなげます。一定時間のリクエスト数を予測しても、エラー、レイテンシ、対応可能な容量は別に監視する必要があります。需要予測では、アプリが特定の負荷に耐えることまでは証明できません。
在庫計画では調達期間につなげます。補充に数日かかるなら、明日の需要だけでは期間が不適切です。次の発注品がまだ届かない間を予測し、欠品と余剰在庫の結果を比べることが有用な演習になります。
3つの例に共通するのは、数量、判断する時点、予測によって変える行動を定義することです。モデルは業務の中の道具になります。予定する行動が明確な方が、その道具を評価しやすくなります。
その時点で可能だった予測を比較する
バックテストは、過去の予測機会を再現します。過去の基準時点を選び、その前に得られた情報だけで次の期間を予測します。基準時点を進めて繰り返し、将来の観測をモデル選びへ逆流させないようにします。
周期に合う単純な基準から始めましょう。週周期なら先週の同じ曜日、安定した短期の処理なら直近値が使えます。どちらも常に強いわけではありませんが、複雑さを足す価値があるかを教えてくれます。
| 比較 | 固定する条件 | 分かること |
|---|---|---|
| Timestralと季節性の単純基準 | 対象、基準時点、予測期間 | 意思決定に関わる誤差が改善するか |
| 5Mと大きなチェックポイント | 前処理と採点方法 | 追加の計算資源に見合う利益があるか |
| 既知のカレンダーの有無 | 各基準時点で取得可能な履歴情報 | 将来情報の漏洩なしに信号が役立つか |
| 中央値と高い意思決定用分位点 | 予測と業務コストの仮定 | モデルではなく計画方針がどう変わるか |
ゼロやそれに近い期間も確認します。対象が小さいと百分率誤差は解釈しにくくなります。系列に適した指標を使い、集計値と実際の外れ方を併せて調べましょう。
実用的な試験では、最も大きく外れた事例の小さな表が、平均値1つより多くを教えます。欠測、祝日、障害、実際の需要変化のどれと関係したのか。それによって、データ処理を直すか、情報を加えるか、予測手法を考え直すかが決まります。
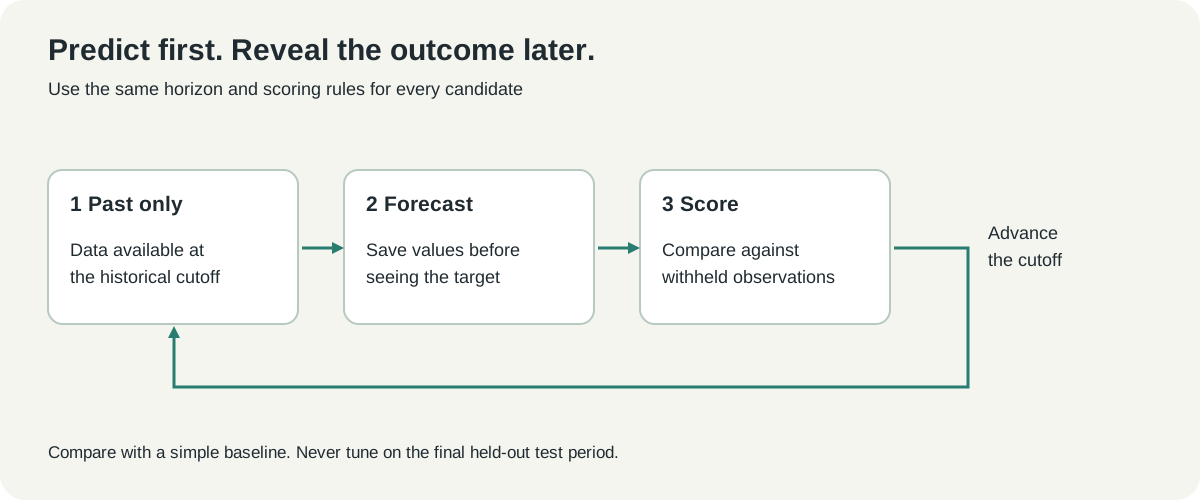 独自のバックテスト図。各予測はその基準時点で得られる情報だけを使い、後の観測は採点用に残します。
小さな重みだけで運用は完成しない
リポジトリはApache 2.0のコードと、Modified MITライセンスのモデル重みを区別しています。選んだチェックポイントの実際の条件を読んでください。公開コードと、別のライセンスで配布されるモデルは別の成果物です。ライセンスの説明
初回ダウンロードと通常推論も異なる段階です。文書にあるローダーはローカルキャッシュを使えますが、アプリ全体がオフラインであるには、全構成要素がそうである必要があります。ローカル予測モデルでも、別の処理が外部サービスへデータを送る可能性は残ります。
繰り返し運用するなら、各予測のチェックポイントと入力データの締め切り時点を記録します。その時点がないグラフは、後の観測を含んでいても予測と誤認されます。後で実績と比べられるよう、予測値を変更せずに保存しましょう。
欠測や実行失敗への対応も必要です。昨日の予測を最新のように見せると、画面だけが正常に見えます。最後に正常取得したデータ時刻を示し、古いモデル出力より単純な基準を使う条件を決めてください。
速い予測は、判断がよくなってこそ価値がある
MistralはCPUで扱いやすい推論と、このモデル群の高いベンチマーク性能を報告しています。調べる理由にはなりますが、自分のデータ処理の測定値ではありません。公表されたモデルの処理時間に、アプリ内のすべてのファイル読込、特徴量計算、待ち行列、描画が含まれるわけではありません。10月15日の発表
動かせる最大のモデルを試験の主役にしたくなりがちです。しかし重要なのは、意思決定に間に合い、意味のある誤差を改善するかです。少し正確でも、人員配置の締め切り後に届く結果は運用上の価値が限られます。
数値の改善と方針の改善も分けます。平均誤差が減っても、最も費用の大きい繁忙日は改善しないかもしれません。逆に中央値が少ししか変わらなくても、上位分位点の較正がよくなれば計画は改善できます。
モデル比較の前に基準を決めましょう。そうすれば、単純な基準を残す、小型を使う、より重い構成を正当化する、という有用な結論を出せます。根拠が明確なら、どれも正解になり得ます。
明日になる前に、予測を記録する
私たちは、専門的な数値予測を使いやすいモデルの流れに持ち込んだ点にTimestralの面白さがあると考えます。出力は業務量の天気予報として、中心的な見通し、幅、準備する理由を示せます。その予測が実際の計画につながって価値が生まれます。
1つの数量と1つの期間から始めましょう。実績が分かる前に予測を保存し、単純な代替方法と公平に比較します。そうして初めて、有望なモデルの発表が、結果を使える実験へ変わります。
出典と画像
2026年10月20日確認。例と図は説明用であり、モデル実行の結果ではありません。公開モデルカードは著者が撮影し、解説図は独自制作しました。出典とライセンス表示はメディア記録をご覧ください。
予測と実績を一緒に残す
データの定義、予測の基準時点、確認メモを元の出典リンクと一緒に保存しましょう。Telli.shは実験記録の整理に役立ちます。Telli.shアカウントを作成