AnyDecisionModelとAnySpeechRecognizer、Swiftアプリの「聞く」と「選ぶ」を分ける
サードパーティー製のSwiftパッケージが、音声認識エンジンと型付きの意思決定をつなぎます。ローカル推論、確信度の校正、範囲を限定した試作の始め方を解説します。
サポート窓口の録音には、異なる二つの課題があります。まず、アプリは発信者の言葉を復元しなければなりません。次に、その依頼を請求担当、技術サポート、あるいは別のチームのどこへ回すか決める必要があります。両方を一つの自由形式の会話として扱うと、アプリが担う責任が見えにくくなります。
開発者のMatttは、2026年10月29日にAnySpeechRecognizerとAnyDecisionModelを発表しました。Appleプラットフォームの開発者に向けたサードパーティー製のSwiftパッケージです。一方は音声認識エンジンを選択でき、もう一方は型付きの選択結果と確率分布を返します。なじみのあるSwiftの設計パターンを活用していますが、Apple自身による製品発表ではありません。Matttの紹介記事は、同じサポート通話の例を使って二つの役割を説明しています。
注目すべき点は、この二つの役割を個別に選択し、評価できることです。本記事では、各パッケージの役割、ローカルとホスト型のバックエンドがアプリ設計に与える違い、数値で示される確信度にも製品側の判断ルールが必要な理由を解説します。
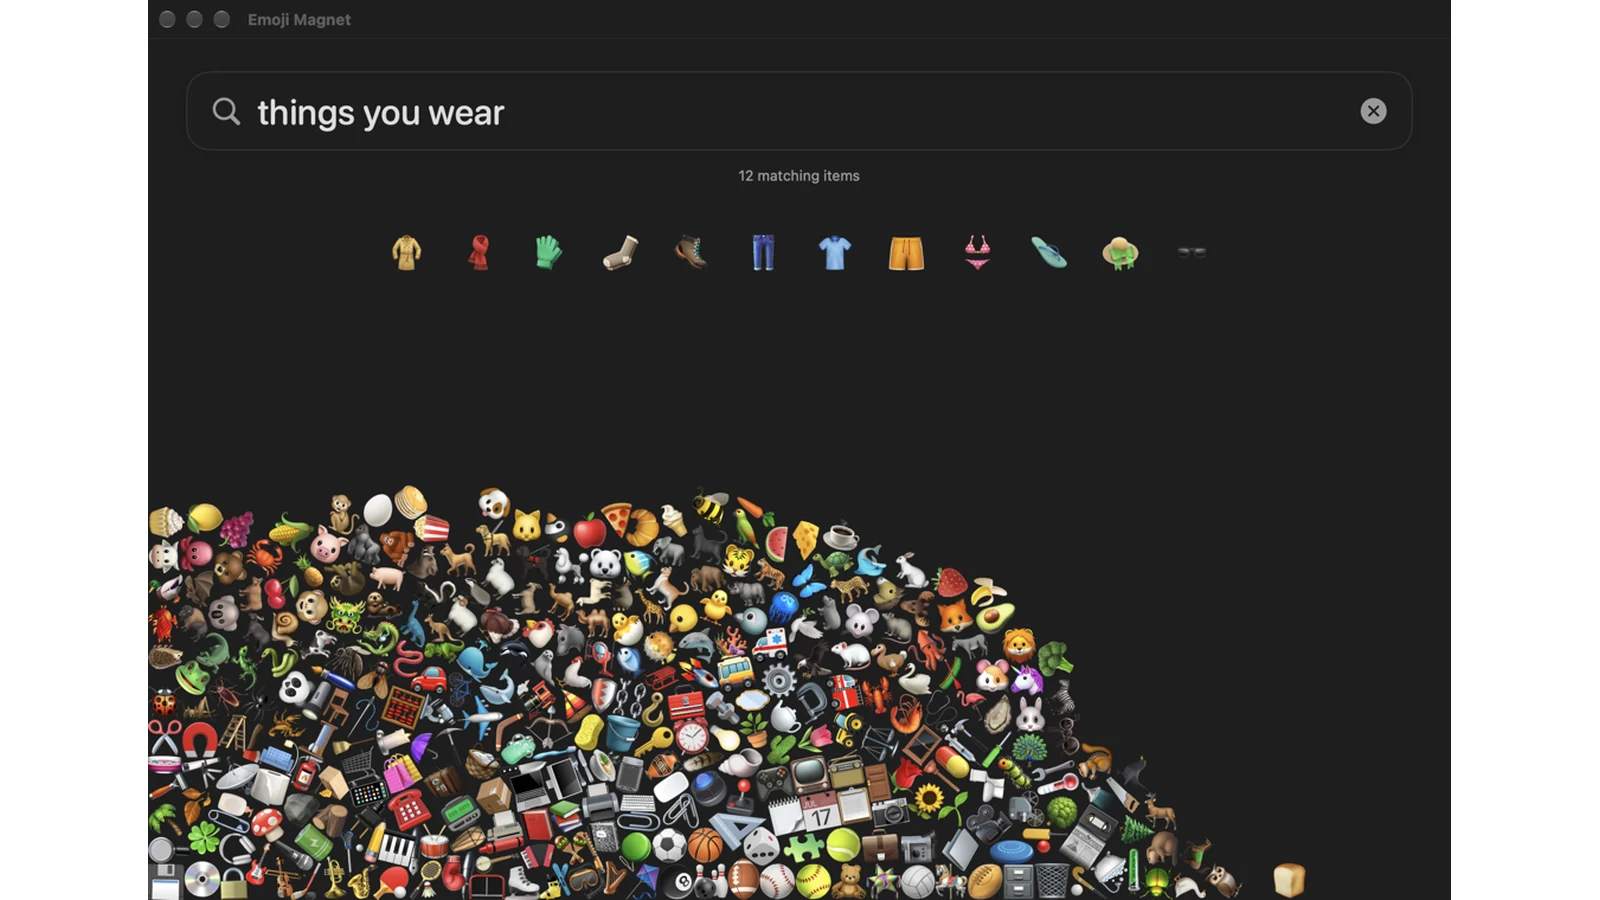 Mattt の Emoji Magnet サンプル アプリは、絵文字の並べ替えに AnyDecisionModel を使用します。著者提供のドキュメントのスクリーンショット、Apache 2.0。余白を付けてサイズ変更しました。 画像ソース · ライセンスと画像に関する注意事項
文字起こしと振り分けには個別の受け入れテストが必要
「請求書が間違っているうえ、ダウンロードしようとしてもサインインできません」という問い合わせを考えてください。この一文を正しく文字起こしできても、振り分けを誤る場合があります。請求書の問題として請求担当へ送るのか、ログインできないため技術サポートへ送るのか、両方を含むため総合窓口へ回すのか、という問題です。
答えはサービスの運用ルールによって決まります。モデルが特定のラベルを強く推しただけで、未定義の担当範囲が埋まるわけではありません。バックエンドの評価前に、許可する各選択肢の意味と、複数に当てはまる場合の扱いを書き出してください。「出力がもっともらしく見えた」よりも有用な評価目標になります。
処理段階を分けると、不具合も診断しやすくなります。認識エンジンが製品名を誤った場合は、その文字起こしを保存し、正しい語であれば判断が変わるか確認します。文字起こしは正確なのに担当チームを誤った場合は、選択肢の定義と意思決定モデルを調べます。修正すべき箇所は異なり、両者を一括りにすると原因が隠れます。
本稿では、最も価値のある抽象化は「聞く」と「選ぶ」の境界にあると考えます。各段階で、次の段階が確認できる成果物を残すべきです。そうすれば製品チームは、自動実行を認める段階と、人への提案にとどめる段階を判断できます。
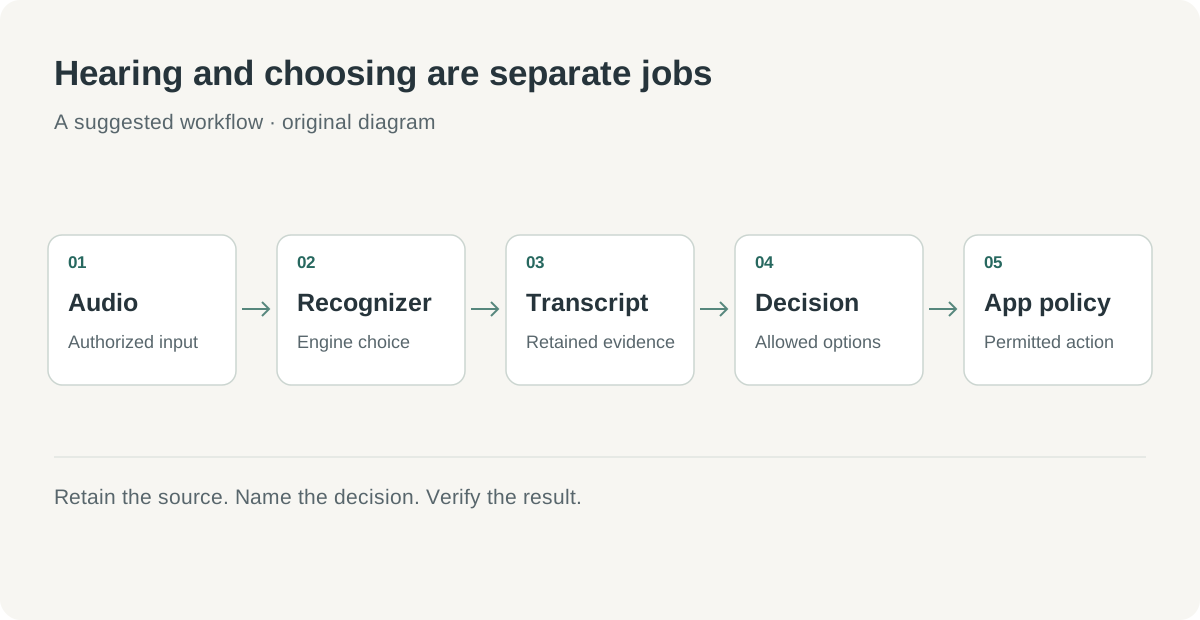 独自作成のワークフロー図。音声認識が根拠を残し、範囲を限定した意思決定が分布を返します。実行を許可する操作はアプリ側が決めます。
音声と操作に合わせてエンジンを選ぶ
2026年11月2日に確認したAnySpeechRecognizerのREADMEは、Appleの新しいSpeechフレームワークを手本にしたAPIと、Apple、Parakeet、Qwen3-ASRの選択肢を説明しています。エンジンによって機能は異なります。公開比較では、一部の構成はライブの暫定結果と単語ごとの時刻情報に対応する一方、Qwen3-ASRは単語時刻を含まないセグメント単位の結果を返します。パッケージはSwift 6.2以降とmacOSまたはiOS 26以降を前提とし、モデルによって追加のハードウェア要件があります。
この違いは製品設計に表れます。ライブ字幕では話し終わる前に文字が届く利点がありますが、暫定的な単語が変わる可能性を示す必要があります。ファイル取り込みでは確定結果を優先し、処理が終わるまで待つ設計もできます。同じ文字起こし画面を使う場合でも、両モードの更新タイミングが同じだと誤解させるべきではありません。
例えば取材用アプリでは、文をタップして録音の該当箇所へ移動するため、単語時刻が不可欠かもしれません。音声メッセージの受信箱なら、短い伝言の確認が中心なので、セグメント単位の文字起こしで足りる場合があります。操作の設計を定めてからエンジンを選び、利用者が実際に使う言語、アクセント、録音条件で検証してください。
対応言語にも同じ考え方が当てはまります。対応言語一覧は利用候補に入るかの確認であり、雑音を含む顧客の録音こそが受け入れテストになります。権限のある確認担当者が元の音声を参照でき、重要な名前や数字を修正できるようにします。修正履歴は、認識設定を変えるべきか、製品側の訂正操作を改善すべきかを判断する材料になります。
音声の収録は引き続きアプリ側が担当します。これは有用な責任分界です。録音の許可、入力元の選択、収録の開始から終了までの管理はアプリに残ります。特に中断、キャンセル、途中終了をUIで扱う必要がある場合、認識ライブラリを録音機能全体と取り違えないことが大切です。
型付きの判断で解析の手間を減らす。責任の定義は残る
2026年11月2日に確認したAnyDecisionModelのREADMEは、二値の確率、許可された選択肢からの選択、順序尺度上のスコアを説明しています。ローカルのMLX、Core AI、llama.cppに加え、JevとOllamaのバックエンドに対応します。説明文からラベルを抽出する作業をアプリに求めず、構造化した結果を返すAPIです。
これによりアプリの処理を大幅に簡素化できます。結果が担当部署なら、コードで部署ごとの処理を明示できます。メッセージの確認が必要かを問う場合は、その結果をレビュー状態を持つルールへ渡せます。それでも、「レビュー」で何を行い、誰がそのキューを管理するかはアプリ側で定義する必要があります。
保守報告アプリを例にすると違いが明確です。作業者が状況を録音し、認識エンジンが文章を生成し、判断層が複数の設備分類から一つを提案します。保存前に、文字起こしと提案を並べて表示できます。ただし、分類の提案を、利用者に知らせず安全判断、修理指示、設備の運転許可へ変換するべきではありません。
順序付きスコアにも具体的な定義が必要です。緊急度を3段階で求めるなら、各段階で必要な対応やサービス水準を説明します。「低・中・高」は表示しやすくても、確認担当者ごとに解釈が異なれば評価しにくくなります。短い評価基準を書いておけば、認識の違いが学習やしきい値の問題として扱われる前に明らかになります。
| 手法 | アプリが受け取るもの | 適した場面 | 主な評価上の問い |
|---|---|---|---|
| 自由形式の生成 | 理由の説明を含み得る文章 | 利用者に説明や下書きが必要 | 内容は正確で使えるか |
| 選択肢を限定した判断 | 許可された選択肢の一つと分布 | アプリで分類を定義している | 分類ルールに従った選択か |
| 順序付きスコア | 定義された各段階への分布 | 意味のある順位付け基準がある | 各段階が想定した対応に結び付くか |
| 人による確認 | 人が記録した判断 | 背景が不足する、または影響を踏まえた判断が必要 | 確認担当者に十分な根拠があるか |
この比較はインターフェース設計のためのもので、特定の技術が常に優れるという主張ではありません。選択肢を限定した判断と簡潔な説明の両方が必要な画面もあります。説明と根拠を区別して示し、業務フローが許す場合は判断を編集できるようにします。
確信度は分布の指標であり、正解率の保証ではない
AnyDecisionModelのREADMEは、有用な区別を明示しています。ローカルの確信度が測るのは回答分布の集中度であり、選ばれた回答が正しい確率ではありません。また、異なるバックエンドの確信度を、同じ計算式による値のように比較しないよう警告しています。校正には、評価用データとは別のデータを使う必要があります。2026年11月2日確認のプロジェクト文書。
仮のテストで、一つの部署に0.90の確率が付き、残りが他の部署に分配されたとします。それは、与えた問いと選択肢の下でモデルがその部署を強く選好したことを示します。同種の顧客メッセージで過去に90%正解したことを示す値ではありません。分類の定義が曖昧だったり、入力に重要な背景が欠けていたり、モデルに特定の選択肢を好む偏りがあったりする可能性があります。
したがって、製品の判断ルールには「レビュー待ちにする」経路を明示する必要があります。最初はすべての判断を確認担当者に見せ、訂正を集めます。その後、対象を狭く定義した自動処理を任せられる部分があるか評価します。しきい値は、自信がありそうに見える数字で決めず、観測した誤りとその損失から導きます。
評価用データには、曖昧なメッセージ、見慣れない名前、どの部署にも適切に当てはまらない例を含めます。すべての例が一つの分類にすっきり収まれば高性能に見えても、実際のサポートに多い複合的な依頼で失敗しかねません。選択を変えた理由も記録してもらうと、モデルの誤答とルールの不足を区別できます。
誤りの方向ごとの損失も調べます。通常の依頼をレビューに回すと時間を使いますが、機微な依頼を気付かれないまま誤った相手へ送れば、別の影響が生じます。単一の平均スコアでは違いが隠れます。製品責任者にとって重要な事例を報告し、利用者と保守担当者に説明できる実行ルールを選びます。
バックエンドの変更が製品上の変更でもあるのは、このためです。同じSwiftの呼び出しでも、動作、数値の意味、運用上の依存先が異なり得ます。従来のしきい値を新しい設定に適用する前に、評価をやり直します。結果とともにモデル識別子、設定、選択肢の定義を保存すれば、後から判断の経緯を説明できます。
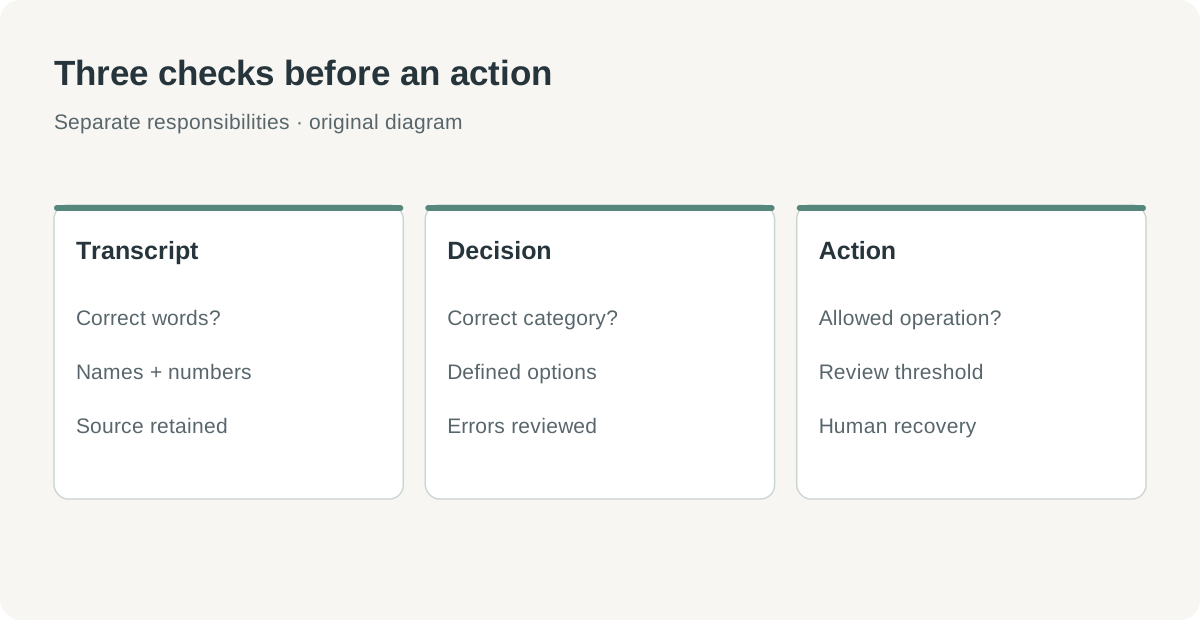 独自作成の図。選好が強くても、正しさの評価や実行ルールの定義は必要です。確信度と正解率は異なる問いに答えます。
ローカル実行はチームが担う作業を変える
端末内でのモデル実行は、音声受信箱やオフラインの参照ツールに適している場合があります。入力をローカルに保存し、ネットワークとの境界を明確にした設計ができます。一方、モデルのダウンロード、対応機器、メモリ使用量、初回準備は利用体験の一部になります。プライバシーに関する説明では、後から追加するホスト型の処理も含め、経路全体を扱う必要があります。
ホスト型の意思決定バックエンドは一部の運用をサービス側へ移しますが、ネットワーク、認証情報、サービスの稼働状況という依存関係が加わります。失敗時や処理待ちの状態を、利用者が理解できる形で示す必要があります。再試行しても元の文字起こしを保持し、完了済みの後続操作を誤って繰り返さない設計が必要です。
現行のプロジェクト文書も、互換性のテストと稼働中サービスの検証を区別しています。AnyDecisionModelによれば、JevとOllamaの通信互換性テストには固定のテストデータを用います。これは有用なテスト範囲ですが、出荷するアプリでは、選んだサービス構成を一連の流れで検証する必要があります。2026年11月2日確認のAnyDecisionModel README。
開発者のMacと、対応対象で最も性能の低いスマートフォンに、同じ性能を約束するべきではありません。デプロイ先の指定は実行を想定する環境を示すもので、全端末の遅延、バッテリー消費、メモリ使用量を保証する資料ではありません。まず検証済みの1台でファイル処理から始め、他のハードウェアでも想定操作を確認した後に対応範囲を広げられます。
結果を確認できるファイル処理から始める
最初の試験導入では、不具合を確認しやすくします。許可された同じ音声を再生して比較できるため、小さなファイル処理アプリの方がライブアシスタントより出発点を明確にできることがあります。リアルタイム操作を加える前に、各段階と受け渡しを検証するのが目標です。
- 許可される決定の短いリストと、あいまいなケースに対する書面によるルールを含む 1 つのタスクを定義します。アプリケーションのポリシーにレビュー オプションを含めます。
- 現在のパッケージ要件を確認し、関連する Swift パッケージの依存関係を追加します。すべての組み合わせを一度に評価するのではなく、1 つの認識エンジンと 1 つの意思決定バックエンドを選択します。
- 利用を許可された録音の小さなセットをインポートします。元のファイル、予想される文字起こし、および確認担当者の決定を別の記録に保管してください。
- パッケージのドキュメントに従って、必要なモデル資産を明示的にインストールまたはステージングします。準備と処理を別個の UI 状態として表示します。
- 認識を実行し、最終的なテキストを保持し、そのテキストについて限定された質問をします。外部アクションをすぐに実行するのではなく、結果をソースと並べて表示します。
- 段階ごとにエラーを確認し、変更を加えた後に別の記録セットを評価します。すべての結果とともに構成を記録します。
- ライブ キャプチャまたは自動ルーティングに拡張する前に、キャンセル、利用できないモデル、およびネットワーク障害の動作を追加します。
達成基準は、製品責任者が理解できるものにします。例えば音声受信箱の試験では、確認担当者が元の録音を見つけ、文字起こしを訂正し、提案されたキューを変更しても、元資料が一切失われないことを条件にできます。自動化の可否を決める前でも、有用な業務上の成果になります。
小さな判断にも製品全体の設計が必要
これらのパッケージは、一つの部品で聞き、別の部品で選び、アプリのコードで許可された操作を実行するという、魅力的な構成を提案しています。品質を測る場所と、失敗から復旧する場所を作れます。数値による回答の限界も、その結果を信頼する必要がある人に説明しやすくなります。
検証する価値があるのは保守性です。アプリ全体を書き直さず認識エンジンを交換できるでしょうか。従来のしきい値がそのまま通用すると見なさず、新しい判断バックエンドを評価できるでしょうか。実際に誤りが生じた段階で、利用者が結果を訂正できるでしょうか。
小型モデルは、役割が明確で、その出力に責任を持つ人がいるときに役立ちます。Swiftの抽象化は部品をつなぎ、製品の意思決定ルールがそれぞれに目的を与えます。
出典
- Mattt: AnySpeechRecognizer および AnyDecisionModel の紹介、2026 年 10 月 29 日。
- AnySpeechRecognizer: 要件、エンジンの比較、例、2026 年 11 月 2 日に確認。
- AnyDecisionModel: バックエンド、キャリブレーション、および制限、2026 年 11 月 2 日に確認。パッケージ コード ライセンスと個別のモデル ライセンスについては、個別に考慮する必要があります。
- Mattt:Emoji Magnetの説明とスクリーンショット、Apache-2.0の文書。2026年11月2日確認。
実装判断を根拠となる資料と結び付けて残す
Telli.shは、利用を許可された資料と、実装判断の背景にあるメモを一緒に残すための選択肢です。ノート用ワークスペースを作成する。