StrataとQwen3.8-Flash-Next:180B級モデルを個人用PCで動かす方法
Strataのアーキテクチャ、Windows/Linuxのセットアップ、別系統のApple Silicon Mac向け手順、公表ベンチマーク、ローカルAIの限界を一次資料に基づいて解説します。
約1800億パラメーターのモデルを、グラフィックスカードのメモリーが12 GBしかないデスクトップで動かす。一見すると矛盾しているように聞こえます。Strataはその可能性を現実味のあるものにしていますが、全パラメーターをカードに押し込むことで実現しているわけではありません。より興味深いのは、疎なモデルの各部分に異なる種類のメモリーと計算資源を割り当て、生成するトークンのたびにストレージ転送がボトルネックにならないようにしている点です。
正式なモデル名はQwen3.8-Next-Flashではなく、Qwen3.8-Flash-Nextです。Qwenの記載によると、コアは1,250億パラメーターで、そのうち活性化されるのは60億です。さらに、510億のn-gram埋め込みコンポーネントと40億のマルチトークン予測コンポーネントがあります。丸めた「180B」という合計は保存されるコンポーネントの規模を表しており、各トークンで実行される密な計算量ではありません。Qwenモデルカード
以下のセットアップと性能に関する説明は、Strataのリビジョンfb58e0dbc8399662c0e47c76578c6e878b14f6cfを対象としています。ベンチマーク値はプロジェクトが公表した測定結果です。実際の結果はハードウェア、プロンプト、コンテキスト、モデルの派生版によって異なる場合があります。
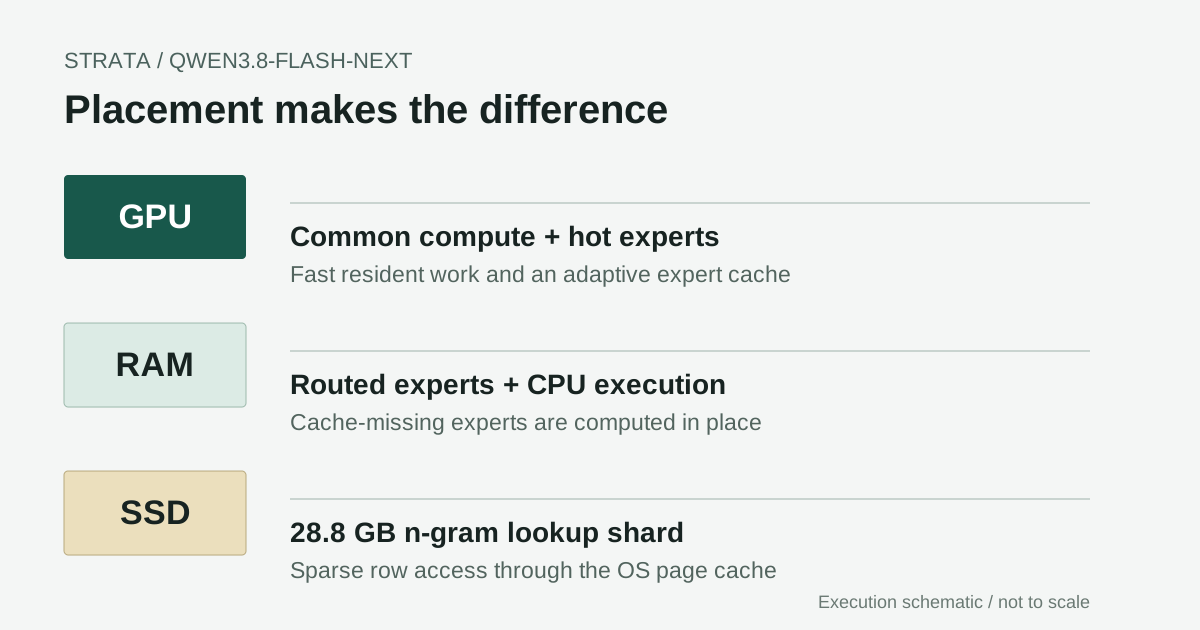
ドキュメントに記載された実行設計をもとに作成した概念図です。各層は縮尺どおりではありません。ダウンロード容量、RAM使用量、GPU上の常駐量はそれぞれ異なる指標です。
画期的なのはモデルの小型化ではなく配置です
非常に大きなローカルモデルについては、保存にどれだけ必要か、1トークンあたりどれだけがアクティブになるか、その処理がどこで実行されるか、という3点を確認する必要があります。アクティブなパラメーターが少ないという数字が答えるのは、2番目の問いだけです。それ以外の重みをどこかアクセス可能な場所に保持する必要はなくなりません。
Strataは、Niko1221リポジトリにあるコミュニティ開発の推論エンジン兼ローカル配信アプリケーションです。ドキュメント記載のセットアップでは、WindowsとLinuxへのインストール、ローカルのチャット画面、互換API、任意の画像入力が提供されています。Qwen公式のデスクトップ製品ではなく、独立したコミュニティプロジェクトです。Strataリポジトリ
有用な技術上の転換点は、PCを「メモリー不足のGPU」とだけ考えるのをやめることです。デスクトップにはシステムRAM、CPUのベクトル演算ユニット、OSのページキャッシュもあります。処理によってはGPUメモリーより遅くなりますが、すべての処理に等しく不向きというわけではありません。大きなテーブルの検索と密な行列積に、同じ配置方針を当てはめる必要はありません。
だからこそ、この大規模モデルの話題には意味があります。モデル自体は大きいままですが、実行環境が、その時点で最速のメモリーに置く必要のある部分を変えます。これにより、一般的なノートPCならどれでも快適に動くと証明されたわけではないものの、実用的なローカル推論への道が開かれます。
疎なアーキテクチャが可能性を生みます
Qwenのアーキテクチャは、リカレント型のGated DeltaNetブロック、Qwen Sparse Attention、ルーティングされるエキスパート、n-gram埋め込みを組み合わせています。技術レポートでは、これらのコンポーネントが効率的なスケーリングを意図して設計された理由を説明しています。これらのモデル部品を発明したのはStrataではありません。異なるアクセスパターンに合わせた実行方法を構築しているのがStrataです。Qwenアーキテクチャレポート
ルーティングの詳細が重要です。48層それぞれに512個のルーティング対象エキスパートがあり、各層で活性化されるのはそのうち10個で、これに共有エキスパートが加わります。したがって、全層にわたって24,576個のルーティング対象エキスパートが保存されます。これは、1トークンに対してモデル全体で24,576個のうち10個だけが使われる、という意味ではありません。Qwenアーキテクチャ設定
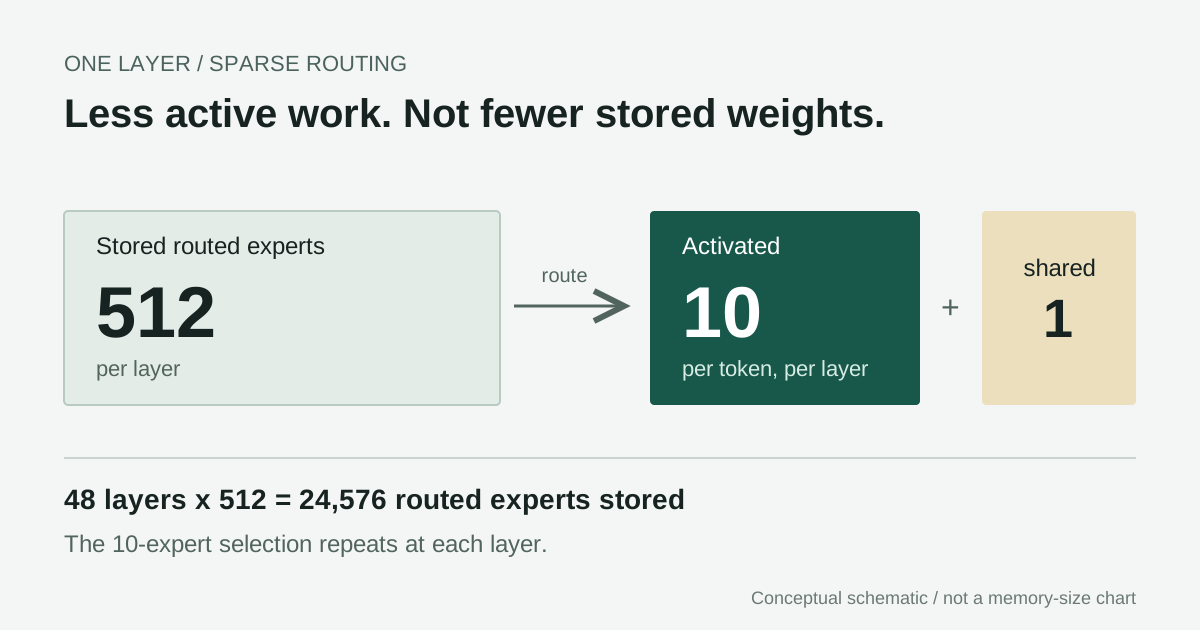
選択によって減るのはアクティブな処理量であり、保存する全体数ではありません。この図が表すのは1層であり、48層のモデル全体ではありません。
速度の主張とは切り離して考えてみましょう。選ばれる頻度が低いエキスパートを、高価なアクセラレーターのメモリーに常時置いておくのは容量の使い方として得策ではない場合があります。一方、各ステップで使われる別のコンポーネントを何度も移動させれば、コストがかさむでしょう。有用なスケジューラーには、この違いを見分け、避けられないキャッシュミスにも対処する仕組みが必要です。
このため、疎な180B級モデルを、パラメーター数だけで密な180Bモデルと比較するのは適切ではありません。逆に「6Bモデル」と呼ぶと、保存容量、ルーティング、コンテキスト状態、分散した重みへのアクセスコストが見えなくなります。どちらの単純化も、実際の技術課題を覆い隠します。
GPU、RAM、SSDにはそれぞれ別の役割があります
ドキュメントに記載された基本構成では、GPUが共通処理と、頻繁に使われるルーティング対象エキスパートのキャッシュを保持します。システムRAMにはルーティング対象エキスパートの重みが置かれ、GPUキャッシュにないエキスパートはCPUがその場で計算します。別個のメモリーマップされたn-gramテーブルはSSDに置き、必要な行をOSのキャッシュ経由で提供します。Strata実行方式の概要
このCPU経路は、単に「オフロード」と呼ぶ以上に重要です。デコード中にキャッシュミスが起きても、処理を続ける前に不足したエキスパートをすべてGPUへコピーする必要があるとは限りません。CPUとGPUの処理を並行して進められます。その代わり、CPU性能とシステムメモリー帯域が出力速度に直接影響します。
n-gramコンポーネントは、さらに異なるアクセスパターンを持ちます。数行を検索することと、テーブル全体を走査することは同じ負荷ではありません。そのため、量子化された28.8 GBの検索用シャードをSSDに置いたままでも実用的であり、生成のたびにモデル全体をディスクから読むという意味ではありません。ただし、低速ドライブやページキャッシュへの過度な負荷は応答性を損なう可能性があります。
プロンプトの事前処理(prefill)とデコードも異なります。最初のプロンプト処理では大きなバッチを使え、エキスパート転送と別レイヤーの処理を並行させる余地があります。次のトークンを繰り返し生成する処理は、レイテンシーに敏感です。プロジェクトの詳細ドキュメントでは、これらの段階ごとに異なるカーネル、スケジューリング、キャッシュ動作を説明しています。単一のスループット値では両方を要約できません。Strataの実装詳細
私の見立てでは、革新の核は単独の圧縮技法ではなく、連携するシステムにあります。量子化で保存する重みの容量を減らし、キャッシュで頻出する重みへの再アクセスを抑え、CPU実行でキャッシュミスに対応し、疎な検索で巨大なテーブル全体の読み込みを避けます。これらの利点のどれかを取り除けば、メモリーに余裕のないデスクトップは、ホストとしての説得力を大きく失います。
投機的処理は検証に通った場合だけ計算を節約します
Strataはモデルのマルチトークン予測コンポーネントも利用し、短い続きの候補を提案してターゲットモデルで検証します。出力トークンごとにターゲットの完全な処理を行う代わりに、候補がうまく通れば、1回の処理で複数トークンを受け入れられます。リポジトリによると、MTP経路では最大3トークンの候補を生成します。MTPの設計と実装
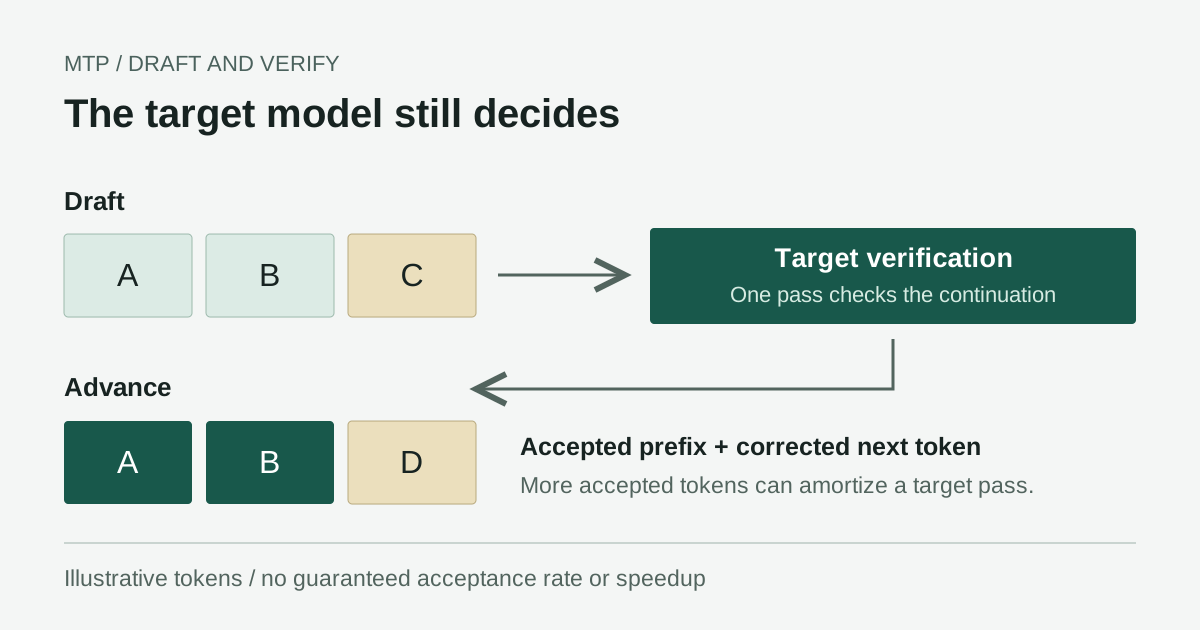
この例は検証の仕組みを示すものであり、受理率や速度向上を保証・測定するものではありません。
これは条件付きの高速化です。予測しやすいコードや繰り返しの多い文章は、なじみのない推論の展開より候補を作りやすい場合があります。プロンプトの表現、サンプリング、出力の長さ、モデルの派生版によって受理率は変わります。あるプロンプトで測った数字を、別の言語やタスクにも当てはまると考えるべきではありません。
検証対象は、実際に実行しているモデルです。量子化によって失われた情報が戻るわけではなく、元のBF16重みと同等であることを証明するものでもありません。この2点は分けて考える必要があります。投機実行と低精度モデルの品質は、別の問いに答えるものです。
キャッシュ再利用についても、別の区別が必要です。変化していない会話の先頭部分を使い回せば、作業を繰り返さずに済む場合があります。しかし、キャッシュが温まった追質問と、初回の長いプロンプトは同じテストではありません。ローカル環境の結果を比較するときは、先頭部分が再利用されたかを記録してください。プロジェクトのドキュメントでは、メッセージ境界でのキャッシュが明示されています。プレフィックスキャッシュの挙動
「GPUが12 GB」と「インストール容量が12 GB」は別の話です
公開されているGGUF量子化版は、メインシャードと固定サイズの28.8 GB n-gramシャードに分かれています。以下のファイルサイズは10進GBで、ダウンロード容量であり、GPUメモリーの必要量ではありません。任意のビジョンプロジェクターは約0.91 GBを追加し、補助ファイルや一時的な変換ファイルにも追加容量が必要です。ISTA-DASLabの量子化ファイル
| バリアント | コアの重み当たり平均ビット数 | メインシャード | n-gramシャード | 総ダウンロード量 |
|---|---|---|---|---|
| Q2_0 | 2.40 | 37.6 GB | 28.8 GB | 66.4 GB |
| IQ2_XS | 2.50 | 39.2 GB | 28.8 GB | 68.0 GB |
| IQ3_XXS | 3.00 | 47.0 GB | 28.8 GB | 75.8 GB |
| IQ3_S | 3.50 | 54.8 GB | 28.8 GB | 83.6 GB |
形式名だけでは、すべてのテンソルを正確に説明できません。メインシャードは複数の形式を組み合わせ、n-gramシャードにはIQ4_NLを使います。「2ビットモデル」は手短な呼び方ですが、全ダウンロードがパラメーターあたり厳密に2ビットだと思わせるなら誤解を招きます。量子化の方法
モデル全体を最初に試すなら、対応GPUを少なくとも12 GB以上とし、システムRAMを64 GB確保するほうが、GPUだけの数字を見て計画するより現実的です。リポジトリにはRAMを減らす経路や枝刈り済みCoder版についても記載があります。これらは別構成であり、32 GBマシンでも同じフルモデル体験が得られる証拠ではありません。Strataのモデル選択
試す前に、SSDの空き容量を100~150 GB確保しておくことをおすすめします。これは余裕を見た計画上の目安であり、ベンダーが定めた固定要件ではありません。選ぶ量子化版、MTP補助モデル、任意のビジョン用ファイル、ビルド・変換キャッシュによって、実際の合計は変わります。Q2の一部のCPU最適化経路では、エキスパートのコピーに相当な追加容量が必要です。共通の容量値を決めつけず、選択した経路を確認してください。
ハードウェアを選ぶ前に、必要な構成を明確にしましょう。フルモデルか枝刈り版か、短いコンテキストか長いコンテキストか、画像対応かテキストのみか、持続的なスループットか時々使う用途か。選択によってボトルネックの場所が変わります。以下のベンチマークは特定の1台のシステムを対象としています。
調整を始める前に、特定のリビジョンを固定して導入します
ドキュメント記載の標準経路はWindows 10/11とUbuntu 22.04/24.04を対象とし、対応するNVIDIA GPUと一部のAMD GPUで利用できます。NVIDIAの手順ではドライバー580以降が指定されています。macOSや、ソースからビルドするその他のバックエンドには別の要件があり、以下のコマンドは万能なセットアップ方法ではありません。公式インストールガイド
Windowsではダウンロード前に確認します
Gitがなければ、公式配布元からインストールしてください。PowerShellで上流リポジトリをクローンし、ここで確認したリビジョンを固定します。
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
.\START-HERE.bat --check
このチェックでは大容量のモデルをダウンロードしませんが、ランチャーがPythonや専用環境をセットアップする場合があります。セットアップチェックの動作
ハードウェアレポートを読み、セットアップスクリプトを確認し、空き容量を確かめてから続行します。その後、対話式のセットアップを開始します。
.\START-HERE.bat
64 GB環境で最初に試すなら、ドキュメントにある選択肢の中ではIQ2_XSが妥当な出発点です。コンテキストは32,768トークン、テキストのみとし、Experimental Speed Projectionはオフにします。コンテキストを最大にし、画像対応とすべての最適化を一度に有効にするより、この小さな基準構成のほうが問題を切り分けやすくなります。
小さな単体実行ファイルだけで済むわけではなく、ダウンロードや依存関係のインストールが発生します。GPUの経路によっては、準備済みエンジンまたはビルドツールを使用します。ドライバー、コンパイラー、管理者権限に関する確認画面は内容を確認してください。インストールを強行するために、ウイルス対策やブラウザーの保護機能を無効にしないでください。必要なドライバーはハードウェアベンダーから入手してください。
次回以降も同じランチャーを使います。セットアップを再度開く場合やポートの競合を避ける場合は、次のようにします。
.\START-HERE.bat --setup
.\START-HERE.bat --port 8081
Ubuntuではドキュメント記載のセットアップスクリプトを使います
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
./setup.sh
GPUに合ったバックエンドを選びます。AMDのROCm経路とNVIDIAのCUDA経路は互換ではありません。パッケージマネージャーやコンパイラーのインストール確認は、自分のマシンに変更を加える操作として内容を確認してください。固定したリビジョンによりこの記事の手順を再現しやすくしています。新しいリリースで対応状況が改善している可能性もあるため、意図的に更新する前にリリースノートを読んでください。
エージェントに接続する前に応答を確認します
モデルの読み込みが終わったら、ローカルブラウザーでhttp://127.0.0.1:8080または選択した別ポートを開きます。機密情報を含まない短い質問を送り、回答が最後まで生成されることを確認してください。それから長いプロンプト、追質問でのキャッシュ再利用、使用予定の言語を試します。初回ロード中はメモリー使用量とサーバーログを確認します。
互換APIとして、ドキュメントにはGET /v1/modelsとPOST /v1/chat/completionsが記載されています。推測した別名をクライアントへコピーするのではなく、配信中のモデルIDを確認してください。
$base = "http://127.0.0.1:8080"
$models = Invoke-RestMethod "$base/v1/models"
$models.data | Select-Object id
互換クライアントの設定には、返されたIDを使います。モデル一覧の取得に成功すればモデルを検出できたことはわかりますが、生成品質までは確認できません。最初に意味のある確認となるのは、チャット応答が最後まで返ることです。この初回テストでは、ファイル書き込みやシェル実行を行うエージェントツールを無効にしておいてください。
GPUのメモリー不足が起きたら、まずコンテキストを短くし、画像機能をオフにします。プロセスが強制終了されたり、マシンのスワップが激しく発生したりする場合は、VRAMだけでなくシステムRAMを調べてください。ランタイムライブラリーが見つからないときは、無関係なDLLをインストールせず、バックエンド固有の手順を確認します。プロジェクトには症状別のガイダンスがあります。Strataのトラブルシューティング
Macではモデル対応とStrata対応を分けて考えます
Apple Siliconは、デスクトップベンチマークのようにGPUのVRAMとシステムRAMを分けず、ユニファイドメモリーを使います。固定したStrataインストーラーの資料には、サポート対象のmacOS経路が記載されていません。Mac対応の要望があることは、移植が完了したことを意味しません。上流のMac対応要望
Macで試すと言っても、2種類の異なる実験が考えられます。コミュニティによるStrata-macOSフォークは、Metalバックエンドによって小さめのGGUFモデル向けにインターフェースとPython APIを維持しています。ドキュメント記載の確認例はQwen2.5であり、元のFlash-Next構成ではありません。このフォークはStrataのCUDAエキスパート・ストリーミングやMTP経路を移植していないと明記しています。このフォークを、この記事のモデルをワンクリックで導入する手段と考えないでください。コミュニティフォークと対象範囲
Qwen3.8-Flash-Nextそのものについては、別の実験的な選択肢として、互換性のあるllama.cppのMetalビルドと配布元の分割GGUFファイルを使う方法があります。これはMac上のStrataではなく、以下のWindows速度表も適用されません。
別系統のMetalランタイムをビルドします
Apple Silicon搭載Mac、ネイティブARM64のターミナル、Appleのコマンドライン開発ツール、Git、CMakeを用意します。CMakeがなければ、公式配布元または信頼できるパッケージマネージャーからインストールしてください。確認したllama.cppのビルドドキュメントでは、macOS上でMetalがデフォルトで有効になります。エンジンのリビジョンを固定すれば、移動するブランチによって例が予告なく変わることも防げます。llama.cpp Metalビルド手順
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git checkout 71ad0590f4808b6202f9213d166913858c73b1bc
cmake -B build -DCMAKE_BUILD_TYPE=Release -DGGML_METAL=ON
cmake --build build --config Release -j 4
./build/bin/llama-cli --version
配布元のファイル一覧からIQ2_XSの2つのシャードを両方ダウンロードし、元のファイル名のまま1つのディレクトリーに置きます。検索対象の行をディスク上に残す場合でも、2つ目のシャードが必要です。以下の例にあるモデルパスを、Mac上の実際の先頭シャードのパスに置き換えてください。
./build/bin/llama-cli \
  -m "/path/to/IQ2_XS/Qwen3.8-Flash-Next-GSQ-RCO-IQ2_XS-00001-of-00002.gguf" \
  -lm mmap --lazy-mode on -ngl 99 \
  --ctx-size 4096 --n-predict 128 \
  -p "Explain sparse expert routing in three sentences."
配布元の資料には分割ファイルの読み込みとmmap/lazyフラグの例があり、確認したエンジンではそれらのオプションを利用できます。n-gramテーブル全体をメモリーに常駐させず、必要に応じて使えるようにします。これらはllama.cppのオプションであり、Strataランチャーのオプションではありません。GGUF読み込み例
容量は依然として重要です。IQ2_XSのメインシャードだけで39.2 GBあり、これにランタイム状態とmacOSの使用分が加わります。そのため、16 GBまたは24 GBのMacは、この例の全体をメモリーに常駐させる現実的な基準構成ではありません。64 GBであっても計画の出発点であり、動作を保証するものではありません。アクティビティモニタでメモリー負荷とスワップを確認し、4Kコンテキストから始め、メモリー負荷が高い状態が続く場合は中止してください。適合しない構成を無理に動かすためにカーネルのメモリー制限を変更しないでください。
ログでMetalが選択されていること、テキストのみで筋の通った回答が最後まで生成されることを確認してから、次の実験に進みます。その後、投機的デコーディングや画像機能を加える前に、長めのプロンプトも試してください。この経路はIntel Mac、複数Macにまたがる分散実行、MLX変換には対応していません。ここではMacのスループット値はありません。結果は正確なチップ、ユニファイドメモリー容量、エンジン、量子化版、コンテキストによって異なります。
公表速度は期待できますが、初回トークンまでの時間は別の話です
再現性のある比較のため、後から追加されたREADMEの見出し値を混ぜず、2026年9月29日のエンジン0.1.26のベンチマークを使います。測定環境はPCIe 5.0 x16接続のRTX 5070 12 GB、6コアのRyzen 5 7600、64 GB DDR5-5200、Windows 10です。テストはgreedy生成、MTP有効、画像無効、生成トークン数256で行われました。ベンチマーク条件
| バリアント | 短いプロンプトのデコード、トークン/秒 | 長いプロンプトのデコード、トークン/秒 | 中程度のプロンプトのprefill、トークン/秒 | 長いプロンプトの最初のトークン、秒 |
|---|---|---|---|---|
| Q2_0 | 92.97 | 73.73 | 2170.85 | 62.48 |
| IQ2_XS | 78.60 | 62.72 | 2092.02 | 74.85 |
| IQ3_XXS | 61.64 | 48.95 | 1745.16 | 81.71 |
| IQ3_S | 53.30 | 45.51 | 1624.07 | 90.72 |
短・中・長の各階層のプロンプトは、それぞれ3,562、31,566、128,478トークンです。各セルは1回の実行結果であり、信頼区間付きの平均値ではありません。IQ2_XSの実行では、ドキュメント記載のSwift 1.5ファインチューンが使われているため、ベースモデルとの量子化だけを変えた統制比較ではありません。数値は公表された結果表から転記しています。 機械可読の測定値
Q2_0で長いプロンプトを使った場合、後続のデコード速度が73.73トークン/秒であっても、最初のトークンが出るまでに62.48秒かかります。新しい文書を待つユーザーにとって、その最初の1分は重要です。コンテキストを再利用する継続中の会話では、体験が異なる可能性があります。最大トークン/秒の主張で、どちらの状況も隠してはいけません。
これらの数値から導ける結論は限定的ですが、有用です。著者が指定したデスクトップでは、選択した量子化構成が対話的な速度で生成できました。帯域幅の低いマシン、韓国語、サンプリングを使った推論、画像機能を有効にした場合、複数ユーザーが同時に使う場合にも同じ結果になるとは示していません。トークンは単語ではなく、言語ごとのトークン分割も単純な比較を難しくします。
モデル本来のコンテキスト長262,144トークンや拡張コンテキストの主張も、選択したStrata構成でその長さを快適に処理できる保証にはなりません。ランタイム状態、キャッシュ配置、利用可能なRAMは引き続き重要です。短い設定から始め、作業上必要な場合にだけ、レイテンシーとメモリーの追加負荷を考慮してコンテキストを伸ばしてください。
品質と「速度」機能は別々に確認します
量子化の配布元は有用な品質比較を公表していますが、これはStrataを使ったエンドツーエンドのベンチマークではありません。たとえばLiveCodeBench v6のスコアはBF16が87.43、Q2_0が81.14です。これは自分に関心のあるタスクで試す理由にはなりますが、低ビット出力をすべて使えないと断定したり、各派生版が同等だと結論づけたりする根拠ではありません。公表された量子化評価
Experimental Speed Projectionには特に注意が必要です。プロジェクトによると、これはモデルの挙動を変える任意の制御ベクトル機能であり、見えない単なる算術最適化ではありません。基準構成ではオフにし、比較で使う場合は明記してください。内容が変わったために回答が速くなることと、同等の処理を速く実行することは、同じ測定ではありません。実験的機能の詳細
自分で評価するときは、リポジトリのコミット、エンジンのバージョン、量子化とファインチューン、GPUとVRAM、CPU、RAM速度、SSD、ドライバー、コンテキスト設定、機能の有効・無効を記録してください。キャッシュなしのプロンプトを少なくとも3件、キャッシュを使う追質問を3件実行し、最良の結果だけを選ばず、中央値と範囲を報告します。プロンプトと出力のトークン数に加え、最初のトークンまでの時間、デコード速度、合計所要時間も記録してください。
速度を確認するときは、タスクに応じた正確さの検証も組み合わせます。コード生成の回答ならコンパイルと関連テストを行い、文書に関する回答なら原文と照合し、多言語出力なら指定言語と用語を確認します。成功した実行だけでなく、失敗、タイムアウト、メモリー不足も記録してください。
ローカル実行で制御性は高まりますが、セキュリティ上のリスクがなくなるわけではありません
既定のループバックアドレスを維持してください。ローカルモデルサーバーをLANやインターネットに公開すると、脅威モデルが変わります。また、互換APIが自動的に認証付きサービスになるわけでもありません。Strataのセキュリティポリシーはローカルへのバインドとセキュリティの適用範囲を説明していますが、独立した外部セキュリティ監査を受けたとは主張していません。Strataセキュリティポリシー
ローカル生成によってホスト型推論プロバイダーへの依存を減らせることはありますが、プライバシーはワークフロー全体に左右されます。チャットログ、クライアントアプリ、ウェブ検索、外部ツール、バックアップによって、データがモデルプロセスの外へ送信または保存される可能性があります。エージェントに機密文書を渡す前に、そうした経路を確認してください。「ローカルで動く」は有用なアーキテクチャ上の事実ですが、プライバシー全体の認証ではありません。
ライセンスも同様に複数の層に分かれています。Strataのコードライセンスが、モデルのqwen-community-1.0ライセンス条件に置き換わるわけではありません。量子化済みの重みでも、元モデルに付随する義務はなくなりません。オープンなリポジトリなら制限なく使えると考えず、再配布や商用導入の前に該当するライセンスを読んでください。Qwenモデルライセンス
個人用AIコンピューターのあり方が変わる可能性があります
最も重要な示唆は、クラウド推論が時代遅れになったということではありません。デスクトップには、同時配信数、初回トークンまでのレイテンシー、電力消費、保守、モデル品質の限界があります。実行環境の制御より可用性や大量リクエストが重要な場合、ホスト型システムが優れた選択肢であり続けます。
Strataが示唆しているのは、コンシューマー向け推論の制約はGPU容量だけでなく、オーケストレーションにも同じくらい左右される可能性があるということです。CPU、RAM、疎なストレージアクセスをよりうまく活用すれば、単純にすべてをGPU上で処理する前提なら候補から外してしまうモデル群を利用できるかもしれません。システムメモリー帯域は、後回しにする仕様ではなく、AIコンピューターの要件の一部になります。
これはアーキテクチャと公表結果からの推論であり、将来のどのモデルにも当てはまる保証ではありません。ランタイムが活用できる疎な構成、キャッシュ可能な部品、検索主体の部品をモデルが備えていることが前提です。アクセスパターンの異なる密なモデルが、パラメーター数が似ているというだけで同じ利点を得るわけではありません。
個人の研究者や開発者にとって、現実的な次の一歩は範囲を絞った試験です。リビジョンを固定し、短いコンテキスト、対応済みマシン、代表的な少数のタスクを使い、品質とレイテンシーを正直に記録します。重要な節目だからこそ、説明もその範囲にとどめるべきです。非常に大きなモデルが慎重な配置と検証によって、デスクトップで現実的な処理対象になりました。ハードウェアの制約が消えたわけではありません。
セットアップの判断を調査メモと一緒に残しましょう
ローカルAIの構成を比較する際は、出典リンク、ハードウェアの詳細、観察結果、未解決の疑問をまとめておきましょう。Telli.shは、Strataとの組み込み連携をうたうことなく、そうしたメモや要約を整理するのに役立ちます。Telli.shアカウントを作成