[ローカルAIフィールドノート 01] Strataの次の試練:大型モデルを自分のPCで役立てる
Strataの0.2ベータはデスクトップアプリになりました。公開された一般向けハードウェアの3事例から、できること、メモリの負担、ローカルAIの次の課題を考えます。
最も興味深いローカルAIのデモは、来週も使い続けられるものです。ゲーミングPCで大型モデルが気の利いた回答を出すのは一つの節目です。同じ会話を明日また開き、モデルファイルを見つけ、安全にプロジェクトを編集させられるようになって、ようやく便利な道具の始まりになります。
Strataは2026年10月19日の0.2.0-betaで、その二つ目の段階へ踏み出しました。デスクトップアプリ、Terminalインターフェース、個別にパッケージ化されたエンジンが登場したのです。10月23日には0.2.3が公開されました。ダウンロードを選ぶ際にはベータの正確な名前が重要です。これは0.2のリリース系列であり、将来の2.0が発表されたわけではありません。ベータリリース、10月23日のリリース
ローカルAIフィールドノートの第1回では、すでに持っているコンピューターで、この変化が何をもたらすのかを考えます。新しいインターフェースを公開されたハードウェアの3事例と結び付け、モデルの選択肢と異なるアーキテクチャを区別し、ローカル推論を日常的に頼れるサービスに変える可能性のある進展を見ていきます。
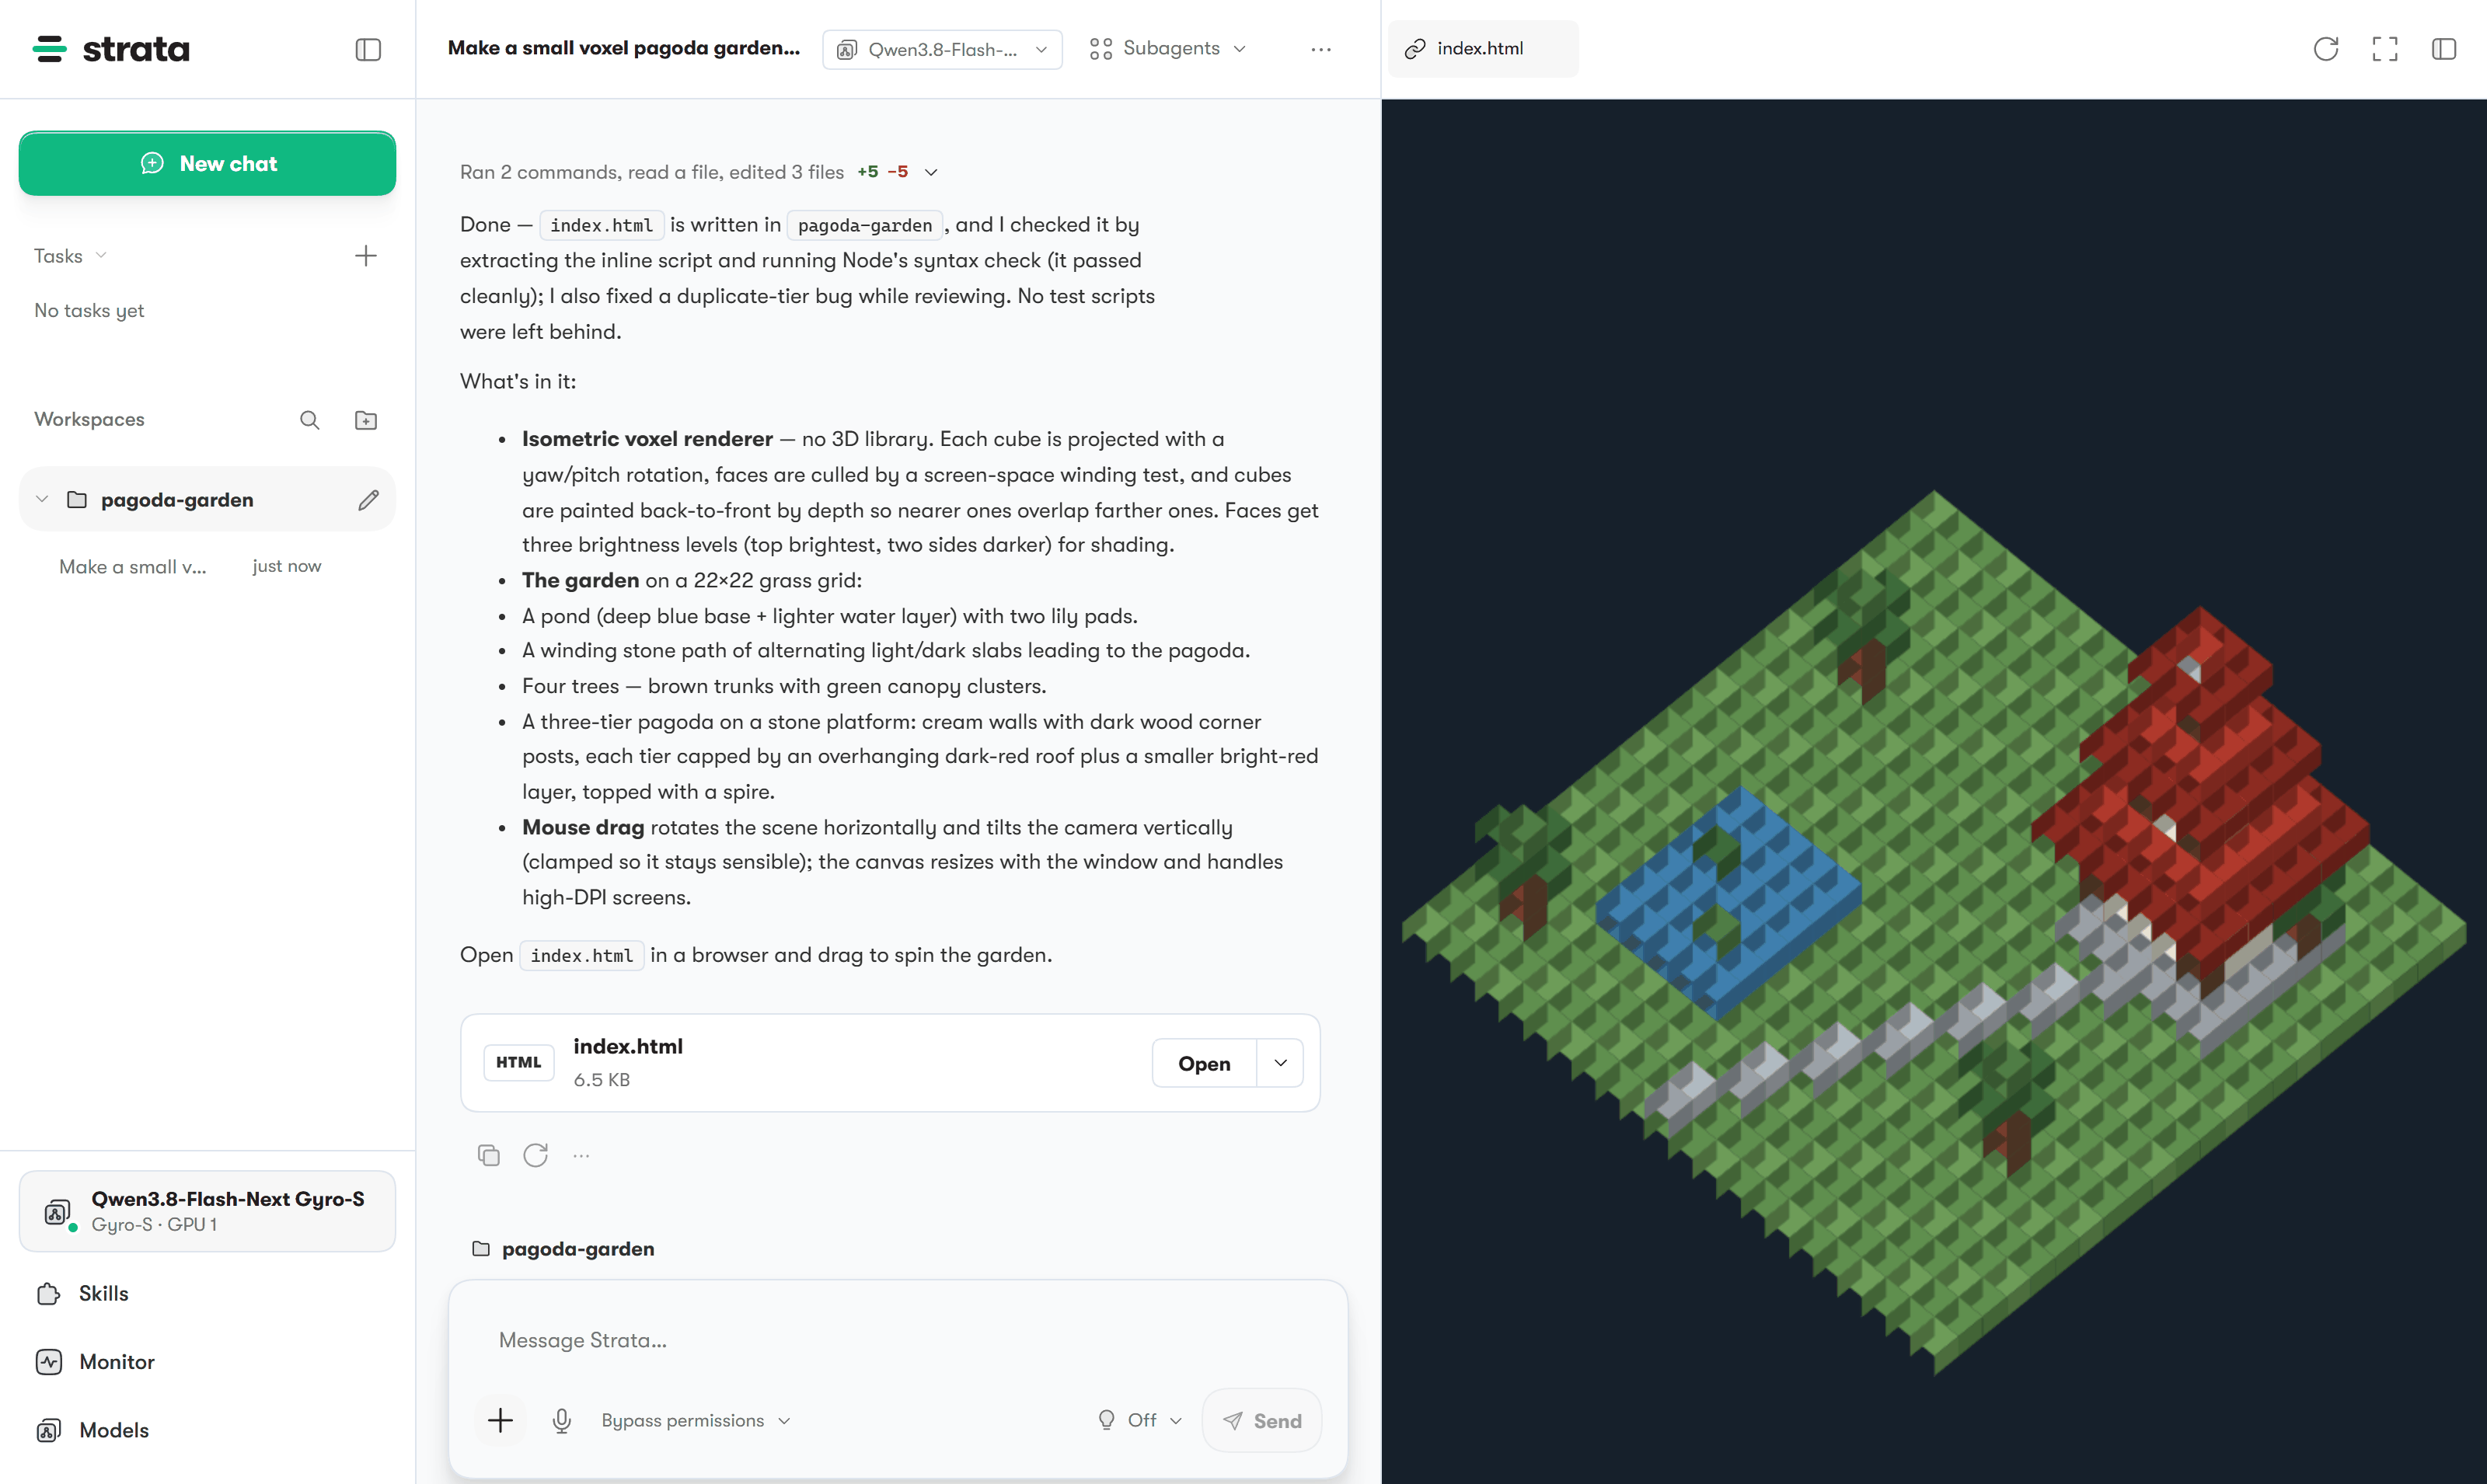
0.2.3リポジトリにあるStrata公式スクリーンショット。コーディングの会話とHTMLプレビューを示しています。本記事で実施したテストではなく、インターフェースを紹介する画像です。© 2026 Niko1221 and the Strata contributors; 出典、MIT license。

ベータはエンジンを繰り返し使える道具にした
デスクトップアプリは、モデル選択、ストレージ管理、チャット、ハードウェア監視、コーディング用ワークスペースをまとめています。権限モードのManualは変更前に確認を求め、より許容範囲の広いBypassはエージェントに大きな自由を与えます。Terminalには、案内に沿って進めるstrata launchの手順と、コーディングクライアントへの接続があります。両者は基盤となる同じエンジンを共有しています。0.2.0-betaの機能説明
開発者なら、分かりやすい利用例が考えられます。使い捨てのプロジェクトで小さなパーサーを依頼し、提案されたファイルを確認し、テストを実行してから、失敗する例を示して会話を続けます。大量の文書を扱う人なら、渡した文章の一節について範囲を絞って質問し、その回答を裏付ける正確な引用を求めるのが同様の最初の仕事です。どちらも、モデルを自律的な従業員に変える必要はありません。
実用面での改善は継続性です。グラフィカルなモデル選択画面は、互換性のない設定で起動する可能性を下げます。ハードウェア監視は、別のアプリが性能を変える理由を理解する助けになります。保存したプリセットは、成功した実験を再現可能な作業に変えます。これらの機能がモデルの推論能力を高めるわけではありません。その能力を利用できる状態から、責任を持って活用するまでの手間を減らします。
私たちの見方はこうです。ローカルAIの次の競争は、その距離を縮めることです。優れた体験では、よい設定を保ちやすく、失敗を理解しやすく、危険な操作を確認しやすくなります。
コンピューター全体のメモリ構成がモデルの一部になる
Strataの主な対象は、コアに1,250億のパラメーターを持つQwen3.8-Flash-Nextです。その実行方式では、共通の計算や頻繁に必要となるエキスパートにGPUメモリを使い、ほかのエキスパートにはシステムRAMとCPUでの実行を使い、n-gramの参照テーブルにはSSDアクセスを使います。大容量のグラフィックスカードは役立ちますが、マシンのRAMとストレージも推論経路の一部であり続けます。プロジェクト概要、実行設計
PCを、作業台がいくつもある工房だと考えてください。最も速い作業台の広さは限られているため、ランタイムはどの作業をそこに置き続けるか判断しなければなりません。その判断を改善すれば、既存のハードウェアをもっと役立てられます。ただし、すべての作業台を同じ速さにはできません。
三つの量を分けて見る必要があります。ダウンロードはストレージを占有します。読み込まれた重みとランタイムのバッファーはメモリを使います。コンテキストウィンドウは、会話が長くなるにつれて作業状態を増やします。そのため、ファイルサイズだけでは必要なVRAMも、最初の回答が出るまでの速さも分かりません。
プロジェクトの現在の導入目安は、RAMとVRAMの合計で少なくとも32 GB、通常の構成では約80 GBのディスク空き容量です。これは導入時の目安であり、あらゆるモデル、コンテキスト長、OSがその枠内に収まるという約束ではありません。標準的な16 GBのノートPCを、以下のデスクトップと同等だと考えるべきではありません。ハードウェア要件
モデル名が増えても、アーキテクチャが増えたとは限らない
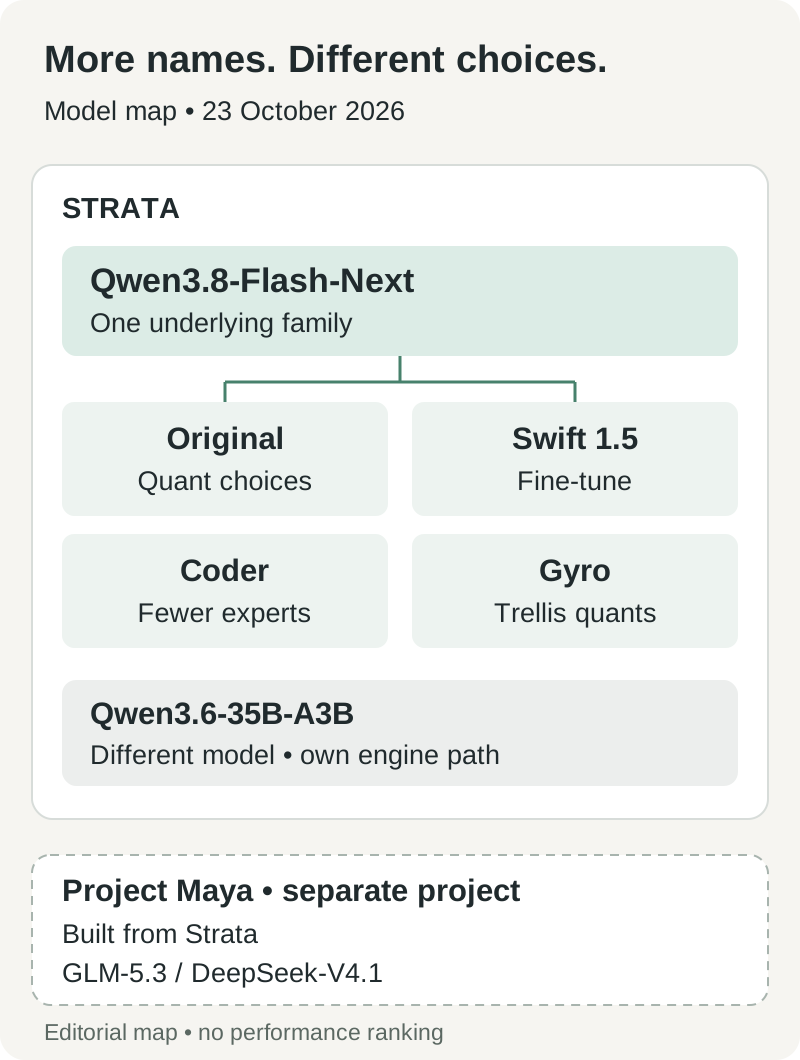
文書化されたモデルの関係を10月23日時点で確認し、独自に作成した編集図です。枝は系譜とランタイムの対応を示しており、品質が等しいことやファイルを交換して使えることを示すものではありません。
オリジナルのFlash-Next、Swift 1.5、Coder、Gyroは、同じ基盤モデル系列に対する異なる要求に応える選択肢です。Swiftはファインチューニングで振る舞いを変えます。Coderは、コーディング用途では有用性が低いと選別されたエキスパートを削除します。Gyroは重みの表現方法を変えます。これらを無関係な四つの基盤モデルと見なすと、実態以上に幅広いカタログに見えてしまいます。モデルガイド
この違いは重要です。Coderは各層の512エキスパートのうち256を残しており、プロジェクトは一般用途と英語以外の性能低下を警告しています。コーディング用デスクトップに収まるから選んだモデルを、そのまま多言語文書への質問の標準にすべきではありません。Swiftの短い推論は、ハードウェアが個々のトークンを速く生成しなくても、全体の所要時間を改善できます。バージョンごとのトレードオフ
Gyro-Sのダウンロードは58.5 GBですが、文書に記載されたRAMとVRAM全体での重み用メモリ要件は27.6 GBです。n-gramテーブルはSSDに残ります。プロジェクトの評価では、より大きな低ビットの選択肢より品質が低いとされています。少ないメモリに収まることには代償があります。Gyroの文書
実際に別の第2モデルもあります。Qwen3.6-35B-A3Bは、全体350億、アクティブ30億パラメーターの混合エキスパートモデルで、別のエンジン経路で処理されます。文書にある選択肢には、対応するNVIDIAおよびAMD構成での画像と同時リクエストの処理が含まれますが、Macエンジンでは動作しません。最大のパラメーター数そのものが本当の要件ではない場合、この違いから評価する価値のある代替候補になります。Qwen3.6への対応
公開された3台のマシンは、異なる3種類の有用性を示す
以下の事例は、コミュニティの貢献者またはプロジェクト自身が公開したものです。特定の構成での測定であり、本記事のために実機テストした結果ではありません。目的は、異なるプロンプトを使った3台の順位付けではなく、どんな作業が見込め、何を負担するのかを示すことです。
| 公開事例 | モデルとコンテキストの条件 | 報告された結果 | 判断に役立つ点 |
|---|---|---|---|
| コミュニティ、10月9日:RTX 3060 12 GB、Core i7-12700、64 GB DDR4-3200、NVMe、Windows 11 | Strata 0.1.41;オリジナルQ2_0;131,072トークンのウィンドウ;キャッシュなしの新規プロンプト4,096トークン、出力256トークン;推論とビジョンを無効;3回実行 | 中央値は出力42.9トークン/秒、最初のトークンまで4.7秒、合計10.6秒 | 古い12 GBカードでも、十分なシステムRAMと組み合わせれば短い対話型の作業に使える |
| コミュニティ、10月9〜10日:RX 9060 XT 16 GB、Ryzen 7 9800X3D、64 GB DDR5-6000、Windows 11 | エンジン0.1.40.3;IQ2_XS;122,880トークンのウィンドウ;prefill 8,192;キャッシュなしの新規入力8,019トークン、低い推論設定;3回実行 | 中央値はプロンプト879.4トークン/秒、出力56.3トークン/秒、合計11.212秒 | 文書規模の入力では、プロンプト設定が高速なカードと同じくらい重要になり得る |
| プロジェクトによる測定、10月23日までに文書化:M4 Mac mini、32 GBユニファイドメモリ | Gyro-S;SSDからのエキスパートストリーミング;エキスパート領域11〜12 GB;ドラフト層なし;120トークンの物語;ウィンドウ全体の大きさは未記載 | 交互に実行した5組の中央値は出力9.14トークン/秒;別の4,065トークンのプロンプトは109トークン/秒で読み込み | 小型マシンでも大型モデルを動かせるが、待ち時間との引き換えになる |
出典:RTX 3060の報告、RX 9060 XTの報告、Macの測定。これらの報告は現在のアプリのリリース以前、または異なる条件のものです。
RTX 3060の事例が役立つのは、出力前の待ち時間を含んでいるためです。毎秒およそ43トークンを表示するインターフェースでも、質問を読んでいる間は止まることがあります。報告には熱による速度低下と、管理されていないバックグラウンド動作も記録されています。理想化されたGPU仕様ではなく、1台のマシンの現実的な範囲を示している点に価値があります。
Radeonユーザーには、速度測定の繰り返しを超えた具体的な作業の証拠があります。貢献者はコーディングクライアントを通じ、合成したTypeScriptの3タスクを各モデルで3回ずつ実行しました。IQ2_XSとIQ3_XXSは、どちらも計9回のタスク実行をすべて通過しました。IQ2構成はホストメモリの使用量が少なく、範囲を限定したこれらのタスクをより速く終えました。これはテスト可能なコーディング作業を試す根拠になりますが、未知のリポジトリで同じ品質を保証するものではありません。コーディング比較とテスト用素材
Macの事例が答えるのは別の問いです。比較的小さな32 GBシステムでも参加できるのでしょうか。公開されたストリーミング構成なら可能です。ただし、Mac文書の別の約30KトークンのIQ3_XXSプロンプトでは、最初の出力まで5.6分かかりました。待てるバッチ処理と、中断に敏感なアシスタントとでは、許容できる遅延が異なります。Macのストリーミング測定
読者が持ち帰るべき判断基準はそこです。短い質問で対話時の応答を知り、長い文書でプロンプトの負担を知り、検証できるタスクで回答の有用性を知ります。一つの数字で三つすべてを代用することはできません。
10月の修正は、セットアップ記録にバージョン番号が必要な理由を示す
10月23日のリリースは、WindowsのStrix HaloテストマシンでIQ3_Sを使った際に、回答速度が6〜19%向上したと報告しています。0.2.2と3組の比較実行で測定したものです。また、A750をテストカードとするIntel Arc Linux SYCLエンジンパッケージも提供します。DFlash2ドラフティングはTerminal専用で、明示的に有効化して使います。代替方式がすべての作業で勝っているわけではないため、Autoは引き続きMTPを選びます。0.2.3の測定と制限
こうした改善と並んで、通常のソフトウェア保守もあります。10月20日のv0.2.1.2タグは、Strix HaloのWindows起動問題に対応しました。ハードウェアガイドは以前の問題を説明しています。エキスパート領域の登録で利用可能なGPUメモリを使い切り、キャッシュ用のスロットが残らなかったのです。メモリの所有関係が修正されるまでは、対応チップとインストーラーだけでは十分ではありませんでした。v0.2.1.2、Strix Haloの起動に関する説明
現在も未解決の部分があります。10月23日に開かれたIssue #3810は、同梱されたビジョンのメタデータに関係するWindows CUDAセットアップのクラッシュを報告しています。本記事の調査締め切り時点では解決を待つユーザー報告であり、すべてのWindowsインストールが失敗する証拠ではありません。同じ経路に当てはまる場合は、モデルの再調整に何時間も費やす前に、そのIssueと後続のリリースノートを確認してください。Windowsセットアップの報告
アップグレードにも注意が必要です。0.2.3の説明では、0.2.0-betaから0.2.1.2までの利用者にTerminalインストーラーの再実行を案内しています。これらのバージョンはControlコンポーネントを自力で切り替えられないためです。インストーラーはモデルと設定を保持します。Macでは、必要な署名済み配布物が実際に公開されたか確認してください。同じリリースの既知の制限には、公開時点でMacビルドはまだ署名中だったとあります。アップグレード手順
一つの役立つ仕事と短いコンテキストから始める
価値があるか知るために、巨大なコンテキストのデモを再現する必要はありません。小さな作業を一巡させて成功すれば、失敗や修正も含む基準が得られます。さらにストレージを使ったり、エージェントに広い範囲の行動を任せたりする前に、その基準を作れます。
- ハードウェアに合う文書化された方法を選びます。 公式リリースページを開き、OSとGPUに合うパッケージを選びます。アプリとエンジンのバージョンは別々に記録します。アップグレードを評価する間は、すでに動作している環境を残してください。
- 空きメモリ、言語、作業に合わせてモデルを選びます。 最初の試行では負荷の高いアプリを閉じます。推奨サイズ、約8Kのコンテキスト、同時リクエスト1件から始めます。モデルファイルはローカルSSDに置きます。
- ガイド付きセットアップを使います。 デスクトップのモデル選択画面や
strata launchから、モデル、ストレージ、コンテキスト、画像、アクセスの設定を行えます。最初のコーディング練習では、ローカル専用アクセスとManual権限を維持します。Terminalガイド - 検証できることを尋ねます。 テスト付きの小さな関数、提供した文書についての三つの質問、既知のラベルを含むスクリーンショットを試します。プロンプトを保存し、実際の資料やテスト出力と回答を照らし合わせます。
- 待ち時間全体を測ります。 起動、最初の出力までの時間、作業全体の時間、メモリ使用量のピーク、正確さを記録します。その後、キャッシュを使える追加質問と、新しいプロンプトで1回ずつ繰り返します。比較中はドラフティングと推論の設定を変えません。
- 一つずつ変数を変えて複雑にします。 作業で必要な場合だけコンテキストを増やします。画像、別のモデル、コーディングクライアント接続は個別に評価してください。そうすれば、悪化した場合に具体的な原因を絞れます。
共有できる性能報告のために、Strataはstrata bench runを提供しています。標準化されたプロトコルは10月23日時点でパイロット検証待ちの草案であり、モデル読み込みと時間測定対象の推論を明確に分けています。重要な習慣は今でも役立ちます。結果にハードウェア、量子化、実際に適用された設定、タスクの成否を添えることです。ベンチマークプロトコル
推論をローカルに保っても、境界での判断は残る
Strataのプライバシー文書には、利用状況のテレメトリーはなく、ダウンロード済みモデルをオフラインで実行できるとあります。ウェブ検索、開いたページ、リモートモデルサービス、トンネル、設定したツールは、利用時に外部接続を作ります。モデルとの会話を非公開にするには、周囲の作業の流れも非公開にする必要があります。ネットワークとダウンロードの動作
文書とコーディングの例では、特に重要です。ファイルを読み、コマンドを実行できるアシスタントは、テキスト生成を超える能力を持ちます。機密資料を渡す前に、作業フォルダー、提案されたコマンドの正確な内容、外部ツールの接続先を確認してください。誤った編集を復元できるよう、原本とバージョン履歴を残します。
既定の推論リスナーは127.0.0.1を使います。ネットワークリスナーを開くと、アクセスできる相手が変わります。StrataはAPIキーと別の共有リスナーについて文書化していますが、アクセスを有効にする人がその判断を担います。互換APIはクライアント接続を便利にしますが、可能なすべてのクライアント構成を非公開にするものではありません。セキュリティポリシー
Project Mayaは、この発想がどこまで広がり、何を要するかを示す
より大きな動きは、このランタイム戦略が別のモデル系列に応用されていることです。Project Mayaは、独自モデル向けに大幅な作業を加えたうえで、エンジン、サーバー、ダッシュボードの出発点としてStrataを明記しています。文書に記載された対象には、GLM-5.3-Flash、321BとDeepSeek-V4.1-Flash-1017、748Bがあります。Strataのモデルメニューの選択肢ではなく、別のプロジェクトです。Mayaのモデルとクレジット
GLM Maya-Sのダウンロードは96.5 GB、DeepSeek Maya-Sの選択肢はEngramテーブル込みで340 GBを占有します。コミュニティの一例では、RTX 5090を1枚、Ryzen 9 7950X、96 GBのRAMと組み合わせ、GLM Maya-Mで毎秒30トークン超を報告しています。この条件から、一般向けの構成を「GPU1枚」とだけ説明しても不十分な理由が分かります。Mayaのファイルとハードウェア報告
可能性は確かにあります。マシンは複数階層のストレージと計算資源を組み合わせ、全体の重みがアクセラレーターのメモリを超えるモデルを提供できます。一方で負担も増えます。数百GBのダウンロード、モデル固有のカーネル、余分なシステムメモリ、実験段階のプラットフォーム対応には、相応の投資が必要です。大型モデルの移植成功が、あらゆるアーキテクチャに対応する汎用ローダーの成立を意味するわけではありません。
多くの読者にとって、Mayaは乗り換えを勧めるものになる前に、動向を追う対象です。役立つ問いは、別のモデルが現在のモデルでは失敗する仕事を解決し、追加のハードウェアと保守を正当化するほどの利点を生むかどうかです。パラメーター数だけでは答えられません。
次の節目は信頼できる仕事であり、公開提案もそこを目指す
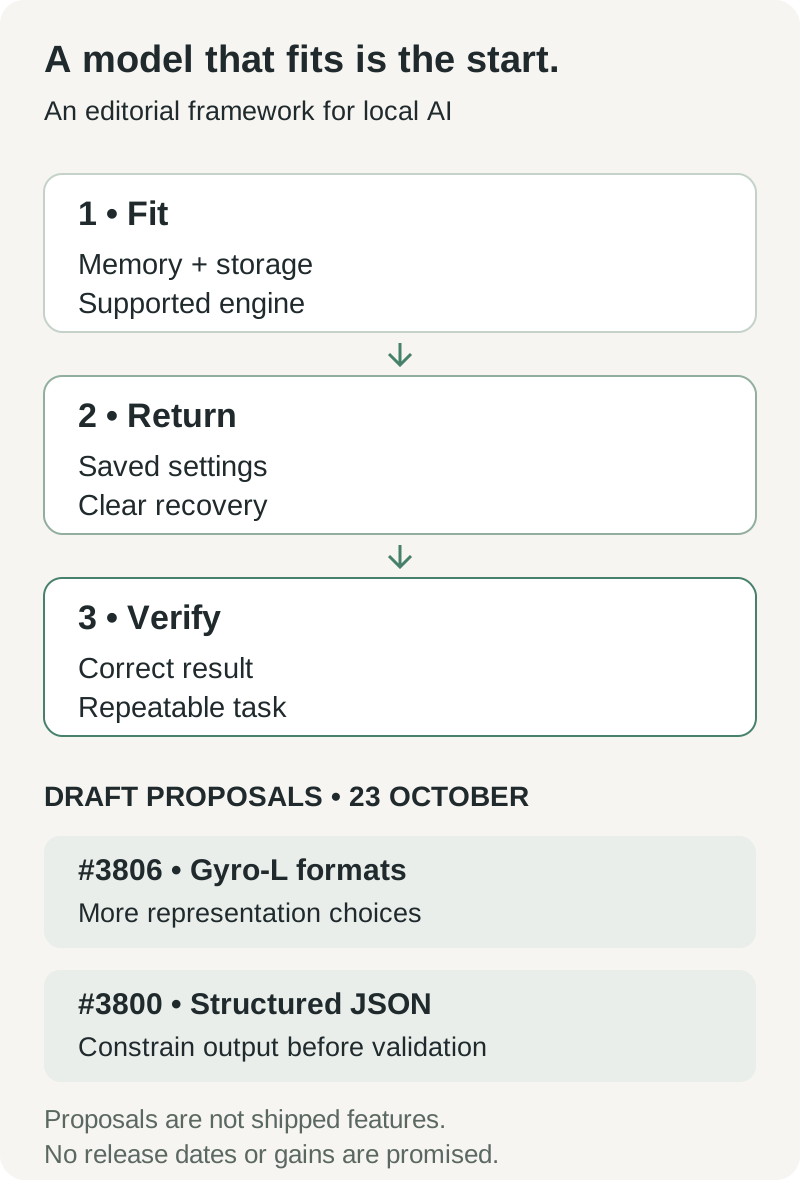
独自の編集上の枠組みです。上の流れは導入の判断基準を説明し、下の行は10月23日に確認した公開提案を示しています。約束されたリリース日程でも、性能予測でもありません。
公開中の二つのドラフトプルリクエストは、想像上の2.0ロードマップより具体的な手掛かりになります。#3806は、現在未対応のGyro-Lのtrellis形式への対応を提案しています。#3800は、構造化JSON出力にトークンマスキングを使い、不正な生成によるリクエスト全体のやり直しを減らす提案です。両方とも10月23日時点ではドラフトであり、出荷済み機能の一覧には入りません。Gyro-Lの提案、構造化出力の提案
こうした作業が信頼できるリリースに届けば、二種類のローカル作業が恩恵を受けます。形式への対応が進めば、メモリと品質の折り合いをつける選択肢が増えます。構造化出力の信頼性が上がれば、文書からの抽出、ラベル付け、ツール呼び出しで、別のプログラムが安全に検証できるデータを生成しやすくなります。後者は動画では地味でも、繰り返す作業では価値が高い可能性があります。
私たちの期待には条件があります。ランタイムが動作する設定を保持し、メモリ使用量を制限し、失敗から回復するほど、個人のための推論は便利になります。バックエンドの移植が増え、ドラフティングが巧みになっても、読者が実際の仕事に結び付けられて初めて役立ちます。デスクトップのモデルは、確認して繰り返せる仕事を生み出すことで、自分の居場所を得るのです。
したがって、次のローカルAIコンピューターへの問いは単純です。明日も同じ役立つ仕事を渡し、使い続けられるほどその過程を信頼できるでしょうか。
出典と閲読上の注記
調査締め切り:2026年10月23日。リリース状況、Issueの状況、入手可能な配布物は、その後変わる場合があります。上記の測定には元の公開日と構成を残しています。本記事のために新たな推論ベンチマークは実施していません。
- Strata 0.2.0-beta、v0.2.1.2、0.2.3リリースノート。
- Strataモデルガイド、Qwen3.6への対応、Gyroの文書。
- コミュニティベンチマーク集、Mac文書、ベンチマークプロトコル草案。
- Project Maya、Strata公式スクリーンショット、リポジトリのライセンス。
ローカルAIの判断を、その根拠と一緒に残す
構成を比較するときは、出典リンク、ハードウェア設定、タスクの結果、修正内容をまとめて残してください。Telli.shは、セットアップの進化に合わせて、そうした調査ノートや要約を整理するお手伝いができます。Telli.shアカウントを作成する