RAMをもっと使うStrata 0.2.17。仕事用PCでも許可すべきか?
Strataの新しいメモリ配分はSSDの読み出しを減らし、別の既定値変更は出力の忠実性を守ります。仕事にも使うPCに適した設定と比較方法を考えます。
ローカルモデルの回答が速くなっても、そのコンピューター自体は使いにくくなることがあります。ブラウザー、エディター、ビデオ通話も動かすマシンなら、この二つの結果を同じベンチマークで評価する必要があります。
2026年11月20日公開のStrata 0.2.17は、そのトレードオフを特にはっきり示す更新です。エキスパートの重みをすべてRAMに保持できない特定のモデルファイルについて、性能重視の構成で常駐割り当てを増やします。一方、回答の品質が落ちたという利用者の報告を受けて、別の最適化は既定で無効になりました。
考えるべきなのは、そのPCが推論専用機なのか、それとも日々の仕事にも使うコンピューターなのかという点です。今回の更新は、毎秒のトークン数が増えたことだけで結論を出さず、その違いを試す理由を与えてくれます。
知っておきたい三つの点: 64 GiBの例は、対応するUnslothファイルと明記されたハードウェア構成に限られます。アプリでは従来の仕事向けメモリ配分を維持できます。また、メモリへの常駐とモデル内の経路の省略は、異なる制御です。
7 GiBの追加でSSD読み出しを大きく減らせる場合がある
Strataは、マシンのリソースを調整して対応モデルを実行するローカルモデル用ランタイムです。0.2.16で説明されたエンジン移行を経て、新しいアプリとTerminalのバージョンは0.2.17になりました。エンジンとControlアップデーターは0.1.63です。Windows、Linux、Mac、DGX Spark向けのダウンロードを提供していますが、あるOS向けの配布物があることは、すべてのモデルと実行経路がすべてのマシンで動くことを意味しません。
メモリの変更は、エキスパートをすべてRAMに常駐させられない場合のUnsloth UD-Q4_K_XLとUD-IQ4_XSファイルに関係します。新しい設定規則は、保持するエキスパートの重みの量を決める際、総RAMから17 GiBとストリーミングされるKVキャッシュを差し引きます。以前の規則では24 GiBを差し引いていました。これは特定の実行経路に対する常駐予算であり、モデル全体、キャッシュ、OSがその数値内に収まるという約束ではありません。
数GiBの追加がなぜ重要なのでしょうか。必要な重みがすでにメモリにあれば、ランタイムはストレージから取り直さずに済みます。負荷の高いプロンプトでは、多数のアクセスにわたりこの利点を繰り返し利用できます。その関係は、7 GiBと入力ファイル一つのサイズを比べるより複雑です。ワークロードがどのエキスパートを使うか、ランタイムがすでに何をキャッシュしているかにも左右されます。
メンテナーの例は、実際のメモリ上限64 GiB、UD-Q4_K_XL、RTX PRO 4500 Blackwellカード、約65Kトークンのプロンプトを使用しています。リリースの表には次の結果が示されています。この構成についてプロジェクトが測定した値であり、すべての64GBコンピューターの予測値ではありません。
| エキスパート重みの常駐予算 | 対象プロンプトでのSSD読み出し | デコード速度 | 報告された空きRAM | 後から起動した8 GiBのプログラム |
|---|---|---|---|---|
| 40 GiB、従来の例 | 97.7 GB | 57.7トークン/秒 | 16.6 GiB | 動作を継続 |
| 47 GiB、新しい例 | 37.0 GB | 84.2トークン/秒 | 9.3 GiB | 動作を継続 |
| 52 GiB、追加テスト | 0.9 GB | 83.4–88.6トークン/秒 | 6.6 GiB | 強制終了 |
注目すべきなのは最後の行です。ストレージアクセスをほぼゼロまで減らしても、デコード速度はそれに見合うほど劇的には増えず、別のプログラムは動作を維持できませんでした。推論に割り当てるメモリを最大化するより、測定して適切な予算を決めるべきだと、この表は示しています。
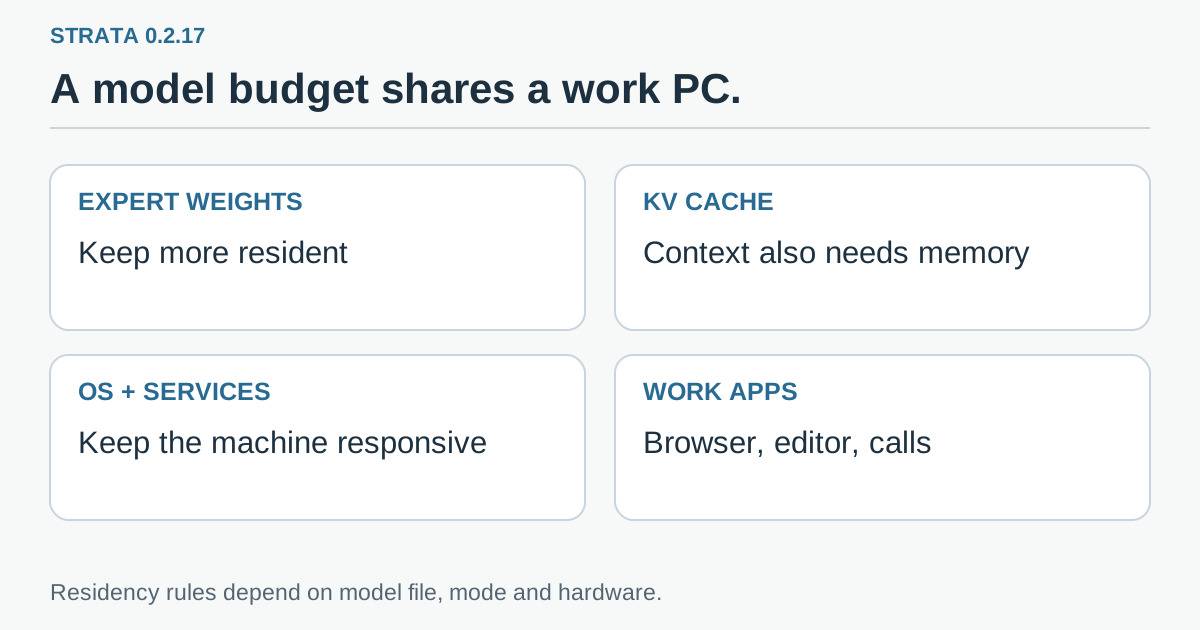 独自制作の解説図:エキスパートの重み、変化するランタイムキャッシュ、日常のアプリがマシンのメモリを共有します。リリースの常駐規則が適用されるのは、明記されたモデル経路だけです。
アプリの仕事用予約領域は出発点として有用
開発者のワークステーションを例に考えてみます。ブラウザーを長時間開き、IDEはリポジトリの索引を作り、ローカルアシスタントは大きな文書から回答を準備しています。IDEがスワップを始めたりビデオ会議が不安定になったりすれば、アシスタント単独で最速の構成も有用性が下がります。基準にすべきなのは仕事のセッション全体です。
Strataのアプリには「Leave 20% for my work」という選択肢があります。リリースによると、これは従来の予算を維持し、64 GiBの例では40 GiBになります。Terminal、strata serve、Docker、アプリの最大性能モードは新しい割り当てを使用します。利用者が指定した予算や明示的な予約設定が優先します。既存の0.2.16環境では、利用者が割り当てを明示していなければ、更新後の最初のStrataコマンドで一度限りの予算移行が行われる場合があり、別途セットアップを実行する必要はありません。
二人が「既定設定で試した」と言うとき、この違いは重要です。一人はデスクトップの仕事用予約モードを使い、もう一人はTerminalからサーバーを起動しているかもしれません。アプリのバージョンが同じでも、常駐の判断は異なり得ます。結果を比べる前に、バージョンとともに起動モードも記録しましょう。
リリースには例外も記載されています。Strix HaloのようにCPUとGPUがメモリを共有するマシンと、2枚のカードにレイヤーを分割する経路は、従来の予約量を維持します。ほかに挙げられたモデルファイル、IQ2_XS、IQ3_XXS、IQ3_S、Q2_0には、どちらのバージョンでもこの常駐予算は適用されません。一つの例から写したメモリ規則で、正確なモデル構成の確認を代用するのは適切ではありません。
Windowsでは、新しいエンジンはさらに初期確保量を「利用可能な空きメモリから4.25 GiBを引いた量」に制限します。稼働中のアプリが多いマシンでは、代表例の47 GiBを下回る量で開始することがあります。リリースは、このWindowsの動作を例の測定に含めていないと明記しています。また、システムが約63.1 GiBを報告する際、名目上64GBのWindowsマシンを分類する方法も調整しています。これらは実際の割り当てが異なる理由を理解する助けになりますが、公開テストがWindowsのベンチマークになるわけではありません。
人が操作しながら使うコンピューターでは、予約オプションから始めることを勧めます。テストのためたまたま閉じたアプリのメモリを借りるのではなく、想定する仕事を実行している状態で、より大きな割り当てを意識的に比較しましょう。
速い回答と忠実な回答には別々のスイッチが必要
二つ目の大きな変更は、Expert設定の「Skip rarely used parts of the model」で、STRATA_ROUTE_TAIL_SKIPとして表されます。これはRAM予算ではありません。
リリースによると、該当するルーティング条件下では、本来コピーして計算するエキスパートの処理をこの最適化で省略できます。以前はNVIDIAとRadeon RX 9000の経路で既定で動作していました。品質低下の報告を受け、メンテナーは自動動作を変更しました。0.2.17では、利用者が明示的に有効にしない限り無効です。
必要な重みをプロセッサーの近くに保持することと、モデルの処理の一部を実行しないことには重要な違いがあります。前者はデータを取得する場所を変えます。後者は計算そのものを変えます。両方がスループットを改善するとしても、出力上のリスクを同じ手法として評価すべきではありません。
メンテナーのRTX 5090の例では、UD-Q4_K_XLとDFlash2を使い、5種類のリクエストを2ラウンド実行しました。平均デコード速度は、経路省略が無効の場合73.4トークン/秒、有効の場合94.5トークン/秒でした。同じ記録には強制トークンの乖離測定も含まれています。これはプロジェクトが公開した構成比較であり、得られた回答が利用者のアプリで役立ち、安全で、正しいかどうかを示す点数ではありません。
日常で起こり得るのは、更新によって特定経路のスループットが落ちる一方、より完全なルーティング動作が戻ることです。それが意図した結果の場合もあります。正確な数値の確認、構造化出力の生成、難しい指示の実行が目的なら、文字が速く流れることより、望む動作を守ることのほうが重要かもしれません。
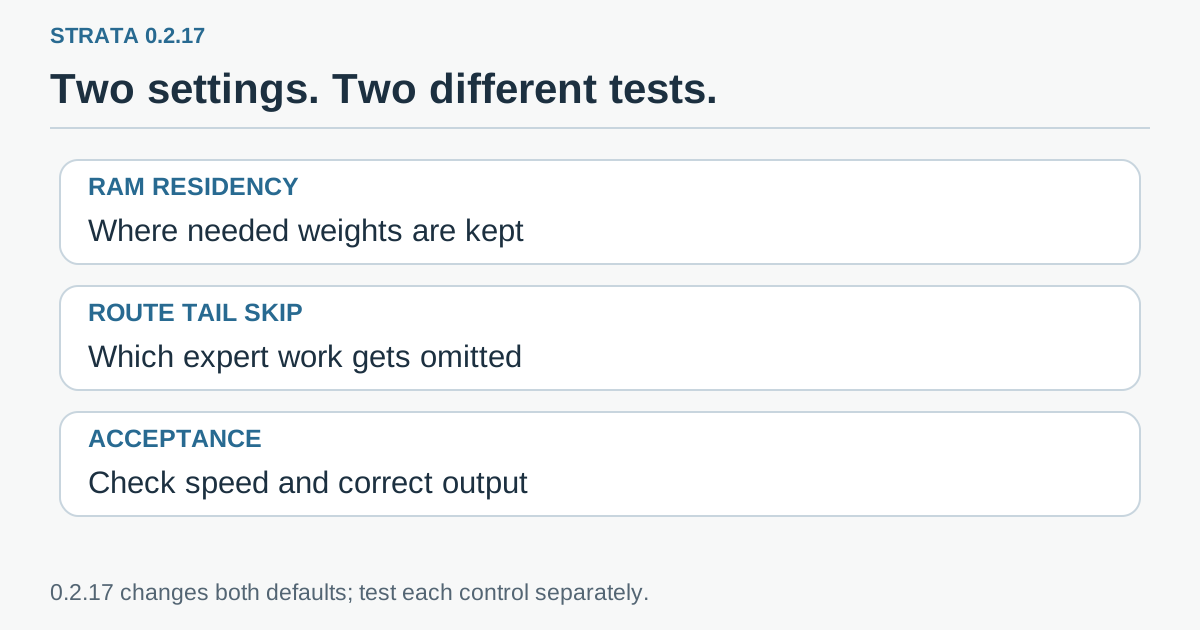 独自制作の評価チェックリスト:リソースへの圧迫と回答品質を別々に測ります。メモリ常駐量の変更と経路省略の変更は、異なる実験です。
既存のカスタム設定も更新履歴の一部
自動の既定値と明示的な選択は、同じようには移行されません。経路設定を変更したことがない場合や自動値を使っていた場合、新しい自動動作は無効になります。rank 7や別のrankを明示的に選んでいた場合、その選択は維持されるとリリースは説明しています。明示的なゼロも無効のままです。
これは意図した構成を保護しますが、2台のマシンを更新しても、必ず同じ動作にそろうとは限りません。片方には、数か月前に誰かが有効にした実験設定が残っているかもしれません。回帰を診断する前に、引き継がれた設定を確認しましょう。
リリースはrank-7の動作を有効にする方法として、strata launch --set STRATA_ROUTE_TAIL_SKIP=7を示しています。これは全員が実行すべき更新手順ではなく、希望する利用者の実験と考えてください。解決したい問題が出力の不一致なら、以前のスループットを取り戻すために有効化するより先に、経路最適化が無効か確認しましょう。
0.2.17には、ハードウェア別のプロンプト読み取りやデコード変更など、ほかの既定値もあります。生成テキストが変わるものもあります。複数の設定を一度に変え、差をすべてRAMによるものと決めつけないための、もう一つの理由です。実際にテストした構成は、バージョン、モデルファイル、ハードウェア経路、明示的な上書き設定で決まります。
開いたままにしたいアプリと一緒に比較する
役立つテストに研究室は要りませんが、繰り返せる問いは必要です。仕事用PCなら、マシン全体が使いやすい状態を保ちながら、アシスタントが代表的なタスクを完了できるかを問います。専用サーバーなら、選んだ予算が、予定する同時稼働サービスをメモリ障害なしに支えられるかを確認します。
- 最初の構成を書き留めます。 アプリとエンジンのバージョン、OS、RAM、GPU、正確なモデルファイル、起動モード、コンテキストサイズ、明示的なメモリ設定と経路設定を記録します。比較中はモデルと量子化を変えません。
- 代表的な仕事を三つ選びます。 たとえば短い質問、長い文書へのリクエスト、必須フィールドが既知の構造化抽出です。これらは推奨するテスト例であり、この記事のために実行した作業ではありません。
- 仕事用予約設定で基準を作ります。 ブラウザー、エディター、普段使うアプリを開いたままにします。空きメモリ、ストレージ活動、最初の応答までの時間、生成速度、それらのアプリの応答性を観察します。
- 常駐量だけを変えます。 同じ経路設定のまま、性能重視の割り当てと比べます。タスク実行中と、その後に通常の別アプリを起動したときのメモリ圧迫を見ます。
- 出力を評価します。 必須の事実、書式、指示への準拠、繰り返し時の一貫性を確認します。構文が正しくても、必要な項目を落とした抽出は失敗とします。
- 必要なら経路省略を別に試します。 選んだ常駐予算を固定します。受け入れ基準の例と結果を比べてから、スループット向上が、観察された変化に見合うかを判断します。
長い文書では、コールドスタートと繰り返しリクエストの両方を記録しましょう。キャッシュによって2回目は1回目と大きく違って見えます。一つの構成のウォーム状態での結果を、別の構成が文書に初めて触れた結果と混ぜないでください。
失敗も平均に埋もれさせず記録します。速い回答の直後にメモリ不足が起こるなら、バックグラウンドサービスにとって良い結果とはいえません。仕事用ノートPCでは、別の設定がデコード速度で勝っていても、エディターを中断せず使えることが決め手になる場合があります。
良い設定は本来の仕事のために余地を残す
Strata 0.2.17のローカル推論は、単一アクセラレーターのベンチマークより、小さな共有コンピューターの管理に近く感じられます。メモリは共同の机です。モデルの資料を多く置けばストレージへの往復は減りますが、仕事そのものを広げる場所も必要です。
専用機では、新しい割り当てをきっかけに、読み出しの減少が提供するワークロードを改善するか測れます。普段使いのワークステーションでは、予約オプションが妥当な出発点です。どちらでも出力の忠実性を独立した受け入れ基準にしましょう。トークン数の表示だけでなく、タスク全体が改善したとき、速い設定を採用する価値が生まれます。
出典と公式メディア
- Strata 0.2.17リリース、2026年11月20日:設定、条件付き測定値、更新時の動作.
- Strata 0.2.16のエンジン移行ノート.
- Strataの公式インターフェース画像。実際の対象を示すリンクです。記事に含めた図は独自制作の解説図です。
上の測定値はプロジェクトに帰属し、そのハードウェアとモデルの条件を保って紹介しています。評価手順は読者に提案するワークフローです。
Telli.shからの提案: 構成、代表的なプロンプト、比較メモをまとめて残しておけば、次の更新も役立つ基準から始められます。Telli.shで最初のノートを作成する。