Macのオフライン音声AIは、話し終わるまで待てる?
Sophon-RealtimeのApple Silicon版は音声のやり取りを端末内で処理します。模擬面接でメモリ、応答の遅延、エコー、割り込みを分けて確かめます。
自宅のテーブルで就職面接を練習しているとします。問題をどう解決したか説明し始め、言葉を探して少し間を空けると、面接官はもう終わったと思って話し始めます。後で面接官の発言を訂正しようとしても、こちらの声にかぶせて話し続けます。回答だけ後から再生すると自然に聞こえる音声アプリでも、どちらの問題も起こり得ます。
Adventists AIは2026年11月13日に、Sophon-RealtimeのMac向けローカル版を発表しました。Apple Silicon上で、Flash-4bitの音声モデルとAppleのMLXランタイムを組み合わせます。このビルドは発話の交代判断や応答中の割り込みに対応し、推奨ユニファイドメモリは36 GB以上です。Macへのセットアップでは約24 GBのモデルファイルを取得します。11月14日に別途発表されたホスト型APIでは、この音声処理がMacの中で実行されるわけではありません。
確かめたいのは、ネットワークがなくても一連のやり取りが会話として成立するかです。短い模擬面接で試せます。最初の音声が聞こえるまでの待ち時間と、話し始めるタイミングの判断を分け、モデルを動かした状態でほかの作業をする余裕も見ます。
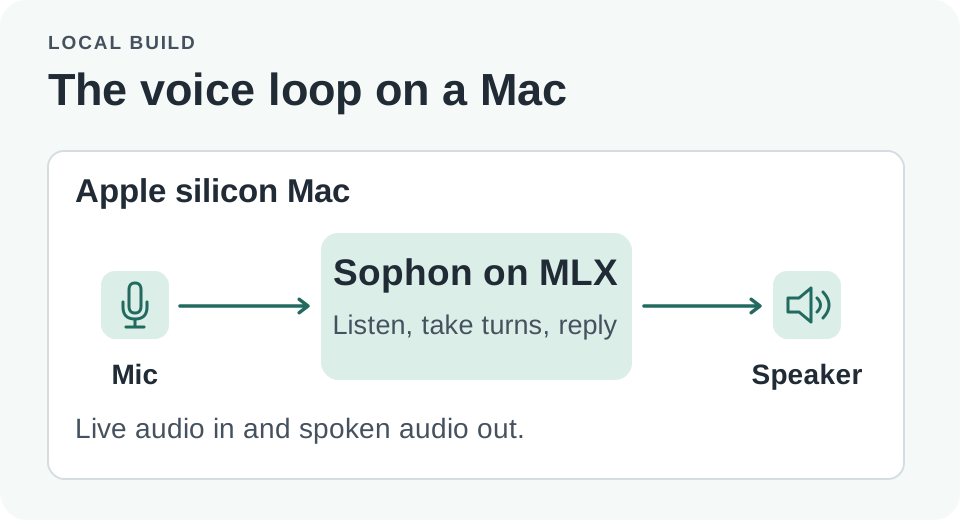
ローカル版はセットアップ後、端末内で音声を処理します。ホスト型APIは別の経路を使います。
約1秒は、どこを起点に測る?
プロジェクトのMac用モデルカードによると、メモリ36 GBのM4 Maxでは、モデルが発話終了を確信できる場合、利用者が話すのをやめてから最初の音声まで0.9〜1.1秒です。判断に時間が必要な場合は、最長で約2.5秒と報告しています。この構成でプロジェクトが得た結果です。再現する前に、何を発話終了とするか決めます。録音では最後に聞こえた音節が基準になります。システムは入力ターンの終わりを独自に判断します。人にとっては自然な間が、二つの時点を隔てることがあります。
最初の音声までの遅延には、発話を終えてからモデルの声が聞こえ始めるまでに起きることがすべて含まれます。モデルの処理に時間を使う場合もあれば、相手が話し終えたか判断するために待つ場合もあります。応答が速くても、沈黙を早く区切りと捉えすぎると、話の途中で何度も割り込むことになります。反対に、迷った場面で少し待つ方が自然な場合があります。秒数だけでは、どちらが使いやすいか分かりません。
「なぜキャッシュを選んだのですか」と聞かれたとします。一回目は簡潔に答え、明確に話し終えてからアプリの応答を待ちます。二回目は「キャッシュを選んだ理由は……」と答え、間を空けて続きを話します。三回目は近くで扇風機を回し、同じ内容を答えます。最初の条件で同じ応答時間でも、残り二つでは大きく崩れることがあります。応答の開始が適切だったことを確認してから、時間を比較します。
| 会話の出来事 | 記録すること | 確かめたい点 |
|---|---|---|
| 答えをはっきり終える | 最後の音節から応答の音声が聞こえるまで | 発話を終えた後の応答を遅く感じるか |
| 文の途中で間を空ける | アプリは待ったか、答え始めたか | 短い沈黙を、交代してよい合図として扱うか |
| 再生中に訂正する | 発話を止めるまでの時間と、訂正内容を理解したか | 利用者が発言権を取り戻せるか |
| マイクが再生音を拾う | アプリが自分の発話に反応したか、同じ内容を繰り返したか | 実際の部屋でエコーがどう影響するか |
自宅で自分の声を使って記録できる項目です。数字と一緒に試験条件を残します。スピーカーとヘッドホンでは、マイクに戻る音の経路が異なります。扇風機を使うのは実用的な負荷試験で、標準化された音声ベンチマークとは条件が違います。統制されていない室内試験からサーバー級の遅延を比較することはできません。
割り込みでは二つのことを確認する
Sophonによると、Mac版は全二重で、発話中の割り込みとエコーキャンセルに対応しています。対話アプリで割り込みを機能させるには、出力を止め、新しい情報をその後の応答へ反映する必要があります。「すみません、火曜日のことです」と言った直後に黙っても、その後も木曜日を前提に答えるなら、解決したのは半分です。
模擬面接では長めの追加質問を頼み、途中で「待ってください。話しているのはデータベースの移行です。顧客向けの公開ではありません」と訂正します。音声が止まったか、アプリが訂正を確認したか、次に実際に聞かれた質問へ訂正が反映されたかを記録します。意味のある訂正だけでなく、咳のような短い音でも試します。アプリが二つを同じ出来事として処理する必要はありません。最初の試験だけうまくいっても、実際の部屋でどの程度簡単に応答が止まるかは見えません。
エコーと割り込みは別に評価します。ヘッドホンと、無理なく聞ける音量のスピーカーでそれぞれ試します。アプリが自分の確認音声を拾い、それだけで録音を再開するなら、小さなモデルを選ぶよりマイクの位置やエコー処理を見直す方が重要かもしれません。ハードウェア、モデル、音声設定を一度に変えないようにします。次回の試験が良くなった、あるいは悪くなった理由を追えるようにするためです。
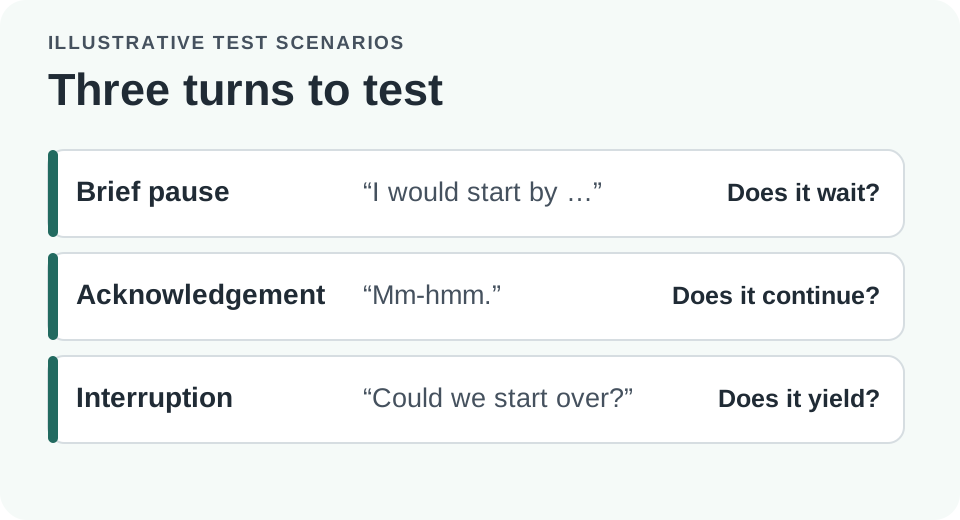
短い間と意図的な訂正は別々に試します。どちらにも沈黙が含まれますが、アプリに必要な反応は異なります。
Mac版の使い心地はメモリにも左右される
Macのセットアップ手順はMLXを使うApple Siliconでの方法を説明し、ユニファイドメモリ36 GB以上を推奨しています。約24 GBはダウンロードするファイルの容量で、実行時の使用メモリが正確に24 GBという意味ではありません。実際のセッションでは、モデル、キャッシュ、音声処理、ほかのアプリがリソースを共有します。
最初はメモリを多く使うアプリを閉じ、短い台本を使います。アクティビティモニタでメモリプレッシャーとスワップの増加を確認します。その後、実際にアシスタントと併用するツールを開いて試験を繰り返します。モデルが起動しても、メモリプレッシャーが高まり、再生が途切れるなら、日常利用には向きにくくなります。起動できる最小構成を推奨とみなすより、快適に使える条件を探します。
プロジェクトは11月16日、一般向けGPUで使う別の4B版を発表しました。リリースノートでは、GPU向けの実行と32B Flash-4bit MLXのMac版を区別しています。別のバックエンドで必要なVRAMが少なくても、Macの推奨値は変わりません。ホスト型API、サーバーGPU、ローカルMLXの数字も、モデルと負荷条件が異なります。リポジトリの数値を読む前に、実際に使う方式を決めます。
音声の検証では、公式の対応言語も重要です。リポジトリでは韓国語は対応予定とされています。多言語モデルなら各言語で音声、認識、発話の交代が同じように動くと想定せず、最初は英語など明記された対応言語で試します。韓国語での面接が必要なら、現行版は対話をどう評価するか学ぶのに役立ちますが、韓国語への対応を確認するには別の検証が必要です。
オフライン動作はダウンロードを終えてから試す
Mac版の手順にある依存ファイルとモデルの重みを取得するには、最初にネット接続が必要です。プロジェクトの手順に従い、インストール前にスクリプトを読み、ローカルファイルの保存先を確かめます。マイクの利用許可はモデルのインストールとは別です。自分で利用を管理できる音声から始め、本人の同意なしに他人の音声を録音しないようにします。
- Macの手順に従い、可能であればプロジェクトのリビジョンを固定します。必要なダウンロードを完了し、接続中に対応言語の短いやり取りを一度試します。
- セットアップを終えたらネット接続を切ります。新しいローカルセッションで、初めて話す問いに対し、保存済みの例ではなく新しい答えが返ることを確認します。
- マイクとスピーカーの設定を保ち、はっきり終える返答、文中の短い間、訂正を何回か試します。端末の機種とメモリ、エラー、計測時間を記録します。
- 普段使うアプリを開いた状態で、一部を繰り返します。遅延や音質が悪化したら、結論を出す前にメモリプレッシャーと試験条件の違いを確認します。
11月14日のホスト型APIの発表で開発者は、ローカルモデルを用意せずプロジェクトを試せるようになりました。会話の比較や連携の開発に使えます。この方法ではアプリがサービスに音声を送るため、サービス側のプライバシーやネットワークの条件が適用されます。ホスト型サービスとMacのCLIには、同じスクリプトが動くかどうか以外にも違いがあります。
オフラインで使えば端末の外へ出る情報を減らせます。機微な経験を話す練習や、接続が弱くても動く試作では大事な点です。オフラインであれば一切ディスクへ書き込まないという保証はありません。録音、文字起こし、ログを含めて、実際に使うクライアントの動作を確認します。接続を切った試験でネットを使わず会話できることは分かりますが、将来のアプリのプライバシー特性すべてを確認できるわけではありません。
もう一つの用途は、音声入力フォームの試作です。四つの質問に答え、先に進む前に直前の答えを訂正できるとします。アプリは、音声モデルが直近で解釈した回答とは別に、確定済みの答えを保持します。再生中に訂正されたら、訂正内容を理解した時点で対象の項目だけを更新します。手を使わない音声入力で操作は楽になりますが、下書きをいつ正式な記録にするかはアプリが管理します。
二つのビルドを比較するなら、どちらも実行する前に合格条件を書き出します。例えば、予定した間は待つ、明確な訂正が入ったら再生を止める、次の質問では訂正後の話題を使う、といった条件です。最後まで完了した試験回数を別に記録し、比較可能な反復が十分なら、時間の中央値と範囲を計算します。最もスムーズなやり取りだけを抜き出さず、再試行も残します。家庭で行う少数の試験では、平均値よりも個々の失敗が多くを教えてくれます。
オフラインとオンラインを比べる際も、同じ用途に絞ります。音声をローカルで動かすメモリがない試作では、ホスト型サービスが比較の基準になります。声、発話の交代設定、モデル、端末へのアクセスが違うなら、それぞれを記録します。一方の遅延が短くても、利用者が言いよどんだときやネットを使えないときにどちらが適しているかまでは分かりません。順位を付けるのではなく、開発中のアプリへの判断材料にします。
試作には、問題が起きた後で操作を戻す方法も用意します。例えば、利用者がアシスタントの声を止めた後、何も発しない場面です。短い視覚表示や端末内の状態表示があれば、固まったのではなく聞き取り中だと分かります。音声デバイスを抜いたり、メモリプレッシャーでモデルが終了したりしたときは、次のセッションを始める前に既知の待機状態へ戻ることを確かめます。復旧の時間は応答の遅延と分けて測ります。通常時に速くても、会話が想定どおりに進まないときに復旧しにくければ、不便さは残ります。
ローカルの面接で、話し手が自分のペースを保てるか
最も多くを知れる試験は、1分もかからないかもしれません。答え始め、少し間を空け、話し終えます。アシスタントが答え始めたら、その途中で内容を一つ訂正します。どの瞬間も意図したとおりに進むなら、音声はオーディオを順番に再生するだけでなく、有用な操作の手段になります。十分なメモリがあれば、Mac版で手元から試せます。結果は機種、言語、部屋、使用するソフトウェアの条件で変わります。
出典
面接の質問、練習メモ、ローカル試験で観察した内容を一か所にまとめましょう。Telli.shで最初のノートを始める。