[AIアイデアノート 01] SlideOn:小さな検索モデルで調整する、2つのコスト予算
LightOnのSlideOnとmSlideOnを紹介。英語・多言語文書を探す疎検索モデルを小さく試し、品質・速度・保存容量を比較する方法を解説します。
AIアイデアノートは、新たに登場するAIモデルやツールの発想と、実用につながる可能性を探るシリーズです。
注文のキャンセル方法を説明した文書があることは覚えています。しかし検索窓が頼りにするのは「キャンセル」という単語だけで、文書では同じ手続きを「撤回」と呼んでいます。正しい答えが保存されていても、簡単に見つかるとは限りません。
LightOnは2026年10月19日、SlideOnとmSlideOnを発表しました。関連文書を取り出すためのモデルで、SlideOnは英語向け、mSlideOnは多言語の文章、長文、コードへと対象を広げています。特に注目したいのは、検索クエリで使う特徴量の数と、保存する各文書に残す特徴量の数を別々に調整できることです。LightOnの発表
この記事では、モデルの用途、2つの設定が変えるもの、検索サービスを構築する前に行う小さな比較実験を説明します。考え方を理解するために、新しいチャットアプリは必要ありません。質問、数件の文書、そして「役に立つ検索結果」の定義から始めましょう。
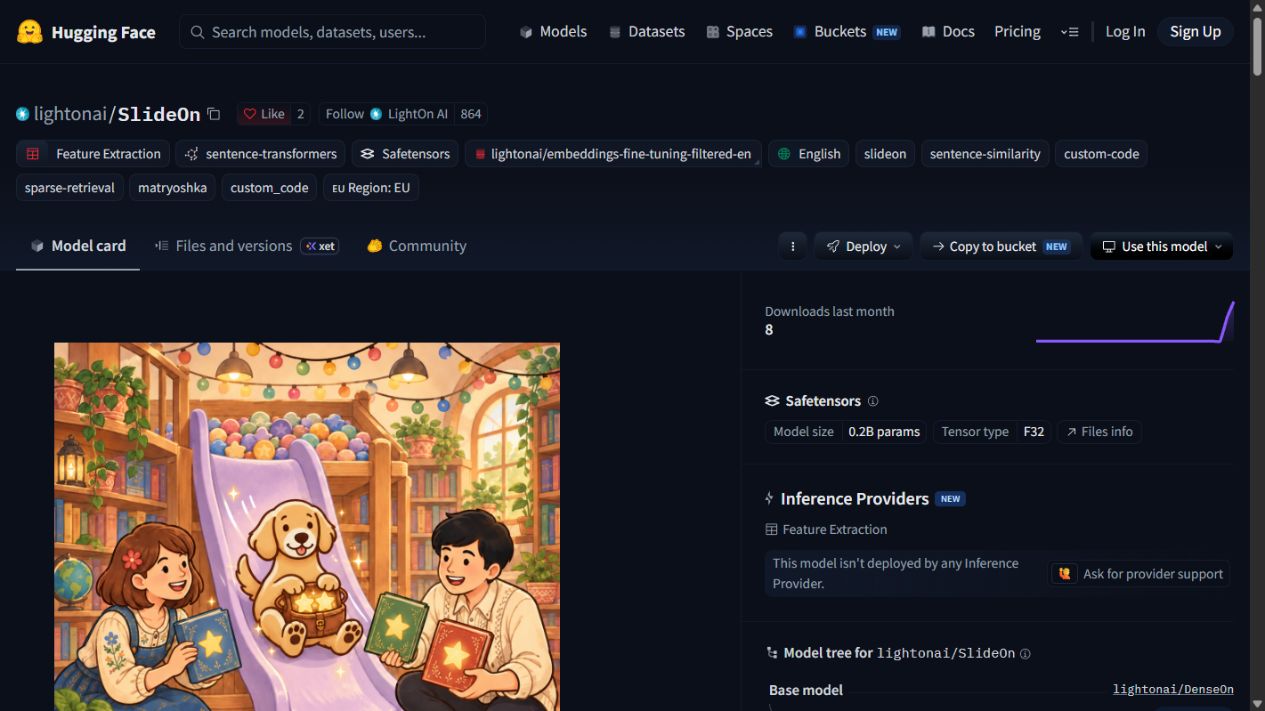 2026年10月20日に撮影した公開モデルカード。出典:Hugging FaceのLightOn。ローカル推論の結果ではなく、公開されているモデルページです。ダウンロード可能なモデルでも、ホスト型の推論プロバイダーが用意されているとは限らないことも画面から分かります。
答えを書く前に、適切な候補を集める
検索モデルはクエリに対して文書を順位付けします。答えを書いたり、ファイルを要約したり、企業の方針変更を判断したりする必要はありません。当面の仕事は、関連する資料を上位に並べることです。
返品、配送、社員の休暇を説明する3ページの社内ハンドブックを考えてください。破損した注文品の返送に関する質問なら、返品ページが上位に来るべきです。最初の結果が休暇カレンダーなら、後段の流暢な回答生成モデルも、すでに誤った根拠から出発しています。
この役割は生成AIがなくても役立ちます。サポート担当者は順位付けされた文書を直接開けますし、研究者は比較する文章を集められます。開発ツールは、人が確認する前に実装の候補を探せます。
責任の分担も明確になります。検索は根拠を探し、正確な表現、日付、例外の確認は元の文書で行います。よい検索結果は、元の資料を信頼度の数値で置き換えるのではなく、資料にたどり着きやすくするものです。
疎検索は、必要な項目だけの住所録を作る
検索インデックスを住所録と考えてみましょう。通常のキーワード索引は、その語を含む文書を記録します。学習型の疎モデルは、少数の学習済み特徴量に重みを付け、共通して有効な特徴量を使ってクエリと文書の一致度を計算します。
「疎」とは、この選択性を指します。表現には多数の位置があっても、個々の文章で使うのは一部だけです。転置インデックスは、有効な特徴量とそれを使う文書を対応付け、検索エンジンが関連するポスティングリストに集中できるようにします。
SlideOnのモデルカードには、32,768個の学習済み特徴量候補と、クエリ・文書それぞれの独立した枝刈り設定が記載されています。特徴量の位置は潜在表現であり、英単語との対応が明白な辞書ではありません。特徴量100を、必ず「返品」の類義語だと解釈することはできません。SlideOnのモデルカード
結果を説明する際には、この点が重要です。疎表現なら検索コストを抑えられても、内部の判断がすべて人間に読めるわけではありません。利用者に示す説明には、関連する原文の一節と、一致の理由を確かめられる文脈が必要です。
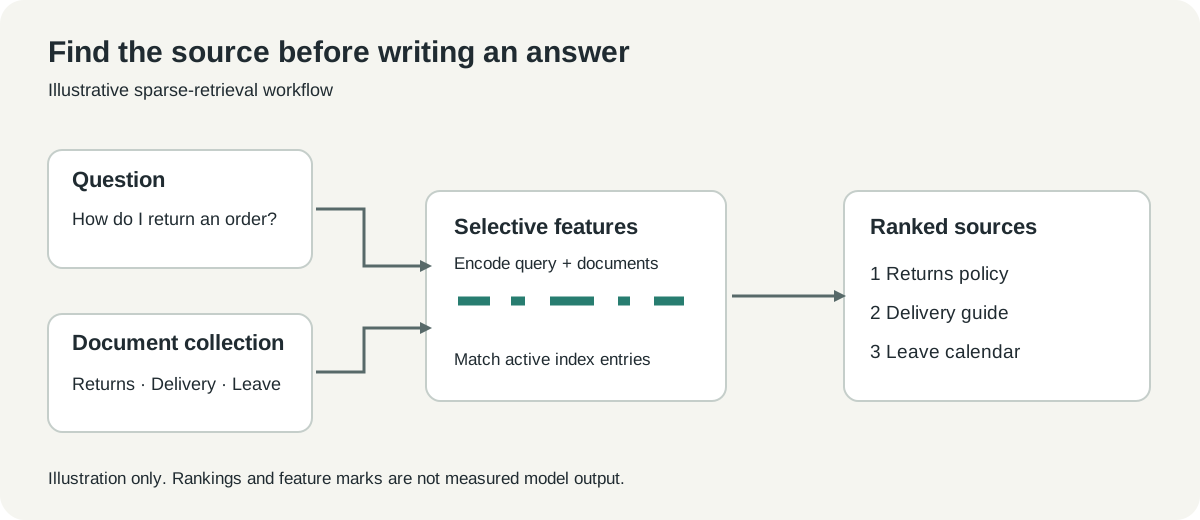 独自の解説図。特徴量の印は仕組みを示す例であり、SlideOnから測定した活性値ではありません。
手元の資料に合うモデルを選ぶ
2つの名前は、単なる言語設定の違いではなく、関連する別々の出発点です。LightOnの発表では、SlideOnは1億7,400万パラメータ、mSlideOnは3億3,900万パラメータとされています。数が大きいだけで、自分の資料に適していると決まるわけではありません。10月19日の発表
| 手元の資料 | 最初に試す候補 | 実験で確かめること |
|---|---|---|
| 英語のヘルプ記事 | SlideOn | 質問と記事の表現が異なっても、正しい記事を取得できるか |
| 複数言語の文書 | mSlideOn | 重要な各言語で機能し、言語をまたぐ検索も要件を満たすか |
| 長い技術文書 | 分割方針を決めたうえでmSlideOn | 関連箇所が前処理と順位付けを通過して残るか |
| 説明文とソースコードの混在 | 候補としてmSlideOn | リポジトリを理解する人にとって返されたファイルが役立つか |
多言語対応という表示は、調査を始める理由になりますが、評価の代わりにはなりません。二言語の資料には翻訳版、地域で異なる方針、直訳では対応しない用語が混在します。同じ言語タグでも、検索の課題はそれぞれ異なります。
たとえば、英語の質問でフランス語の返金規定を探すのは言語横断の検索です。フランス語の質問でフランス語の文書を探すのは同一言語の検索です。集計値が一部の読者にとっての弱点を隠さないよう、別々に記録してください。
コードでも同様です。「セッションの復旧」に関するファイルを見つけることと、関数名の完全一致検索では必要な能力が異なります。便利な検索には両方が必要なことが多いため、説明的な質問だけでなく、識別子をそのまま使う検索も比較に含めましょう。
最初の実験はノートブックで始められる
公開または合成の文章と、新しいPython環境を用意してください。公開例ではSentence TransformersのSparseEncoderを使います。これはモデルを読み込むインターフェースであり、完成した検索サーバーではありません。以下は2026年10月20日に確認した公式手順を応用したものです。利用方法
- モデルカードを開き、リポジトリ独自の推論コードと依存関係を確認します。以下の
trust_remote_code=TrueはリポジトリのPython実装の実行を許可するため、再現可能な実験には確認済みのリビジョンを使います。 - 独立した環境を作り、文書で指定された範囲のライブラリをインストールします。
- 1件のクエリと短い文書を数件エンコードします。接頭辞を手作業で付けず、モデルのクエリ用・文書用メソッドを使います。
- 実際の文書とスコアを並べて確認します。最初に調べるのは順位であり、万能なスコアのしきい値ではありません。
python -m venv .venv
# Activate .venv using the command for your shell.
python -m pip install "sentence-transformers>=6.1,<6.2" "transformers>=5.3,<6"
from sentence_transformers import SparseEncoder

model = SparseEncoder("lightonai/SlideOn", trust_remote_code=True)
documents = [
    "Customers may return a damaged order within the stated return period.",
    "Standard delivery takes three working days after dispatch.",
    "Staff should record annual leave in the shared calendar.",
]
queries = ["What should I do if my delivery arrives broken?"]

q = model.encode_query(queries, top_k=64)
d = model.encode_document(documents, top_k=512)
scores = model.similarity(q, d)
print(scores)
上記の文書は学習用に作った架空の例です。このコードに実測の出力や精度の主張は付いていません。まず返品文書が最上位になるかを確認し、言い換えや意図的に難しい選択肢も試してください。
最も簡単な質問が通っただけで終えないことが大切です。発送前のキャンセル、配達後の破損、期限後の返金を質問してみましょう。資料に答えがない場合は、魅力的だが無関係な結果を評価するのではなく、その不足が分かる実験にします。
2つの予算は、異なるコストを調整する
クエリの枝刈りは、質問時に使う特徴量を制限します。文書の枝刈りは、索引の各項目に保存する特徴量を制限します。大規模なサービスでは、前者は検索のたびに繰り返す処理に関係し、後者は検索の間も残る索引にも影響します。
実験では一度に1つの予算だけを変えましょう。文書表現を固定してクエリ側を調整し、その後に文書側の予算を変えて繰り返します。両方を同時に変えると、結果が変わった原因を特定しにくくなります。
どこまで小さくすれば十分かは、用途次第です。短いFAQ、多言語のアーカイブ、ソフトウェアのリポジトリでは、言語、長さ、反復の分布が違います。大まかな質問に有効な設定でも、よく似た手続きを区別する珍しい細部を失うかもしれません。
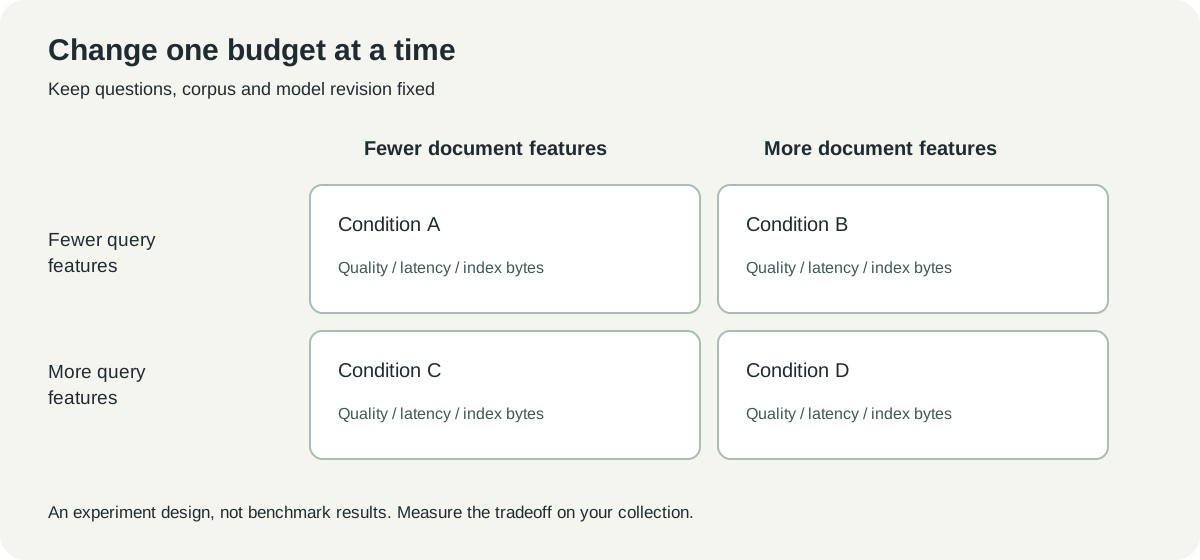 独自の実験計画図。比較条件を示しており、ベンチマーク結果や本番向け推奨設定ではありません。
品質、時間、保存容量は別々の列で記録します。速くなっても正しい記事が最初のページから消えるなら、その改善には代償があります。索引を大きくしても実際の質問で意味のある改善がないなら、追加の保存容量に見合わないこともあります。
ベンチマークの数値は応答時間ではない
モデルカードは、枝刈りしないSlideOnについてBEIR-15でnDCG@10が56.68と報告しています。これは各データセットにわたる順位品質の報告値であり、個々の答えが正しい確率ではありません。ミリ秒でもありません。公開評価
LightOnの効率性の説明は、検索FLOPSの代理指標と実測レイテンシ、文書の非ゼロ要素数とバイト単位の索引容量を区別しています。比較表でもその区別を保ちましょう。数学的な代理指標は仕組みを説明し、運用上の測定は実際のシステムの振る舞いを示します。
小さな評価でも、ストップウォッチだけでは不十分です。初回のモデル読み込み、文書のエンコード、索引構築、繰り返しの検索は別の段階です。コールドスタートと準備済みの検索を分け、クエリのエンコード時間を含むかも明記します。
品質評価も同様です。正しい文書が見つかっても、長文内で誤った箇所が上位になることがあります。判定の単位がファイル、節、文章のどれなのかを記録し、すべての候補でそろえます。
3種類の資料でトレードオフを確かめる
業務ハンドブックは、期待する結果が明確なので最初の例に適しています。返品、発送遅延、アカウントへのアクセスについて質問し、それぞれの正式なページを指定します。見出しと異なる表現も使い、タイトル一致だけを試すことにならないようにします。
多言語のプロジェクト資料には別の難しさがあります。同じ話題が会議メモ、翻訳された告知、古い計画に登場することがあります。現行方針と過去の議論はメタデータで区別してください。意味の類似度では、組織が従うべき版は決まりません。
開発者向け資料では、正確な文字列と類似文書が増えます。タイムアウトの質問には、概念的なガイドと設定キーの両方が必要かもしれません。語彙検索を基準として残し、ハイブリッド方式の複雑さが実際の質問で報われるか確認します。
これらは評価シナリオの提案であり、導入事例ではありません。受け入れ条件を具体化するための例です。どの場合も、質問、正解と認める資料、観測した順位をまとめ、他の人が確認できるようにすることが重要です。
最初の比較は、終えられる規模にする
無制限に質問を集めず、代表的な30問程度から始めてみましょう。通常の参照、言い換え、曖昧な質問、資料では答えられない質問に分けます。これは着手用の設計案であり、統計的に代表性のあるベンチマークではありません。
調整前に、分野に詳しい人が期待する結果を判定します。そうしないと、意外な順位が出るたびに質問の「本当の意味」を後付けしがちです。開発時の例だけに設定を合わせないよう、最後の確認用に未使用の質問を分けておきましょう。
モデルのリビジョン、前処理、分割サイズ、枝刈り設定、マシンの仕様を記録してください。どれか1つの変更でも比較は変わります。入力が失われた大きなスコアより、他の人が再現できる短い実験の方が役立ちます。
最後に、利用者が実際に使う画面サイズで確認します。最上位が正しくても、タイトルが切れて識別できなかったり、抜粋から決め手の文が隠れていたりすれば失敗です。検索と画面の品質は、人が開く資料を選ぶ瞬間につながっています。
よい検索は、原文までの道を短くする
私たちは、SlideOnの有用な発想は品質とリソースの予算を、実験できる設定として分けた点にあると考えます。あらゆる検索課題に大きな回答モデルが必要だと考えるより、実用的な出発点です。質問を保ち、表現を変え、人が実際に何を見つけられるか確認する小さな実験につながります。
チームが何度も見つけ損なう文書から始めましょう。表現が変わっても新しい検索モデルが安定してそれを上位に出せるなら、積み重ねられる具体的な改善です。目的地は読める原文であり、モデルの役目はそこまでの距離を縮めることです。
出典と画像
2026年10月20日確認。セットアップ例は公開モデルカードを応用したもので、インストール、ローカル推論、独立したベンチマークの実施を主張するものではありません。スクリーンショットは著者が撮影したHugging FaceのLightOn公開ページです。2枚の図は独自制作です。画像の出典とライセンス表示はメディア記録にあります。
質問と根拠を一緒に残す
後の比較でも同じ質問に答えられるよう、クエリ集、出典リンク、確認メモをまとめて保存しましょう。Telli.shは、その調査記録の整理に役立ちます。Telli.shアカウントを作成