デモで勝ったロボットが、自分の作業台では負けることがある
RoboColosseumの分散型実機評価は、ハードウェア、タスク、ファインチューニングで性能が変わる理由を示します。必要な作業から試行を組み立てます。
映像では二台のロボットアームが同じくらい頼もしく見えます。一台は見慣れない容器をつかみ損ねます。もう一台はきちんとつかんでも、違う箱に入れます。選定する現場チームは、自分のラインでどんな失敗が起き、復旧に何が必要かを知りたいはずです。
RoboColosseumは、各地の評価サイトにある実機でロボットの方策を比較する研究です。11月2日のarXiv版で、著者は124サイト、5,699件のペア比較を報告しています。機体をまたいだ方策の順位の一致度は低く、ファインチューニング後に相対的な性能が変わることも報告しています。購買担当者や研究者は、この結果を参考に、デモ映像で判断する前に評価を組み立てられます。
Japan Mobility Show 2025で展示されたUnitree G1(左)。評価で使われたロボットの一つです。撮影 RuinDig/Yuki Uchida。サイズ変更あり、CC BY 4.0。画像の出典 · ライセンス。

順位には機体、タスク、環境が伴う
現場でのロボット評価。Telli.sh制作。
ある方策は、特定のロボットとセンサー位置、タスクの組み合わせでうまく動きます。グリッパーや物体が作業領域に入る位置を変えると、少し違う能力が成否を決めることがあります。ファインチューニングした方策と、調整せずに使う方策も別物です。性能には、与えた実演データと適応の工程が反映されます。
研究では現地の条件をそろえて方策を比べています。Open Trackでは、どのモデルによる試行かを伏せて、同じタスクの試行を評価者が比べます。Fine-tune Trackは、より統制されたタスクと実演データを使います。初めての指示に対して何が起こるか、例を与えたときにどこまで適応するかを分けて見られます。
| 結果が示す範囲 | 導入チームがさらに知るべきこと |
|---|---|
| 一つの機体 | ハードウェアやセンサーが自分たちの環境と似ているか |
| 一つのタスク分布 | 対象物、配置、例外がどのように含まれるか |
| ファインチューニングした方策 | どんな実演データ、時間、計算リソースで作ったか |
| 好ましさや進捗の判定 | 介入なしで一連の作業を完了する頻度 |
| ある評価期間 | 当時の構成が導入するバージョンと合うか |
論文は、調査した四種類の機体で順位の一致度が低かったと報告しています。プロジェクトサイトには、より新しく広い評価用ハードウェアの一覧が載ることもあります。論文の数字は論文の対象範囲で説明します。公開プラットフォームの一覧が示すのは現在の提供内容で、論文が示すのは特定時点の実験です。
どの段階で失敗したかを見る
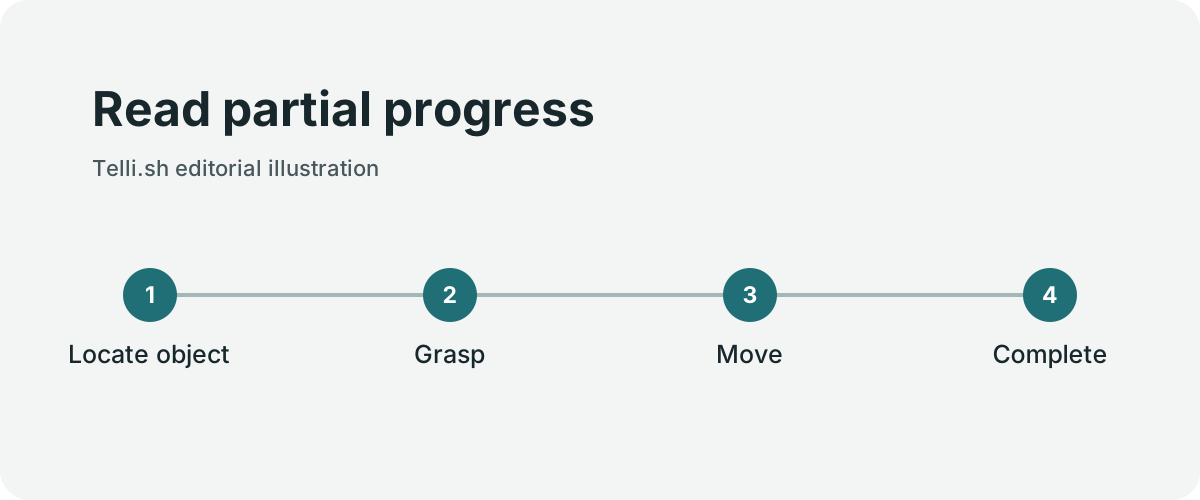
途中の進捗を読む。Telli.sh制作。
研究では、特定の構成のUnitree G1で評価した五つのタスクを完了した方策はありませんでした。それでも進捗スコアには差がありました。最初の段階でつまずくのか、終盤で失敗するのかを知るために、この区別が役立ちます。研究条件での該当タスクと方策に限った結果です。
物体の仕分けを五段階で考えます。対象を認識し、近づき、つかみ、運び、正しい場所に置きます。最後の操作が単純なら、置く直前まで安定して進むモデルは改善に値するかもしれません。失敗時に重い物体を落とすなら、同じ高い進捗スコアでも現場では安心できません。途中の進捗は調べる箇所を示し、物理的な結果は職場でその挙動を許せるかを判断する材料になります。
短いデモでは、やり直しを見落としやすくなります。忙しいラインでは、再試行に時間がかかり、人が配置を戻す場合もあります。成功時に10秒でも、一部で復旧に1分かかるなら、遅くても介入が少ない方策より処理量が低い可能性があります。重要な中断が観察できる回数を繰り返し、成功と復旧時間の両方を測ります。
映像を確認するのも有効です。完全な成功、途中まで進んだ試行、異なる原因で失敗した試行の映像を抽出して残します。つかんだ直後に映像が終われば、置く場面が抜けます。一連の試行を見た評価者は、作業を完了したのか、見込みのある動きまでだったのかを区別できます。
研究の比較方法を現場試験に生かす
試験は、その現場が本当に必要とする仕事から始めます。倉庫なら反射する包装とつぶれた箱が混じるコンテナ、研究室なら小さな道具を次々に受け渡す工程に関心があるかもしれません。タスク、開始状態、期待する結果を具体的にすると再現しやすく、ベンダーにも改善点が伝わります。
- 完了を目で確かめられるタスクを選びます。開始時の配置と完了条件を書き、代表的な対象物と、難しいが実際にあり得る事例を加えます。
- 機体、センサー、エンドエフェクター、現場の条件、方策のバージョンを記録します。可能なら候補を同じ現場設定と指示で動かします。
- 初期状態での実行と、適応後の実行を分けます。適応に用いた実演の数と作業量、評価用に取り置いた例を記録します。
- 完全な成功、途中の進捗、完了時間、人の介入を観察します。準備で失敗した試行や、作業者がリセットした試行も残します。
- 関係する条件が変わるシフトや場所で繰り返します。例えば、入ってくる物体の構成を変えたり、開始位置を少し中心から外した場合を測ったりします。
- 有資格者と現地手順に沿って、導入時の制御と物理的安全性を評価します。研究ベンチマークが測るのは方策の挙動です。職場での評価では、周囲にいる人と設備も考慮します。
質的な違いを判定する場合、モデル名を伏せた映像を二本ずつ比べられます。評価者には、許容できる挙動の定義と、危険または使えない試行を報告する手段を渡します。意見が分かれた理由を後で調べられるよう、十分なメタデータを残します。名称を伏せるとブランドへの先入観を減らせ、共通の採点基準があれば別の現場でも同じ成果を判断できます。
方策を比べる前に評価トラックを分けて読む
Open TrackとFine-tune Trackは、関連する問いを異なる設計で扱います。プレプリントによると、Open Trackは124サイトで5,699件のペア比較を使っています。同等のタスクと現場なら、ペア比較で二つの方策の違いがわかります。すべての機体を、すべてのタスクとサイトで試したという意味ではありません。
論文に記載されたFine-tune Trackでは、20タスクについて各100件の実演データを使います。このトラックでUnitree G1が評価対象の五つのタスクを完全に終えた事例はゼロで、平均の進捗スコアは13.3%から23.2%だったと著者は報告しています。完了がゼロという数字だけよりも、途中のスコアのほうが差を具体的に表します。完了に至らなくても、評価基準上は確認できる進展があることを示しています。
著者は、四つの機体別タスク群の進捗順位について、ケンドールの一致係数を0.24と報告しています。これは順位の一致度で、タスクの完了割合とは異なります。タスク群では、機体だけでなく、一緒に使うタスクと環境も違います。一致度の低さは、自分が選んだ組み合わせを現地で検証する理由になります。機体の形状が順位差の原因だと切り分けられるわけではありません。
現場の二つのシフトで条件をそろえる
物流センターが、同じ包装用の緩衝材をトレーから段ボールへ移す作業を、二つのシフトでロボットに任せたいとします。作業者は、夕方には別のトレーが届き、自然光も少ないと気づきます。整った実験室へ移す代わりに、二つの環境の両方で両方策を動かします。シフト内の実行順を交互にし、残り少ないバッテリー、ずれた治具、作業者の慣れが一方だけを有利にしないようにします。
対象物の最初の位置と向き、許可するセンサーや照明の設定、作業者の介入方法、配置完了の条件を記録します。失敗映像と介入の記録も残します。トレーの置き直し後に一方だけ改善するなら、その介入が最終平均よりも導入判断に役立つ場合があります。治具を変えたり、次の試験の事例を選び直したりする材料になります。
採点表では、観察可能な段階ごとに部分点をつけます。正しい緩衝材を見つけても持ち上げられないグリッパーと、持ち上げても箱に置けないグリッパーでは、必要な改善が違います。二人の評価者が同じ試行を一貫して判断できるよう、各段階を簡潔に定義します。安全停止も別に分類します。作業者が区域に入って停止したなら、完了しなくても正しい動きだった可能性があります。
次の段階に進む証拠を決める
実験室でデモが成功すれば現場試験へ、現場試験が成功すれば長期の試行へ進む根拠になります。どの判断にも独自の基準があります。購買チームは予測が難しい区域に広げる前に、一般的な二つのシフトで繰り返せる結果を求められます。研究者は、方策が別環境でも通用したと述べる前に、失敗分類と再試験の条件を求められます。
結果が食い違う場合は、環境間で何が変わり、どの動作が失敗したかを残します。順位の逆転によって、元のベンチマークになかった作業が見つかることがあります。別のロボット、別の方策、作業セルの変更、より実態に近いテストのどれが必要かを判断する助けになります。
論文で実際に起きた順位の逆転を読む
Fine-tune Trackには、四つのタスク群で順位が入れ替わる具体例があります。進捗の順位では、π0.5がFrankaとBimanual-YAMで1位、G1で4位です。GR00T N1.7はSO-101で1位ですが、FrankaとBimanual-YAMでは4位です。論文のタスク群と進捗指標に基づく結果です。購買チームは、タスク、環境、機体の組み合わせが変わると順位も変わる例として読めます。
論文は、実行する比較を能動的に選ぶ方法も調べています。分析では、約400〜500件の比較を適応的に選ぶと、全データによる順位との一致が約90%に達しました。一様に選んだ場合は約1,000件でした。この評価設計における結果です。現場では、代表的な事例の最低数を固定しつつ、有力な候補の差がわかりにくい場面に試行を追加する、という考え方を使えます。
施設では初回と追加の評価を分けられます。初回は同じ介入規則のもとで、両候補に同じ作業を任せます。次に、初回の結果が分かれた環境で繰り返します。受け入れ条件は変えません。安全上または実務上の理由で除外した設定があれば、理由を残します。最終報告では、追加試験が判断にどう影響したかを説明できるようにします。
大切な仕事について判断に使える情報を買う
分散評価なら、一つの実験室で再現しにくい多様な環境を集められます。現場試験なら、チームが担う仕事を深く調べられます。両者は併用できます。広い証拠で有望な候補を探し、自分たちの評価でシステムの実用性を決める例外を見つけます。
有用なのは、新しい方策やハードウェア変更のあとにチームで繰り返せる比較です。スコアと一緒に、タスク、構成、失敗事例を保存します。順位が変われば、その変更が仕事を改善するか判断する材料になります。
出典
仕事の背景となる会話や判断を検索できる記録にするには、Telli.shのアカウントを作成してください。