Qwen4-Max Previewは動画を読める。必要な場面にたどり着けるか?
長い研修動画でQwen4-Max Previewを試す。答えが正しい場面を示すか、短いクリップにすると何が変わるかを確認する。
研修動画では、保存期間の状態を確認してから記録をアーカイブするよう説明している。40分後、二回目の実演で同じ画面を開くが、確認の手順は飛ばす。研修を受けた人は、一連の操作が全部見える場面を知りたい。整った答えは読みやすい。正しい再生位置なら、その場面を自分で確かめられる。
QwenCloudは2026年11月11日、テキスト、画像、動画を受け付ける主力モデルQwen4-Max-Previewの限定プレビューを始めた。文書に記載されたコンテキスト長は100万トークン。利用できるのはToken Planのみで、プレビューはUTC+8の11月25日24時に終了予定だ。QwenCloudはその後、このモデルIDの提供を終えるとしている。QwenCloudのモデル文書
この種のモデルなら、長い録画について質問できる。役に立つのは、答えを裏づける箇所に人を直接案内できるときだ。研修動画を使えば、正しい場面を探すこと、その内容を理解すること、分かりやすく伝えることを分けて試せる。
長いコンテキストは、探せる候補を増やす
100万トークンという仕様はコンテキストの上限だ。ある動画から役に立つ細部をどれだけ受け取れるかを予測する単位としては使いにくい。動画処理、フレームのサンプリング、ファイルの制約、API経路、プロンプトのほかの内容が、リクエストに入る情報を左右する。長さが同じでも、視聴者が気づくべき内容は大きく違う。一瞬だけ映る画面は、数分表示される部分より探しにくいことがある。使うエンドポイントと入力方法に対応する動画入力の文書を確認する。
QwenCloudは構造化出力と、推論の強さを調整する個別の設定を文書に載せている。一定の形式で答えを返すよう指定し、設定を比較できる。主張と時刻の形式をそろえられるが、根拠はその時刻の動画に何が映っているかを見て確かめる。QwenCloudのモデル機能
50分のソフトウェア研修動画を想像してみよう。同じアーカイブ用ダイアログが二回出る。必要な方の実演では、講師はまず保存期間の項目を読み、日付を確認してから続ける。最後の振り返りでは、画面を開く場所だけ見せ、その項目は確認しない。適切な答えは、全手順のある場面を特定し、画面にある目印を伝える。ダイアログの名前だけで照合すると、受講者を違う場面に案内しかねない。
この違いを中心に評価を組み立てる。各質問で、確認者に根拠となる区間と画面上の目印を記録してもらい、文字起こしだけで答えられるかも記す。二つの区間に十分な根拠があれば、両方を正解にする。役に立つ別の箇所を挙げた答えまで減点しなくて済む。二つの動作の順序が重要なら、両方が見える区間全体を指定する。
候補の時刻を開いて実際に根拠を見られると、再生位置が役に立つ。Telli.sh作成。
人が確かめられる答えを求める
返すデータは少なくてよい。答え、元動画上の開始と終了時刻、根拠となる目印の短い説明、根拠不足を明示する状態を用意する。画面からは候補区間の開始位置を開ける。確認者には、生成された説明を読む前に動画の根拠を見るよう頼む。もっともらしい説明に判断を引きずられにくくなる。
依頼はこう書ける。「アーカイブの全手順が映っている場面を見つけてください。開始と終了の時刻を示し、保存期間の状態を表示する項目を特定し、アーカイブの確認前に日付が表示されるか答えてください。全手順が録画に含まれていなければ、根拠不足と報告してください」。人が見て確かめられる項目を指定する。「確信度」の数値は、実際の結果と合っているか検証できる場合に求める。
文字、順序、映っていないものについて質問する。文字なら、二つの場面で意味が変わる画面上のラベルを選ぶ。順序なら、明確な目印の前後に何が現れるか聞く。映っていないものなら、ありそうでも動画には出てこない手順を聞く。モデルはよくある手順を頼りに普通の問題を解ける。この録画がその手順どおりでないときに、どう答えるかを見るのが否定例の役割だ。
タイムスタンプの定義も必要だ。プレーヤーがゼロから始まり、文字起こしが元録画のタイムコードを使うなら、採点前に基準をそろえる。長い動画から5分を切り出す場合は、クリップと元動画の時刻の差を保持する。クリップ上の04:15を出力し、元動画の04:15を開けば、モデルが正しいフレームを見つけていても、もっともらしい誤りになる。
同じ質問で、全体検索と短い区間の確認を比べる
録画を探す方法は少なくとも二つある。動画全体をモデルに渡し、候補区間を返してもらう。あるいは、既知の章に分け、章名や文字起こしで絞り、その短いクリップを調べてもらう。同じ質問と、人が付けた同じ参照区間で始める。大きなリクエストに見合う成果があるか判断する前に、両方の時間と費用を比べる。
| 方法 | 向いている場面 | 確認すること |
|---|---|---|
| 一回のリクエストで動画全体 | 離れた場面で同じ動作が繰り返される | 正しい場面、全体の待ち時間、未完了の出力 |
| 章を探してから短いクリップを確認 | 話題が分かっており、画面の細かい箇所を読みたい | 章選びの失敗と時刻のずれ |
| 先に文字起こし、次に映像を確認 | ナレーションと画面上の確認がある手順 | 説明と実際の操作が一致するか |
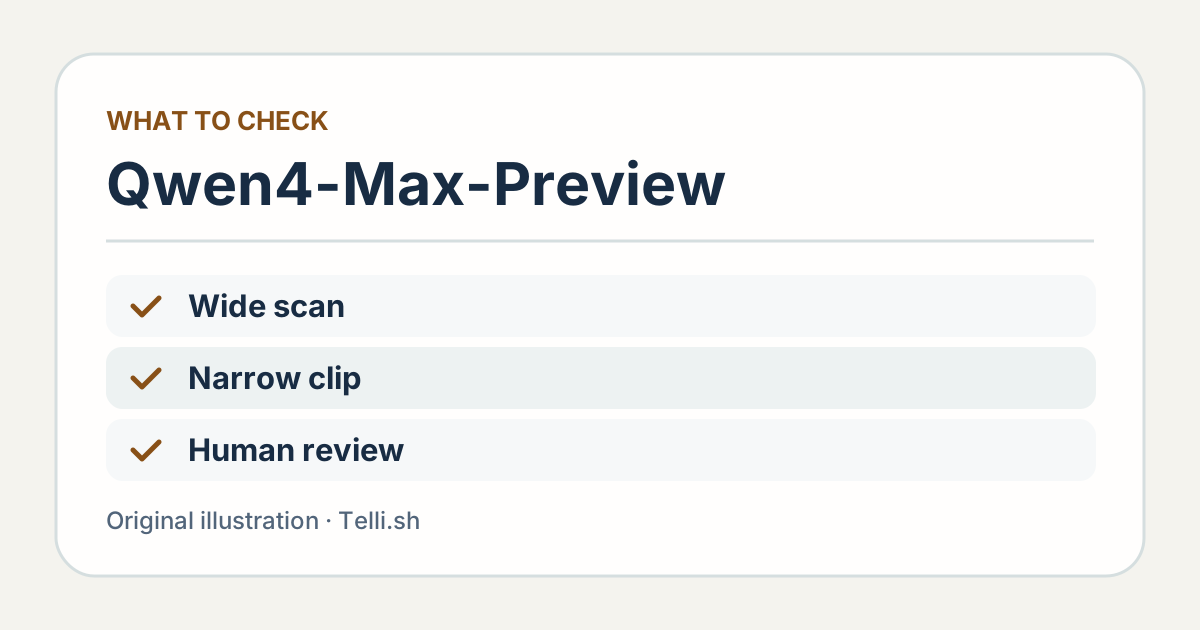
同じ参照場面を使い、見つけ方を比較する。Telli.sh作成。
短い経路は安価に試せる場合があるが、モデルが根拠を見る前に検索が失敗する可能性が加わる。動画全体なら予想外の章の場面が見つかることもある。大まかな箇所は合っていても、目印を見落とすこともある。誤りは種類ごとに記録する。検索の失敗なら章の選び方を改善する。根拠の読み取りを誤ったなら、映像入力か確認手順を見直す。元動画の時刻がずれたなら、プレーヤーか変換を直す。
区間の一致と、答えの完成度を分けると評価が明確になる。候補区間が有効な参照場面と重なるかを記録する。そのうえで、映った項目と操作順序を正しく説明したかを見る。ゆっくりした実演なら10秒など、許容範囲を事前に決められる。瞬間的な画面遷移にはもっと狭い範囲が必要かもしれない。別モデルも同じ条件で評価できるよう、設定を保存する。
質問してから根拠を再生できるまでの時間を測る。説明だけ早く返ってきても、開ける区間がなければ、人がもう一度検索することになる。最初に使える結果までの時間と、処理が全部終わる時間は分けて記録する。重要な答えなら候補を二つ開く価値があるかもしれない。日常の質問なら、正しい答えと根拠へのリンク一件で足りる。
似た動画三本で、異なる三つの誤りを見つけられる
動画ごとに、分かりやすい難しさを一つずつ加えた小規模な試験セットを作る。一本目は、音声での説明と映像の操作が一致する実演。二本目では、話した手順と画面のボタン操作を変える。三本目では、最初の方に似た場面を置き、正しい場面を終盤に入れる。手順どおりの教材をうまく読めても、受講者が助けを求めるケースで失敗することがある。
画面上の細かな手がかりが答えを左右する課題を使う。二本目で、講師は「送信」をクリックするよう言うが、見えているボタンは「下書きとして保存」で、文書はレビュー待ちに入らない。文書を提出したい人には重要な違いだ。講師が勧めた操作と、実際に起きたことを別々に答えさせる。最終状態を表示する項目を探すべき根拠にする。正しいタイムスタンプは、画面状態が変わった理由まで見える位置を開く。
確認者には簡単な判定表を渡す。区間が正しく解釈が違えば読み取りエラー、解釈が正しく別の場面を指せば検索エラーとする。意図的に欠けたクリップで根拠不足と答えれば正しい。明示された手順が入っているのに同じ答えなら誤りだ。このようなケースを明示して数えれば、難しい質問をすべて断って点数を上げることはできない。すべての方式に同じ採点を使う。
画面の文字の見落としを判断する前に、読める状態か確認する。提出したファイルそのものを想定サイズで開き、確認者が見られるフレームと比較する。圧縮によって、モデルが受け取る前から状態欄が読めないこともある。広い検索で毎回章を見つけるのに細部を逃すなら、映像を切り出して試す。動画全体を送り直すより、局所の映像を詳しくした方が役立つかを確かめられる。
研修では、根拠の区間をどこまで短くするかにも編集上の判断がいる。5秒の切り出しでは最終状態は見えても、その状態に至った判断は省かれることがある。直前のメニュー選択、警告、確認画面のどれを学習者が見る必要があるか記す。答えの証明と操作の理解の両方に役立つ区間を開ける。
プレビューの期間を評価に使う
QwenCloudのモデルIDは qwen4-max-preview だ。モデルページは専用のToken Planからの利用を示し、このプレビューでは従量課金が使えないと説明している。OpenAI形式のChat CompletionsとResponses、Anthropic形式のMessagesへの互換性が文書化されている。テキスト専用に作ったクライアントを再利用する前に、選んだプロトコルの視覚入力ルールを確認する。QwenCloudのプレビュー利用条件
QwenCloudが示す最大出力は393,216トークンで、推論と最終回答がその枠を共有する。Chat Completions互換のインターフェースでは、最大生成予算に両方が含まれる。この評価では答えを短く指定し、出力が途中で切れていないか見る。一つの20秒の場面を探す人に、長い出力枠そのものはほとんど役立たない。推論設定を比較するときは、入力サイズの違いを推論の品質差と誤認しないよう、動画、質問、検証条件を固定する。
サービスへ送る許可のある動画を選ぶ。根拠検索を試すなら、架空の操作を使った教材や公開研修動画で足りる。顧客データや社内手順を含めず、見た目の似た二つの実演に一つだけ意図的な違いを入れられる。後で職場の録画を使うなら、試験に加える前に、提供元の最新のデータ条件とチームのアップロード許可を確認する。
プレビューが終わっても評価を使えるようにする。ファイルの参照先、章の区切り、参照区間、質問、採点の判断を、モデルIDと日付とともに保存する。映像は利用が認められた自分たちの保存先に置く。後継モデルと比べる場合、作り直す手間が大きい、確認済みの事例がすでにそろっている。
根拠へのリンクが利用者との接点になる
長いコンテキストで、場面を探す新しい方法を試せる。次の人に役立つ結果は、正確で再生できる区間だ。研修担当者なら、授業全体を見直さずに、受講者が正しい場面を開いて操作を理解できるかを試すとよい。この評価はプレビュー終了後も使える。
出典
研修メモや、その内容に基づく判断を検索できる形に残すには、Telli.shアカウントを作成。