16.5GB짜리 파일이 2월의 최강 비공개 모델을 앞질렀습니다
3년 전, 다운로드할 수 있는 최고의 모델은 HumanEval에서 GPT-4에 37점 뒤졌고 그래픽카드 두 장이 있어야 돌아갔습니다. 지난주 27B 오픈 웨이트 모델이 Artificial Analysis 인텔리전스 지수에서 52.0을 기록했습니다. Claude Opus 4.6 Max는 44.9였습니다. 가격은 9분의 1, 파일 크기는 16.5GB. 벤치마크 표와 가격 곡선, 그리고 추격 시차가 162일까지 줄어든 것의 의미를 정리했습니다.
해커뉴스의 어떤 사람이 메모리 16GB짜리 그래픽카드로 프런티어급 언어 모델을 돌리고 있습니다. 초당 50~60토큰, 컨텍스트는 12만 8천 토큰. 모델은 2026년 8월 14일 공개된 Qwen3.8-27B입니다. Artificial Analysis 인텔리전스 지수에서 이 모델은 52.0을 받았습니다. 불과 지난 2월까지 시장에서 가장 강했던 비공개 모델 Claude Opus 4.6 Max는 44.9입니다.
2023년이었다면 이건 공상과학이었습니다. 그것도 즐거운 쪽의 공상과학은 아니었죠.
이 글은 그 전과 후를 비교합니다. 출시 소식 자체는 이미 다뤘고, 여기서 하려는 건 3년을 사이에 둔 비교입니다. 당시와 지금, 다운로드 가능한 최고의 모델이 프런티어를 상대로 받은 점수. 당시와 지금, 일정 수준의 지능을 사는 데 드는 비용. 그리고 당시와 지금, 직접 돌리려면 어떤 하드웨어가 필요했는지. 아래의 모든 수치에는 출처와 날짜가 붙어 있습니다. 그 수치들이 그리는 추세는 요즘 소프트웨어 업계에서 벌어지는 일 중 가장 낙관적인 축에 듭니다.
요약:
- 격차가 좁혀졌고, 날짜까지 특정할 수 있습니다. 2023년 7월 최고의 오픈 모델은 MMLU에서 GPT-4에 17.5점, HumanEval에서 37.1점 뒤졌습니다. 2026년 8월, 오픈 27B는 2월의 비공개 대표 모델을 상대로 양쪽이 모두 점수를 공개한 19개 벤치마크 중 15개에서 이겼고, 독립 종합 지수에서도 앞섰습니다.
- 가격은 23개월 만에 약 208배 떨어졌습니다. 동일 성능 기준으로 Epoch AI가 측정한 값입니다. 지금 오픈 27B의 혼합 단가는 100만 토큰당 1.09달러, Opus 4.6 Max는 10.00달러입니다. 직접 돌리면 토큰당 비용은 0입니다.
- 프런티어는 아닙니다. 그 점도 분명히 말합니다. Claude Opus 5 Max는 63.1, GPT-5.6 Sol Max는 60.9입니다. 27B는 폭넓은 지식 추론에서 Opus 4.6에 크게 집니다. HLE에서 30.8 대 40.0입니다.
이미지: Steve Jurvetson, 위키미디어 공용, CC BY 2.0. 1988년경 Cray Y-MP의 인터커넥트. 한때 진지한 연산이란 사람이 걸어 들어가는 방이었습니다.
"전"은 실제로 이런 모습이었다
시계를 2023년 7월 18일, 메타가 Llama 2를 공개한 날로 돌려 봅시다. 당시 세계에서 공개적으로 다운로드할 수 있는 가장 좋은 모델이었고, 그 논문은 비공개 프런티어와의 점수표를 조금도 감추지 않고 실었습니다.
Llama 2 70B는 MMLU에서 68.9를 받았습니다. GPT-4는 86.4였습니다. GSM8K에서는 56.8 대 92.0. 코딩 벤치마크인 HumanEval에서는 29.9 대 67.0으로, 절반에도 못 미쳤습니다. 논문 자신의 요약은 이렇습니다. "Llama 2 70B와 GPT-4, PaLM-2-L 사이에는 여전히 큰 성능 격차가 있다." 2023년, 오픈 웨이트 진영의 대표 모델이 스스로 남긴 문장입니다.
하드웨어도 보죠. 사람들이 실제로 Llama 2 70B를 돌리던 방식인 TheBloke의 4비트 커뮤니티 빌드는 41.4GB 파일이었고, 2023년 9월 4일에 올라왔습니다. 이걸 쓸 만한 속도로 돌리려면 24GB 그래픽카드 두 장이나 64GB 맥이 필요했습니다. 평범한 노트북에 실제로 들어가는 모델은 Llama 2 13B였습니다. 7.9GB 파일에 MMLU 54.8점, GPT-4보다 31.6점 낮았고, 데모 말고는 쓸 데가 거의 없었습니다.
그러니까 2023년의 선택지는 이랬습니다. 프런티어 연구소에 돈을 내거나, 눈에 띄게 못한 모델을 대부분이 갖고 있지도 않은 하드웨어에서 돌리거나. "그냥 API 쓰세요"라는 주장이 2년 동안 압도적으로 이긴 이유가 여기 있습니다. 그 주장은 옳았습니다.
같은 질문을 2026년 8월에 던져 본다
알리바바는 2026년 8월 14일 Apache 2.0 라이선스로 Qwen3.8-27B를 공개하면서, 모델 카드에 Claude Opus 4.6 Max와의 정면 비교표를 실었습니다. 양쪽 모두 숫자가 있는 행을 전부 세어 봤습니다.
Qwen3.8-27B는 19개 행 중 15개에서 이기고 4개에서 집니다. 이긴 항목에는 SWE-bench Pro(61.7 대 53.4), IFBench 지시 수행(79.5 대 62.5), LiveCodeBench v6 경쟁 코딩(90.3 대 88.8), OSWorld-Verified 컴퓨터 조작(84.3 대 72.7), AndroidWorld 모바일 에이전트(81.9 대 62.0)가 있고, 격차가 아예 크게 벌어지는 멀티모달 벤치마크가 줄줄이 이어집니다. MathVision 90.0 대 65.5, CharXiv 차트 분석 83.7 대 66.0, ERQA 체화 추론 65.5 대 40.8입니다.
진 4개가 이긴 15개보다 중요합니다. 270억 파라미터 모델이 아직 못 하는 일이 무엇인지 알려 주기 때문입니다. Terminal Bench 2.1에서 73.0 대 78.2로 지고, NL2Repo-Bench 저장소 단위 코드 생성에서 42.3 대 47.6으로 지고, GPQA Diamond에서 89.2 대 91.3으로 아깝게 지고, 폭넓은 다분야 추론 벤치마크인 HLE에서 30.8 대 40.0으로 크게 집니다. 마지막 항목이 이 한계의 형태 그 자체입니다. 세상의 지식을 16.5GB 파일에 압축할 수는 없습니다. 반면 기술은 엄청난 양을 압축할 수 있습니다.
한 줄에는 별표가 필요합니다. 79.0 대 63.8이 나온 QwenSWEBench는 Qwen이 직접 만든 벤치마크입니다. 벤더가 만든 벤치마크를 벤더가 돌린 결과는 어떤 모델 카드에서든 가장 약한 증거이고, 우리는 이 숫자에 기대지 않습니다.
독립 점수표도 같은 말을 한다
벤더 표는 벤더 표일 뿐이니 제3자를 봅시다. 남의 숫자를 옮겨 싣는 대신 직접 평가를 돌리는 Artificial Analysis가 이제 27B를 벤치마크했습니다. 2026년 8월 21일 기준 Qwen3.8-27B의 인텔리전스 지수는 52.0이고, 오픈 웨이트 40억~400억 파라미터 등급 135개 모델 중 1위입니다. Claude Opus 4.6 Max는 44.9입니다. 이해관계가 없는 쪽이 측정한 7.1점 차이이며, Opus 4.6 출시로부터 190일 뒤의 일입니다.
이 비교를 시간축으로 되짚으면 그게 곧 이야기가 됩니다. 2023년 7월, 400억 파라미터 이하 최고의 오픈 모델은 같은 지수에서 2.6점이었습니다. 2024년 7월에는 7.4점. 2025년 3월에는 13.4점. 2026년 2월에는 34.6점. 그리고 지난주 52.0점입니다.
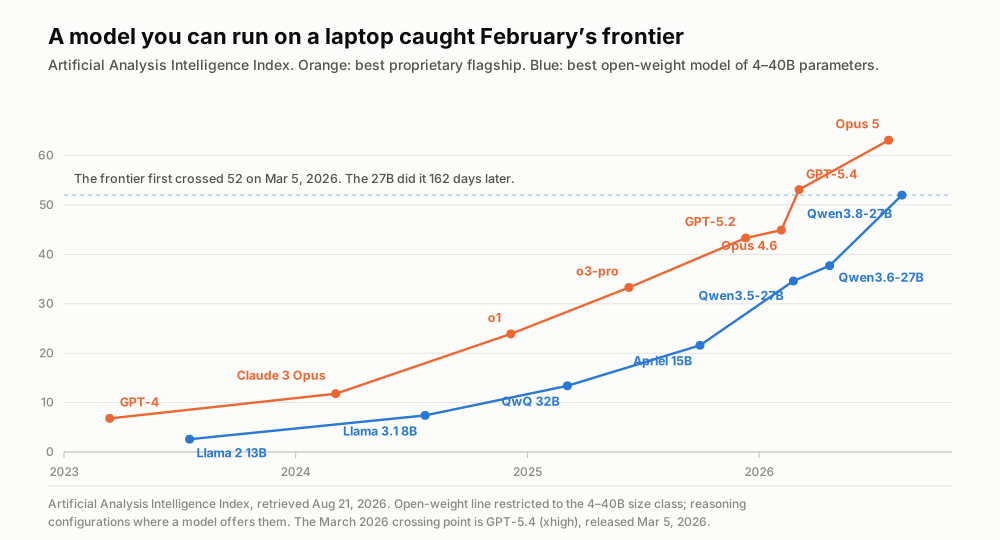
두 선 모두 올라갑니다. 흥미로운 값은 둘 사이의 가로 거리입니다. Artificial Analysis 인텔리전스 지수, 2026년 8월 21일 조회.
여기 이름을 붙일 만한 숫자가 있습니다. 프런티어가 인텔리전스 지수 52를 처음 넘은 건 2026년 3월 5일, GPT-5.4가 최고 추론 강도에서 53.1을 받았을 때입니다. 개인용 기기에서 돌아갈 만큼 작은 모델이 거기 도달한 건 8월 14일, 162일 뒤입니다. 이걸 추격 시차라고 부르겠습니다. 어떤 능력이 프런티어에 등장한 시점과 내 하드웨어에 등장한 시점 사이의 간격이죠.
이 시차는 예전엔 훨씬 길었습니다. Llama 3.1 8B가 GPT-4 Turbo의 수준에 닿는 데 260일이 걸렸습니다. GLM-4.7-Flash가 o1을 따라잡는 데는 410일이 걸렸습니다. 최근 노트북급 출시 세 건은 각각 201일, 155일, 162일이었습니다. 프런티어가 느려진 게 아닙니다. Opus 5 Max는 오늘 63.1에 있습니다. 다만 뒤따르는 가장자리가 2년 전보다 두 배쯤 빠르게 좁혀 오고 있습니다.
가격은 떨어진 게 아니라 무너졌다
능력은 전후 비교의 절반입니다. 나머지 절반은 청구서입니다.
Epoch AI가 2025년 3월에 이 문제를 가장 깔끔하게 측정했고, 방법 자체가 알아둘 만합니다. 벤치마크 점수를 고정해 놓고, 그 점수를 내는 가장 싼 모델의 가격을 시간에 따라 추적하는 것입니다. GPT-4의 MMLU 86점을 기준으로 잡으면 가격 사다리는 2023년 3월 100만 토큰당 37.50달러, 2023년 11월 15.00달러, 2024년 5월 7.50달러, 같은 달 말 2.19달러, 2025년 2월 0.18달러로 내려갑니다. 점수는 그대로입니다. 23개월 만에 208배 싸졌습니다.
Epoch의 핵심 결론은 그 속도가 과제에 따라 크게 다르다는 것입니다. 어떤 능력을 고정하느냐에 따라 연간 9배에서 900배까지 벌어지고, 박사 수준 과학 문제에서 GPT-4급 성능의 가격은 연 40배 정도 떨어졌습니다. 방향만은 한 번도 바뀌지 않았습니다.
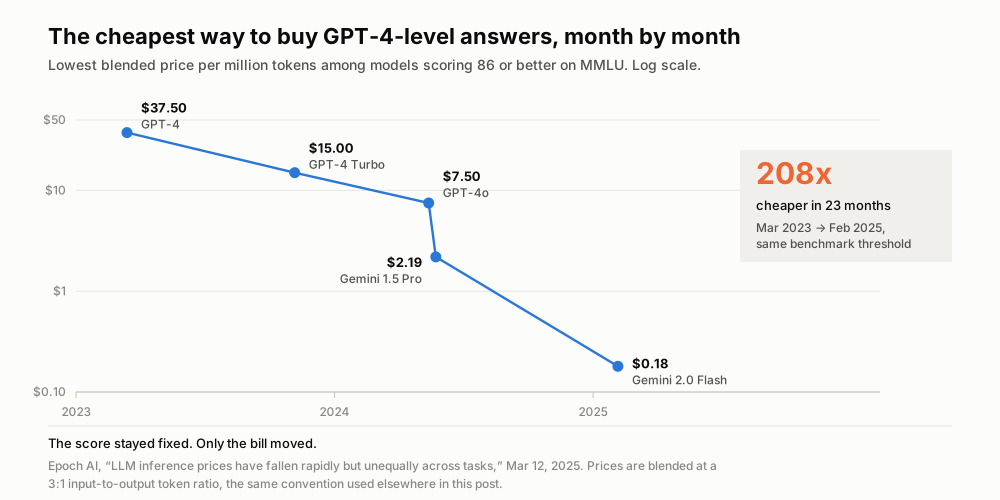
이 선 위의 모든 점에서 벤치마크 점수는 고정되어 있습니다. Epoch AI, 2025년 3월 12일.
이 계열을 현재 가격으로 이어 보면 흐름은 그대로입니다. 2026년 8월 21일 기준 OpenRouter 카탈로그에서 Qwen3.8-27B는 입력 100만 토큰당 0.45달러, 출력 100만 토큰당 3.20달러입니다. Claude Opus 4.6은 각각 5.00달러와 25.00달러입니다. Epoch가 쓰는 입력 대 출력 3:1 혼합 기준으로 환산하면 1.09달러 대 10.00달러, 즉 오픈 모델이 반년 전 비공개 대표 모델보다 9.1배 싸고 지수로 7.1점 높습니다.
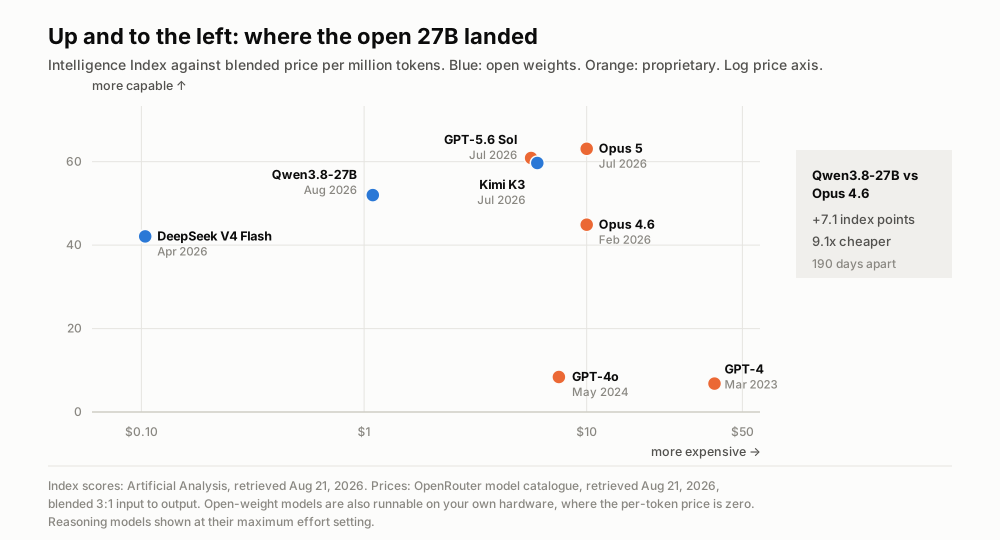
의미 있는 모델은 전부 왼쪽 위 구석으로 이동하고 있습니다. 점수는 Artificial Analysis, 가격은 OpenRouter, 둘 다 2026년 8월 21일 조회.
그리고 토큰당 가격이라는 개념 자체가 없는 선택지도 있습니다. 27B를 자기 RTX 4090에서, 출시 스레드에서 실사용자들이 보고한 초당 약 48토큰으로 돌린다고 해 봅시다. 카드의 정격 450와트를 가정하고 미국 가정용 평균 전기요금 킬로와트시당 18.44센트(EIA, 2026년 5월)를 적용하면 전기값은 출력 100만 토큰당 약 0.48달러입니다. 카드 값은 아직 세지 않았고, 대신 누구의 마진도 세지 않은 값입니다. 벤더의 주장이 아니라 가정을 전부 드러낸 계산 추정치입니다.
전과 후, 한 줄씩
| 2023년 7월 | 2026년 8월 | |
|---|---|---|
| 다운로드 가능한 최고 모델 | Llama 2 70B (메타, 2023년 7월 18일) | Qwen3.8-27B (알리바바, 2026년 8월 14일) |
| 파라미터 | 700억 | 270억 |
| 표준 4비트 커뮤니티 빌드 | 41.4GB | 16.5GB |
| 쓸 만한 최소 빌드 | 7.9GB (13B, MMLU 54.8) | 9.8GB (2비트, 16GB 카드에서 12만 8천 컨텍스트) |
| 현실적인 하드웨어 | 24GB GPU 두 장 또는 64GB 맥 | 16GB 소비자용 GPU 한 장 |
| 당시의 프런티어 모델 | GPT-4 (2023년 3월 14일) | Claude Opus 4.6 Max (2026년 2월 5일) |
| 그 모델과의 대결 결과 | MMLU −17.5, GSM8K −35.2, HumanEval −37.1 | 공개된 19개 벤치마크 중 15개 승, 인텔리전스 지수 +7.1 |
| 그 프런티어 모델의 혼합 단가 | 100만 토큰당 37.50달러 | 100만 토큰당 10.00달러 |
| 오픈 모델의 혼합 단가 | 대규모 제공 없음 | 100만 토큰당 1.09달러 |
| 라이선스 | Llama 2 커뮤니티 라이선스 | Apache 2.0 |
모든 칸의 출처는 글 끝에 있습니다. 우리가 계속 돌아보게 되는 건 아래에서 두 번째 행입니다. 프런티어 자체의 가격은 3년 동안 3.75배 떨어졌는데, 오픈 대안은 그 아래 10분의 1 수준에서 등장했습니다. 두 가지 모두 일어났습니다. 누가 무엇을 만들 수 있는지를 바꾸는 건 두 번째 쪽입니다.
아직 사실이 아닌 것
이번 공개를 둘러싼 열기는 네 가지 지점에서 증거를 앞지릅니다. 표시해 두겠습니다.
프런티어가 아닙니다. 같은 지수에서 Claude Opus 5 Max는 63.1, GPT-5.6 Sol Max는 60.9로 52.0보다 한참 위입니다. 지금 구할 수 있는 가장 어려운 추론이 업무의 전제라면, 프런티어는 여전히 다른 제품이고 여전히 비공개입니다.
크기 대비 싸지도 않습니다. Artificial Analysis의 요약 자체가 Qwen3.8-27B를 두고 "비슷한 크기의 다른 오픈 웨이트 모델과 비교하면 특히 비싸다"고 씁니다. 같은 등급 오픈 모델의 입력 단가 중간값은 100만 토큰당 0.05달러인데 Qwen은 0.43달러입니다. 파라미터가 아니라 능력에 돈을 내는 것입니다.
말이 많고, 말이 많으면 그게 곧 비용입니다. 인텔리전스 지수 평가를 돌리면서 27B는 출력 토큰 1억 6천만 개를 썼습니다. 중간값은 4천 5백만 개입니다. 어떤 사용자는 64GB 맥 미니에서 두 단어짜리 프롬프트를 넣고 17분 12초 동안 모델이 생각하는 걸 지켜봤습니다. 추론 모델은 토큰이 공짜여도 벽시계 시간으로 청구합니다.
그리고 벤치마크 점수는 원래 정밀도 모델의 것입니다. 여러분의 그래픽카드에 들어가는 9.8GB짜리 2비트 빌드는 52.0을 받은 그 모델이 아닙니다. 강한 양자화는 정확도를 깎고, 특히 긴 컨텍스트에서 그렇습니다. "노트북에서 돌아간다"는 모든 주장에는, 우리 것을 포함해 이 단서가 붙습니다.
시차가 계속 줄어들 이유
이제 우리 견해입니다. 전환점을 분명히 표시하겠습니다. 위의 내용은 전부 측정이고, 아래는 그로부터의 추론입니다.
추격 시차를 끌어내리는 메커니즘은 신비롭지 않습니다. 프런티어에서 공개된 사후 학습 기법은 몇 달 안에 오픈 진영에서 재현됩니다. 1년 반 전만 해도 독점 기술이었던 추론 강도 조절은 이제 이 모델 카드에 문서화된 파라미터로 실려 나옵니다. 커뮤니티 양자화는 원 연구소의 문서가 확정되기도 전에 끝납니다. 이 세 개의 피드백 루프 중 어느 것도 느려질 이유가 없고, 그중 둘은 참여자가 늘수록 빨라집니다.
그러니 다음 세대에 대한 합리적인 기대는 오픈 모델이 프런티어를 추월한다는 게 아닙니다. 162일이라는 시차가 계속 압축되는 동안 양쪽의 절대적인 능력도 함께 올라간다는 것입니다. 그러면 흥미로운 질문은 "오픈 모델이 이길 수 있느냐"가 아니라 "내 작업에서 차이가 사라지려면 프런티어가 얼마나 최신이어야 하느냐"가 됩니다. 회의 전사, 번역, 요약, 대부분의 문서 작업에서는 그 문턱이 이미 한참 전에 넘겼습니다. 최전선 연구와 가장 어려운 에이전트형 엔지니어링에서는 아직 아닙니다.
2023년의 세계보다 훨씬 나은 세계이고, 그 말을 분명히 할 가치가 있습니다. 컴퓨터에게 언어를 제대로 이해시키는 비용이 3년 만에 100배 규모로 떨어졌고 여전히 떨어지고 있습니다. 가장 크게 이득을 보는 건 그동안 가격 때문에 밀려나 있던 쪽입니다. 1인 개발자, 100만 토큰당 10달러가 반올림 오차가 아닌 나라의 팀, 예산 대신 연구비로 일하는 연구자, 그리고 법적인 이유로 데이터가 자기 기기를 떠나면 안 되는 모든 사람입니다.
결론: 프런티어는 장소이길 그만두고 날짜가 됐다
예전 질문은 "어느 연구소에 접근할 수 있는가"였습니다. 새 질문은 "9분의 1 값에 내 하드웨어에서 돌아간다면, 프런티어보다 몇 달 뒤처지는 걸 감수할 수 있는가"입니다.
점점 더 많은 일에서 정직한 답은 이렇습니다. 다섯 달쯤, 그리고 줄어드는 중.
Telli.sh는 여기에 있습니다: 위의 이야기가 바로 우리가 특정 벤더를 둘러싸는 대신 오픈 모델 위에 제품을 만드는 이유입니다. Telli.sh는 이미 요약 경로에 오픈 Qwen 모델을 쓰고 있어서, 이 곡선을 한 칸 내려갈 때마다 가격 인상 공지가 아니라 더 나은 회의록으로 도착합니다. 우리가 붙들고 있는 건 어떤 다운로드로도 얻을 수 없는 부분입니다. 한 시간짜리 오디오를 끊기지 않고 담아내고, 화자를 구분하고, 15개 언어를 실시간으로 번역하고, 그 전부를 몇 달 뒤에도 검색되는 노트로 바꾸는 일이죠.
출처
- Qwen3.8-27B 모델 카드 및 벤치마크 표, 허깅페이스 — Opus 4.6 Max와의 정면 비교 수치, 2026년 8월 21일 조회
- Artificial Analysis: Qwen3.8 27B 지능·성능·가격 분석 — 인텔리전스 지수 52.0, 가격 및 출력량 수치, 2026년 8월 21일 조회
- Artificial Analysis: Claude Opus 4.6 모델 페이지 — 최고 추론 강도에서 인텔리전스 지수 44.9, 2026년 8월 21일 조회
- Epoch AI, "LLM inference prices have fallen rapidly but unequally across tasks", 2025년 3월 12일 — 성능 고정 가격 사다리와 연 9~900배 범위
- Llama 2: Open Foundation and Fine-Tuned Chat Models (arXiv:2307.09288), 2023년 7월 18일 — 표 4, Llama 2 70B 대 GPT-4
- TheBloke/Llama-2-70B-Chat-GGUF 파일 목록 — 41.4GB Q4_K_M 빌드, 2023년 9월 4일 공개
- unsloth/Qwen3.8-27B-GGUF 파일 목록 — 16.5GB 및 9.8GB 빌드, 다운로드 수 2026년 8월 21일 조회
- OpenRouter 모델 카탈로그 — Qwen3.8-27B, Claude Opus 4.6, Claude Opus 5의 토큰 단가, 2026년 8월 21일 조회
- Qwen3.8-27B 공개에 대한 해커뉴스 토론, 2026년 8월 14일 — 16GB 및 24GB 카드에서의 실사용 처리량 보고
- 미국 에너지정보청 Electric Power Monthly, 표 5.3 — 2026년 5월 가정용 평균 킬로와트시당 18.44센트
- Qwen3.8 오픈 웨이트 공개에 대한 이전 글과 더 넓은 오픈 웨이트 물결에 대한 글
- Cray Y-MP 사진의 위키미디어 공용 페이지
