중국의 3주 오픈 웨이트 질주: Kimi K3, Qwen3.8-Max, 그리고 이 흐름을 끝낼 수도 있는 반전
3주 사이 중국의 대표 AI 연구소들이 프론티어급 오픈 웨이트 모델을 공개하거나 예고했습니다 — Kimi K3, Qwen3.8-Max, 그리고 정식 출시에 이른 DeepSeek V4. 각 모델이 무엇인지, 무엇이 실제로 공개됐고 무엇이 아직 약속인지, 그리고 베이징이 왜 자신이 키운 흐름을 이제 규제하려 하는지를 쉬운 말로 풀어봅니다.
7월 16일부터 26일 사이, 중국의 대표 AI 연구소 세 곳이 프론티어급 오픈 모델을 나란히 내놓았습니다. Moonshot AI는 7월 16일 Kimi K3를 발표하고 7월 26일 가중치를 공개했습니다. 알리바바는 7월 19일 상하이 WAIC에서 Qwen3.8-Max를 선보였습니다. DeepSeek의 V4 라인은 7월 20일 무렵 정식 출시(GA)에 도달했습니다. 연구소 세 곳, 약 3주입니다.
패턴은 분명하고, 그것은 중국 오픈 모델 진영이 명성을 쌓아 온 방식과는 다릅니다. 이들 연구소는 작고 빠르고 저렴하면서도 체급 이상을 해내는 모델로 알려져 있었습니다. 이번 흐름은 정반대의 베팅입니다. 조 단위 파라미터 시스템을, 공개했거나 공개하겠다고 약속한 것입니다.
이 글은 그 흐름을 솔직하게 짚어 봅니다. 무엇이 실제로 공개됐고, 무엇이 아직 프리뷰나 약속에 머물러 있는지, 그리고 함께 찾아온 반전 — 이 공개를 가능하게 한 바로 그 정부가 이제 규제 여부를 저울질하고 있다는 사실입니다. 전문 용어는 최소로 줄이고 나머지는 그때그때 풀어 설명하겠습니다. "오픈 웨이트"나 "mixture-of-experts"가 처음이어도 이야기를 따라올 수 있도록 말이죠. 지난 7월 정리 글을 읽으셨다면, 이 글은 그 속편이며 당시 남겨 둔 떡밥 하나가 풀렸습니다.
Image: OLCF at ORNL, Wikimedia Commons, CC BY 2.0.
먼저, 이 이야기를 이해하게 해 줄 다섯 가지 개념
이 분야가 처음이라면, 다섯 개의 용어가 이야기의 대부분을 짊어집니다. 모델로 넘어가기 전에 쉬운 말로 잠깐 짚어 볼 가치가 있습니다.
"오픈 웨이트(open weights)"는 이번 흐름이 중요한 이유 그 자체입니다. 모델의 가중치란 학습 과정에서 습득한 거대한 숫자 격자, 사실상 완성된 두뇌입니다. 연구소가 가중치를 공개하면, 여러분은 그 파일을 내려받아 자기 하드웨어에서 모델을 돌리고, 손보고, 그 위에 제품을 만들 수 있습니다. 누구의 허락도, 요청당 비용도 필요 없이 말이죠. 반대편에는 폐쇄형 모델이 있습니다. 대부분의 상용 챗봇처럼 가중치는 벤더의 서버에 잠겨 있고, 여러분은 유료 API로 접근 권한을 빌립니다. 오픈 웨이트는 모델을 '빌려 쓰는 서비스'에서 '내가 사본을 소유한 것'으로 바꾸며, 좋은 모델이 나올 때 업계 전체가 주목하는 이유가 바로 이 차이입니다.
"파라미터(parameters)"란 바로 그 학습된 숫자들이며, 그 개수는 모델이 담아낼 수 있는 양을 가늠하는 대략적인 지표입니다. "2.8조 파라미터" 모델은 그 숫자가 2.8조 개라는 뜻입니다. 크다고 무조건 낫진 않지만, 프론티어에서는 대체로 추론할 여유가 더 많다는 뜻이고 — 그만큼 돌리는 데 더 많은 하드웨어가 든다는 뜻이기도 합니다. 여기서 "mixture-of-experts(MoE)"가 등장합니다. 단어 하나마다 모든 파라미터를 켜는 대신, MoE 모델은 전문가라 불리는 수많은 특화 하위망으로 나뉘고, 라우터가 토큰마다 그중 몇 개만 고릅니다. 그래서 "총 2.8조, 활성 1,040억"이라 적혀 있으면, 모델은 거대하지만 어느 순간에 실제로 일하는 파라미터는 약 1,040억 개뿐이라는 뜻입니다 — 수천 명의 전문의가 있지만 환자마다 관련된 몇 명만 진료하는 병원처럼요. 총합은 얼마나 유능할 수 있는지를 암시하고, 활성 수는 서빙 비용이 얼마나 드는지를 알려 줍니다. 이 둘의 차이가 비용을 판단하는 가장 쓸모 있는 숫자입니다.
"컨텍스트 창(context window)"은 모델이 한 번에 머릿속에 담아 둘 수 있는 텍스트의 양이며, 토큰 단위로 셉니다 — 토큰 하나는 대략 단어의 4분의 3쯤 됩니다. 100만 토큰 창은 추상적인 사양이 아닙니다. 긴 소설 여러 권, 혹은 한 시간짜리 회의 녹취록 수십 개를 한 번에 담는다는 뜻입니다. 이메일 한 통을 요약하는 것과, 한 분기치 이메일 전체를 놓고 추론하는 것의 차이죠.
마지막으로 라이선스입니다 — 그리고 이것이 실무자가 벤치마크보다 먼저 읽어야 할 부분입니다. 라이선스는 가중치로 무엇을 해도 되는지를 규정한 법적 세부 문구입니다. MIT는 최고의 표준입니다. 쓰고, 고치고, 상용 제품에 넣어 출시해도 아무 빚이 없습니다. 커스텀 라이선스는 열려 있어 보이면서도 정작 여러분이 노리던 바로 그 용도를 제외해 둘 수 있습니다 — 예컨대 그 위에 세운 사업이 커지면 비용을 물리는 식으로요. 두 모델이 똑같이 "오픈 웨이트"이면서도, 법적으로 무엇이 허용되는지는 하늘과 땅 차이일 수 있습니다. 그러니 점수에 반하기 전에 이 한 줄을 먼저 읽는 편이 이득입니다. 이 다섯 개념을 손에 쥐면 이번 흐름이 또렷하게 읽힙니다.
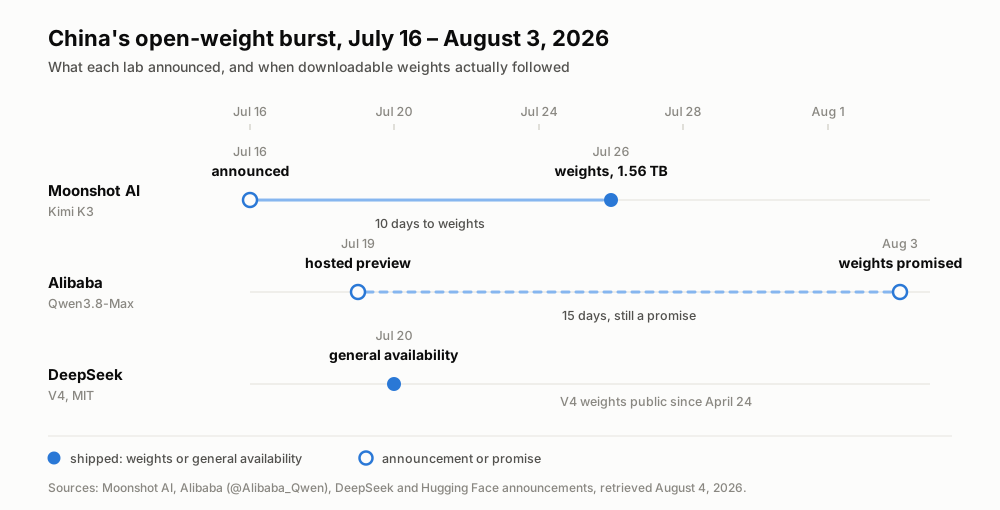
연구소 셋, 3주 — 그리고 이 다섯 순간 중 실제로 가중치를 손에 쥐여 준 것은 둘뿐입니다. 날짜는 각 연구소의 공식 발표 기준이며 2026년 8월 4일에 확인했습니다.
실제로 공개된 건 Kimi K3다
먼저 Moonshot AI부터 보겠습니다. Kimi 어시스턴트를 만든 베이징의 연구소로, 지난 한 해 동안 크고 유능한 오픈 모델로 명성을 쌓아 왔습니다. 7월에 Kimi K3를 다뤘을 때 가중치는 아직 약속에 불과했습니다. Moonshot은 "7월 27일까지"라고 했었죠. 그 가중치가 7월 26일에 도착했습니다. Hugging Face의 moonshotai/Kimi-K3에 96개 샤드로 나뉜 1.56테라바이트입니다. 이게 핵심 뉴스입니다. 발표는 보도자료이지만, 내려받을 수 있는 가중치는 그 위에 무언가를 지을 수 있는 사실입니다.
쉬운 말로 하면, K3는 지금까지 공개된 가장 큰 오픈 모델 중 하나입니다. 총 2.8조 파라미터에 토큰당 활성 파라미터는 약 1,040억 개인 mixture-of-experts 시스템으로, Moonshot이 Kimi Delta Attention이라 부르는 방식으로 896개 전문가 중 약 16개를 라우팅하고, 100만 토큰 컨텍스트 창을 지원하며, 이전 모델 K2 대비 약 2.5배의 스케일링 효율 향상이 보고됐습니다. 사양서를 걷어 내고 풀어 보면 이렇습니다. 매우 크지만, 토큰마다 일부만 켜지므로 규모에 비하면 비교적 저렴하게 돌릴 수 있고, 책 한 권 분량의 입력을 통째로 삼킬 수 있습니다.
이 숫자들은 실제로 누가 이걸 돌릴지도 알려 줍니다. 96개 샤드로 나뉜 1.56테라바이트는 노트북 다운로드가 아닙니다. 불러오는 것만으로도 고성능 가속기 클러스터가 필요한 데이터센터급 산물입니다. 현실적으로 개인이 K3를 직접 호스팅하는 경우는 거의 없고, 이미 하드웨어를 갖춘 제공업체를 통해 접근하게 됩니다. 그리고 그 시장은 첫날에 도착했습니다. Together AI와 Modal 모두 가중치가 떨어지자마자 Kimi K3 호스팅 엔드포인트를 띄웠습니다. 호기심 많은 독자가 오늘 이걸 써 보는 방법도 이것입니다 — 1.56TB를 내려받는 게 아니라, 그런 호스팅 엔드포인트를 호출하거나 Kimi 앱을 쓰는 것이죠. 여기서 "오픈"이란 가중치가 공개되어 하드웨어를 갖춘 누구나 서빙할 수 있다는 뜻이고, 바로 그 점이 가격 경쟁을 유지시킵니다. 여러분이 직접 책상 위에서 돌린다는 뜻은 아닙니다.
성능은 괜찮을까요? 이번에 우리가 신뢰하는 유일한 독립 수치로 보면, 네 그렇습니다. Artificial Analysis 순위에서 189개 모델 중 4위에 올랐습니다 — Claude Fable 5와 두 종의 GPT-5.6 "Sol" 구성 뒤, Opus 4.8과 GPT-5.5 앞입니다. 내려받을 수 있는 오픈 모델이 그런 자리에 있다는 것 자체가 이야기입니다.
그다음 라이선스를 읽으세요. 여기서 "오픈"에 별표가 붙기 때문입니다. Kimi K3는 MIT가 아닙니다. OSI 승인을 받지 않은 커스텀 "Kimi K3 License"로 배포되며, 매출 기준 조항이 붙어 있습니다. K3를 대규모 Model-as-a-Service 사업의 엔진으로 돌리려면 Moonshot과 별도 계약이 필요합니다. 1인 개발자나, 내부에서 쓰는 일반 기업에게는 달라지는 게 없습니다. 하지만 대규모 호스팅 제품을 만드는 쪽이라면 "오픈 가중치"와 "오픈 라이선스"는 서로 다른 두 질문이며, 여기서 분명히 "예"인 것은 앞쪽뿐입니다.
Qwen3.8-Max는 다운로드가 아니라 프리뷰다
Qwen은 알리바바의 모델 제품군으로, 그 팀은 세계에서 오픈 모델을 가장 많이 내놓은 축에 듭니다 — 바로 그 이력 때문에 이번 신작이 헷갈립니다. 7월 19일 상하이 WAIC에서 발표된 Qwen3.8-Max는 이번 흐름에서 가장 큰 헤드라인이자 가장 무른 헤드라인입니다. 2.4조 파라미터의 희소(sparse) MoE이며 — 활성 파라미터는 비공개 — 텍스트뿐 아니라 이미지·영상·문서를 입력으로 받는, 1조 파라미터를 넘긴 첫 멀티모달 Qwen입니다.
초보자에게 분명히 짚어 줘야 할 함정은 이것입니다. 요란한 발표에도 불구하고, 여러분은 이걸 내려받을 수 없습니다. 지금은 "호스팅 프리뷰"로만 존재합니다 — qwen3.8-max-preview로, 알리바바 자체 서비스(Token Plan과 Qoder 도구)를 통해 표준 대비 약 10% 가격에 접근할 수 있습니다. 호스팅 프리뷰란 알리바바가 자사 서버에서 모델을 돌리고 여러분이 호출하게 해 준다는 뜻입니다. '빌려 쓰는 API' 모델이지, '사본을 소유하는' 모델이 아닙니다. 오늘 이걸 오픈 웨이트 공개라 부르는 건 성급합니다.
이 구도는 8월 3일에 바뀌었습니다. Qwen의 공식 X 계정 @Alibaba_Qwen이, Qwen3.8-Max의 오픈 가중치가 "다음 주"에 공개되며 — 더 작은 Qwen3.8-27B도 함께 오픈 웨이트로 나온다고 게시했습니다. 그러니 27B는 소문이 아닙니다. 앞선 잡음이 무엇이었든, 이것은 알리바바 자사 계정이 공식적으로 내놓은 약속입니다. 그리고 크기가 핵심입니다. 2.4조 파라미터의 Max는 K3처럼 데이터센터만 돌릴 수 있는 물건인 반면, 27B는 고성능 머신 한 대로 서빙할 만큼 작습니다 — 개인이나 소규모 팀이 실제로 직접 호스팅할 수 있는 체급이죠. 이는 "구체적인 내용 없이 약속만 했다"는 그림을 실제로 누그러뜨립니다. 이제 크기도 있고, 대략적인 시점도 있습니다.
다만 솔직한 단서들은 여전히 유효합니다. "다음 주"는 방향이지 출시 날짜가 아니며, 이 글을 쓰는 8월 4일 현재 Qwen의 Hugging Face 조직에는 아무것도 올라오지 않았습니다 — 그곳의 최신 모델은 6월 것입니다. 오픈 웨이트 라이선스도 아직 공개되지 않았고, 프리뷰 약관을 먼저 읽은 이들은 지역 제한이 있을 수 있다고 지적했습니다. 실제 라이선스가 나오기 전까지는 확인되지 않은 이야기입니다 — 바로 앞의 라이선스 우선 교훈 그대로죠. 이 모델이 "Fable 5에 이어 2위"라는 알리바바의 주장 역시 여전히 제3자 수치가 없는 자체 보고이니, 알리바바 밖의 누군가가 측정하기 전까지는 벤더의 마케팅 문구로 받아들이는 편이 좋습니다. 오늘 이 모델을 써 보고 싶다면 호스팅 프리뷰가 유일한 문입니다 — 하지만 처음으로, 내려받을 수 있는 가중치를 기다리는 시간이 "언젠가"가 아니라 "다음 주"로 측정됩니다.
DeepSeek V4는 조용히 정식 출시에 도달했다
DeepSeek은 2025년 초 현재의 오픈 모델 경쟁에 불을 지핀 R1 모델을 만든 연구소이며, 그 성향대로 이번에도 가장 적게 알리면서 가장 쓸 만한 것을 내놓았습니다. 4월 24일에 공개된 V4 라인은 가장 무리 없이 채택할 수 있는 모델입니다. 앞서 기초 설명에서 최고의 표준이라 꼽은 바로 그 라이선스를 달고 나오기 때문이죠.
V4는 두 가지 크기로 나오며, 둘 다 MIT입니다. V4-Pro는 총 1.6조·활성 490억 파라미터의 플래그십이고, V4-Flash는 총 2,840억·활성 130억 파라미터의 경량 모델입니다. 활성 수가 무엇을 뜻하는지 떠올려 보세요. V4-Flash는 토큰당 130억 파라미터만 켜므로 서빙이 저렴하고 빠릅니다. 그리고 그 점이 대량 처리 작업 — 토큰당 비용이 모든 것을 좌우하는 대규모 전사·요약 부하 — 에 알맞은 가성비 선택지로 만듭니다. 둘 다 100만 토큰 컨텍스트 창을 갖추고, 한 번의 응답에서 최대 384K 토큰까지 출력할 수 있습니다. 한 문단이 아니라 긴 보고서를 초안 잡을 만한 분량이죠. 7월 20일 무렵 V4는 시간 기반 가격제로 정식 출시에 도달했고, 봄에 나온 릴리스를 K3·Qwen과 같은 3주 프레임 안으로 끌어들인 게 바로 이 지점입니다.
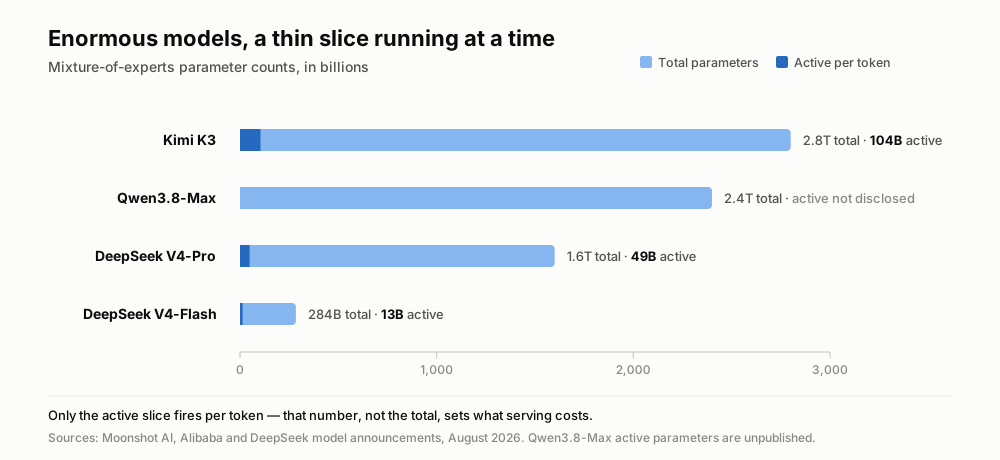
옅은 막대는 모델의 크기이고, 짙은 토막은 토큰마다 실제로 켜지는 양입니다. 알리바바는 Qwen3.8-Max의 활성 파라미터를 공개하지 않았습니다.
MIT이기에 V4는 변호사가 가장 적게 필요한 모델입니다. 가중치를 받아(또는 호스팅 제공업체를 이용해) 돌리고, 상용으로 출시하고, 아무 빚 없이 누구에게도 묻지 않아도 됩니다. 그리고 버전 번호를 두고 분명히 해 두자면 — 소문은 이런 걸 좋아하니까요 — R2도, V5도, V4.1도 없습니다. 그저 V4 계열이 팀이 믿고 쓸 수 있는 무언가로 무르익었을 뿐입니다.
격차는 리더보드가 인정하는 것보다 빠르게 좁혀지고 있다
한 걸음 물러서면, 개별 공개보다 기울기가 더 중요합니다. Nathan Lambert의 진단은, 최고의 오픈 모델과 최고의 폐쇄 모델 사이 거리가 약 69개월에서 35개월로 좁혀졌다는 것입니다 — "DeepSeek R1 이후 오픈 모델이 프론티어에 가장 가까이 다가선 시점"입니다. 쉽게 말하면, 무료로 내려받을 수 있는 모델이 이제 돈으로 빌릴 수 있는 최고의 모델에 겨우 몇 달 뒤처져 있다는 뜻입니다. 1년 전에는 한 바퀴쯤 여유 있게 뒤처져 있었죠.
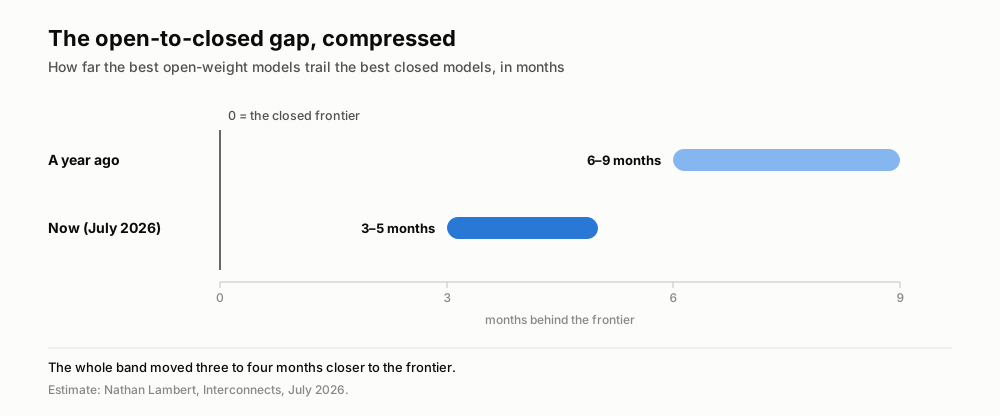
Lambert의 추정을 실제 눈금으로 그린 것입니다. 오픈 진영은 가까워지기만 한 게 아니라, 구간 자체가 좁아졌습니다.
사용 데이터도 같은 방향을 가리킵니다. 여러 모델로 요청을 분배하는 마켓플레이스인 OpenRouter에서, 미국 출신 모델의 토큰 점유율은 2025년 6월 약 70%에서 1년 뒤 약 30%로 떨어졌고, 중국 출신 모델은 이제 정기적으로 30%를 넘깁니다. 가격이 큰 이유입니다. 중국 오픈 모델은 토큰당 60~90% 저렴한 경향이 있고, 호스팅도 곧바로 등장했습니다. 첫날에 뜬 K3 엔드포인트가 이를 분명히 보여 줬죠.
더 조용한 변화는 규모에 관한 것입니다. 중국 오픈 모델의 브랜드는 작고 빠르고 저렴함이었습니다. 2.8조 파라미터의 K3와 2.4조 파라미터의 Qwen3.8-Max는 정확히 그 반대입니다 — 이제 오픈으로 크게 가는 것이 해볼 만하다는 베팅이죠. 6월 16일 MIT로 공개돼 Artificial Analysis Index에서 51점으로 오픈 웨이트 부문 정상에 오른 Z.ai의 GLM-5.2도, 네 번째 연구소가 던지는 같은 메시지입니다.
반전: 이 흐름을 가능하게 한 정부가 이제 규제하려 한다
그리고 국면이 바뀌었습니다. 7월 22~25일 무렵, Financial Times와 Reuters는 중국 상무부가 오픈 웨이트 LLM을 포함한 AI 모델에 대한 수출 통제를 저울질하고 있다고 보도했습니다 — 알리바바, ByteDance, Z.ai가 논의에 포함된 것으로 전해집니다. 거론되는 틀은 계층형입니다. 약한 모델은 신고 의무, 강한 모델은 보안 심사, 가장 강력한 모델은 공개 배포 자체를 금지할 가능성입니다. 아직 법제화된 것은 없습니다. 하지만 방향은 인상적입니다. 이 흐름은, 자신을 낳은 정부가 이 모델들을 오픈 기여가 아니라 전략 수출품으로 다루기 시작하는 바로 그 순간에 정점을 찍고 있는지도 모릅니다.
마치며: 열린 것이 전략 자산이 되기까지
깔끔한 이야기는 "중국이 따라잡았다"입니다. 더 정확한 이야기는, 오픈 가중치가 전략 자산이 되는 속도가 너무 빨라서 이제 정부가 그 수도꼭지에 손을 얹으려 한다는 것입니다. 3주 사이에 오픈 모델은 프론티어에 두세 분기 뒤처진 상태에서 한 분기 뒤로 좁혔고 — 작고 저렴하던 것에서, 어떤 형태로든 공개된 가장 큰 축의 모델로 바뀌었습니다. 오픈 프론티어는 단지 이동한 게 아닙니다. 그 제작자들이 계속 내보낼 수 있으리라 장담하기 어려운 곳으로 이동했습니다.
이 모델들 위에 무언가를 만드는 팀에게 실질적인 결론은 그대로이되 조금 더 날카로워졌습니다. Telli.sh는 이미 요약 레이어에 오픈 모델 Qwen3를 사용하고 있어서, 오픈 모델의 품질과 가격이 좋아질 때마다 그 이득이 회의 전사·번역·요약으로 곧장 흘러듭니다. 새로 생긴 항목은 공급입니다. 보도된 대로 중국의 수출 규정이 자리 잡는다면, 어떤 오픈 모델이 계속 자유롭게 내려받을 수 있는지는 당연하게 여길 게 아니라 지켜봐야 할 문제입니다. 레이어를 떠받치는 모델이 좋아지는 것은 흐름이고, 그 모델이 어디에서 나올 수 있는지는 눈여겨볼 지점입니다.
출처
- Simon Willison on Kimi K3 weights (July 27, 2026)
- Nathan Lambert, "Kimi K3: the open-weights escalation" (Interconnects, July 20, 2026)
- Kimi K3 announcement (Moonshot AI)
- Kimi K3 weights on Hugging Face
- Artificial Analysis on Kimi K3
- Qwen (@Alibaba_Qwen), Qwen3.8-Max & Qwen3.8-27B open-weights announcement on X (Aug 3, 2026)
- Latent Space / AINews, "Qwen 3.8 Max (2.4T) and 27B, new open weights models" (Aug 4, 2026)
- WinBuzzer on DeepSeek V4 (April 27, 2026)
- The Decoder on Chinese open-model adoption
- Tom's Hardware on China's proposed AI export controls (July 2026)
- Wikimedia Commons image page
