Qwen3.8-27B 오픈 웨이트: 용량, Q4_K_M, 4090·맥 실측 속도
Qwen3.8-27B는 Apache 2.0입니다. Q4_K_M GGUF는 17.1GB로 32GB 노트북에 들어가고, FP8은 30.9GB입니다. 실측은 RTX 4090에서 초당 48토큰, 맥 미니 M4 Pro에서 12.75토큰.
8월 3일, 알리바바의 Qwen 계정은 오픈 웨이트가 "다음 주"에 나온다고 했습니다. AI 업계가 지난 몇 년간 사람들에게 할인해서 듣도록 훈련시켜 온 종류의 문장이죠. 그런데 12일 뒤, 할인할 것이 하나도 남지 않았습니다. 2.4조 파라미터 Qwen3.8-Max 가중치가 8월 12일 허깅페이스에 올라왔고, 작은 쪽인 Qwen3.8-27B는 평범한 Apache 2.0 라이선스를 달고 8월 14일에 뒤따랐습니다.
그리고 진짜 흥미로운 일이 벌어졌습니다. Qwen이 27B의 모델 카드 작성을 마친 바로 그 시간 안에, 세 개의 커뮤니티 그룹이 이미 이 모델을 개인용 컴퓨터에서 돌릴 수 있는 형식으로 변환해 놓았습니다. 그로부터 이틀 뒤, 그 변환본들의 다운로드 수는 100만 건을 넘었습니다.
이야기의 핵심은 벤치마크 표가 아니라 이 숫자입니다. 세계 최상위권 AI 연구소의 270억 파라미터 모델이 "발표됨"에서 "백만 대쯤 되는 책상 위에서 돌아가는 중"까지 가는 데 대략 48시간이 걸렸습니다. 이 글은 그게 실제로 무슨 뜻인지 쉬운 말로 정리한 안내서입니다. 무엇이 어떤 라이선스로 공개됐는지, 이미 가지고 있는 하드웨어로 27B를 돌리려면 무엇이 필요한지, 3년 사이에 얼마나 멀리 왔는지, 그리고 대부분의 기사가 건너뛰는 부분 — 로컬 27B가 여전히 하지 못하는 일은 무엇인지.
한눈에 보기
- 약속은 지켜졌습니다. Qwen3.8-Max(총 2.4조 / 활성 950억)는 8월 12일에, Qwen3.8-27B는 8월 14일에 도착했습니다. 둘 다 호스팅 프리뷰가 아니라 진짜 내려받을 수 있는 가중치입니다.
- 라이선스가 서로 다르고, 그 차이가 점수보다 중요합니다. 27B는 Apache 2.0입니다. 기준선도, 조항도 없이 상업적으로 쓰고 아무것도 갚지 않아도 됩니다. Qwen3.8-Max는 모델 서비스 사업에 매출 트리거가 걸린 자체 라이선스로 나왔습니다.
- 누가 무엇을 돌릴 수 있는지는 결국 크기가 정합니다. Max는 4,892GB 다운로드이고, 4비트로 압축한 27B는 17.1GB로 32GB 머신에도 들어갑니다. 커뮤니티 4비트 빌드는 이틀 만에 107만 다운로드를 넘겼습니다.
이미지: Dejan Krsmanovic, Wikimedia Commons, CC BY 2.0. 프런티어 연구소의 모델을 직접 돌린다는 건, 그 기계와 유지보수까지 내 것이 된다는 뜻입니다.
약속에는 날짜가 붙어 있었고, 그 날짜는 지켜졌다
8월 4일 우리는 그 발표 자체를 다루면서 기다림이 "언젠가"가 아니라 "다음 주" 단위로 측정된다고 썼습니다. 당시 증거로 갈 수 있는 최대치였죠. 결말은 깔끔했습니다.
Qwen3.8-Max로 마케팅된 Qwen3.8-2.4T-A95B는 8월 12일 라이선스 파일과 함께 올라왔습니다. Qwen3.8-27B와 효율을 높인 FP8 버전은 8월 14일에 도착했습니다. 두 날짜 모두 "다음 주"가 가리킨 구간 안에 있습니다. 발표된 모델이 끝내 나오지 않는 일이 흔한 업계에서, 아홉 날 전에 말로 한 마감을 지킨 것만으로도 눈여겨볼 만합니다.
반응은 즉각적이었고 컸습니다. 27B에 대한 해커뉴스 스레드는 하루 만에 1,351점과 769개의 댓글을 모았습니다. 몇 시간 안에 실무자들이 특정 하드웨어용으로 작동하는 서빙 설정을 올리기 시작했고, 어떤 사람은 엔비디아 DGX Spark와 소비자용 RTX 4090 그래픽카드 양쪽 설정을 공유했습니다. 새 아키텍처를 돌아가게 만드는 것 자체가 주말 프로젝트였던 2년 전의 오픈 모델 출시 풍경과는 다릅니다.
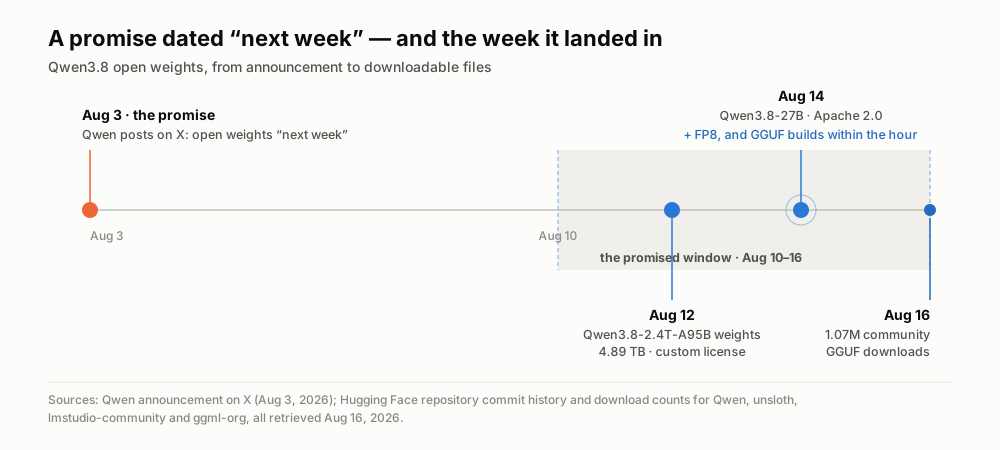
날짜가 붙은 약속, 그리고 그 안에 들어온 두 번의 공개. 날짜는 허깅페이스 저장소 커밋 기록에서 2026년 8월 16일 확인.
"내가 돌릴 수 있나?"라는 질문에 맞춘 다섯 개의 용어
이전 글에서 넘어오셨다면 오픈 웨이트가 무엇인지는 이미 아실 겁니다. 연구소가 완성된 모델을 이루는 거대한 학습 숫자 격자를 공개하고, 우리는 그걸 내려받아 내 하드웨어에서 돌리고, 요청마다 돈을 내지 않고 그 위에 무언가를 만들 수 있죠. 여기서 중요한 건 그다음 질문, 전적으로 실용적인 질문입니다. 실제로 돌리는 데 하드웨어가 얼마나 드는가?
파라미터는 그 학습된 숫자들이고, 개수가 모델의 순수한 크기를 정합니다. 어림셈은 잔인할 만큼 단순합니다. 연구소가 학습에 쓰는 정밀도에서는 파라미터 10억 개당 디스크 약 2GB이고, 돌리는 동안 모델을 담아둘 메모리도 대략 그만큼 필요합니다. 그러니 270억 파라미터 모델은 55GB짜리 다운로드입니다. 2.4조 파라미터짜리는 5테라바이트에 가깝고요. 한쪽이 노트북 문제이고 다른 쪽이 데이터센터 문제인 이유가 여기 있습니다.
양자화는 그 간극을 메우는 방법이고, 집에서 모델을 돌리려는 사람에게 가장 쓸모 있는 개념입니다. 파라미터는 보통 16비트 정밀도로 저장됩니다. 양자화는 이를 더 적은 비트(8비트, 4비트, 때로는 2비트)로 반올림하고, 파일 크기는 거의 그 비율만큼 줄어듭니다. 4비트 양자화는 그 55GB 다운로드를 약 17GB로 만듭니다. 정확도를 조금 잃고, 아예 돌릴 수 있는 능력을 얻는 거래죠. GGUF는 이렇게 압축된 버전이 담기는 파일 형식일 뿐입니다. llama.cpp, Ollama, LM Studio 같은 도구가 읽는 형식이죠. "Q4_K_M"이라는 표기를 보면 "대부분이 쓰는 4비트 빌드"라고 읽으시면 됩니다.
밀집 모델과 전문가 혼합의 차이는 일단 들어간 다음의 속도를 결정합니다. Qwen3.8-27B는 밀집 모델입니다. 단어 하나를 만들 때마다 270억 파라미터 전부가 작동합니다. Qwen3.8-Max는 전문가 혼합 모델입니다. 총 2.4조 파라미터지만, 라우터가 512개의 전문 하위 네트워크 가운데 토큰당 약 950억 개어치만 골라 씁니다. 총량은 저장 비용을, 활성 개수는 연산 비용을 알려줍니다. 이 구분에는 날카로운 실무적 함의가 있는데, 뒤에서 다시 다루겠습니다.
컨텍스트 윈도는 모델이 한 번에 고려할 수 있는 분량입니다. 27B는 262,144토큰을 기본으로 다룹니다. 한 시간짜리 회의록 여러 편을 쌓아 놓은 정도이고, 설정을 바꾸면 100만까지 늘릴 수 있습니다.
라이선스부터 읽어야 한다
여기가 이 글에서 가장 무게가 실리는 발견입니다. 같은 계열의 모델이면 같은 계열의 조건을 공유하리라는 가정을 정면으로 거스릅니다.
Qwen3.8-27B는 Apache 2.0입니다. 스펙트럼에서 가장 허용적인 쪽이죠. 쓰고, 고치고, 파인튜닝하고, 상업 제품에 넣어 출시하고, 그 위에 사업을 세워도 아무것도 갚지 않고 누구에게도 묻지 않아도 됩니다. 매출 기준선도, 화면에 이름을 표시하라는 요구도, 용도 제한도 없습니다.
Qwen3.8-Max는 다릅니다. MIT처럼 시작해서 두 가지 조건을 붙이는 자체 "Qwen3.8-Max 라이선스"로 나왔습니다. 제품이 월간 활성 사용자 1억 명 또는 월 매출 2,000만 달러를 넘으면 인터페이스에 모델 이름을 표시해야 합니다. 그리고 모델 서비스나 AI 업무 비서 사업을 하면서 12개월 매출이 5,000만 달러를 넘으면, 상업적으로 쓰기 전에 Qwen과 별도 계약을 맺어야 합니다.
1인 개발자나 사내에서만 쓰는 회사라면 어느 쪽도 걸리지 않습니다. 하지만 이건 Kimi K3가 MIT 대신 자체 라이선스로 나왔을 때 우리가 짚었던 것과 같은 단서 조항이고, 교훈도 반복됩니다. "오픈 웨이트"와 "오픈 라이선스"는 별개의 질문이고, 한 연구소가 이틀 간격으로 낸 두 모델에 서로 다르게 답할 수 있습니다. 점수에 반하기 전에 라이선스를 읽으세요.
| 모델 | 총 파라미터 | 토큰당 활성 | 다운로드 크기 | 라이선스 | 현실적인 실행 환경 |
|---|---|---|---|---|---|
| Qwen3.8-Max (2.4T-A95B) | 2.4조 | 950억 | 4,892GB | 자체, 매출 트리거 | 가속기 클러스터 |
| Qwen3.8-Max, FP8 | 2.4조 | 950억 | 2,496GB | 자체, 매출 트리거 | 가속기 클러스터 |
| Qwen3.8-27B | 270억, 밀집 | 270억 | 55.6GB | Apache 2.0 | 다중 GPU 워크스테이션 |
| Qwen3.8-27B, FP8 | 270억, 밀집 | 270억 | 30.9GB | Apache 2.0 | 고사양 GPU 한 장 |
| Qwen3.8-27B, Q4_K_M GGUF | 270억, 밀집 | 270억 | 17.1GB | Apache 2.0 | 32GB 노트북이나 4090 |
27B를 돌리는 데 실제로 드는 것
솔직한 답은 이렇습니다. 생각보다는 적게 들고, 헤드라인이 암시하는 것보다는 많이 듭니다.
가장 낮은 문턱은 명령어 하나입니다. 27B는 Ollama 라이브러리에 있고, ollama run qwen3.8을 치면 256K 컨텍스트 윈도와 이미지 입력을 갖춘 18GB 빌드를 받아옵니다. 애플 실리콘용을 포함해 열두 가지 변형이 있습니다. 터미널 대신 채팅 창을 주는 LM Studio도 공개 몇 분 만에 빌드를 올렸습니다. 둘 다 앞 절의 내용을 이해하라고 요구하지 않습니다.
그다음에는 초당 토큰 수라는 형태로 현실이 끼어듭니다. 출시 스레드에 올라온 실무자들의 측정치는 대체로 하드웨어가 예측하는 지점에 떨어졌습니다. RTX 4090에서 4비트 빌드를 돌린 한 사람은 초당 약 48토큰을 기록했습니다. 사람이 읽는 속도보다 넉넉히 빠릅니다. 메모리 64GB의 맥 미니 M4 Pro에서는 초당 12.75토큰이 나왔습니다. 쓸 만하지만 타이핑되는 걸 지켜보게 되는 속도죠. 그리고 AMD 7840U와 평범한 DDR5 64GB를 단 노트북에서는 같은 4비트 빌드가 초당 약 4토큰을 냈습니다. 기술적으로는 돌아가고, 실질적으로는 걸어두고 자리를 뜨는 배치 작업입니다.
마지막 숫자가 바로 밀집과 전문가 혼합의 차이가 값을 하는 지점입니다. 같은 사람이 같은 노트북에서 명목상 더 큰 구형 전문가 혼합 모델을 재보니 초당 약 20토큰이 나왔습니다. 더 작은 밀집 모델보다 다섯 배 빠릅니다. 단어마다 파라미터의 일부만 작동하기 때문입니다. CPU에서 돌릴 물건을 고르는 중이라면, 장바구니 기준은 총 파라미터가 아니라 활성 파라미터여야 합니다. 로컬 AI에서 가장 직관에 어긋나면서 가장 쓸모 있는 교훈입니다.
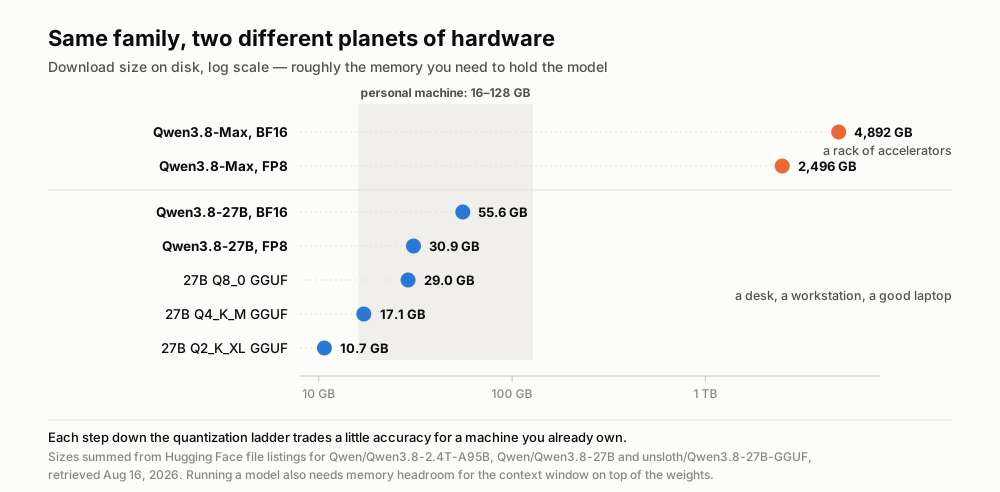
같은 모델 계열의 두 구성원, 다운로드 크기는 290배 차이. 허깅페이스 파일 목록에서 합산, 2026년 8월 16일 확인.
3년 전에는 유출과 주말 하나가 필요했다
이 도약의 크기를 보려면, 로컬 모델이 어디서 출발했는지와 나란히 놓아야 합니다.
2023년 2월, 메타는 원조 LLaMA 가중치를 승인된 연구자에게만 공개했습니다. 그 파일은 일주일쯤 만에 유출됐고, 취미 수준의 로컬 모델 씬 전체가 사람들이 가지고 있으면 안 되는 파일 위에 세워졌습니다. 2023년 3월 10일, 한 개발자가 llama.cpp를 공개했습니다. 70억 파라미터 모델을 맥북에서 돌리는 게 장기인 작은 C++ 프로그램이었죠. 그 저장소는 지금 12만 4천 개의 별을 달고 있고, 오늘날 쓰이는 사실상 모든 "로컬로 돌리기" 도구의 조상입니다.
두 출시일을 비교해 봅시다. 2023년에는 유출된 7B, 이름값 하는 라이선스 없음, 돌아가게 만드는 데 커뮤니티의 일주일, 그리고 유용하다기보다 흥미로운 모델. 2026년에는 프런티어 연구소의 27B가 의도적으로 Apache 2.0으로 공개됐고, 이미지와 비디오 입력에 262K 컨텍스트 윈도를 갖췄으며, 커뮤니티 빌드는 연구소 자신의 문서가 아직 바뀌는 중일 때 이미 끝나 있었습니다. unsloth 변환본의 첫 커밋은 8월 14일 협정 세계시 14시 56분에 올라왔습니다. Qwen이 모델 카드를 마지막으로 고치기 4분 전입니다.
채택 숫자는 같은 이야기를 더 무뚝뚝하게 합니다. 8월 16일 기준으로 27B의 커뮤니티 4비트 빌드는 한 배포자에게서 867,963회, 두 번째에게서 171,518회, 세 번째에게서 34,520회 내려받혔습니다. 이틀 만에 107만 회입니다. Qwen 자신의 공식 27B 저장소가 21만 5천 회를 더합니다. 훨씬 더 유능한 모델인 Qwen3.8-Max는 두 저장소를 합쳐 17,126회에 머물러 있습니다.
이 비율을 다시 읽어 보세요. 프런티어급 모델은 노트북급 모델이 받은 관심의 약 1.6%를 받았습니다. 시장이 나가서 가져온 것은 성능이 아닙니다. 도달 범위입니다.
로컬 27B가 여전히 하지 못하는 것
이제 교정할 차례입니다. 열광이 증거를 앞지르는 방식은 늘 예측 가능하니까요.
알리바바 자체 벤치마크 표에서 27B는 여러 에이전트 코딩·지시 이행 지표에서 Opus 4.6 Max를 앞섭니다. SWE-bench Pro에서 61.7 대 53.4, IFBench에서 79.5 대 62.5. 반면 다른 지표에서는 집니다. 폭넓은 지식을 묻는 HLE에서는 30.8 대 40.0입니다. 이 숫자들은 전부 공급사가 스스로 보고한 값입니다. 이 글을 쓰는 시점에 우리가 신뢰하는 독립 평가 기관 Artificial Analysis에는 27B 항목이 아예 없습니다. Qwen3.8-Max는 188개 모델 중 10위, 지능 점수 58로 올라 있는데, 훌륭한 성적이고 동시에 다른 모델입니다.
실무자들은 스프레드시트보다 날카로웠습니다. 출시 스레드에서 가장 많은 추천을 받은 반론은 오래된 오픈 모델 사용자를 자처하는 사람이 쓴 것으로, 단호했습니다. 이 모델들은 실제 사용에서 최상위 호스팅 모델을 이기지 못하고, 여러 작업에 "충분히 좋으며" 감당할 만한 하드웨어에서 돌아간다는 것이었습니다. 다르고 더 겸손한 주장이죠. 다른 댓글은 천장을 물리적인 언어로 표현했습니다. 인간 지식 전체를 30GB 파일에 압축해 넣을 수는 없으니, 작은 모델은 코딩이나 도구 사용이 아무리 날카로워져도 잘 알려지지 않은 사실을 기억해 내는 일에서는 상대적으로 약하게 남는다는 것입니다.
직접 돌려 봐야 드러나는 한계가 둘 더 있습니다. 양자화는 공짜가 아닙니다. 심하게 압축한 모델은 긴 컨텍스트에서 맥락을 놓치고 같은 말을 반복하는 루프에 빠지기 쉽습니다. 메모리가 남는 사람에게 전체 정밀도 버전을 권하는 이유죠. 그리고 이번 세대 Qwen은 기본값에서 깊게 생각합니다. 어떤 사용자는 64GB 맥 미니에서 27B에 "svg owl"이라는 두 단어를 던졌다가, 답이 나오기까지 17분 12초 동안 21,769토큰의 추론이 생성되는 것을 지켜봤습니다. 결과물인 올빼미는 훌륭했습니다. 동시에 어떤 호스팅 API도 청구하지 않았을 벽시계 시간 청구서도 나왔습니다.
그리고 아무도 세지 않는 항목이 있습니다. 이제 운영이 내 몫입니다. 모델 업데이트, 양자화 선택, 메모리 여유, 드라이버 버전, 기계의 팬 소리까지. 피하려던 그 호스팅 API는 무언가를 계속 돌아가게 만드는 사람들의 팀이기도 했습니다.
결론: 해자는 스택 아래로 내려갔다
핵심은 이것이고, 출시 하나보다 큽니다.
프런티어 연구소가 목요일에 유능한 27B를 공개했습니다. 토요일이 되자 커뮤니티가 압축한 버전 100만 부 이상이 사람들의 기계에 올라가 있었고, Ollama에서 명령어 하나 거리였으며, 그 위에 사업을 세워도 법적으로 자유로웠습니다. 그 모델이 대표하는 우위가 무엇이든, 모든 경쟁자에게 동시에 열리기까지 대략 이틀이 걸렸습니다. 이걸 이틀짜리 해자라고 부릅시다. 모델 우위의 반감기가 이제 48시간쯤이라는 뜻입니다.
이건 예측이 아닙니다. 이번 주에, 이번 출시에서 잰 측정값입니다.
그리고 이것은 AI 제품을 만든다는 게 무슨 뜻인지를 다시 정의합니다. 모델 계층이 누구나 하루 오후면 갈아 끼울 수 있는 범용재가 되면, 모델은 더 이상 경쟁의 지점이 아닙니다. 살아남는 건 그 주위를 감싼 전부입니다. 새벽 세 시에 추론 서버가 넘어질 때의 안정성, 올바른 맥락을 붙잡고 정리하고 다시 꺼내 오는 데이터 파이프라인, 벤치마크의 데이터가 아니라 내 데이터에서 작동하는지 알려주는 평가, 사람이 실제로 쓸 인터페이스, 그리고 애초에 누가 회의 녹음을 맡길지를 결정하는 신뢰 장치 — 프라이버시, 보관 기간, 누가 무엇을 볼 수 있는지.
이 중 어느 것도 이틀 만에 범용재가 되지 않습니다. 어느 것에도 다운로드 버튼이 없습니다.
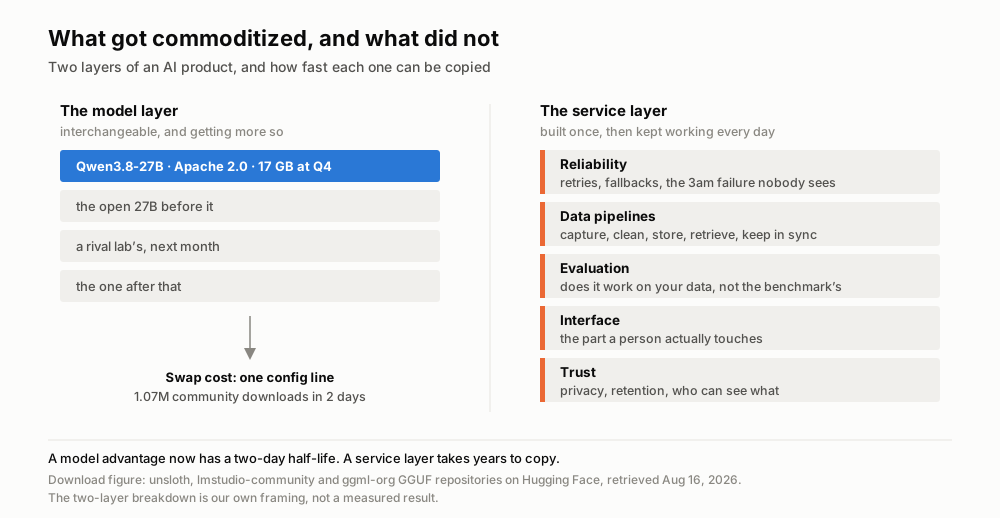
이번 주에 싸진 계층과, 싸지지 않은 계층. 다운로드 수치는 허깅페이스에서 2026년 8월 16일 확인. 두 계층 구분은 우리의 관점입니다.
그러니 훌륭한 오픈 모델이 노트북에 도착한 데 대한 올바른 반응은 "모델 회사가 이겼다"도 "제품 회사가 졌다"도 아닙니다. 흥미로운 작업이 스택에서 한 층 아래로 내려갔다는 것입니다. 훨씬 베끼기 어렵고, 훨씬 기사 쓰기 재미없는 곳으로요.
Telli.sh는 여기에 있습니다. 우리는 바로 그 서비스 계층을, 오픈 모델 위에 만듭니다. Telli.sh는 이미 요약 경로에 오픈 Qwen 모델을 쓰고 있습니다. 오픈 모델 품질이 도약할 때마다 — 이번 것을 포함해 — 그 이득이 회의 전사, 번역, 요약으로 곧장 흘러들고 여러분 쪽 가격은 그대로라는 뜻입니다. 우리가 시간을 쓰는 곳은 GGUF 파일로 도착하지 않는 부분입니다. 오디오를 안정적으로 담아내고, 화자를 헷갈리지 않고, 60분짜리 녹음을 몇 달 뒤에도 검색할 수 있는 노트로 바꾸고, 여러분의 데이터가 어디에 있는지 분명히 밝히는 일입니다.
출처
- Qwen3.8-27B 모델 카드 및 라이선스, 허깅페이스
- Qwen3.8-2.4T-A95B 모델 카드 및 라이선스, 허깅페이스
- unsloth/Qwen3.8-27B-GGUF 양자화 빌드 및 다운로드 수
- Ollama 모델 라이브러리의 Qwen3.8
- Qwen3.8-27B 출시에 대한 해커뉴스 토론 (2026년 8월 14일)
- Artificial Analysis의 Qwen3.8 Max 모델 페이지
- Qwen(@Alibaba_Qwen)의 오픈 웨이트 발표, X (2026년 8월 3일)
- llama.cpp 저장소, 2023년 3월 10일 생성
- Wikimedia Commons 이미지 페이지
