Un archivo de 16,5 GB ya supera al mejor modelo cerrado de febrero
Hace tres años, el mejor modelo descargable perdía por 37 puntos frente a GPT-4 en HumanEval y necesitaba dos tarjetas gráficas. La semana pasada un modelo abierto de 27B obtuvo 52,0 en el índice de inteligencia de Artificial Analysis frente a los 44,9 de Claude Opus 4.6 Max, a una novena parte del precio y desde un archivo de 16,5 GB. Un antes y después con las tablas de benchmarks, la curva de precios y qué significa que el desfase de alcance haya bajado a 162 días.
Alguien en Hacker News está ejecutando un modelo de lenguaje de primera línea en una tarjeta gráfica de 16 GB, a 50 o 60 tokens por segundo y con una ventana de contexto de 128.000 tokens. El modelo es Qwen3.8-27B, publicado el 14 de agosto de 2026. En el índice de inteligencia de Artificial Analysis obtiene 52,0, por encima de Claude Opus 4.6 Max, que hasta febrero era el mejor modelo propietario del mercado y se queda en 44,9.
En 2023 esa frase habría sido ciencia ficción, y no de la divertida.
Este artículo es el antes y el después. No la cobertura del lanzamiento — esa ya la escribimos —, sino la comparación a tres años vista: qué puntuaba el mejor modelo descargable frente a la frontera entonces y ahora, cuánto costaba comprar un determinado nivel de inteligencia entonces y ahora, y qué hardware había que tener para ejecutarlo uno mismo. Cada cifra de abajo lleva fuente y fecha. La tendencia que dibujan es de lo más genuinamente optimista que está ocurriendo hoy en el software.
Resumen:
- La brecha se cerró, y podemos ponerle fecha. En julio de 2023 el mejor modelo abierto perdía por 17,5 puntos en MMLU y por 37,1 en HumanEval frente a GPT-4. En agosto de 2026 un 27B abierto gana al buque insignia propietario de febrero en 15 de los 19 benchmarks que ambos publican, y también en un índice compuesto independiente.
- El precio cayó unas 208 veces en 23 meses, según la medición de Epoch AI a umbral de capacidad fijo. El 27B abierto cuesta hoy 1,09 dólares por millón de tokens en tarifa mixta, frente a los 10,00 de Opus 4.6 Max, y cero por token si lo ejecutas tú.
- No es la frontera, y lo decimos. Claude Opus 5 Max obtiene 63,1 y GPT-5.6 Sol Max 60,9. En razonamiento de conocimiento amplio el 27B pierde de forma clara frente a Opus 4.6: 30,8 contra 40,0 en HLE.
Imagen: Steve Jurvetson, Wikimedia Commons, CC BY 2.0. La interconexión de un Cray Y-MP, hacia 1988. La computación seria era antes una sala en la que se entraba.
Cómo era realmente el «antes»
Pongamos el reloj en el 18 de julio de 2023, el día en que Meta publicó Llama 2. Era el mejor modelo descargable del mundo, y su propio artículo imprimió sin rodeos el marcador frente a la frontera cerrada.
Llama 2 70B obtuvo 68,9 en MMLU frente a los 86,4 de GPT-4. En GSM8K, 56,8 contra 92,0. En HumanEval, el benchmark de programación, 29,9 contra 67,0: menos de la mitad. El propio resumen del artículo dice: «Sigue existiendo una amplia brecha de rendimiento entre Llama 2 70B y GPT-4 y PaLM-2-L». Ese es el buque insignia de los pesos abiertos en 2023, con sus propias palabras.
Ahora el hardware. La versión comunitaria de 4 bits de TheBloke — la forma en que la gente ejecutaba realmente Llama 2 70B — era un archivo de 41,4 GB publicado el 4 de septiembre de 2023. Para moverlo a una velocidad usable hacían falta dos tarjetas gráficas de 24 GB o un Mac de 64 GB. El modelo que sí cabía en un portátil normal era Llama 2 13B: un archivo de 7,9 GB con 54,8 en MMLU, 31,6 puntos por detrás de GPT-4 y útil para poco más que demostraciones.
Así que el trato de 2023 era este: pagar a un laboratorio de frontera, o ejecutar algo visiblemente peor en hardware que la mayoría no tenía. Por eso mismo el argumento de «usa la API y ya» ganó de forma tan rotunda durante dos años. Era correcto.
Ahora la misma pregunta en agosto de 2026
Alibaba publicó Qwen3.8-27B el 14 de agosto de 2026 bajo Apache 2.0 e imprimió en la ficha del modelo una comparación directa con Claude Opus 4.6 Max. Contamos todas las filas en las que ambos modelos dan una cifra.
Qwen3.8-27B gana 15 de esas 19 filas y pierde 4. Entre las victorias están SWE-bench Pro (61,7 contra 53,4), el seguimiento de instrucciones en IFBench (79,5 contra 62,5), la programación competitiva en LiveCodeBench v6 (90,3 contra 88,8), el manejo de ordenador en OSWorld-Verified (84,3 contra 72,7), las tareas de agente móvil en AndroidWorld (81,9 contra 62,0) y una larga serie de benchmarks multimodales en los que los márgenes no son ajustados: 90,0 contra 65,5 en MathVision, 83,7 contra 66,0 en análisis de gráficos en CharXiv, 65,5 contra 40,8 en razonamiento corporeizado en ERQA.
Las cuatro derrotas importan más que las victorias, porque dicen qué sigue sin poder hacer un modelo de 27.000 millones de parámetros. Pierde en Terminal Bench 2.1 (73,0 contra 78,2), en generación de código a escala de repositorio en NL2Repo-Bench (42,3 contra 47,6), por poco en GPQA Diamond (89,2 contra 91,3) y con claridad en HLE, el benchmark de razonamiento multidisciplinar amplio: 30,8 contra 40,0. Ese último dato es la forma exacta de toda la limitación. No se puede comprimir el conocimiento del mundo en un archivo de 16,5 GB; sí se puede comprimir una cantidad enorme de destreza.
Una fila merece asterisco: el 79,0 contra 63,8 sale de QwenSWEBench, un benchmark construido por Qwen. Los resultados de un fabricante sobre su propio benchmark son la evidencia más débil de cualquier ficha de modelo, y no contamos con ellos.
El marcador independiente dice lo mismo
Las tablas del fabricante son tablas del fabricante, así que aquí va un tercero. Artificial Analysis, que ejecuta sus propias evaluaciones en lugar de reimprimir las ajenas, ya ha medido el 27B. A 21 de agosto de 2026 le asigna un índice de inteligencia de 52,0, primer puesto entre 135 modelos en la categoría de pesos abiertos de 4.000 a 40.000 millones de parámetros, frente a 44,9 de Claude Opus 4.6 Max. Son 7,1 puntos de ventaja para el modelo abierto, medidos por alguien sin interés en el resultado, 190 días después de la salida de Opus 4.6.
Sigue esa comparación hacia atrás en el tiempo y ahí está la historia. En julio de 2023 el mejor modelo abierto por debajo de 40.000 millones de parámetros puntuaba 2,6 en ese mismo índice. En julio de 2024, 7,4. En marzo de 2025, 13,4. En febrero de 2026, 34,6. La semana pasada, 52,0.
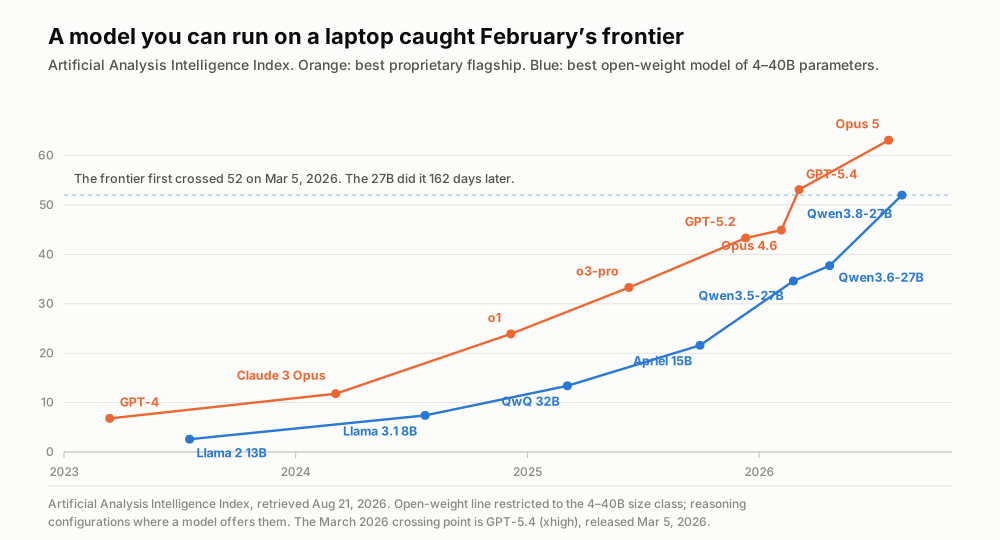
Ambas líneas suben; la magnitud interesante es la distancia horizontal entre ellas. Índice de inteligencia de Artificial Analysis, consultado el 21 de agosto de 2026.
Aquí está la cifra que merece un nombre. La frontera cruzó por primera vez el índice 52 el 5 de marzo de 2026, cuando GPT-5.4 obtuvo 53,1 con su máximo esfuerzo de razonamiento. Un modelo lo bastante pequeño como para funcionar en una máquina personal llegó ahí el 14 de agosto: 162 días después. Llamémoslo el desfase de alcance: el tiempo entre que una capacidad aparece en la frontera y aparece en tu propio hardware.
Ese desfase solía ser mucho mayor. Llama 3.1 8B necesitó 260 días para alcanzar un nivel que GPT-4 Turbo ya había tocado. GLM-4.7-Flash necesitó 410 días para igualar a o1. Los tres últimos lanzamientos de tamaño portátil se sitúan en 201, 155 y 162 días. La frontera no se está frenando — Opus 5 Max está hoy en 63,1 —, pero el borde que la persigue recorta a un ritmo unas dos veces más rápido que hace dos años.
El precio no bajó: se derrumbó
La capacidad es la mitad del antes y después. La otra mitad es la factura.
Epoch AI publicó la medición más limpia de esto en marzo de 2025, y el método merece entenderse: se fija una puntuación de benchmark y se sigue en el tiempo cuál es el modelo más barato que la alcanza. Fija el umbral en los 86 puntos de GPT-4 en MMLU y la escalera queda así: 37,50 dólares por millón de tokens en marzo de 2023, 15,00 en noviembre de 2023, 7,50 en mayo de 2024, 2,19 más adelante ese mismo mes y 0,18 en febrero de 2025. La misma puntuación. 208 veces más barato en 23 meses.
El hallazgo central de Epoch es que el ritmo varía enormemente según la tarea — entre 9 y 900 veces al año según qué capacidad se fije —, y el precio del rendimiento de nivel GPT-4 en preguntas científicas de nivel doctoral cayó unas 40 veces al año. La dirección no varía nunca.
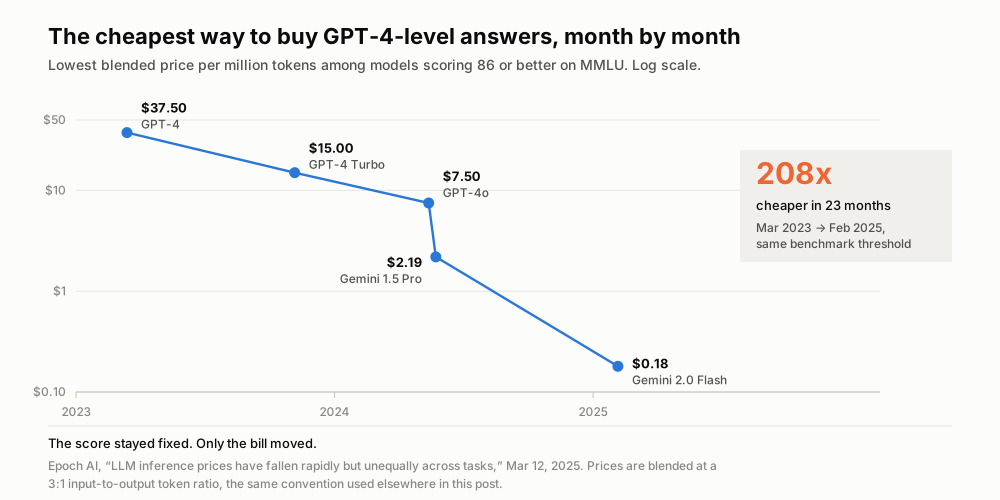
La puntuación del benchmark es constante en cada punto de esta línea. Epoch AI, 12 de marzo de 2025.
Extiende la serie hasta los precios de hoy y sigue igual. En el catálogo de OpenRouter a 21 de agosto de 2026, Qwen3.8-27B cuesta 0,45 dólares por millón de tokens de entrada y 3,20 por millón de salida; Claude Opus 4.6 cuesta 5,00 y 25,00. Mezclados con la proporción 3 a 1 que usa Epoch, son 1,09 frente a 10,00 dólares: el modelo abierto es 9,1 veces más barato y 7,1 puntos de índice mejor que el buque insignia cerrado de hace seis meses.
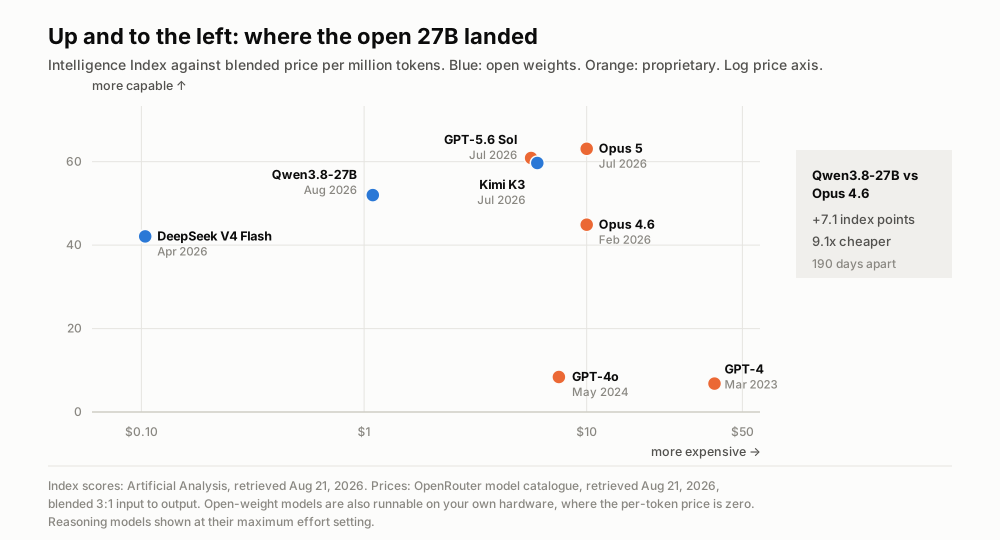
Todos los modelos que importan migran hacia la esquina superior izquierda. Puntuaciones de Artificial Analysis, precios de OpenRouter, ambos consultados el 21 de agosto de 2026.
Y luego está la opción que no tiene precio por token en absoluto. Ejecuta el 27B en tu propia RTX 4090 a los aproximadamente 48 tokens por segundo que reportaron los usuarios en el hilo del lanzamiento, asume los 450 vatios nominales de la tarjeta y, al precio medio residencial de la electricidad en Estados Unidos de 18,44 centavos por kilovatio hora (EIA, mayo de 2026), la electricidad sale a unos 0,48 dólares por millón de tokens de salida: antes de contar la tarjeta, y después de dejar de contar el margen de nadie. Es una estimación calculada con los supuestos sobre la mesa, no una afirmación de fabricante.
El antes y el después, línea a línea
| Julio de 2023 | Agosto de 2026 | |
|---|---|---|
| Mejor modelo descargable | Llama 2 70B (Meta, 18 de julio de 2023) | Qwen3.8-27B (Alibaba, 14 de agosto de 2026) |
| Parámetros | 70.000 millones | 27.000 millones |
| Versión comunitaria estándar de 4 bits | 41,4 GB | 16,5 GB |
| Versión mínima usable | 7,9 GB (13B, MMLU 54,8) | 9,8 GB (2 bits, contexto de 128K en una tarjeta de 16 GB) |
| Hardware realista | dos GPU de 24 GB o un Mac de 64 GB | una GPU de consumo de 16 GB |
| Modelo de frontera del momento | GPT-4 (14 de marzo de 2023) | Claude Opus 4.6 Max (5 de febrero de 2026) |
| Resultado frente a él | −17,5 MMLU, −35,2 GSM8K, −37,1 HumanEval | gana 15 de 19 benchmarks publicados, +7,1 puntos de índice |
| Precio mixto de ese modelo de frontera | 37,50 $ por millón de tokens | 10,00 $ por millón de tokens |
| Precio mixto del modelo abierto | sin oferta a gran escala | 1,09 $ por millón de tokens |
| Licencia | Llama 2 Community License | Apache 2.0 |
Las fuentes de cada celda están al final. La fila a la que volvemos una y otra vez es la penúltima: el precio de la propia frontera cayó 3,75 veces en tres años, mientras que la alternativa abierta apareció por debajo, en torno a una décima parte de esa cifra. Ocurrieron las dos cosas. La segunda es la que cambia quién puede construir.
Lo que todavía no es cierto
El entusiasmo alrededor de este lanzamiento se adelanta a la evidencia en cuatro puntos concretos. Vamos a marcarlos.
No es la frontera. En el mismo índice, Claude Opus 5 Max obtiene 63,1 y GPT-5.6 Sol Max 60,9, muy por encima de 52,0. Si tu trabajo depende del razonamiento más difícil disponible, la frontera sigue siendo otro producto y sigue siendo cerrada.
No es barato para su tamaño. El propio resumen de Artificial Analysis califica a Qwen3.8-27B de «particularmente caro en comparación con otros modelos de pesos abiertos de tamaño similar»: la mediana de su categoría es de 0,05 dólares por millón de tokens de entrada, frente a los 0,43 de Qwen. Estás pagando capacidad, no parámetros.
Es verboso, y la verbosidad es una factura. Al ejecutar la evaluación del índice de inteligencia, el 27B generó 160 millones de tokens de salida frente a una mediana de 45 millones. Un usuario le dio un prompt de dos palabras en un Mac mini de 64 GB y lo vio pensar durante 17 minutos y 12 segundos. Los modelos de razonamiento cobran en tiempo de reloj aunque los tokens sean gratis.
Y las puntuaciones de benchmark pertenecen al modelo en precisión completa. La versión de 2 bits y 9,8 GB que cabe en tu tarjeta gráfica no es el modelo que sacó 52,0. La cuantización agresiva cuesta exactitud, sobre todo en contextos largos. Toda afirmación del tipo «funciona en un portátil», incluida la nuestra, lleva ese asterisco.
Por qué el desfase debería seguir encogiendo
A partir de aquí va nuestra lectura, y marcamos el giro con claridad: todo lo anterior es medición; lo que sigue es inferencia a partir de ella.
El mecanismo que empuja el desfase hacia abajo no tiene misterio. Las técnicas de post-entrenamiento publicadas en la frontera se reproducen en laboratorios abiertos en cuestión de meses. El control del esfuerzo de razonamiento, que hace año y medio era un truco propietario, aparece hoy como parámetro documentado en esta ficha de modelo. La cuantización comunitaria termina antes de que la documentación del laboratorio original deje de cambiar. Ninguno de esos tres bucles de realimentación tiene motivo para frenarse, y dos se aceleran cuanta más gente participa.
Así que la expectativa razonable para la próxima generación no es que los modelos abiertos adelanten a la frontera. Es que ese desfase de 162 días siga comprimiéndose mientras la capacidad absoluta sube en ambos extremos. Con eso, el umbral interesante deja de ser «¿pueden ganar los modelos abiertos?» y pasa a ser «¿cómo de reciente tiene que ser la frontera para que la diferencia deje de importar en mi tarea?». Para transcripción de reuniones, traducción, resumen y la mayor parte del trabajo documental, ese umbral se cruzó hace tiempo. Para la investigación de vanguardia y la ingeniería agéntica más difícil, no.
Es un mundo mucho mejor que el de 2023, y merece la pena decirlo sin rodeos. El coste de dar a un ordenador una comprensión competente del lenguaje ha caído dos órdenes de magnitud en tres años y sigue cayendo. Quienes más ganan son los que antes quedaban fuera por precio: desarrolladores en solitario, equipos en países donde 10 dólares por millón de tokens no es un error de redondeo, investigadores con una beca en lugar de un presupuesto y cualquiera que necesite que los datos no salgan de su máquina por razones legales.
En resumen: la frontera dejó de ser un lugar y pasó a ser una fecha
La pregunta antigua era a qué laboratorio tienes acceso. La nueva es cuántos meses por detrás de la frontera estás dispuesto a ir, dado que cuesta una novena parte y funciona en hardware que ya es tuyo.
Para un número creciente de trabajos, la respuesta honesta es: unos cinco meses, y bajando.
Dónde encaja Telli.sh: todo lo anterior explica por qué construimos sobre modelos abiertos y no alrededor de un único proveedor. Telli.sh ya usa un modelo Qwen abierto en su ruta de resumen, de modo que cada escalón hacia abajo en esta curva llega como mejores actas de reunión y no como un aviso de subida de precios. Nuestro trabajo está en la parte que ninguna descarga te da: capturar una hora de audio sin fallos, mantener separados a los hablantes, traducir en directo a 15 idiomas y convertirlo todo en notas que sigas pudiendo buscar meses después.
Empezar una nota de IA en directo
Fuentes
- Ficha del modelo Qwen3.8-27B y tablas de benchmarks, Hugging Face — cifras del enfrentamiento con Opus 4.6 Max, consultado el 21 de agosto de 2026
- Artificial Analysis: análisis de inteligencia, rendimiento y precio de Qwen3.8 27B — índice de inteligencia 52,0, precio y verbosidad, consultado el 21 de agosto de 2026
- Artificial Analysis: página del modelo Claude Opus 4.6 — índice de inteligencia 44,9 con esfuerzo de razonamiento máximo, consultado el 21 de agosto de 2026
- Epoch AI, «LLM inference prices have fallen rapidly but unequally across tasks», 12 de marzo de 2025 — escalera de precios a umbral fijo y rango de 9 a 900 veces al año
- Llama 2: Open Foundation and Fine-Tuned Chat Models (arXiv:2307.09288), 18 de julio de 2023 — tabla 4, Llama 2 70B frente a GPT-4
- Listado de archivos de TheBloke/Llama-2-70B-Chat-GGUF — versión Q4_K_M de 41,4 GB, publicada el 4 de septiembre de 2023
- Listado de archivos de unsloth/Qwen3.8-27B-GGUF — versiones de 16,5 GB y 9,8 GB, descargas consultadas el 21 de agosto de 2026
- Catálogo de modelos de OpenRouter — precios por token de Qwen3.8-27B, Claude Opus 4.6 y Claude Opus 5, consultado el 21 de agosto de 2026
- Discusión en Hacker News sobre el lanzamiento de Qwen3.8-27B, 14 de agosto de 2026 — informes de rendimiento de usuarios en tarjetas de 16 y 24 GB
- Administración de Información Energética de EE. UU., Electric Power Monthly, tabla 5.3 — 18,44 centavos por kilovatio hora de media residencial, mayo de 2026
- Nuestra cobertura anterior del lanzamiento de los pesos abiertos de Qwen3.8 y de la ola más amplia de pesos abiertos
- Página de Wikimedia Commons de la fotografía del Cray Y-MP
