Qwen3.8-27B open weights: tamaños, Q4_K_M y velocidades reales en 4090 y Mac
Qwen3.8-27B se publica con licencia Apache 2.0. El GGUF Q4_K_M ocupa 17,1 GB y cabe en un portátil de 32 GB; FP8 son 30,9 GB. Medido: 48 tokens/s en una RTX 4090 y 12,75 en un Mac mini M4 Pro.
El 3 de agosto, la cuenta Qwen de Alibaba dijo que los pesos abiertos llegarían «la semana que viene». Es justo el tipo de frase que el sector de la IA ha enseñado a todo el mundo a escuchar con descuento. Doce días después no queda nada que descontar: los pesos de Qwen3.8-Max, con 2,4 billones de parámetros, aparecieron en Hugging Face el 12 de agosto, y el pequeño — Qwen3.8-27B, bajo una licencia Apache 2.0 sin adornos — llegó el 14.
Entonces ocurrió lo interesante. Dentro de la misma hora en que Qwen terminó de publicar la ficha del 27B, tres grupos comunitarios distintos ya lo habían convertido a formatos ejecutables en un ordenador personal. Dos días más tarde, esas conversiones superaban el millón de descargas.
Ese número es la noticia, no la tabla de resultados. Un modelo de 27.000 millones de parámetros de uno de los mejores laboratorios de IA del mundo pasó de «anunciado» a «funcionando en cerca de un millón de escritorios» en unas 48 horas. Este artículo explica en lenguaje llano qué significa eso: qué se publicó y bajo qué licencia, qué hace falta para ejecutar el 27B con el hardware que ya tienes, cuánto se ha avanzado en tres años y la parte que casi nadie cuenta: qué sigue sin poder hacer un 27B local.
En resumen:
- La promesa se cumplió. Qwen3.8-Max (2,4 billones totales / 95.000 millones activos) llegó el 12 de agosto; Qwen3.8-27B, el 14. Ambos son descargas reales, no vistas previas alojadas.
- Las licencias son distintas, y esa diferencia pesa más que las puntuaciones. El 27B es Apache 2.0: sin umbrales ni cláusulas, uso comercial libre y sin deudas. Qwen3.8-Max sale con una licencia propia que incluye un disparador de ingresos para negocios de modelo como servicio.
- El tamaño decide quién puede ejecutar qué: Max son 4.892 GB de descarga; el 27B comprimido a 4 bits ocupa 17,1 GB y cabe en una máquina de 32 GB. Las versiones comunitarias en 4 bits superaron 1,07 millones de descargas en dos días.
Imagen: Dejan Krsmanovic, Wikimedia Commons, CC BY 2.0. Ejecutar tú mismo el modelo de un laboratorio de primera línea significa que la máquina — y su mantenimiento — pasan a ser tuyos.
La promesa venía con fecha, y la fecha se cumplió
El 4 de agosto cubrimos el anuncio y escribimos que la espera se medía en «la semana que viene», no en «algún día». Era todo lo lejos que llegaban las pruebas entonces. Se resolvió limpiamente.
Qwen3.8-2.4T-A95B — comercializado como Qwen3.8-Max — apareció con su archivo de licencia el 12 de agosto. Qwen3.8-27B y una variante FP8 optimizada llegaron el 14. Ambas fechas caen dentro de la ventana que señalaba «la semana que viene». En un sector donde los modelos anunciados a menudo nunca se publican, que un laboratorio cumpla un plazo verbal de nueve días atrás ya merece atención.
La recepción fue inmediata y grande. El hilo de Hacker News sobre el 27B reunió 1.351 puntos y 769 comentarios en un día. En cuestión de horas, profesionales publicaban configuraciones de despliegue que funcionaban para hardware concreto; alguien compartió los ajustes tanto para un NVIDIA DGX Spark como para una tarjeta gráfica de consumo RTX 4090. No es así como el sector trataba los lanzamientos abiertos hace dos años, cuando lograr que una arquitectura nueva arrancara era un proyecto de fin de semana.
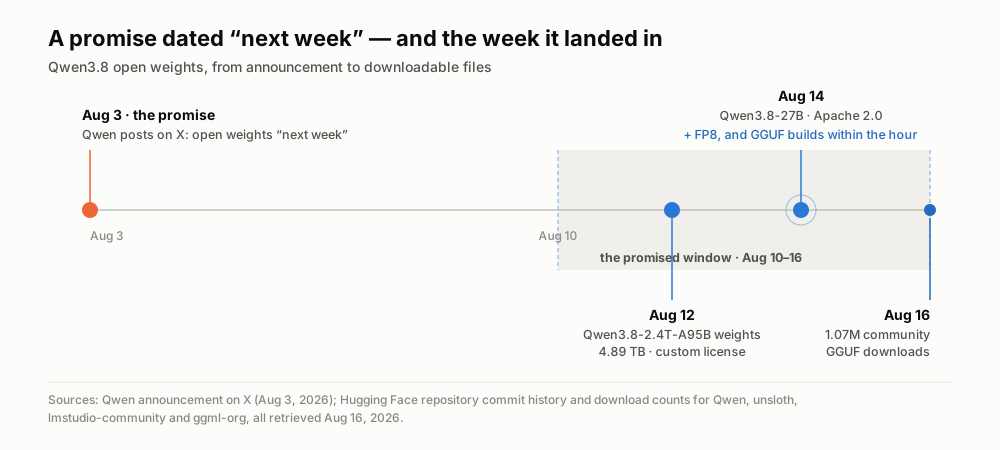
Una promesa con fecha y las dos entregas que cayeron dentro de ella. Fechas del historial de commits de los repositorios de Hugging Face, consultado el 16 de agosto de 2026.
Cinco términos, enfocados a la pregunta «¿puedo ejecutarlo?»
Si vienes de nuestros artículos anteriores, ya sabes qué son los pesos abiertos: el laboratorio publica la enorme cuadrícula de números aprendidos que constituye el modelo terminado, y puedes descargarla, ejecutarla en tu hardware y construir encima sin pagar por petición. Aquí nos ocupa la pregunta siguiente, que es puramente práctica: ¿cuánto cuesta ejecutarlo, en hardware?
Los parámetros son esos números aprendidos, y su cantidad fija el tamaño bruto del modelo. La regla es brutalmente sencilla: a la precisión con la que entrenan los laboratorios, cada mil millones de parámetros ocupan unos 2 GB en disco, y necesitas aproximadamente esa memoria para sostener el modelo mientras funciona. Así que un modelo de 27.000 millones de parámetros es una descarga de 55 GB. Uno de 2,4 billones roza los 5 TB. Por eso uno es un asunto de portátil y el otro, de centro de datos.
La cuantización cierra ese hueco, y es la idea más útil para quien quiera ejecutar modelos en casa. Los parámetros se guardan normalmente con 16 bits de precisión. La cuantización los redondea a menos bits — 8, 4, a veces 2 — y el archivo encoge aproximadamente en la misma proporción. La cuantización de 4 bits convierte esos 55 GB en unos 17 GB. Pierdes algo de precisión y ganas la posibilidad de ejecutarlo. GGUF es simplemente el formato de archivo en que se distribuyen esas versiones comprimidas; es lo que leen herramientas como llama.cpp, Ollama y LM Studio. Cuando veas «Q4_K_M», léelo como «la versión de 4 bits que usa casi todo el mundo».
Denso frente a mezcla de expertos decide la velocidad una vez que cabe. Qwen3.8-27B es denso: los 27.000 millones de parámetros se activan para cada palabra que produce. Qwen3.8-Max es de mezcla de expertos: 2,4 billones de parámetros en total, pero un enrutador selecciona solo unos 95.000 millones por token, repartidos entre 512 subredes especializadas. El total te dice la factura de almacenamiento; el número activo, la de cómputo. Esta distinción tiene un filo práctico muy afilado, y volveremos a ella.
La ventana de contexto es cuánto puede considerar el modelo de una sola vez. El 27B maneja 262.144 tokens de forma nativa — una pila de transcripciones de reuniones de una hora — y puede estirarse hasta un millón cambiando la configuración.
La licencia es lo primero que hay que leer
Aquí está el hallazgo que sostiene todo lo demás, y contradice la idea de que una familia de modelos comparta una familia de condiciones.
Qwen3.8-27B es Apache 2.0. Es el extremo permisivo del espectro: úsalo, modifícalo, ajústalo, inclúyelo en un producto comercial, monta un negocio encima, sin deber nada ni pedir permiso a nadie. Sin umbrales de ingresos, sin obligación de mostrar el nombre en la interfaz, sin exclusiones de uso.
Qwen3.8-Max, no. Sale bajo una «Qwen3.8-Max License» propia que empieza pareciéndose a MIT y luego añade dos condiciones. Si tu producto supera los 100 millones de usuarios activos mensuales o los 20 millones de dólares de ingresos mensuales, debes mostrar el nombre del modelo en la interfaz. Y si operas un negocio de modelo como servicio o de asistente de trabajo con IA cuyos ingresos superen los 50 millones de dólares en doce meses consecutivos, necesitas un acuerdo aparte con Qwen antes de cualquier uso comercial.
Para un desarrollador independiente o una empresa que lo use internamente, nada de esto muerde. Pero es el mismo asterisco que señalamos cuando Kimi K3 salió con licencia propia en lugar de MIT, y la lección se repite: «pesos abiertos» y «licencia abierta» son dos preguntas distintas, y un laboratorio puede responderlas de forma diferente para dos modelos publicados con dos días de diferencia. Lee la licencia antes de enamorarte de una puntuación.
| Modelo | Parámetros totales | Activos por token | Tamaño de descarga | Licencia | Entorno realista |
|---|---|---|---|---|---|
| Qwen3.8-Max (2.4T-A95B) | 2,4 billones | 95.000 M | 4.892 GB | Propia, disparador de ingresos | Un clúster de aceleradores |
| Qwen3.8-Max, FP8 | 2,4 billones | 95.000 M | 2.496 GB | Propia, disparador de ingresos | Un clúster de aceleradores |
| Qwen3.8-27B | 27.000 M, denso | 27.000 M | 55,6 GB | Apache 2.0 | Estación de trabajo multi-GPU |
| Qwen3.8-27B, FP8 | 27.000 M, denso | 27.000 M | 30,9 GB | Apache 2.0 | Una GPU de gama alta |
| Qwen3.8-27B, Q4_K_M GGUF | 27.000 M, denso | 27.000 M | 17,1 GB | Apache 2.0 | Un portátil de 32 GB o una 4090 |
Qué hace falta de verdad para ejecutar el 27B
La respuesta honesta: menos de lo que imaginas, y más de lo que insinúan los titulares.
El escalón más bajo es un solo comando. El 27B está en la biblioteca de Ollama; ollama run qwen3.8 descarga una versión de 18 GB con ventana de contexto de 256K y entrada de imágenes, entre doce variantes, una de ellas ajustada para chips de Apple. LM Studio, que te da una ventana de chat en vez de un terminal, tuvo su versión disponible pocos minutos después del lanzamiento. Ninguno de los dos te pide entender nada de la sección anterior.
Después irrumpe la realidad en forma de tokens por segundo. Las mediciones que los profesionales publicaron en el hilo del lanzamiento cayeron donde el hardware hacía prever. En una RTX 4090 con la versión de 4 bits, uno midió unos 48 tokens por segundo, cómodamente más rápido de lo que puedes leer. En un Mac mini M4 Pro con 64 GB de memoria, otro obtuvo 12,75 tokens por segundo: utilizable, pero lo ves escribir. Y en un portátil con AMD 7840U y 64 GB de DDR5 corriente, la misma versión de 4 bits dio unos 4 tokens por segundo: técnicamente funciona, en la práctica es un proceso por lotes que lanzas y dejas solo.
Esa última cifra es donde la distinción entre denso y expertos se gana el sueldo. La misma persona midió en el mismo portátil un modelo de mezcla de expertos más antiguo y nominalmente más grande a unos 20 tokens por segundo: cinco veces más rápido que el modelo denso más pequeño, porque solo una fracción de sus parámetros se activa por palabra. Si buscas algo para ejecutar en CPU, el número por el que comprar son los parámetros activos, no los totales. Es la lección menos intuitiva y más útil de la IA local.
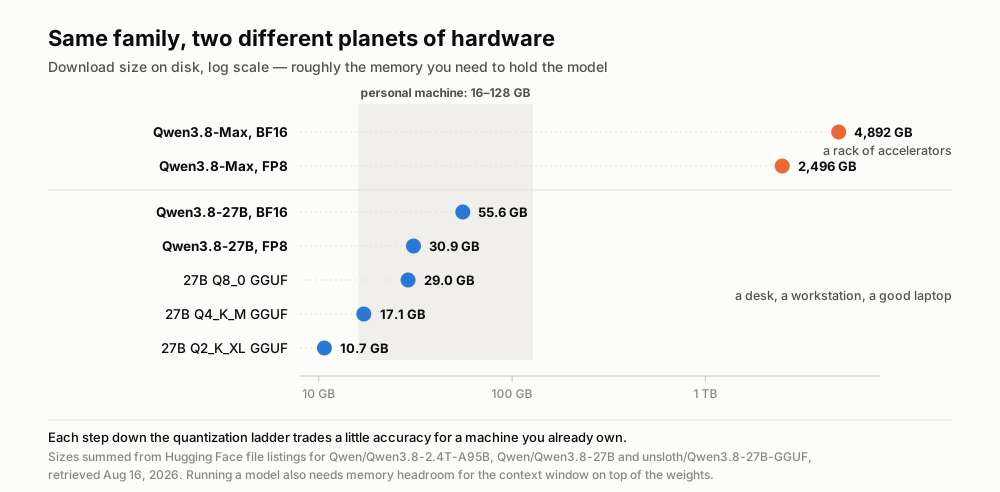
Dos miembros de la misma familia de modelos, separados por un factor de 290 en tamaño de descarga. Tamaños sumados de los listados de archivos de Hugging Face, consultados el 16 de agosto de 2026.
Hace tres años esto requería una filtración y un fin de semana
Para ver el salto, ponlo al lado del punto de partida de los modelos locales.
En febrero de 2023, Meta publicó los pesos del LLaMA original solo para investigadores aprobados. Se filtraron en cosa de una semana, y toda la escena aficionada de modelos locales se construyó sobre un archivo que nadie debía tener. El 10 de marzo de 2023, un desarrollador publicó llama.cpp, un pequeño programa en C++ cuya gracia era ejecutar el modelo de 7.000 millones de parámetros en un MacBook. Ese repositorio tiene hoy 124.000 estrellas y es el antepasado de prácticamente toda herramienta de «ejecución local» que se usa hoy.
Compara los dos días de lanzamiento. En 2023: un 7B filtrado, sin licencia digna de ese nombre, una semana de esfuerzo comunitario para hacerlo arrancar y un modelo más interesante que útil. En 2026: un 27B de un laboratorio de primera línea, publicado deliberadamente con Apache 2.0, con entrada de imagen y vídeo, ventana de contexto de 262K y versiones comunitarias terminadas antes de que la documentación del propio laboratorio dejara de cambiar. El primer commit de la conversión de unsloth fue a las 14:56 UTC del 14 de agosto: cuatro minutos antes de la última actualización de la ficha por parte de Qwen.
Las cifras de adopción lo dicen más crudamente. A 16 de agosto, las versiones comunitarias de 4 bits del 27B acumulaban 867.963 descargas en un editor, 171.518 en un segundo y 34.520 en un tercero: 1,07 millones en dos días. Los repositorios oficiales de Qwen para el 27B suman otras 215.000. Qwen3.8-Max, el modelo mucho más capaz, se queda en 17.126 entre sus dos repositorios.
Vuelve a leer esa proporción. El modelo de escala frontera recibió alrededor del 1,6 % de la atención que recibió el que cabe en un portátil. Lo que el mercado fue a buscar no fue capacidad. Fue alcance.
Qué sigue sin poder hacer un 27B local
Ahora la corrección, porque el entusiasmo adelanta a las pruebas de formas predecibles.
La propia tabla de Alibaba sitúa al 27B por delante de Opus 4.6 Max en varias medidas de programación agéntica y seguimiento de instrucciones — 61,7 frente a 53,4 en SWE-bench Pro, 79,5 frente a 62,5 en IFBench — y por detrás en otras, incluido un 30,8 frente a 40,0 en HLE, que mide conocimiento amplio. Todas esas cifras las declara el propio fabricante. A la hora de escribir esto, Artificial Analysis, el evaluador independiente en el que nos apoyamos, no tiene entrada alguna para el 27B; sí sitúa a Qwen3.8-Max en el puesto 10 de 188 modelos con una puntuación de inteligencia de 58, lo cual es excelente y es otro modelo.
Los profesionales fueron más afilados que la hoja de cálculo. La objeción más votada del hilo, de alguien que se declaraba usuario veterano de modelos abiertos, fue tajante: estos no superan a los mejores modelos alojados en uso real; son «suficientemente buenos» para muchas tareas y funcionan en hardware asequible, que es una afirmación distinta y más modesta. Otro comentario planteó el techo en términos físicos: no se puede comprimir todo el conocimiento humano en un archivo de 30 GB, así que los modelos pequeños siguen siendo comparativamente flojos recordando datos poco frecuentes, por afilados que se vuelvan programando o usando herramientas.
Hay dos límites más que solo aparecen al ejecutarlo. La cuantización no es gratis: un modelo muy comprimido tiende a perder el hilo en contextos largos y puede caer en bucles de repetición, y por eso a quien le sobra memoria se le recomienda la versión de precisión completa. Y esta generación de Qwen piensa mucho por defecto: un usuario le dio al 27B, en un Mac mini de 64 GB, las dos palabras «svg owl» y lo vio generar 21.769 tokens de razonamiento durante 17 minutos y 12 segundos antes de responder. El búho salió bien. También salió una factura en tiempo de reloj que ninguna API alojada habría cobrado.
Y queda la partida que nadie contabiliza: la operación pasa a ser tuya. Actualizaciones del modelo, elección de cuantización, margen de memoria, versiones de controladores, el ventilador de la máquina. Aquella API alojada que evitabas era también un equipo de personas manteniendo algo en marcha.
En conclusión: el foso se ha movido hacia abajo en la pila
Este es el punto, y es mayor que un lanzamiento.
Un laboratorio de primera línea publicó un 27B competente un jueves. El sábado había más de un millón de copias de versiones comprimidas por la comunidad en las máquinas de la gente, estaba a un comando de distancia en Ollama y era legalmente libre construir un negocio encima. Sea cual sea la ventaja que representa ese modelo, tardó unos dos días en quedar disponible para todos los competidores a la vez. Llamémoslo el foso de dos días: una ventaja de modelo cuya vida media ronda ahora las 48 horas.
Esto no es una predicción. Es una medición, tomada esta semana, sobre este lanzamiento.
Y redefine lo que significa construir un producto de IA. Cuando la capa del modelo es una mercancía que cualquiera cambia en una tarde, el modelo deja de ser aquello en lo que compites. Lo que sobrevive es todo lo que lo envuelve: la fiabilidad cuando el servidor de inferencia se cae a las tres de la madrugada, las tuberías de datos que capturan, limpian y recuperan el contexto correcto, la evaluación que te dice si funciona con tus datos y no con los de un benchmark, una interfaz que alguien vaya a usar de verdad, y los acuerdos de confianza — privacidad, retención, quién puede ver qué — que deciden si alguien te entrega sus grabaciones de reuniones.
Nada de eso se convierte en mercancía en dos días. Nada de eso tiene botón de descarga.
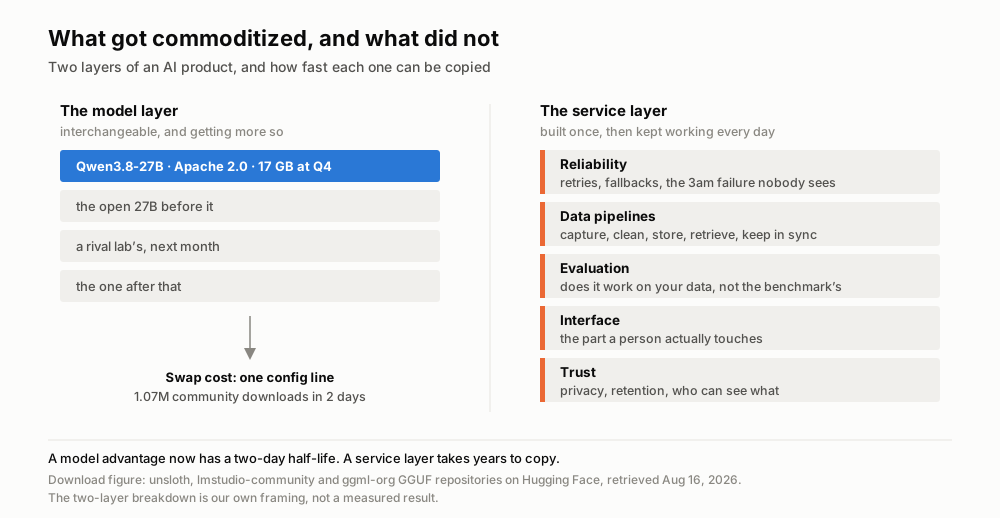
La capa que se abarató esta semana y la que no. Cifras de descarga de Hugging Face, consultadas el 16 de agosto de 2026; la división en dos capas es nuestra.
Así que la reacción correcta a que un gran modelo abierto llegue a los portátiles no es «ganaron las empresas de modelos» ni «perdieron las de producto». Es que el trabajo interesante bajó un piso en la pila, a un lugar mucho más difícil de copiar y mucho menos divertido de titular.
Dónde encaja Telli.sh: construimos exactamente esa capa de servicio, sobre modelos abiertos. Telli.sh ya usa un modelo Qwen abierto en su ruta de resumen, lo que significa que cada salto de calidad en los modelos abiertos — este incluido — llega directo a la transcripción, la traducción y los resúmenes de reuniones, sin cambio de precio por tu parte. Nuestro tiempo se va en la parte que no viene dentro de un archivo GGUF: capturar audio de forma fiable, no confundir a los hablantes, convertir una grabación de 60 minutos en notas que puedas buscar meses después y ser claros sobre dónde viven tus datos.
Empezar una nota con IA en directo
Fuentes
- Ficha y licencia de Qwen3.8-27B, Hugging Face
- Ficha y licencia de Qwen3.8-2.4T-A95B, Hugging Face
- unsloth/Qwen3.8-27B-GGUF: versiones cuantizadas y contadores de descarga
- Qwen3.8 en la biblioteca de modelos de Ollama
- Discusión en Hacker News sobre el lanzamiento de Qwen3.8-27B (14 de agosto de 2026)
- Página del modelo Qwen3.8 Max en Artificial Analysis
- Anuncio de pesos abiertos de Qwen (@Alibaba_Qwen) en X (3 de agosto de 2026)
- Repositorio llama.cpp, creado el 10 de marzo de 2023
- Página de la imagen en Wikimedia Commons
