El sprint de pesos abiertos de China en tres semanas: Kimi K3, Qwen3.8-Max y el giro que podría acabar con todo
En tres semanas, los mayores laboratorios de IA de China han publicado o anticipado modelos de pesos abiertos de frontera — Kimi K3, Qwen3.8-Max y DeepSeek V4 en disponibilidad general. Una guía en lenguaje claro: qué es cada modelo, qué salió de verdad y qué sigue siendo una promesa, y por qué Pekín podría ahora restringir la ola que él mismo desató.
Entre el 16 y el 26 de julio, tres de los mayores laboratorios de IA de China pusieron sobre la mesa modelos abiertos de nivel frontera. Moonshot AI anunció Kimi K3 el 16 de julio y publicó los pesos el 26 de julio. Alibaba presentó Qwen3.8-Max el 19 de julio en la WAIC de Shanghái. La línea V4 de DeepSeek alcanzó la disponibilidad general (GA) en torno al 20 de julio. Tres laboratorios, unas tres semanas.
El patrón es difícil de pasar por alto, y no es aquel con el que la escena china de modelos abiertos se labró su reputación. Estos laboratorios eran conocidos por modelos pequeños, rápidos y baratos que golpeaban por encima de su categoría. Esta ola es la apuesta contraria: sistemas de billones de parámetros publicados, o prometidos, como pesos abiertos.
Esta es una lectura honesta de esa ola: qué salió de verdad, qué sigue siendo una vista previa o una promesa, y el giro que llegó con ella — el mismo gobierno que hizo posibles estos lanzamientos está sopesando ahora si restringirlos. Mantendremos la jerga al mínimo y explicaremos el resto sobre la marcha, para que puedas seguir la historia aunque «pesos abiertos» y «mixture-of-experts» te suenen a nuevo. Si leíste nuestro repaso de julio, esto es la secuela, y uno de sus cabos sueltos se ha resuelto.
Image: OLCF at ORNL, Wikimedia Commons, CC BY 2.0.
Primero, las cinco ideas que hacen que todo encaje
Si eres nuevo en este rincón de la IA, cinco términos cargan con la mayor parte de la historia, y merecen un minuto en lenguaje claro antes de llegar a los modelos.
«Pesos abiertos» (open weights) es toda la razón por la que esta ola importa. Los pesos de un modelo son la enorme cuadrícula de números que aprendió durante el entrenamiento — en la práctica, el cerebro terminado. Cuando un laboratorio publica los pesos, puedes descargar ese archivo, ejecutar el modelo en tu propio hardware, ajustarlo y construir productos sobre él sin pedir permiso a nadie ni pagar por petición. La alternativa es un modelo cerrado, como la mayoría de los chatbots comerciales, donde los pesos quedan bajo llave en los servidores del proveedor y tú alquilas el acceso mediante una API de pago. Los pesos abiertos convierten un modelo de un servicio que alquilas en algo de lo que posees una copia, y esa diferencia es la razón por la que una industria entera presta atención cuando sale uno bueno.
Los «parámetros» son esos números aprendidos, y su cantidad es el indicador aproximado de cuánto puede albergar un modelo. Un modelo de «2,8 billones de parámetros» tiene 2,8 billones de ellos. Más grande no es automáticamente mejor, pero en la frontera suele significar más margen para razonar — y, no menos importante, más hardware para ejecutarlo. Ahí entra el «mixture-of-experts» (MoE). En lugar de disparar todos los parámetros para cada palabra, un modelo MoE se divide en muchas subredes especializadas llamadas expertos, y un enrutador elige solo un puñado para cada token. Así que cuando ves «2,8 billones en total, 104.000 millones activos», significa que el modelo es enorme pero solo unos 104.000 millones de parámetros trabajan en un momento dado — como un hospital con miles de especialistas donde a cada paciente solo lo ven los pocos pertinentes. El total insinúa cuán capaz puede ser; el número activo dice cuánto cuesta servirlo. Esa brecha es la cifra más útil para juzgar el coste.
Una «ventana de contexto» es cuánto texto puede tener el modelo en mente a la vez, contado en tokens — y un token equivale a unos tres cuartos de palabra. Una ventana de un millón de tokens no es una especificación abstracta: son varias novelas largas, o decenas de transcripciones de reuniones de una hora, en una sola pasada. Es la diferencia entre resumir un solo correo y razonar sobre un trimestre entero de ellos.
Por último, la licencia — y esta es la parte que los profesionales deberían leer primero, antes que los benchmarks. La licencia es la letra pequeña legal que dice qué puedes hacer con los pesos. MIT es el patrón oro: úsalo, modifícalo, inclúyelo en un producto comercial, no debes nada. Una licencia propia puede parecer abierta y a la vez excluir justo el uso que tenías en mente — por ejemplo, cobrándote en cuanto el negocio que montaste sobre ella se hace grande. Dos modelos pueden ser ambos «pesos abiertos» y estar a mundos de distancia en lo que legalmente puedes hacer. Así que compensa leer esta línea antes de enamorarte de una puntuación. Con estas cinco ideas en la mano, la ola se lee con claridad.
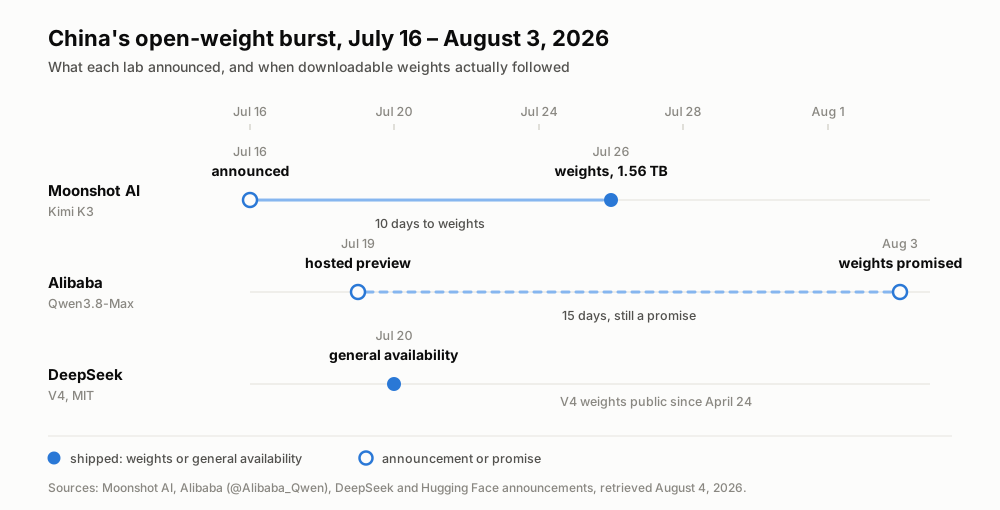
Tres laboratorios, tres semanas — y de estos cinco momentos solo dos pusieron pesos en manos de alguien. Fechas tomadas de los anuncios de cada laboratorio, consultadas el 4 de agosto de 2026.
Kimi K3 es el que realmente salió
Empieza por Moonshot AI, el laboratorio de Pekín tras el asistente Kimi, que pasó el último año labrándose una reputación con modelos abiertos grandes y capaces. Cuando escribimos sobre Kimi K3 en julio, los pesos eran solo una promesa — Moonshot había dicho «antes del 27 de julio». Llegaron el 26 de julio: 1,56 terabytes repartidos en 96 fragmentos en Hugging Face, bajo moonshotai/Kimi-K3. Esa es la noticia. Un anuncio es una nota de prensa; unos pesos descargables son un hecho sobre el que se puede construir.
En términos llanos, K3 es uno de los mayores modelos abiertos jamás publicados — un sistema mixture-of-experts con 2,8 billones de parámetros en total y unos 104.000 millones activos por token, que enruta alrededor de 16 de 896 expertos mediante un mecanismo que Moonshot llama Kimi Delta Attention, con una ventana de contexto de un millón de tokens y una mejora de eficiencia de escalado reportada de cerca del 2,5x frente a su predecesor, K2. Traducido de la ficha técnica: es muy grande, relativamente económico de ejecutar para su tamaño porque solo una porción se dispara por token, y capaz de tragarse de una vez entradas del tamaño de un libro.
Esos números también dicen quién lo ejecutará de verdad. 1,56 terabytes en 96 fragmentos no es una descarga de portátil; es un artefacto de clase centro de datos que necesita un clúster de aceleradores de gama alta solo para cargarse. En la práctica, casi ningún particular alojará K3 por su cuenta — lo alcanzará a través de proveedores que ya tienen el hardware, y ese mercado llegó el primer día: Together AI y Modal levantaron endpoints alojados de Kimi K3 en el instante en que aterrizaron los pesos. Así es también como un lector curioso lo prueba hoy — no descargando 1,56 TB, sino llamando a uno de esos endpoints alojados o usando la app de Kimi. «Abierto» aquí significa que los pesos son públicos y cualquiera con el hardware puede servirlos, que es justo lo que mantiene la competencia de precios; no significa que tú lo vayas a ejecutar en tu escritorio.
¿Es bueno? Por la única cifra independiente en la que confiamos esta ronda, sí. En el ranking de Artificial Analysis quedó 4º de 189 modelos — por detrás de Claude Fable 5 y de dos configuraciones GPT-5.6 «Sol», por delante de Opus 4.8 y GPT-5.5. Para un modelo abierto que puedes descargar, estar en esa compañía ya es la historia.
Luego lee la licencia, porque aquí «abierto» gana un asterisco. Kimi K3 no es MIT. Se distribuye bajo una licencia propia, la «Kimi K3 License», no aprobada por la OSI y con una cláusula de umbral de ingresos: ejecutar K3 como motor de un gran negocio de Model-as-a-Service exige un acuerdo aparte con Moonshot. Para un desarrollador en solitario, o una empresa normal que lo usa internamente, eso no cambia nada. Pero para quien construya un producto alojado a gran escala, «pesos abiertos» y «licencia abierta» son dos preguntas distintas — y aquí solo la primera es un sí inequívoco.
Qwen3.8-Max es una vista previa, no una descarga
Qwen es la familia de modelos de Alibaba, y su equipo ha sido de los que más modelos abiertos publican en el mundo — precisamente ese historial es lo que hace confuso al más reciente. Presentado el 19 de julio en la WAIC de Shanghái, Qwen3.8-Max es el titular más grande de la ola y también el más blando. Es un MoE disperso de 2,4 billones de parámetros — parámetros activos sin revelar — y el primer Qwen por encima del billón de parámetros que es multimodal, es decir, que toma como entrada no solo texto sino imágenes, vídeo y documentos.
Aquí está la trampa que un recién llegado necesita que le deletreen: pese a la fanfarria, no puedes descargarlo. Ahora mismo existe solo como «vista previa alojada» — qwen3.8-max-preview, accesible a través del propio servicio de Alibaba (su Token Plan y la herramienta Qoder) a alrededor del 10 % del precio estándar. Una vista previa alojada significa que Alibaba ejecuta el modelo en sus servidores y te deja llamarlo; es el modelo de API alquilada, no el de poseer una copia. Llamarlo hoy un lanzamiento de pesos abiertos es prematuro.
Ese panorama cambió el 3 de agosto. La cuenta oficial de Qwen en X, @Alibaba_Qwen, publicó que los pesos abiertos de Qwen3.8-Max llegarían «la semana que viene» — y que un Qwen3.8-27B más pequeño también pasaría a pesos abiertos. Así que el 27B no es un rumor, dijera lo que dijera la cháchara anterior: es un compromiso por escrito de la propia cuenta de Alibaba. Y el tamaño es lo importante. Mientras que el Max de 2,4 billones de parámetros, como K3, es algo que solo ejecuta un centro de datos, un 27B es lo bastante pequeño para servirse en una sola máquina de gama alta — el nivel que un individuo o un equipo pequeño puede alojar de verdad por su cuenta. Eso suaviza de verdad la imagen del «prometido sin detalles»: ahora hay un tamaño y un plazo aproximado.
Aun así, las advertencias honestas siguen en pie. «La semana que viene» es una dirección, no una fecha de entrega, y al momento de escribir esto, el 4 de agosto, nada ha aparecido en la organización de Qwen en Hugging Face — sus modelos más recientes allí son de junio. Tampoco se ha publicado la licencia de pesos abiertos, y los primeros lectores de los términos de la vista previa señalaron posibles restricciones regionales, sin confirmar hasta que aparezca la licencia real — justo la lección de «la licencia primero» del abecé. La afirmación de Alibaba de que el modelo es «solo superado por Fable 5» sigue siendo un dato propio sin cifras de terceros, así que trátalo como el eslogan de marketing de un proveedor hasta que alguien fuera de Alibaba lo mida. Si quieres probar el modelo hoy, la vista previa alojada es la única puerta — pero por primera vez, la espera por pesos descargables se mide en «la semana que viene», no en «algún día».
DeepSeek V4 alcanzó la disponibilidad general en silencio
DeepSeek es el laboratorio cuyo modelo R1 ayudó a arrancar la actual carrera de modelos abiertos a principios de 2025, y fiel a su estilo, aquí fue el que menos anunció mientras entregaba lo más utilizable. Su línea V4, publicada ya el 24 de abril, es la que se puede adoptar de forma más directa, porque llega bajo la licencia que el abecé señaló como patrón oro.
V4 llega en dos tamaños, ambos con licencia MIT. V4-Pro es el buque insignia, con 1,6 billones en total y 49.000 millones de parámetros activos; V4-Flash es el ligero, con 284.000 millones en total y 13.000 millones activos. Recuerda qué significa el número activo: V4-Flash solo dispara 13.000 millones de parámetros por token, lo que lo hace barato y rápido de servir, y eso es lo que lo convierte en la opción económica para el trabajo de alto volumen — ese tipo de carga de transcribir y resumir donde el coste por token lo decide todo. Ambos tienen una ventana de contexto de un millón de tokens y pueden producir hasta 384K tokens de salida en una sola respuesta, suficiente para redactar un informe largo, no solo un párrafo. En torno al 20 de julio, V4 alcanzó la disponibilidad general con precios por tiempo, lo que metió un lanzamiento de primavera en el mismo marco de tres semanas que K3 y Qwen.
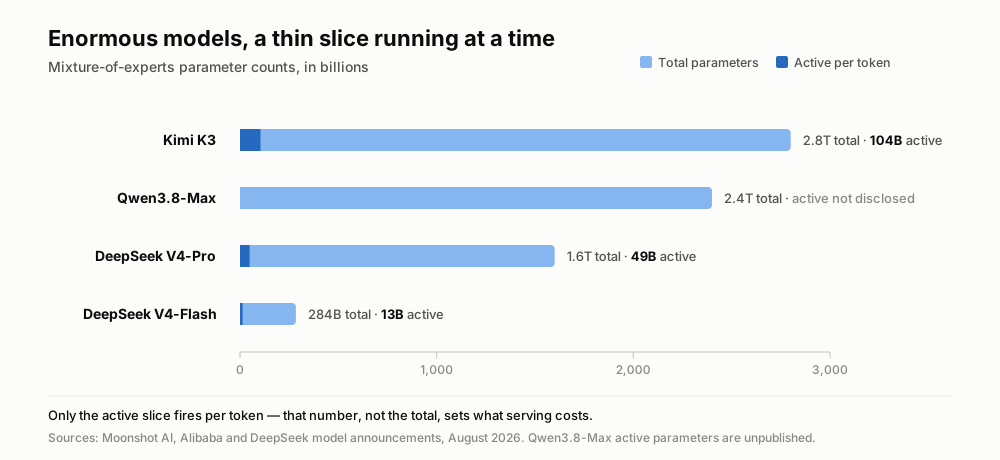
La barra clara es el tamaño del modelo; el tramo oscuro es lo que realmente se enciende en cada token. Alibaba no ha revelado los parámetros activos de Qwen3.8-Max.
Como es MIT, V4 es el que un adoptante puede construir con los menos abogados posibles: consigue los pesos (o usa un proveedor alojado), ejecútalo, lánzalo comercialmente, no debes nada y no pides permiso a nadie. Y para ser claros con los números de versión, ya que el rumor los adora — no hay R2, ni V5, ni V4.1. Solo está la familia V4 madurando hasta convertirse en algo en lo que los equipos pueden confiar.
La brecha se cierra más rápido de lo que admiten las clasificaciones
Si damos un paso atrás, la pendiente importa más que los lanzamientos individuales. La lectura de Nathan Lambert es que la distancia entre los mejores modelos abiertos y los mejores cerrados se ha comprimido de unos seis a nueve meses a tres a cinco — «lo más cerca que han estado los modelos abiertos de la frontera desde DeepSeek R1». Dicho llanamente: los modelos de libre descarga están ahora solo unos meses por detrás de los mejores modelos que se pueden alquilar, donde hace un año iban una vuelta cómoda por detrás.
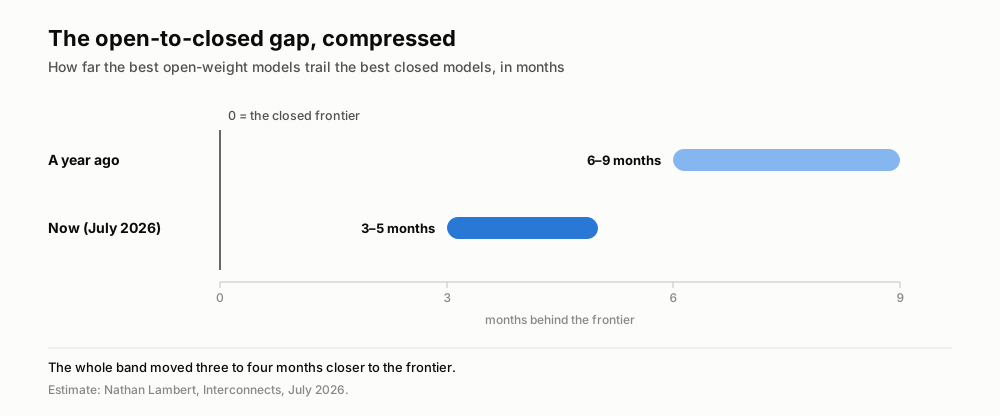
La estimación de Lambert dibujada a escala: el bando abierto no solo se acercó, la banda entera se estrechó.
Los datos de uso apuntan en la misma dirección. En OpenRouter, un mercado que reparte las peticiones entre muchos modelos, la cuota de tokens de los modelos de origen estadounidense cayó de cerca del 70 % en junio de 2025 a alrededor del 30 % un año después, mientras que los modelos de origen chino superan ya con regularidad el 30 %. El precio explica buena parte: los modelos abiertos chinos suelen costar entre un 60 y un 90 % menos por token, y el alojamiento apareció de inmediato, como dejaron claro esos endpoints de K3 en el día cero.
El cambio más silencioso tiene que ver con la escala. La marca del modelo abierto chino era pequeño, rápido y barato. K3 con 2,8 billones de parámetros y Qwen3.8-Max con 2,4 billones son justo lo contrario — una apuesta a que ir a lo grande en abierto ya merece la pena. GLM-5.2 de Z.ai, publicado el 16 de junio bajo MIT y en cabeza de la categoría de pesos abiertos del Artificial Analysis Index con 51, es el mismo mensaje desde un cuarto laboratorio.
El giro: el gobierno que lo hizo posible podría restringirlo
Entonces cambió el rumbo. En torno al 22 al 25 de julio, el Financial Times y Reuters informaron de que el Ministerio de Comercio de China está sopesando controles de exportación sobre los modelos de IA — incluidos los LLM de pesos abiertos —, con Alibaba, ByteDance y Z.ai supuestamente en la conversación. El marco que se baraja es escalonado: una obligación de declaración para los modelos más débiles, una revisión de seguridad para los más fuertes y una posible prohibición de publicar abiertamente los más capaces. Nada es todavía ley. Pero la dirección es llamativa: la ola quizá esté alcanzando su cima justo cuando su propio gobierno empieza a tratar estos modelos como exportaciones estratégicas y no como contribuciones abiertas.
En resumen: cuando lo abierto se vuelve un activo estratégico
El relato cómodo dice «China alcanzó al resto». El más preciso dice que los pesos abiertos se volvieron un activo estratégico tan rápido que un gobierno quiere ahora la mano sobre el grifo. En tres semanas, los modelos abiertos pasaron de ir dos o tres trimestres por detrás de la frontera a ir solo uno — y de ser pequeños y baratos a estar entre los mayores modelos jamás publicados en cualquier forma. La frontera abierta no solo se movió. Se movió a un lugar desde el que sus creadores quizá no sean libres de seguir enviando.
Para los equipos que construyen sobre estos modelos, la conclusión práctica no cambia y se afina un poco. Telli.sh ya ejecuta un modelo abierto, Qwen3, en su capa de resumen, de modo que cada avance en calidad y precio de los modelos abiertos fluye directo a la transcripción, la traducción y los resúmenes de reuniones. La nueva partida es el suministro: si las reglas de exportación de China cuajan como sugieren las informaciones, qué modelos abiertos seguirán siendo de libre descarga es algo que vigilar más que presuponer. Que mejoren los modelos que alimentan esa capa es la tendencia; de dónde se les permite venir es lo que hay que no perder de vista.
Empezar una nota de IA en vivo
Fuentes
- Simon Willison on Kimi K3 weights (July 27, 2026)
- Nathan Lambert, "Kimi K3: the open-weights escalation" (Interconnects, July 20, 2026)
- Kimi K3 announcement (Moonshot AI)
- Kimi K3 weights on Hugging Face
- Artificial Analysis on Kimi K3
- Qwen (@Alibaba_Qwen), Qwen3.8-Max & Qwen3.8-27B open-weights announcement on X (Aug 3, 2026)
- Latent Space / AINews, "Qwen 3.8 Max (2.4T) and 27B, new open weights models" (Aug 4, 2026)
- WinBuzzer on DeepSeek V4 (April 27, 2026)
- The Decoder on Chinese open-model adoption
- Tom's Hardware on China's proposed AI export controls (July 2026)
- Wikimedia Commons image page
