Eine Datei von 16,5 GB schlägt jetzt das beste geschlossene Modell vom Februar
Vor drei Jahren lag das beste herunterladbare Modell bei HumanEval 37 Punkte hinter GPT-4 und brauchte zwei Grafikkarten. Letzte Woche erreichte ein offenes 27B-Modell 52,0 im Intelligence Index von Artificial Analysis, Claude Opus 4.6 Max liegt bei 44,9 — zu einem Neuntel des Preises, aus einer Datei von 16,5 GB. Eine Vorher-Nachher-Analyse mit Benchmark-Tabellen, Preiskurve und der Bedeutung einer auf 162 Tage geschrumpften Aufholzeit.
Jemand auf Hacker News betreibt ein Sprachmodell der Spitzenklasse auf einer Grafikkarte mit 16 GB Speicher, bei 50 bis 60 Token pro Sekunde und einem Kontextfenster von 128.000 Token. Das Modell ist Qwen3.8-27B, veröffentlicht am 14. August 2026. Im Intelligence Index von Artificial Analysis erreicht es 52,0 — mehr als Claude Opus 4.6 Max, noch im Februar das stärkste proprietäre Modell am Markt, das dort bei 44,9 liegt.
2023 wäre dieser Satz Science-Fiction gewesen.
Dieser Beitrag ist der Vorher-Nachher-Vergleich. Nicht die Berichterstattung zur Veröffentlichung — die haben wir bereits geschrieben —, sondern der Vergleich über drei Jahre hinweg: welche Werte das beste herunterladbare Modell damals und heute gegen die Spitzenklasse erreicht, was ein bestimmtes Maß an Intelligenz damals und heute kostet und welche Hardware man damals und heute besitzen musste, um es selbst zu betreiben. Jede Zahl unten hat eine Quelle und ein Datum. Der Trend, den sie beschreiben, gehört zum Optimistischsten, was derzeit in der Software passiert.
Kurzfassung:
- Der Abstand hat sich geschlossen, und wir können das datieren. Im Juli 2023 verlor das beste offene Modell bei MMLU um 17,5 Punkte und bei HumanEval um 37,1 Punkte gegen GPT-4. Im August 2026 schlägt ein offenes 27B-Modell das proprietäre Flaggschiff vom Februar in 15 von 19 Benchmarks, die beide veröffentlichen, sowie in einem unabhängigen Gesamtindex.
- Der Preis fiel in 23 Monaten um rund das 208-Fache, gemessen von Epoch AI bei fixer Leistungsschwelle. Das heutige offene 27B kostet gemischt 1,09 US-Dollar je Million Token, Opus 4.6 Max 10,00 US-Dollar. Wer selbst betreibt, zahlt null je Token.
- Es ist nicht die Spitzenklasse, und das sagen wir auch. Claude Opus 5 Max erreicht 63,1, GPT-5.6 Sol Max 60,9. Beim breiten Wissensschließen verliert das 27B deutlich gegen Opus 4.6: 30,8 zu 40,0 auf HLE.
Bild: Steve Jurvetson, Wikimedia Commons, CC BY 2.0. Die Verbindungsebene eines Cray Y-MP, um 1988. Ernsthafte Rechenleistung war früher ein Raum, den man betrat.
So sah das „Vorher“ tatsächlich aus
Stellen wir die Uhr auf den 18. Juli 2023, den Tag, an dem Meta Llama 2 veröffentlichte. Es war das beste frei herunterladbare Modell der Welt, und sein eigenes Paper druckte die Gegenüberstellung mit der geschlossenen Spitzenklasse ohne Beschönigung ab.
Llama 2 70B erreichte 68,9 bei MMLU, GPT-4 lag bei 86,4. Bei GSM8K standen 56,8 gegen 92,0. Bei HumanEval, dem Coding-Benchmark, 29,9 gegen 67,0 — weniger als die Hälfte. Die Zusammenfassung im Paper selbst lautet: „Zwischen Llama 2 70B und GPT-4 sowie PaLM-2-L besteht weiterhin eine große Leistungslücke.“ Das ist das Flaggschiff der offenen Gewichte im Jahr 2023, in seinen eigenen Worten.
Nun zur Hardware. TheBlokes 4-Bit-Community-Build von Llama 2 70B — die übliche Art, das Modell zu betreiben — war eine Datei von 41,4 GB, veröffentlicht am 4. September 2023. Für brauchbare Geschwindigkeit brauchte man zwei Grafikkarten mit je 24 GB oder einen Mac mit 64 GB. Auf ein normales Notebook passte Llama 2 13B: eine Datei von 7,9 GB mit 54,8 Punkten bei MMLU, also 31,6 Punkte hinter GPT-4 und jenseits von Demos kaum zu gebrauchen.
Die Wahl im Jahr 2023 lautete also: einem Spitzenlabor Geld zahlen oder etwas sichtbar Schlechteres auf Hardware betreiben, die die meisten nicht besaßen. Genau deshalb hat das Argument „nimm einfach die API“ zwei Jahre lang so deutlich gewonnen. Es war richtig.
Dieselbe Frage im August 2026
Alibaba veröffentlichte Qwen3.8-27B am 14. August 2026 unter Apache 2.0 und druckte auf der Modellkarte eine direkte Gegenüberstellung mit Claude Opus 4.6 Max ab. Wir haben jede Zeile gezählt, in der beide Modelle einen Wert angeben.
Qwen3.8-27B gewinnt 15 dieser 19 Zeilen und verliert 4. Zu den Siegen zählen SWE-bench Pro (61,7 gegen 53,4), Anweisungstreue bei IFBench (79,5 gegen 62,5), Wettbewerbsprogrammierung bei LiveCodeBench v6 (90,3 gegen 88,8), Rechnerbedienung bei OSWorld-Verified (84,3 gegen 72,7), mobile Agentenaufgaben bei AndroidWorld (81,9 gegen 62,0) sowie eine lange Reihe multimodaler Benchmarks mit deutlichen Abständen: 90,0 gegen 65,5 bei MathVision, 83,7 gegen 66,0 bei der Diagrammanalyse in CharXiv, 65,5 gegen 40,8 beim verkörperten Schließen in ERQA.
Die vier Niederlagen wiegen schwerer als die Siege, weil sie zeigen, was ein Modell mit 27 Milliarden Parametern noch nicht kann. Es verliert bei Terminal Bench 2.1 (73,0 gegen 78,2), bei der Code-Erzeugung auf Repository-Ebene in NL2Repo-Bench (42,3 gegen 47,6), knapp bei GPQA Diamond (89,2 gegen 91,3) und deutlich bei HLE, dem Benchmark für breites fachübergreifendes Schließen: 30,8 gegen 40,0. Der letzte Wert beschreibt die Form der ganzen Einschränkung. Das Wissen der Welt lässt sich nicht in eine Datei von 16,5 GB komprimieren; eine enorme Menge an Können dagegen schon.
Eine Zeile verdient eine Fußnote: Das Ergebnis 79,0 gegen 63,8 stammt aus QwenSWEBench, einem von Qwen selbst gebauten Benchmark. Herstellerläufe auf herstellereigenen Benchmarks sind die schwächste Evidenz in jeder Modellkarte, und wir stützen uns nicht darauf.
Die unabhängige Wertung sagt dasselbe
Herstellertabellen bleiben Herstellertabellen, deshalb hier eine dritte Partei. Artificial Analysis, das eigene Evaluationen durchführt statt fremde Zahlen abzudrucken, hat das 27B inzwischen vermessen. Stand 21. August 2026 vergibt es an Qwen3.8-27B einen Intelligence Index von 52,0 und damit Platz 1 von 135 Modellen in der Klasse offener Gewichte mit 4 bis 40 Milliarden Parametern; Claude Opus 4.6 Max liegt bei 44,9. Das sind 7,1 Punkte Vorsprung für das offene Modell, gemessen von einer Stelle ohne eigenes Interesse am Ergebnis, 190 Tage nach dem Erscheinen von Opus 4.6.
Verfolgt man diesen Vergleich zurück, ergibt sich die eigentliche Geschichte. Im Juli 2023 erreichte das beste offene Modell unter 40 Milliarden Parametern im selben Index 2,6 Punkte. Im Juli 2024 waren es 7,4. Im März 2025 13,4. Im Februar 2026 34,6. Vergangene Woche 52,0.
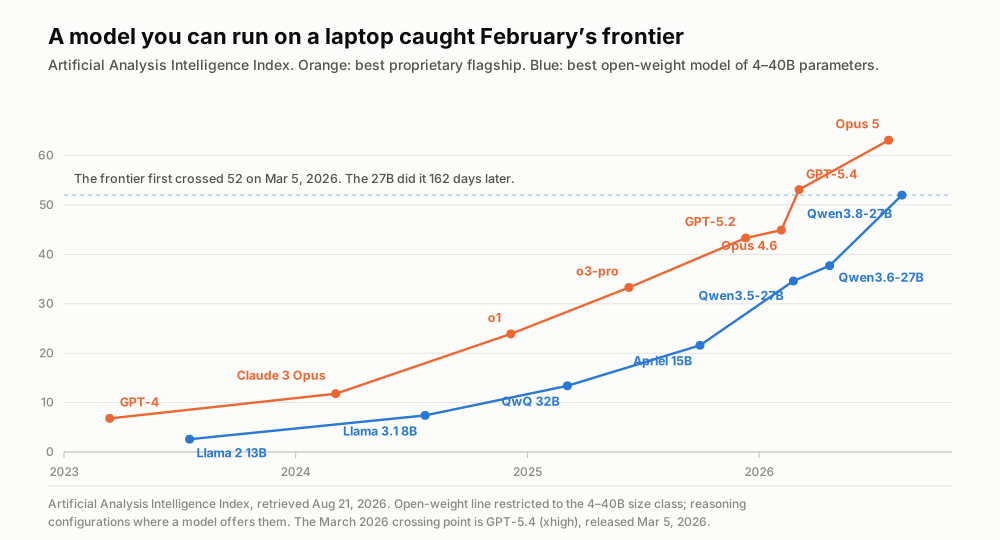
Beide Linien steigen; interessant ist der horizontale Abstand zwischen ihnen. Artificial Analysis Intelligence Index, abgerufen am 21. August 2026.
Eine Zahl verdient einen Namen. Die Spitzenklasse überschritt einen Intelligence Index von 52 erstmals am 5. März 2026, als GPT-5.4 bei maximaler Denkstufe 53,1 erreichte. Ein Modell, klein genug für einen persönlichen Rechner, kam am 14. August dort an — 162 Tage später. Nennen wir es die Aufholzeit: die Spanne zwischen dem Auftauchen einer Fähigkeit an der Spitze und ihrem Auftauchen auf der eigenen Hardware.
Diese Spanne war früher deutlich länger. Llama 3.1 8B brauchte 260 Tage bis zu einem Niveau, das GPT-4 Turbo erreicht hatte. GLM-4.7-Flash brauchte 410 Tage, um o1 einzuholen. Die letzten drei Veröffentlichungen in Notebook-Größe lagen bei 201, 155 und 162 Tagen. Die Spitze wird nicht langsamer — Opus 5 Max steht heute bei 63,1 —, aber die nachrückende Kante holt etwa doppelt so schnell auf wie vor zwei Jahren.
Der Preis ist nicht gefallen, er ist eingebrochen
Fähigkeit ist die eine Hälfte des Vergleichs. Die andere ist die Rechnung.
Epoch AI hat das im März 2025 am saubersten vermessen, und die Methode lohnt das Verständnis: einen Benchmark-Wert festhalten und dann verfolgen, welches Modell diesen Wert im Zeitverlauf am günstigsten erreicht. Setzt man die Schwelle auf GPT-4s 86 Punkte bei MMLU, verläuft die Leiter über 37,50 US-Dollar je Million Token im März 2023, 15,00 im November 2023, 7,50 im Mai 2024, 2,19 noch im selben Monat und 0,18 im Februar 2025. Der Wert bleibt gleich. 208-mal günstiger in 23 Monaten.
Epochs Hauptbefund lautet, dass die Rate je nach Aufgabe stark schwankt — zwischen dem 9-Fachen und dem 900-Fachen pro Jahr, je nachdem, welche Fähigkeit man festhält —, wobei der Preis für GPT-4-Niveau bei naturwissenschaftlichen Fragen auf Promotionsniveau um etwa das 40-Fache pro Jahr sank. Die Richtung ändert sich nie.
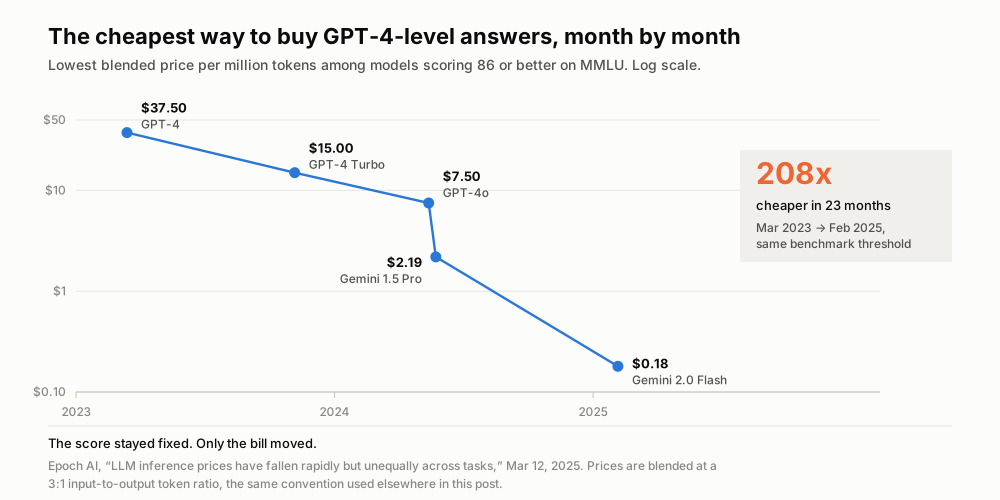
Der Benchmark-Wert ist an jedem Punkt dieser Linie konstant. Epoch AI, 12. März 2025.
Verlängert man die Reihe mit aktuellen Preisen, geht es weiter. Im OpenRouter-Katalog kostet Qwen3.8-27B am 21. August 2026 0,45 US-Dollar je Million Eingabe-Token und 3,20 je Million Ausgabe-Token; Claude Opus 4.6 kostet 5,00 und 25,00. Gemischt nach Epochs Verhältnis von 3:1 sind das 1,09 gegen 10,00 US-Dollar — das offene Modell ist 9,1-mal günstiger und 7,1 Indexpunkte besser als das geschlossene Flaggschiff von vor einem halben Jahr.
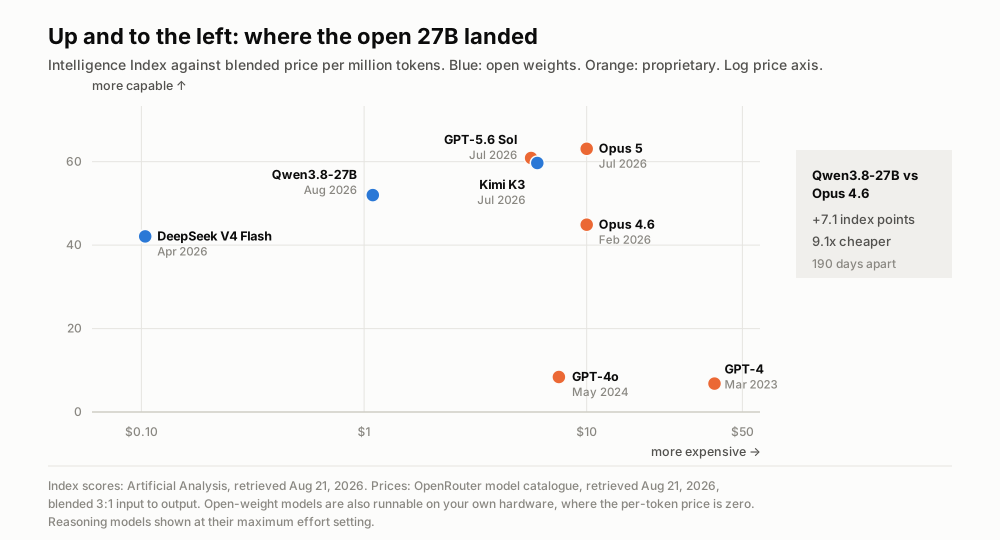
Alle relevanten Modelle wandern in die linke obere Ecke. Werte von Artificial Analysis, Preise von OpenRouter, beide abgerufen am 21. August 2026.
Und dann gibt es die Option ohne jeden Token-Preis. Betreibt man das 27B auf einer eigenen RTX 4090 mit den rund 48 Token pro Sekunde, die Anwender im Veröffentlichungs-Thread berichteten, und nimmt die 450 Watt Nennleistung der Karte an, ergibt sich beim US-Durchschnittspreis für Haushaltsstrom von 18,44 Cent je Kilowattstunde (EIA, Mai 2026) ein Stromkostenanteil von etwa 0,48 US-Dollar je Million Ausgabe-Token — die Karte noch nicht eingerechnet, dafür aber auch niemandes Marge. Das ist eine gerechnete Schätzung mit offengelegten Annahmen, keine Herstellerangabe.
Vorher und nachher, Zeile für Zeile
| Juli 2023 | August 2026 | |
|---|---|---|
| Bestes herunterladbares Modell | Llama 2 70B (Meta, 18. Juli 2023) | Qwen3.8-27B (Alibaba, 14. August 2026) |
| Parameter | 70 Mrd. | 27 Mrd. |
| Üblicher 4-Bit-Community-Build | 41,4 GB | 16,5 GB |
| Kleinster brauchbarer Build | 7,9 GB (13B, MMLU 54,8) | 9,8 GB (2 Bit, 128K Kontext auf einer 16-GB-Karte) |
| Realistische Hardware | zwei 24-GB-GPUs oder ein 64-GB-Mac | eine 16-GB-Consumer-GPU |
| Spitzenmodell der Zeit | GPT-4 (14. März 2023) | Claude Opus 4.6 Max (5. Februar 2026) |
| Ergebnis dagegen | −17,5 MMLU, −35,2 GSM8K, −37,1 HumanEval | 15 von 19 Benchmarks gewonnen, +7,1 Indexpunkte |
| Gemischter Preis dieses Spitzenmodells | 37,50 USD je Mio. Token | 10,00 USD je Mio. Token |
| Gemischter Preis des offenen Modells | nicht in großem Maßstab angeboten | 1,09 USD je Mio. Token |
| Lizenz | Llama 2 Community License | Apache 2.0 |
Die Quellen für jede Zelle stehen am Ende. Die Zeile, auf die wir immer wieder zurückkommen, ist die vorletzte: Der Preis der Spitzenklasse selbst fiel in drei Jahren um das 3,75-Fache, während die offene Alternative darunter bei etwa einem Zehntel davon auftauchte. Beides ist geschehen. Das Zweite verändert, wer überhaupt bauen kann.
Was weiterhin nicht stimmt
Die Begeisterung um diese Veröffentlichung eilt der Evidenz an vier Stellen voraus. Halten wir sie fest.
Es ist nicht die Spitzenklasse. Claude Opus 5 Max erreicht im selben Index 63,1 und GPT-5.6 Sol Max 60,9, beide klar über 52,0. Wer auf das schwierigste verfügbare Schließen angewiesen ist, arbeitet weiterhin mit einem anderen Produkt, und dieses ist weiterhin geschlossen.
Für seine Größe ist es nicht günstig. Artificial Analysis selbst nennt Qwen3.8-27B „besonders teuer im Vergleich zu anderen offenen Modellen ähnlicher Größe“ — der Median in dieser Klasse liegt bei 0,05 US-Dollar je Million Eingabe-Token, Qwen bei 0,43. Bezahlt wird Fähigkeit, nicht Parameterzahl.
Es ist wortreich, und Wortreichtum ist eine Rechnung. Für den Intelligence Index erzeugte das 27B 160 Millionen Ausgabe-Token gegenüber einem Median von 45 Millionen. Ein Anwender gab ihm auf einem Mac mini mit 64 GB einen Prompt aus zwei Wörtern und sah 17 Minuten und 12 Sekunden beim Nachdenken zu. Denkende Modelle stellen die Uhrzeit in Rechnung, auch wenn die Token nichts kosten.
Und die Benchmark-Werte gehören dem Modell in voller Genauigkeit. Der 2-Bit-Build mit 9,8 GB, der auf Ihre Grafikkarte passt, ist nicht das Modell, das 52,0 erreicht hat. Starke Quantisierung kostet Genauigkeit, besonders über lange Kontexte. Jede Aussage „läuft auf einem Notebook“, auch unsere, trägt diesen Vorbehalt.
Warum die Aufholzeit weiter schrumpfen dürfte
Ab hier folgt unsere Einschätzung, und wir markieren den Übergang deutlich: Alles Bisherige ist Messung, was folgt, ist Schlussfolgerung daraus.
Der Mechanismus hinter der schrumpfenden Aufholzeit ist nicht rätselhaft. An der Spitze veröffentlichte Nachtrainingsverfahren werden binnen Monaten in offenen Laboren reproduziert. Die Steuerung der Denkstufe, vor anderthalb Jahren noch ein proprietärer Kniff, erscheint auf dieser Modellkarte als dokumentierter Parameter. Community-Quantisierungen sind fertig, bevor die Dokumentation des ursprünglichen Labors ihre endgültige Fassung erreicht. Keine dieser drei Rückkopplungsschleifen hat einen Grund, langsamer zu werden, und zwei werden schneller, je mehr Menschen mitmachen.
Die vernünftige Erwartung für die nächste Generation ist deshalb nicht, dass offene Modelle die Spitze überholen. Sie lautet, dass sich die 162 Tage weiter verdichten, während die absolute Leistungsfähigkeit an beiden Enden steigt. Damit ist die interessante Schwelle nicht mehr „können offene Modelle gewinnen“, sondern „wie aktuell muss die Spitze sein, damit der Unterschied für meine Aufgabe keine Rolle mehr spielt“. Für Transkription, Übersetzung, Zusammenfassung und die meiste Dokumentenarbeit ist diese Schwelle längst überschritten. Für Spitzenforschung und die schwierigste agentische Entwicklung nicht.
Das ist eine deutlich bessere Lage als 2023, und das darf man aussprechen. Die Kosten dafür, einem Rechner ein kompetentes Sprachverständnis zu geben, sind in drei Jahren um zwei Größenordnungen gefallen und fallen weiter. Am meisten profitieren die, die zuvor am Preis scheiterten: Einzelentwickler, Teams in Ländern, in denen 10 US-Dollar je Million Token kein Rundungsfehler sind, Forschende mit Fördermitteln statt Budget und alle, deren Daten aus rechtlichen Gründen auf dem eigenen Rechner bleiben müssen.
Fazit: Die Spitze ist kein Ort mehr, sondern ein Datum
Die alte Frage war, zu welchem Labor man Zugang hat. Die neue Frage lautet, wie viele Monate hinter der Spitze man zu liegen bereit ist, wenn das ein Neuntel kostet und auf eigener Hardware läuft.
Für immer mehr Aufgaben ist die ehrliche Antwort: etwa fünf Monate, Tendenz fallend.
Wo Telli.sh hineinpasst: All das ist der Grund, warum wir auf offenen Modellen aufbauen statt rund um einen einzelnen Anbieter. Telli.sh nutzt in der Zusammenfassung bereits ein offenes Qwen-Modell, sodass jeder Schritt auf dieser Kurve als bessere Besprechungsnotiz ankommt und nicht als Preisankündigung. Unsere Arbeit steckt in dem Teil, den kein Download liefert: eine Stunde Audio zuverlässig aufnehmen, Sprecher auseinanderhalten, live in 15 Sprachen übersetzen und daraus Notizen machen, die auch Monate später noch auffindbar sind.
Quellen
- Modellkarte und Benchmark-Tabellen zu Qwen3.8-27B, Hugging Face — Direktvergleich mit Opus 4.6 Max, abgerufen am 21. August 2026
- Artificial Analysis: Qwen3.8 27B, Analyse von Intelligenz, Leistung und Preis — Intelligence Index 52,0, Preis- und Verbositätswerte, abgerufen am 21. August 2026
- Artificial Analysis: Modellseite zu Claude Opus 4.6 — Intelligence Index 44,9 bei maximaler Denkstufe, abgerufen am 21. August 2026
- Epoch AI, „LLM inference prices have fallen rapidly but unequally across tasks“, 12. März 2025 — Preisleiter bei fixer Schwelle und die Spanne vom 9- bis 900-Fachen
- Llama 2: Open Foundation and Fine-Tuned Chat Models (arXiv:2307.09288), 18. Juli 2023 — Tabelle 4, Llama 2 70B gegen GPT-4
- Dateiliste von TheBloke/Llama-2-70B-Chat-GGUF — 41,4-GB-Build Q4_K_M, veröffentlicht am 4. September 2023
- Dateiliste von unsloth/Qwen3.8-27B-GGUF — Builds mit 16,5 GB und 9,8 GB, Downloadzahlen abgerufen am 21. August 2026
- OpenRouter-Modellkatalog — Token-Preise für Qwen3.8-27B, Claude Opus 4.6 und Claude Opus 5, abgerufen am 21. August 2026
- Hacker-News-Diskussion zur Veröffentlichung von Qwen3.8-27B, 14. August 2026 — Durchsatzberichte von Anwendern auf 16- und 24-GB-Karten
- US Energy Information Administration, Electric Power Monthly, Tabelle 5.3 — 18,44 Cent je Kilowattstunde im Haushaltsdurchschnitt, Mai 2026
- Unsere frühere Berichterstattung zur Veröffentlichung der Qwen3.8-Gewichte und zur breiteren Welle offener Gewichte
- Wikimedia-Commons-Seite zur Cray-Y-MP-Aufnahme
