Chinas Open-Weight-Sprint in drei Wochen: Kimi K3, Qwen3.8-Max und die Wende, die alles beenden könnte
In drei Wochen haben Chinas größte KI-Labore Open-Weight-Modelle der Spitzenklasse veröffentlicht oder angekündigt – Kimi K3, Qwen3.8-Max und DeepSeek V4 in allgemeiner Verfügbarkeit. Ein Leitfaden in einfacher Sprache: was jedes Modell ist, was wirklich erschienen ist und was noch Versprechen bleibt, und warum Peking die selbst ausgelöste Welle nun regulieren könnte.
Zwischen dem 16. und 26. Juli legten drei der größten KI-Labore Chinas Open-Modelle der Spitzenklasse auf den Tisch. Moonshot AI kündigte Kimi K3 am 16. Juli an und veröffentlichte die Gewichte am 26. Juli. Alibaba stellte Qwen3.8-Max am 19. Juli auf der WAIC in Shanghai vor. DeepSeeks V4-Reihe erreichte um den 20. Juli die allgemeine Verfügbarkeit (GA). Drei Labore, rund drei Wochen.
Das Muster ist kaum zu übersehen, und es ist nicht das, mit dem sich die chinesische Open-Modell-Szene ihren Ruf erarbeitet hat. Diese Labore waren für kleine, schnelle, günstige Modelle bekannt, die über ihrem Gewicht boxten. Diese Welle ist die entgegengesetzte Wette: Systeme mit Billionen von Parametern, veröffentlicht oder als Open Weights versprochen.
Dies ist eine ehrliche Einordnung dieser Welle – was wirklich erschienen ist, was noch Vorschau oder Versprechen bleibt, und die Wende, die mit ihr kam: Ebendie Regierung, die diese Veröffentlichungen ermöglicht hat, wägt nun ab, ob sie sie einschränken soll. Wir halten den Fachjargon so knapp wie möglich und erklären den Rest unterwegs, damit Sie der Geschichte folgen können, selbst wenn „Open Weights“ und „Mixture-of-Experts“ neu für Sie sind. Wenn Sie unseren Juli-Überblick gelesen haben, ist dies die Fortsetzung – und einer seiner offenen Fäden hat sich aufgelöst.
Image: OLCF at ORNL, Wikimedia Commons, CC BY 2.0.
Zuerst die fünf Begriffe, mit denen alles Sinn ergibt
Wenn Sie in dieser Ecke der KI neu sind, tragen fünf Begriffe den Großteil der Geschichte, und es lohnt sich, sie vor den Modellen in einfacher Sprache kurz durchzugehen.
„Open Weights“ sind der ganze Grund, warum diese Welle zählt. Die Gewichte eines Modells sind das riesige Gitter aus Zahlen, das es beim Training gelernt hat – faktisch das fertige Gehirn. Wenn ein Labor die Gewichte freigibt, können Sie diese Datei herunterladen, das Modell auf Ihrer eigenen Hardware laufen lassen, es anpassen und Produkte darauf bauen, ohne jemanden um Erlaubnis zu fragen oder pro Anfrage zu zahlen. Die Alternative ist ein geschlossenes Modell, wie die meisten kommerziellen Chatbots, bei denen die Gewichte auf den Servern des Anbieters bleiben und Sie den Zugang über eine kostenpflichtige API mieten. Open Weights verwandeln ein Modell von einem Dienst, den man mietet, in etwas, von dem man eine Kopie besitzt – und genau dieser Unterschied ist der Grund, warum eine ganze Branche aufhorcht, wenn ein gutes erscheint.
„Parameter“ sind jene gelernten Zahlen, und ihre Anzahl ist der grobe Näherungswert dafür, wie viel ein Modell fassen kann. Ein Modell mit „2,8 Billionen Parametern“ hat 2,8 Billionen davon. Größer ist nicht automatisch besser, aber an der Spitze bedeutet es meist mehr Spielraum zum Schlussfolgern – und, ebenso wichtig, mehr Hardware, um es zu betreiben. Hier kommt „Mixture-of-Experts“ (MoE) ins Spiel. Statt für jedes Wort alle Parameter zu zünden, ist ein MoE-Modell in viele spezialisierte Teilnetze namens Experten aufgeteilt, und ein Router wählt für jeden Token nur eine Handvoll aus. Wenn also „2,8 Billionen gesamt, 104 Milliarden aktiv“ dasteht, heißt das: Das Modell ist riesig, aber in jedem Moment arbeiten nur etwa 104 Milliarden Parameter – wie ein Krankenhaus mit Tausenden Fachärzten, bei dem jeden Patienten nur die wenigen zuständigen sehen. Die Gesamtzahl deutet an, wie leistungsfähig es sein kann; die Aktivzahl sagt, wie teuer es im Betrieb ist. Diese Lücke ist die einzige nützlichste Zahl, um Kosten zu beurteilen.
Ein „Kontextfenster“ ist, wie viel Text das Modell auf einmal im Kopf behalten kann, gezählt in Tokens – und ein Token entspricht etwa drei Vierteln eines Wortes. Ein Fenster von einer Million Token ist keine abstrakte Angabe: Es sind mehrere lange Romane oder Dutzende einstündiger Meeting-Transkripte in einem einzigen Durchgang. Es ist der Unterschied zwischen dem Zusammenfassen einer einzelnen E-Mail und dem Schlussfolgern über ein ganzes Quartal davon.
Zuletzt die Lizenz – und das ist der Teil, den Fachleute zuerst lesen sollten, vor den Benchmarks. Die Lizenz ist das juristische Kleingedruckte, das festlegt, was Sie mit den Gewichten tun dürfen. MIT ist der Goldstandard: nutzen, verändern, in ein kommerzielles Produkt einbauen – Sie schulden nichts. Eine eigene Lizenz kann offen aussehen und dabei genau den Anwendungsfall ausklammern, den Sie im Sinn hatten – etwa indem sie Sie zur Kasse bittet, sobald das darauf aufgebaute Geschäft groß wird. Zwei Modelle können beide „Open Weights“ sein und Welten auseinanderliegen in dem, was rechtlich erlaubt ist. Es zahlt sich also aus, diese Zeile zu lesen, bevor Sie sich in eine Punktzahl verlieben. Mit diesen fünf Begriffen in der Hand liest sich die Welle klar.
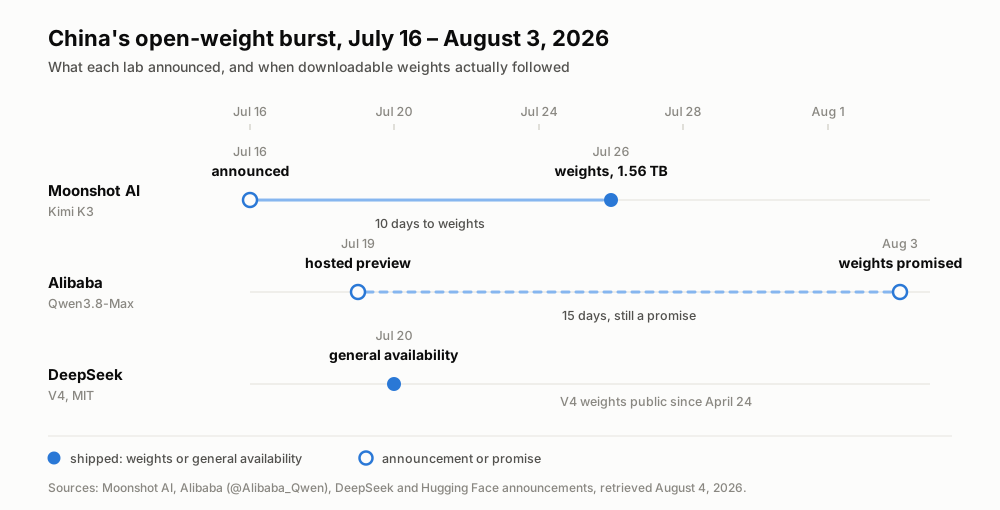
Drei Labore, drei Wochen — und nur zwei dieser fünf Momente haben tatsächlich Gewichte in fremde Hände gelegt. Daten aus den Ankündigungen der Labore selbst, abgerufen am 4. August 2026.
Kimi K3 ist das, was tatsächlich erschienen ist
Beginnen wir mit Moonshot AI, dem Pekinger Labor hinter dem Kimi-Assistenten, das sich im vergangenen Jahr einen Ruf für große, leistungsfähige Open-Modelle erarbeitet hat. Als wir im Juli über Kimi K3 schrieben, waren die Gewichte noch ein Versprechen – Moonshot hatte „bis zum 27. Juli“ gesagt. Sie kamen am 26. Juli: 1,56 Terabyte in 96 Shards auf Hugging Face unter moonshotai/Kimi-K3. Das ist die Nachricht. Eine Ankündigung ist eine Pressemitteilung; herunterladbare Gewichte sind eine Tatsache, auf der man aufbauen kann.
In einfachen Worten ist K3 eines der größten je veröffentlichten Open-Modelle – ein Mixture-of-Experts-System mit 2,8 Billionen Parametern insgesamt und rund 104 Milliarden aktiv pro Token, das über einen von Moonshot „Kimi Delta Attention“ genannten Mechanismus etwa 16 von 896 Experten ansteuert, mit einem Kontextfenster von einer Million Token und einem berichteten Zuwachs der Skalierungseffizienz von rund 2,5x gegenüber dem Vorgänger K2. Aus dem Datenblatt übersetzt: Es ist sehr groß, für seine Größe vergleichsweise günstig zu betreiben, weil pro Token nur ein Bruchteil zündet, und es kann buchlange Eingaben am Stück verschlucken.
Diese Zahlen sagen auch, wer es tatsächlich betreiben wird. 1,56 Terabyte in 96 Shards sind kein Laptop-Download; es ist ein Artefakt der Datacenter-Klasse, das allein zum Laden einen Cluster aus High-End-Beschleunigern braucht. In der Praxis wird kaum jemand K3 selbst hosten – man erreicht es über Anbieter, die die Hardware bereits besitzen, und dieser Markt war am ersten Tag da: Together AI und Modal stellten in dem Moment, als die Gewichte landeten, gehostete Kimi-K3-Endpunkte bereit. So probiert es auch ein neugieriger Leser heute aus – nicht durch das Herunterladen von 1,56 TB, sondern indem er einen dieser gehosteten Endpunkte aufruft oder die Kimi-App nutzt. „Offen“ heißt hier, dass die Gewichte öffentlich sind und jeder mit der passenden Hardware sie bereitstellen kann, was genau den Preiswettbewerb aufrechterhält; es heißt nicht, dass Sie es persönlich auf Ihrem Schreibtisch laufen lassen.
Ist es gut? Nach der einen unabhängigen Zahl, der wir diese Runde trauen, ja. In der Rangliste von Artificial Analysis belegte es Platz 4 von 189 Modellen – hinter Claude Fable 5 und zwei GPT-5.6-„Sol“-Konfigurationen, vor Opus 4.8 und GPT-5.5. Für ein Open-Modell, das man herunterladen kann, ist allein diese Gesellschaft die Geschichte.
Lesen Sie dann die Lizenz, denn hier bekommt „offen“ ein Sternchen. Kimi K3 ist nicht MIT. Es erscheint unter einer eigenen „Kimi K3 License“, die nicht OSI-anerkannt ist und eine Umsatzschwellenklausel enthält: Wer K3 als Motor eines großen Model-as-a-Service-Geschäfts betreibt, braucht eine gesonderte Vereinbarung mit Moonshot. Für einen Einzelentwickler oder ein normales Unternehmen, das es intern nutzt, ändert das nichts. Für alle jedoch, die ein gehostetes Produkt in großem Maßstab bauen, sind „offene Gewichte“ und „offene Lizenz“ zwei verschiedene Fragen – und hier ist nur die erste ein eindeutiges Ja.
Qwen3.8-Max ist eine Vorschau, kein Download
Qwen ist Alibabas Modellfamilie, und ihr Team gehört zu den produktivsten Open-Modell-Veröffentlichern der Welt – genau deshalb ist das neueste so verwirrend. Am 19. Juli auf der WAIC in Shanghai vorgestellt, ist Qwen3.8-Max die größte Schlagzeile der Welle und zugleich die weichste. Es ist ein Sparse-MoE mit 2,4 Billionen Parametern – aktive Parameter nicht offengelegt – und das erste Qwen jenseits einer Billion Parameter, das multimodal ist, also nicht nur Text, sondern auch Bild, Video und Dokumente als Eingabe verarbeitet.
Hier ist der Haken, den ein Einsteiger buchstabiert braucht: Trotz des Getöses können Sie es nicht herunterladen. Derzeit existiert es nur als „gehostete Vorschau“ – qwen3.8-max-preview, erreichbar über Alibabas eigenen Dienst (dessen Token Plan und das Qoder-Tool) zu rund 10 % des Standardpreises. Eine gehostete Vorschau bedeutet, dass Alibaba das Modell auf seinen Servern betreibt und Sie es aufrufen lässt; es ist das Miet-API-Modell, nicht das Besitz-eine-Kopie-Modell. Es heute als Open-Weight-Release zu bezeichnen, ist verfrüht.
Dieses Bild änderte sich am 3. August. Der offizielle Qwen-Account auf X, @Alibaba_Qwen, postete, dass die Open Weights von Qwen3.8-Max „nächste Woche“ kämen – und dass ein kleineres Qwen3.8-27B ebenfalls als Open Weights erscheine. Das 27B ist also kein Gerücht, was auch immer frühere Wortmeldungen andeuteten: Es ist eine schriftlich festgehaltene Zusage von Alibabas eigenem Account. Und die Größe ist der Punkt. Wo das 2,4-Billionen-Parameter-Max wie K3 nur ein Rechenzentrum betreibt, ist ein 27B klein genug, um auf einer einzigen High-End-Maschine bereitgestellt zu werden – die Klasse, die ein Einzelner oder ein kleines Team tatsächlich selbst hosten kann. Das entschärft das Bild „versprochen ohne Details“ tatsächlich: Jetzt gibt es eine Größe und einen groben Zeitrahmen.
Die ehrlichen Vorbehalte gelten dennoch. „Nächste Woche“ ist eine Richtung, kein Versanddatum, und zum Zeitpunkt dieses Textes am 4. August ist bei der Qwen-Organisation auf Hugging Face nichts gelandet – ihre neuesten Modelle dort stammen aus dem Juni. Auch die Open-Weight-Lizenz wurde nicht veröffentlicht, und frühe Leser der Vorschaubedingungen haben mögliche regionale Beschränkungen angemerkt, unbestätigt, bis die echte Lizenz erscheint – genau die Lizenz-zuerst-Lehre aus dem Grundlagenteil. Alibabas Behauptung, das Modell sei „nur Fable 5 unterlegen“, bleibt eine Eigenangabe ohne Zahlen Dritter, also behandeln Sie sie als Marketingzeile eines Anbieters, bis jemand außerhalb Alibabas nachmisst. Wenn Sie das Modell heute ausprobieren wollen, ist die gehostete Vorschau die einzige Tür – aber zum ersten Mal misst sich die Wartezeit auf herunterladbare Gewichte in „nächster Woche“, nicht in „irgendwann“.
DeepSeek V4 erreichte still die allgemeine Verfügbarkeit
DeepSeek ist das Labor, dessen R1-Modell Anfang 2025 das aktuelle Open-Modell-Rennen mit anstieß, und ganz in dieser Manier machte es hier am wenigsten Aufhebens und lieferte das Brauchbarste. Seine V4-Reihe, bereits am 24. April veröffentlicht, ist die, die man am unkompliziertesten übernehmen kann, weil sie unter der Lizenz erscheint, die der Grundlagenteil als Goldstandard markiert hat.
V4 kommt in zwei Größen, beide MIT-lizenziert. V4-Pro ist das Flaggschiff mit 1,6 Billionen gesamt und 49 Milliarden aktiven Parametern; V4-Flash ist der Leichtgewichtler mit 284 Milliarden gesamt und 13 Milliarden aktiven. Erinnern Sie sich, was die Aktivzahl bedeutet: V4-Flash zündet nur 13 Milliarden Parameter pro Token, was den Betrieb billig und schnell macht – und genau das macht es zur günstigen Wahl für Arbeit mit hohem Volumen, jene Transkribier-und-Zusammenfassen-Last, bei der die Kosten pro Token über alles entscheiden. Beide bieten ein Kontextfenster von einer Million Token und können in einer einzigen Antwort bis zu 384K Token Ausgabe erzeugen – genug, um einen langen Bericht zu entwerfen, nicht nur einen Absatz. Um den 20. Juli erreichte V4 mit zeitbasierter Preisgestaltung die allgemeine Verfügbarkeit, was ein Frühjahrs-Release in denselben Drei-Wochen-Rahmen wie K3 und Qwen zog.
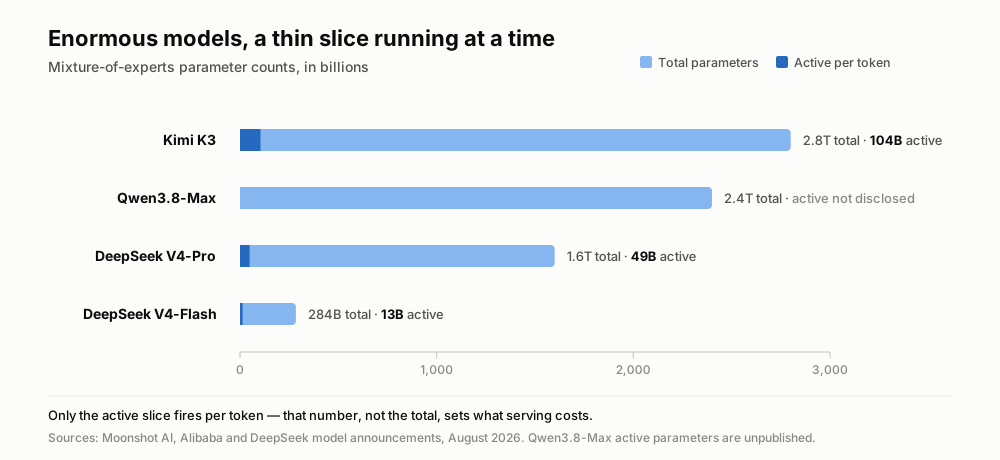
Der helle Balken ist die Größe des Modells, der dunkle Stummel der Anteil, der pro Token wirklich rechnet. Alibaba hat die aktiven Parameter von Qwen3.8-Max nicht veröffentlicht.
Weil es MIT ist, ist V4 dasjenige, auf dem ein Anwender mit den wenigsten Anwälten aufbauen kann: Gewichte holen (oder einen gehosteten Anbieter nutzen), betreiben, kommerziell ausliefern – nichts schulden, niemanden fragen. Und um bei den Versionsnummern klar zu sein, da die Gerüchteküche sie liebt – es gibt kein R2, kein V5, kein V4.1. Es gibt nur die V4-Familie, die zu etwas heranreift, auf das sich Teams verlassen können.
Der Abstand schrumpft schneller, als es die Ranglisten zugeben
Tritt man einen Schritt zurück, zählt die Steigung mehr als die einzelnen Veröffentlichungen. Nathan Lamberts Lesart: Der Abstand zwischen den besten offenen und den besten geschlossenen Modellen hat sich von rund sechs bis neun Monaten auf drei bis fünf verkürzt – „so nah waren offene Modelle der Spitze seit DeepSeek R1 nicht mehr“. Schlicht gesagt: Die frei herunterladbaren Modelle liegen nun nur noch wenige Monate hinter den besten Modellen, die man für Geld mieten kann, während sie vor einem Jahr eine bequeme Runde zurücklagen.
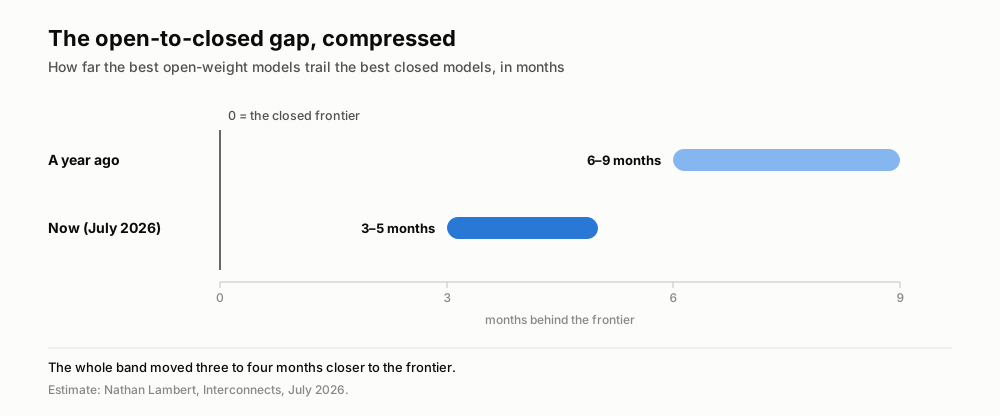
Lamberts Schätzung maßstabsgetreu gezeichnet: Das offene Feld ist nicht nur näher gerückt, das ganze Band ist enger geworden.
Die Nutzungsdaten weisen in dieselbe Richtung. Auf OpenRouter, einem Marktplatz, der Anfragen über viele Modelle verteilt, fiel der Token-Anteil US-amerikanischer Modelle von etwa 70 % im Juni 2025 auf rund 30 % ein Jahr später, während Modelle chinesischer Herkunft nun regelmäßig über 30 % liegen. Der Preis ist ein großer Grund: Chinesische Open-Modelle sind pro Token meist 60 bis 90 % günstiger, und das Hosting war sofort da, wie jene Kimi-K3-Endpunkte am Tag null zeigten.
Der leisere Wandel betrifft den Maßstab. Die Marke des chinesischen Open-Modells war klein, schnell, günstig. K3 mit 2,8 Billionen Parametern und Qwen3.8-Max mit 2,4 Billionen sind das genaue Gegenteil – eine Wette darauf, dass sich Großdenken im Offenen nun lohnt. GLM-5.2 von Z.ai, am 16. Juni unter MIT veröffentlicht und mit 51 an der Spitze der Open-Weight-Kategorie des Artificial Analysis Index, ist dieselbe Botschaft aus einem vierten Labor.
Die Wende: Die Regierung, die dies ermöglicht hat, könnte es einschränken
Dann kam die Kehrtwende. Um den 22. bis 25. Juli berichteten die Financial Times und Reuters, dass Chinas Handelsministerium Exportkontrollen für KI-Modelle – einschließlich Open-Weight-LLMs – erwägt, wobei Alibaba, ByteDance und Z.ai an den Gesprächen beteiligt sein sollen. Der ins Spiel gebrachte Rahmen ist gestuft: eine Meldepflicht für schwächere Modelle, eine Sicherheitsprüfung für stärkere und ein mögliches Verbot der öffentlichen Freigabe der leistungsfähigsten. Noch ist nichts Gesetz. Doch die Richtung ist bemerkenswert: Die Welle erreicht ihren Höhepunkt womöglich genau in dem Moment, in dem ihre eigene Regierung beginnt, diese Modelle als strategische Exportgüter statt als offene Beiträge zu behandeln.
Fazit: Wenn das Offene zum strategischen Gut wird
Die saubere Erzählung lautet „China hat aufgeholt“. Die genauere lautet: Offene Gewichte wurden so schnell zum strategischen Gut, dass eine Regierung nun die Hand am Hahn haben will. In drei Wochen holten offene Modelle von zwei bis drei Quartalen Rückstand auf die Spitze auf ein Quartal auf – und wandelten sich von klein und günstig zu einigen der größten Modelle, die je in irgendeiner Form veröffentlicht wurden. Die offene Grenze ist nicht nur weitergerückt. Sie ist an einen Ort gerückt, von dem aus ihre Schöpfer womöglich nicht weiter ausliefern dürfen.
Für Teams, die auf diesen Modellen aufbauen, bleibt die praktische Erkenntnis dieselbe und wird eine Spur schärfer. Telli.sh betreibt in seiner Zusammenfassungsschicht bereits ein Open-Modell, Qwen3, sodass jeder Zuwachs an Qualität und Preis offener Modelle direkt in Meeting-Transkription, Übersetzung und Zusammenfassungen einfließt. Der neue Posten heißt Versorgung: Sollten Chinas Exportregeln so ausfallen, wie es die Berichte nahelegen, ist die Frage, welche offenen Modelle frei herunterladbar bleiben, eher zu beobachten als vorauszusetzen. Bessere Modelle für die Schicht sind der Trend; woher diese Modelle kommen dürfen, ist das, was man im Blick behalten sollte.
Quellen
- Simon Willison on Kimi K3 weights (July 27, 2026)
- Nathan Lambert, "Kimi K3: the open-weights escalation" (Interconnects, July 20, 2026)
- Kimi K3 announcement (Moonshot AI)
- Kimi K3 weights on Hugging Face
- Artificial Analysis on Kimi K3
- Qwen (@Alibaba_Qwen), Qwen3.8-Max & Qwen3.8-27B open-weights announcement on X (Aug 3, 2026)
- Latent Space / AINews, "Qwen 3.8 Max (2.4T) and 27B, new open weights models" (Aug 4, 2026)
- WinBuzzer on DeepSeek V4 (April 27, 2026)
- The Decoder on Chinese open-model adoption
- Tom's Hardware on China's proposed AI export controls (July 2026)
- Wikimedia Commons image page
