Qwen3.8-27B Open Weights: Größen, Q4_K_M und echte 4090-/Mac-Tempos
Qwen3.8-27B steht unter Apache 2.0. Das Q4_K_M-GGUF ist 17,1 GB groß und passt auf einen 32-GB-Laptop; FP8 sind 30,9 GB. Gemessen: 48 Token/s auf einer RTX 4090, 12,75 auf einem Mac mini M4 Pro.
Am 3. August schrieb Alibabas Qwen-Account, die offenen Gewichte kämen „nächste Woche“. Das ist genau die Art von Satz, den die KI-Branche allen beigebracht hat mit Abschlag zu lesen. Zwölf Tage später gibt es nichts mehr abzuziehen: Die Gewichte des 2,4 Billionen Parameter großen Qwen3.8-Max erschienen am 12. August auf Hugging Face, und das kleine Modell — Qwen3.8-27B, unter einer schlichten Apache-2.0-Lizenz — folgte am 14. August.
Dann wurde es interessant. Noch in derselben Stunde, in der Qwen die Modellkarte des 27B fertigstellte, hatten drei verschiedene Community-Gruppen das Modell bereits in Formate übersetzt, die auf einem gewöhnlichen Rechner laufen. Zwei Tage später waren diese Umwandlungen über eine Million Mal heruntergeladen worden.
Diese Zahl ist die Geschichte, nicht die Benchmark-Tabelle. Ein Modell mit 27 Milliarden Parametern aus einem der führenden KI-Labore der Welt brauchte rund 48 Stunden von „angekündigt“ zu „läuft auf etwa einer Million Schreibtischen“. Dieser Beitrag erklärt in verständlicher Sprache, was das praktisch bedeutet: was unter welcher Lizenz erschienen ist, was der Betrieb des 27B auf vorhandener Hardware verlangt, wie weit das in drei Jahren gekommen ist — und den Teil, den die meisten Berichte auslassen: was ein lokales 27B weiterhin nicht kann.
Das Wichtigste in Kürze:
- Das Versprechen wurde gehalten. Qwen3.8-Max (2,4 Bio. gesamt / 95 Mrd. aktiv) kam am 12. August, Qwen3.8-27B am 14. August. Beide sind echte Downloads, keine gehosteten Vorschauen.
- Die Lizenzen unterscheiden sich, und dieser Unterschied wiegt schwerer als die Punktzahlen. Das 27B steht unter Apache 2.0 — keine Schwellen, keine Klauseln, kommerziell nutzbar ohne Gegenleistung. Qwen3.8-Max kommt mit einer eigenen Lizenz samt Umsatzschwelle für Model-as-a-Service-Geschäfte.
- Wer was betreiben kann, entscheidet die Größe: Max ist ein Download von 4.892 GB, das auf 4 Bit komprimierte 27B misst 17,1 GB und passt auf eine Maschine mit 32 GB. Community-Builds in 4 Bit überschritten in zwei Tagen 1,07 Millionen Downloads.
Bild: Dejan Krsmanovic, Wikimedia Commons, CC BY 2.0. Ein Modell aus einem Spitzenlabor selbst zu betreiben heißt, dass die Maschine — und ihre Wartung — Ihnen gehört.
Das Versprechen hatte ein Datum, und das Datum hielt
Am 4. August haben wir die Ankündigung selbst behandelt und das Warten als „in nächste Woche gemessen, nicht in irgendwann“ beschrieben. Weiter trug die Faktenlage damals nicht. Sie hat sich sauber aufgelöst.
Qwen3.8-2.4T-A95B — vermarktet als Qwen3.8-Max — erschien am 12. August mitsamt Lizenzdatei. Qwen3.8-27B und eine effizienzoptimierte FP8-Variante kamen am 14. August. Beide Daten liegen innerhalb des Fensters, das „nächste Woche“ bezeichnete. In einer Branche, in der angekündigte Modelle regelmäßig nie erscheinen, ist das Einhalten einer neun Tage alten mündlichen Frist für sich genommen bemerkenswert.
Die Reaktion kam sofort und fiel groß aus. Der Hacker-News-Thread zum 27B sammelte an einem Tag 1.351 Punkte und 769 Kommentare. Binnen Stunden veröffentlichten Praktiker funktionierende Serving-Konfigurationen für konkrete Hardware; jemand teilte Setups sowohl für einen NVIDIA DGX Spark als auch für eine RTX-4090-Consumer-Grafikkarte. So ging die Branche vor zwei Jahren nicht mit offenen Modellen um, als es ein Wochenendprojekt war, eine neue Architektur überhaupt zum Laufen zu bringen.
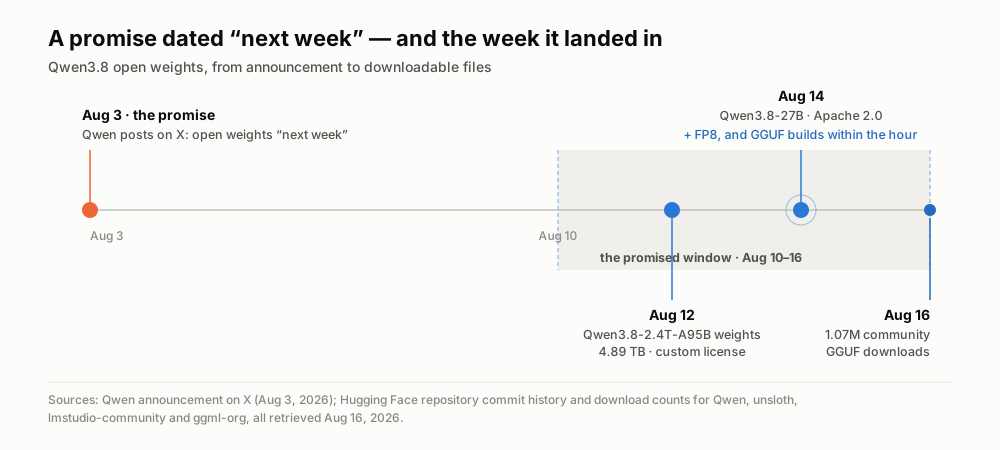
Ein Versprechen mit Datum und die beiden Lieferungen, die darin landeten. Daten aus der Commit-Historie der Hugging-Face-Repositories, abgerufen am 16. August 2026.
Fünf Begriffe, zugeschnitten auf die Frage „kann ich das betreiben?“
Wer von unseren früheren Beiträgen kommt, weiß bereits, was offene Gewichte sind: Das Labor veröffentlicht das riesige Raster gelernter Zahlen, aus dem das fertige Modell besteht, und Sie können es herunterladen, auf eigener Hardware betreiben und darauf aufbauen, ohne pro Anfrage zu zahlen. Hier geht es um die Anschlussfrage, und die ist rein praktisch: Was kostet der Betrieb an Hardware?
Parameter sind eben jene gelernten Zahlen, und ihre Anzahl bestimmt die reine Größe des Modells. Die Faustregel ist brutal einfach: In der Genauigkeit, in der Labore trainieren, entspricht jede Milliarde Parameter etwa 2 GB auf der Festplatte, und ungefähr so viel Arbeitsspeicher brauchen Sie, um das Modell im Betrieb vorzuhalten. Ein Modell mit 27 Milliarden Parametern ist also ein Download von 55 GB. Eines mit 2,4 Billionen sind knapp 5 Terabyte. Deshalb ist das eine eine Laptop-Frage und das andere eine Rechenzentrums-Frage.
Quantisierung schließt diese Lücke und ist der nützlichste Begriff für alle, die Modelle zu Hause betreiben wollen. Parameter werden normalerweise mit 16 Bit Genauigkeit gespeichert. Quantisierung rundet sie auf weniger Bits — 8, 4, manchmal 2 — und die Datei schrumpft ungefähr im gleichen Verhältnis. Vier-Bit-Quantisierung macht aus jenen 55 GB rund 17 GB. Sie verlieren etwas Genauigkeit und gewinnen die Möglichkeit, das Ganze überhaupt zu betreiben. GGUF ist schlicht das Dateiformat, in dem diese komprimierten Fassungen ausgeliefert werden; Werkzeuge wie llama.cpp, Ollama und LM Studio lesen es. „Q4_K_M“ bedeutet schlicht: der 4-Bit-Build, den die meisten verwenden.
Dicht gegen Mixture-of-Experts entscheidet, wie schnell es läuft, sobald es passt. Qwen3.8-27B ist dicht: Für jedes erzeugte Wort feuern alle 27 Milliarden Parameter. Qwen3.8-Max ist ein Mixture-of-Experts-Modell — 2,4 Billionen Parameter insgesamt, aber ein Router wählt pro Token nur etwa 95 Milliarden davon aus 512 spezialisierten Teilnetzen aus. Die Gesamtzahl nennt die Speicherrechnung, die aktive Zahl die Rechenrechnung. Diese Unterscheidung hat eine scharfe praktische Kante, auf die wir zurückkommen.
Kontextfenster ist die Menge, die das Modell auf einmal berücksichtigen kann. Das 27B verarbeitet nativ 262.144 Token — ein Stapel stundenlanger Besprechungsprotokolle — und lässt sich per Konfiguration auf eine Million dehnen.
Die Lizenz gehört zuerst gelesen
Hier steht der tragende Befund, und er widerspricht der Annahme, eine Modellfamilie teile eine Lizenzfamilie.
Qwen3.8-27B steht unter Apache 2.0. Das ist das permissive Ende: nutzen, verändern, feinabstimmen, in ein kommerzielles Produkt einbauen, ein Geschäft darauf gründen — ohne Gegenleistung und ohne jemanden zu fragen. Keine Umsatzschwellen, keine Namensnennung in der Oberfläche, keine Nutzungsausschlüsse.
Qwen3.8-Max nicht. Es erscheint unter einer eigenen „Qwen3.8-Max License“, die MIT-ähnlich beginnt und dann zwei Bedingungen anhängt. Überschreitet Ihr Produkt 100 Millionen monatlich aktive Nutzer oder 20 Millionen US-Dollar Monatsumsatz, müssen Sie den Modellnamen in der Oberfläche anzeigen. Und wer ein Model-as-a-Service- oder KI-Arbeitsassistenz-Geschäft betreibt, dessen Umsatz in zwölf zusammenhängenden Monaten 50 Millionen Dollar übersteigt, braucht vor jeder kommerziellen Nutzung eine gesonderte Vereinbarung mit Qwen.
Für Einzelentwickler oder Unternehmen mit rein interner Nutzung greift nichts davon. Aber es ist dasselbe Sternchen, das wir markiert haben, als Kimi K3 unter einer eigenen statt einer MIT-Lizenz erschien, und die Lehre wiederholt sich: „Offene Gewichte“ und „offene Lizenz“ sind zwei getrennte Fragen, und ein Labor kann sie für zwei im Abstand von zwei Tagen veröffentlichte Modelle unterschiedlich beantworten. Lesen Sie die Lizenz, bevor Sie sich in eine Punktzahl verlieben.
| Modell | Parameter gesamt | Aktiv pro Token | Downloadgröße | Lizenz | Realistische Umgebung |
|---|---|---|---|---|---|
| Qwen3.8-Max (2.4T-A95B) | 2,4 Bio. | 95 Mrd. | 4.892 GB | Eigene, Umsatzschwelle | Ein Cluster aus Beschleunigern |
| Qwen3.8-Max, FP8 | 2,4 Bio. | 95 Mrd. | 2.496 GB | Eigene, Umsatzschwelle | Ein Cluster aus Beschleunigern |
| Qwen3.8-27B | 27 Mrd., dicht | 27 Mrd. | 55,6 GB | Apache 2.0 | Workstation mit mehreren GPUs |
| Qwen3.8-27B, FP8 | 27 Mrd., dicht | 27 Mrd. | 30,9 GB | Apache 2.0 | Eine High-End-GPU |
| Qwen3.8-27B, Q4_K_M GGUF | 27 Mrd., dicht | 27 Mrd. | 17,1 GB | Apache 2.0 | Laptop mit 32 GB oder eine 4090 |
Was der Betrieb des 27B wirklich verlangt
Die ehrliche Antwort: weniger, als Sie vermuten, und mehr, als die Schlagzeilen nahelegen.
Die unterste Stufe ist ein einziger Befehl. Das 27B liegt in der Ollama-Bibliothek; ollama run qwen3.8 holt einen 18-GB-Build mit 256K Kontextfenster und Bildeingabe, es gibt zwölf Varianten, darunter eine für Apple-Silicon. LM Studio, das Ihnen statt eines Terminals ein Chatfenster gibt, hatte seinen Build binnen Minuten nach der Veröffentlichung online. Keines von beiden verlangt, dass Sie den vorigen Abschnitt verstanden haben.
Danach meldet sich die Realität in Gestalt von Token pro Sekunde. Die Messwerte, die Praktiker im Release-Thread berichteten, landeten ungefähr dort, wo die Hardware es erwarten lässt. Auf einer RTX 4090 mit dem 4-Bit-Build maß jemand rund 48 Token pro Sekunde — bequem schneller, als Sie lesen können. Auf einem Mac mini M4 Pro mit 64 GB Speicher kam ein anderer auf 12,75 Token pro Sekunde: brauchbar, aber Sie sehen ihm beim Tippen zu. Und auf einem Laptop mit AMD 7840U und 64 GB gewöhnlichem DDR5 lieferte derselbe 4-Bit-Build etwa 4 Token pro Sekunde — technisch läuft es, praktisch ist es ein Batch-Job, den man anstößt und stehen lässt.
An dieser letzten Zahl zeigt sich der Wert der Unterscheidung dicht gegen Experten. Dieselbe Person maß auf demselben Laptop ein älteres Mixture-of-Experts-Modell mit nominell größerer Parameterzahl bei rund 20 Token pro Sekunde — fünfmal schneller als das kleinere dichte Modell, weil pro Wort nur ein Bruchteil der Parameter feuert. Wer etwas für den Betrieb auf der CPU sucht, sollte nach aktiven Parametern einkaufen, nicht nach Gesamtparametern. Es ist die unintuitivste und nützlichste Lektion lokaler KI.
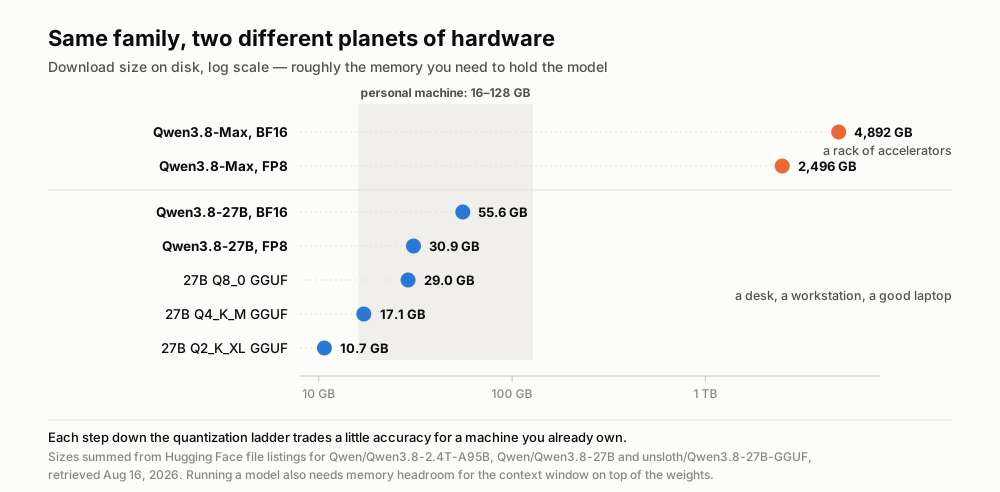
Zwei Mitglieder derselben Modellfamilie, getrennt um den Faktor 290 in der Downloadgröße. Größen summiert aus den Hugging-Face-Dateilisten, abgerufen am 16. August 2026.
Vor drei Jahren brauchte das ein Leck und ein Wochenende
Um den Sprung zu sehen, stellen Sie ihn neben den Ausgangspunkt lokaler Modelle.
Im Februar 2023 gab Meta die ursprünglichen LLaMA-Gewichte nur an zugelassene Forschende heraus. Sie leckten binnen etwa einer Woche, und die gesamte Hobbyszene für lokale Modelle wurde auf einer Datei errichtet, die dort niemand haben sollte. Am 10. März 2023 veröffentlichte ein Entwickler llama.cpp, ein kleines C++-Programm, dessen Kunststück darin bestand, das Modell mit 7 Milliarden Parametern auf einem MacBook laufen zu lassen. Dieses Repository hat heute 124.000 Sterne und ist der Vorfahr praktisch jedes „lokal betreiben“-Werkzeugs, das heute im Einsatz ist.
Vergleichen Sie die beiden Veröffentlichungstage. 2023: ein geleaktes 7B, keine nennenswerte Lizenz, eine Woche Gemeinschaftsarbeit bis zum Lauffähigen und ein Modell, das eher interessant als nützlich war. 2026: ein 27B aus einem Spitzenlabor, bewusst unter Apache 2.0 veröffentlicht, mit Bild- und Videoeingabe, 262K Kontextfenster und Community-Builds, die fertig waren, bevor die Dokumentation des Labors aufhörte sich zu ändern. Der erste Commit der unsloth-Umwandlung fiel auf 14:56 UTC am 14. August — vier Minuten vor Qwens letzter Aktualisierung der Modellkarte.
Die Nutzungszahlen sagen dasselbe deutlicher. Am 16. August verzeichneten die 4-Bit-Community-Builds des 27B 867.963 Downloads bei einem Anbieter, 171.518 bei einem zweiten und 34.520 bei einem dritten: 1,07 Millionen in zwei Tagen. Qwens eigene offizielle 27B-Repositories steuern weitere 215.000 bei. Qwen3.8-Max, das weit leistungsfähigere Modell, steht bei 17.126 über beide Repositories.
Lesen Sie dieses Verhältnis noch einmal. Das Modell in Frontier-Größe erhielt rund 1,6 Prozent der Aufmerksamkeit, die dem Laptop-tauglichen zufiel. Der Markt hat sich nicht Leistungsfähigkeit geholt. Er hat sich Reichweite geholt.
Was ein lokales 27B weiterhin nicht kann
Jetzt die Korrektur, denn die Begeisterung überholt die Belege auf vorhersehbare Weise.
Alibabas eigene Benchmark-Tabelle sieht das 27B in mehreren Maßen für agentisches Programmieren und Anweisungstreue vor Opus 4.6 Max — 61,7 gegen 53,4 bei SWE-bench Pro, 79,5 gegen 62,5 bei IFBench — während es andere verliert, darunter 30,8 gegen 40,0 beim breiten Wissenstest HLE. Jede dieser Zahlen stammt vom Anbieter selbst. Zum Zeitpunkt dieses Textes führt Artificial Analysis, der unabhängige Prüfer, auf den wir uns stützen, überhaupt keinen Eintrag zum 27B; Qwen3.8-Max steht dort auf Rang 10 von 188 Modellen mit einem Intelligenzwert von 58 — hervorragend, und eben ein anderes Modell.
Die Praktiker waren schärfer als die Tabelle. Der meistbewertete Einwand im Release-Thread, von einem erklärten langjährigen Nutzer offener Modelle, war knapp: Diese schlagen im echten Einsatz die besten gehosteten Modelle nicht; sie sind für viele Aufgaben „gut genug“ und laufen auf bezahlbarer Hardware — eine andere und bescheidenere Behauptung. Ein weiterer Kommentar formulierte die Obergrenze physikalisch: Man kann das gesamte menschliche Wissen nicht in eine 30-GB-Datei pressen, also bleiben kleine Modelle beim Abruf entlegener Fakten vergleichsweise schwach, so scharf sie beim Programmieren oder Werkzeuggebrauch auch werden.
Zwei weitere Grenzen zeigen sich erst im Betrieb. Quantisierung ist nicht umsonst: Ein stark komprimiertes Modell verliert bei langem Kontext eher den Faden und kann in Wiederholungsschleifen kippen — weshalb allen mit ausreichend Speicher die volle Genauigkeit empfohlen wird. Und diese Qwen-Generation denkt standardmäßig gründlich: Ein Nutzer gab dem 27B auf einem Mac mini mit 64 GB die zwei Wörter „svg owl“ und sah zu, wie es über 17 Minuten und 12 Sekunden 21.769 Token an Überlegung erzeugte, bevor es antwortete. Die Eule wurde gut. Es entstand aber auch eine Rechnung in Wanduhrzeit, die keine gehostete API gestellt hätte.
Und dann der Posten, den niemand zählt: Der Betrieb gehört jetzt Ihnen. Modell-Updates, Quantisierungswahl, Speicherreserve, Treiberversionen, der Lüfter der Maschine. Die gehostete API, die Sie vermeiden wollten, war auch ein Team von Menschen, das etwas am Laufen hielt.
Das Fazit: Der Burggraben ist im Stapel nach unten gewandert
Hier ist der Punkt, und er ist größer als eine Veröffentlichung.
Ein Spitzenlabor veröffentlichte an einem Donnerstag ein leistungsfähiges 27B. Am Samstag lagen über eine Million Kopien community-komprimierter Fassungen auf den Rechnern der Leute, es war in Ollama einen Befehl entfernt, und es war rechtlich frei, ein Geschäft darauf zu bauen. Welchen Vorsprung dieses Modell auch darstellt — er wurde binnen rund zwei Tagen allen Wettbewerbern gleichzeitig zugänglich. Nennen wir es den Zwei-Tage-Burggraben: ein Modellvorsprung mit einer Halbwertszeit von etwa 48 Stunden.
Das ist keine Prognose. Das ist eine Messung, aufgenommen in dieser Woche, an dieser Veröffentlichung.
Und sie definiert neu, was der Bau eines KI-Produkts bedeutet. Wenn die Modellschicht eine Ware ist, die jeder an einem Nachmittag austauscht, ist das Modell nicht länger das, worüber Sie konkurrieren. Es überlebt alles, was darum herum liegt: Zuverlässigkeit, wenn der Inferenzserver um drei Uhr nachts umfällt; Datenpipelines, die den richtigen Kontext erfassen, säubern und wiederfinden; Evaluation, die Ihnen sagt, ob es auf Ihren Daten funktioniert statt auf denen eines Benchmarks; eine Oberfläche, die Menschen tatsächlich benutzen; und die Vertrauensfragen — Datenschutz, Aufbewahrung, wer was sehen darf — die entscheiden, ob Ihnen überhaupt jemand seine Besprechungsaufnahmen anvertraut.
Nichts davon wird in zwei Tagen zur Ware. Nichts davon hat einen Download-Button.
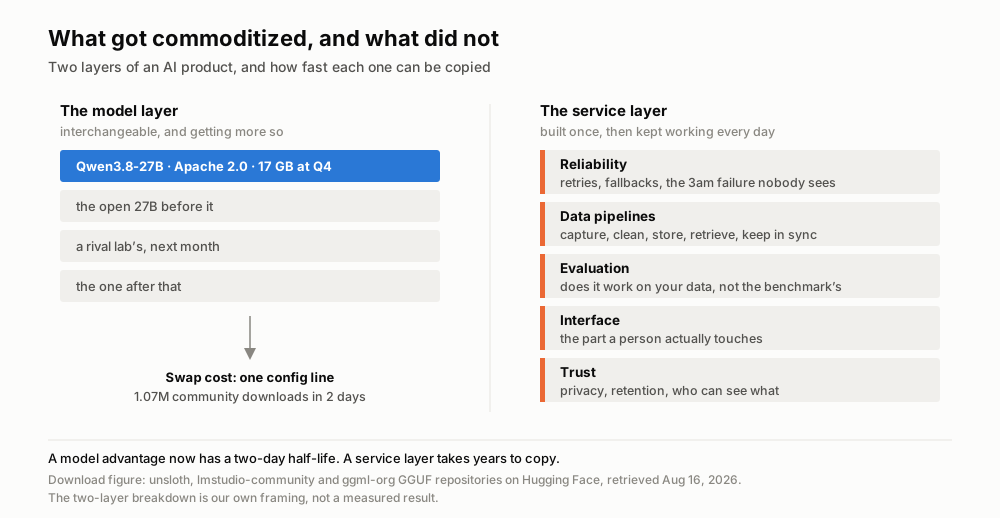
Die Schicht, die diese Woche billig wurde, und die, die es nicht wurde. Downloadzahlen von Hugging Face, abgerufen am 16. August 2026; die Zwei-Schichten-Einteilung ist unsere.
Die richtige Reaktion darauf, dass ein starkes offenes Modell auf Laptops landet, lautet also weder „die Modellfirmen haben gewonnen“ noch „die Produktfirmen haben verloren“. Sie lautet: Die interessante Arbeit ist im Stapel ein Stockwerk tiefer gewandert — dorthin, wo sie viel schwerer zu kopieren und viel weniger schlagzeilentauglich ist.
Wo Telli.sh steht: Wir bauen genau diese Dienstschicht, auf offenen Modellen. Telli.sh setzt in der Zusammenfassung bereits ein offenes Qwen-Modell ein, das heißt: Jeder Qualitätssprung bei offenen Modellen — dieser eingeschlossen — fließt direkt in Transkription, Übersetzung und Zusammenfassungen, ohne Preisänderung auf Ihrer Seite. Unsere Zeit geht in den Teil, der nicht in einer GGUF-Datei ankommt: Audio zuverlässig aufnehmen, Sprecher auseinanderhalten, aus einer 60-minütigen Aufnahme Notizen machen, die Sie Monate später noch finden, und klar sagen, wo Ihre Daten liegen.
Quellen
- Modellkarte und Lizenz zu Qwen3.8-27B, Hugging Face
- Modellkarte und Lizenz zu Qwen3.8-2.4T-A95B, Hugging Face
- unsloth/Qwen3.8-27B-GGUF: quantisierte Builds und Downloadzahlen
- Qwen3.8 in der Ollama-Modellbibliothek
- Hacker-News-Diskussion zur Veröffentlichung von Qwen3.8-27B (14. August 2026)
- Artificial-Analysis-Modellseite zu Qwen3.8 Max
- Ankündigung der offenen Gewichte von Qwen (@Alibaba_Qwen) auf X (3. August 2026)
- llama.cpp-Repository, erstellt am 10. März 2023
- Bildseite bei Wikimedia Commons
