[AIアイデアノート 04] Jev型の判断を画像へ:小型QwenモデルQEVを知る
Qwenを基盤に画像の判断モデルが登場する理由、Jevの実験的画像対応による変化、ローカル2BクラスのQEVの位置付けを解説します。
AIアイデアノートは、新たに登場するAIモデルやツールの発想と、実用につながる可能性を探るシリーズです。
仕分け作業に写真が届きます。アプリはプラスチック、ガラス、金属から選び、与えられた分類に属するかを判定し、ソフトウェアが使える値を返す必要があります。ボトルを説明する流暢な文章も興味深いものの、モデルの出力から判断まで、もう1段階が残ります。
Jevが注目させたのは別のインターフェースです。状況、質問、許された答えを渡し、確率付きの構造化された判断を受け取ります。次の問いは自然です。文章を読むだけでなく、モデルが見たものにも同じ方法を使えるのでしょうか。
今では複数の形で可能です。TypeSafeは2026年10月14日、Jevに実験的な画像対応を導入しました。独立したプロジェクトも、Qwenの視覚言語モデルをJev型の判断へ適応させています。その1つがQEVです。Qwen3.5-2Bを使うローカルモデルで、選択、順序付きスコア、真偽判定、回答保留を提供します。Jevの発表、QEVリポジトリ
著者からの開示:QEVは、この記事の著者が独立して保守するプロジェクトです。この記事は公開済みリリースとソース限定の機能を分け、公開文書と記録済みの例を使います。新たな独立評価を実施したという紹介ではありません。
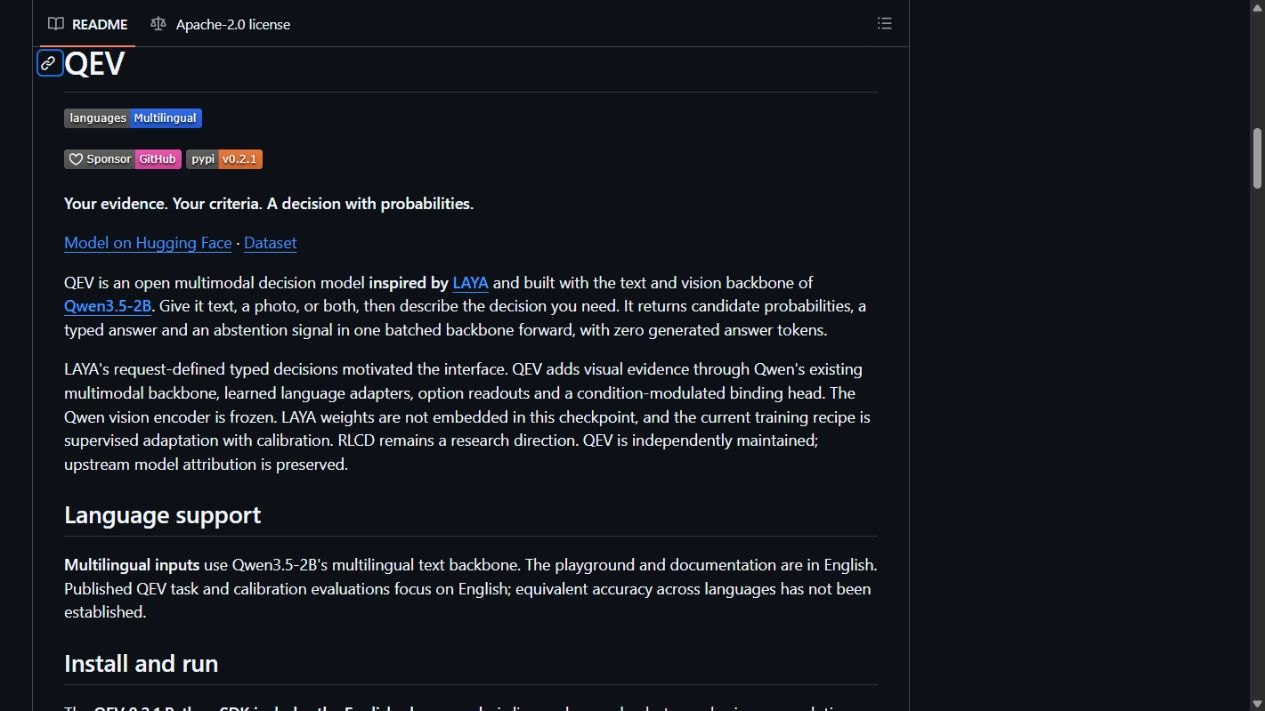 2026年10月20日に撮影したQEVの公開リポジトリ。文書の画面であり、ローカル推論の実演ではありません。
判断モデルは、チャットボットと何が違うのか
通常のチャットボットは、トークンを順に生成して答えを書きます。判断モデルは、行き先を選ぶ、順序付きの尺度で条件を評価する、記述が成立するか判断するなど、アプリが答えの形を決めている場面で役立ちます。
選択肢は要求ごとに変えられます。サポートシステムは今日、請求と技術支援を提示し、明日はアカウント復旧を加えるかもしれません。画像仕分けでは、ある質問で6種類の材質、別の質問で取り扱い規則を渡せます。モデルは固定の学習済みラベルから選ぶのではなく、現在の根拠とその説明を対応付けます。
Jevで知られる基本型はchoice、score、noulです。QEVのchoiceは、渡された候補の確率分布を返します。scoreは、渡された順序付き水準の確率と期待水準を返します。noulは真・偽の条件を使います。同じモデルでも、それぞれ異なる出力契約です。QEV APIリファレンス
確率は境界を見えるようにします。上位2候補の差が小さければ、自動処理ではなく確認へ回せます。ただし、確率が判断の正しさを保証するわけではありません。不確実性、不適切な入力、誤りの費用に対応する方針はアプリ側に必要です。
Jevには、すでに実験的な画像入力がある
登場の背景は更新する必要があります。「Jevは今も画像を受け取れない」としてQEVを紹介するのは正確ではありません。TypeSafeの10月の発表では、TypeSafe-Danger-Zone-Imagesヘッダーを使い、Jev 1.13と1.14で実験的な画像入力を有効にできます。1.14は空間用のBox型も加えています。画像機能は実験段階とされています。Jev 1.14の発表
比較すべき内容も変わります。重要なのは、どの配布形態、入力契約、判断動作が自分の処理に合うかです。ホスト型Jevの実験、研究モデル、ローカルQwenの適応版は、制約された判断という発想を共有しても、パッケージ化や操作の対応は大きく異なります。
QEVには、JevのBoxに相当する機能は文書化されていません。TypeSafeの重みでも、公式Jevリリースでもなく、独立した実装です。型の名前やSystemOne型のエンドポイントが共通でも、それは連携の出発点であり、すべての要求をそのまま移せる証明ではありません。
こうしたプロジェクトにQwenが使われる理由
視覚言語モデルは、文章と画像の情報を共通のモデルへ取り込みます。視覚理解を保ちつつ、アプリが渡す答えと根拠の結び付け方を適応できるので、判断モデルの実用的な基盤になります。
次の公開例から、1つのリポジトリを超える方向性が見えます。
| プロジェクト | 公開されている方式 | 状態をどう読むか |
|---|---|---|
| PixelJev | 2B・4Bなどの小型Qwen3.5でJev型の視覚選択を研究 | 視覚選択の論文であり、完全なホスト型Jev代替の証拠ではない |
| AutoTrust JEV-27B-VL | Qwen3.8-27Bに判断ヘッドとアダプターを追加 | 独立した大型モデルで、文章で学習した判断と画像のゼロショット利用を区別 |
| QEV | Qwen3.5-2Bをchoice・score・noulへ適応 | 公開SDKと別途説明されたソース拡張を持つ、ローカル2Bクラスのプロジェクト |
PixelJevの論文は、画像と要求時の候補を判断用の読み出しへつなぐ構造を理解するのに役立ちます。AutoTrustのモデルカードは別の規模の実装を示す一方、画像の体系的な較正が未確立としています。新しい設計パターンの例であり、順位表でも、同じ互換性を持つ製品一覧でもありません。PixelJev論文、AutoTrustモデルカード
その中でQEVが狙うのは、小型のローカル運用です。「小型」は、より大きな視覚言語モデルに対する基盤の規模を指します。導入全体が数MBで済むことや、すべての端末ですぐ動くことを意味しません。
QEVは画像をどう判断につなげるか
QEVは、文章と画像を扱う1つのQwen3.5-2B基盤を使います。公開構造は言語側の適応と、状況・質問を候補の説明へ結び付ける読み出しを加えています。回答文を生成して別のパーサーでラベルを抜くのではなく、候補を直接採点します。公開モデルカード
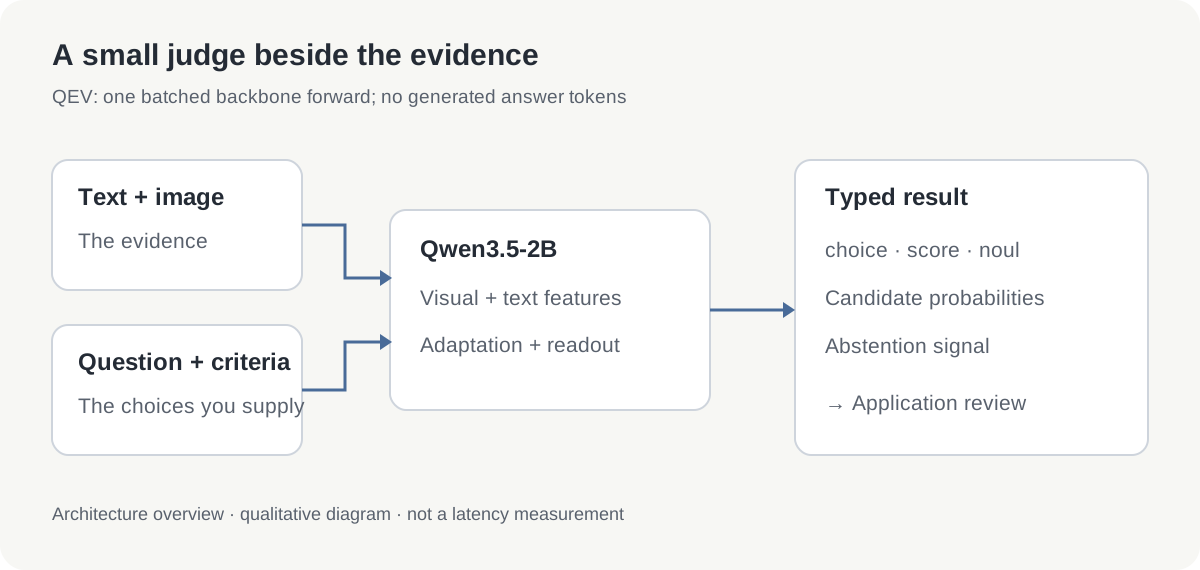 独自の解説図。矢印は文書にある判断経路を示し、速度の実測比較ではありません。
公開SDKの1要求は、文章、画像1枚、または両方を含められます。質問は1~4個、choiceの候補は2~16個、scoreの順序付き水準も2~16個です。質問ごとに別のチャットを作らず、関連する判断をまとめられます。APIリファレンス
写真と「この説明に従って材質を選んで」という短い指示を考えてください。次に適用する方針区分を尋ね、3問目で真偽条件に合うかを尋ねられます。写真は共通の根拠で、各判断の意味は条件の説明が決めます。
文書の推論経路は、回答トークンを生成しません。書式の揺れは減りますが、視覚エンコーダー、基盤の計算、画像前処理、アプリ側の負担は残ります。「回答を生成しない」と「計算コストがない」は違います。
ボトルの例は、例として読む
リポジトリには、利用許諾のあるプラスチックボトルの写真と、記録済みの出力があります。インストール前に返答の形を見るのに便利です。
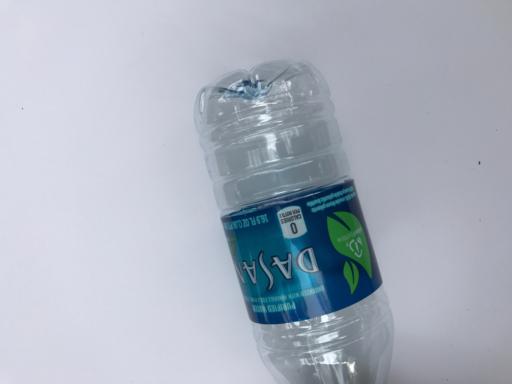 QEVの写真サンプルの公開入力で、元はTrashNetです。Copyright 2017 Gary Thung、MITライセンス。ライセンス表示を保存しています。
| 公開サンプルの質問 | 記録された結果 | 意味 |
|---|---|---|
| 6種類の材質から選ぶ | プラスチック、確率約0.9361 | 与えた候補で最大の確率を持つ |
| 順序付き方針区分を選ぶ | 0~2の尺度で期待水準約0.4254 | 3つの区分番号の加重平均 |
| ガラス・紙・プラスチックに属するか | 真、確率約0.7903 | 偽の代替条件より真の条件を支持 |
scoreには特に注意が必要です。この例では区分0がガラスとプラスチック、1が金属とごみ、2が段ボールと紙です。順序は例示の方針です。0.4254は安全評価、リサイクル基準、材質選択の信頼度ではありません。
同様に、プラスチックの確率はこの要求と候補に対する値です。すべてのボトル写真の93.61%を正しく分類できる証拠ではありません。新しい未使用テストではなく、以前に確認したリリースサンプルで、出力はこの記事で再現せずプロジェクトの記録を使っています。
ここでいう「Jev互換」を整理する
互換性は層に分けると理解しやすくなります。要求で定義する判断という発想、正確なJSON構造、対応入力、各出力の振る舞いです。1つが一致しても、残りが自動的に一致するわけではありません。
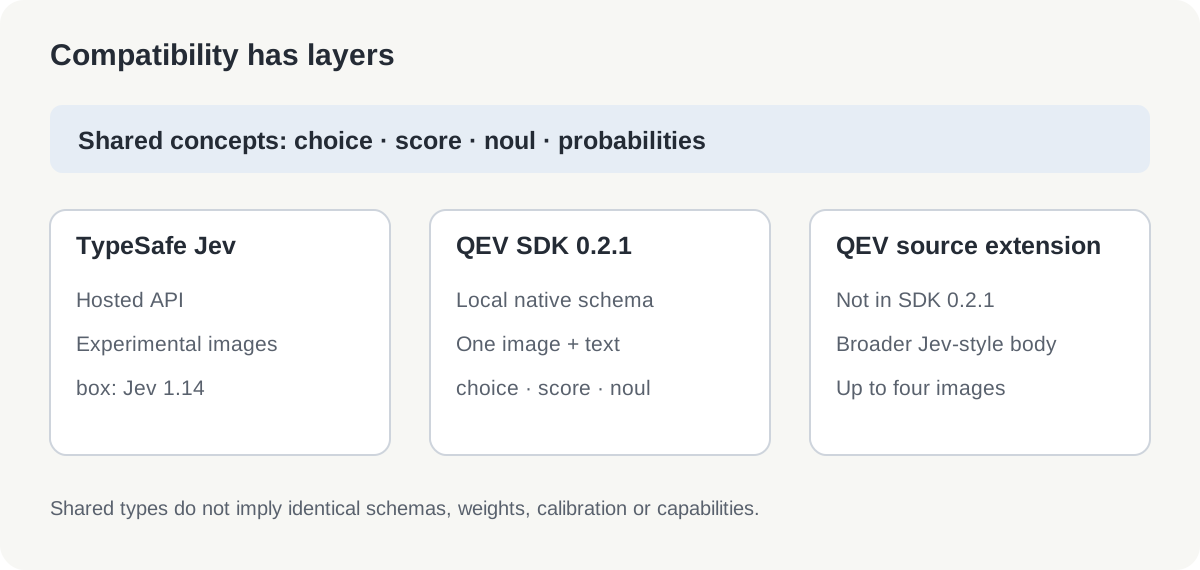 2026年10月20日に確認した独自の互換性マップ。ソース拡張と配布SDKの契約は別です。
パッケージ版QEV 0.2.1は、QEV独自の要求構造と任意の画像1枚を使います。公開ソースには、より広いJev/SystemOne型の要求処理と、順序付き最大4画像も記載されています。これらが公開済み0.2.1パッケージにもあるとは考えないでください。APIとリリース情報、0.2.1リリース
連携では、既知の要求1つから、入力検証、答えのフィールド、候補順、不確実性の扱いを比べます。見慣れた/v1/systemoneだけで、TypeSafeのサービスやSDKの完全な差し替えだとは言えません。
まずはローカル画面で試す
最初の探索では、アプリ連携よりローカルのplaygroundが確認しやすいでしょう。
- Python 3.12環境を準備して有効にします。
- 以下で版を固定して導入し、playgroundを起動します。
http://127.0.0.1:7860を開き、例を選んで候補の確率と回答保留を確認します。
python -m pip install qev==0.2.1
qev playground
公開playgroundはhttp://127.0.0.1:7860で動き、写真例、確率、回答保留、構造化出力を表示します。画面と文書は英語です。リリースの導入手順であり、この記事のために導入や計時をしたという意味ではありません。Playgroundガイド
小さな文章要求で、SDK独自形式を見てみましょう。
from qev import DecisionRequest, load

model = load()
request = DecisionRequest.model_validate({
    "state": {
        "text": "I was charged twice. Please refund the duplicate payment."
    },
    "questions": {
        "department": {
            "type": "choice",
            "instructions": "Which team should handle this request?",
            "criteria": {
                "billing": "Payments and refunds",
                "technical": "Software faults"
            }
        }
    }
})
print(model.predict(request)["answers"])
明確に異なる2~3候補から始め、曖昧な入力と、どれにも属さない入力も試します。回答保留とアプリの方針で有用な結果になるかを確認してください。画像は処理する権利のある写真を使い、画像では分からない事実ではなく、見える根拠に沿って条件を書きます。
アダプターだけでなく、基盤にも予算を取る
上記の旧SDK 0.2.1では、適応チェックポイントが約32.01 MB、別途Qwen基盤のダウンロードが約4.55 GBです。公開内訳は、基盤約22.13億パラメータ、適応・読み出し約799.2万パラメータとしています。下の10月版QEV-0.8B・QEV-2Bは、別のリリース読込経路を使います。SDKモデルサイズ内訳
初回準備には数GBが必要です。以後はキャッシュを使えますが、実行メモリには活性値、画像処理、バッファーも含まれます。GPUとCPUでは数値精度も違います。重みのバイト数は保存計画には役立っても、特定の機械のメモリ、処理量、電池消費を約束しません。
2Bが重ければ、QEV-0.8Bから試す
10月のリリースには、Qwen3.5-0.8Bを基盤とし、新しいQEV-2Bと同じ教師から蒸留したQEV-0.8Bがあります。GPUメモリや応答時間の都合で2Bが厳しい場合の出発点です。要求ごとに判断を定義する機能を保ちつつ、一部の画像判断品質と引き換えに資源を減らします。0.8Bモデルカード、2Bモデルカード
| 公開測定値 | QEV-0.8B | 10月版QEV-2B | 差 |
|---|---|---|---|
| 公開画像Decision Index、accurateモード | 53.02 | 61.99 | 2Bが8.97ポイント上 |
| GPU最大割当、accurateモード | 1.86 GiB | 4.44 GiB | 0.8Bが約58%少ない |
| 要求プロファイル別p50の中央値 | 66.0 ms | 135.3 ms | 0.8Bが約51%低い |
| 要求プロファイル別p95の最大値 | 377.3 ms | 738.6 ms | 0.8Bが約49%低い |
| GPU最大割当、fastモード | 1.60 GiB | 4.13 GiB | 0.8Bが2.53 GiB少ない |
| RealWorldQAスコア | 39.2 | 56.2 | 2Bが17.0ポイント上 |
| Winogroundスコア | 47.5 | 65.5 | 2Bが18.0ポイント上 |
| InfographicVQAスコア | 75.4 | 83.1 | 2Bが7.7ポイント上 |
2026年10月20日に確認した開発者の測定値です。指数は公開vision kit 0.3.2での自己採点で、公式実行は未実施です。総合正解率ではありません。8.97ポイント差の対応付きブートストラップ区間は7.39~10.48ポイントです。個別の基準から、差が仕事で変わることも分かります。
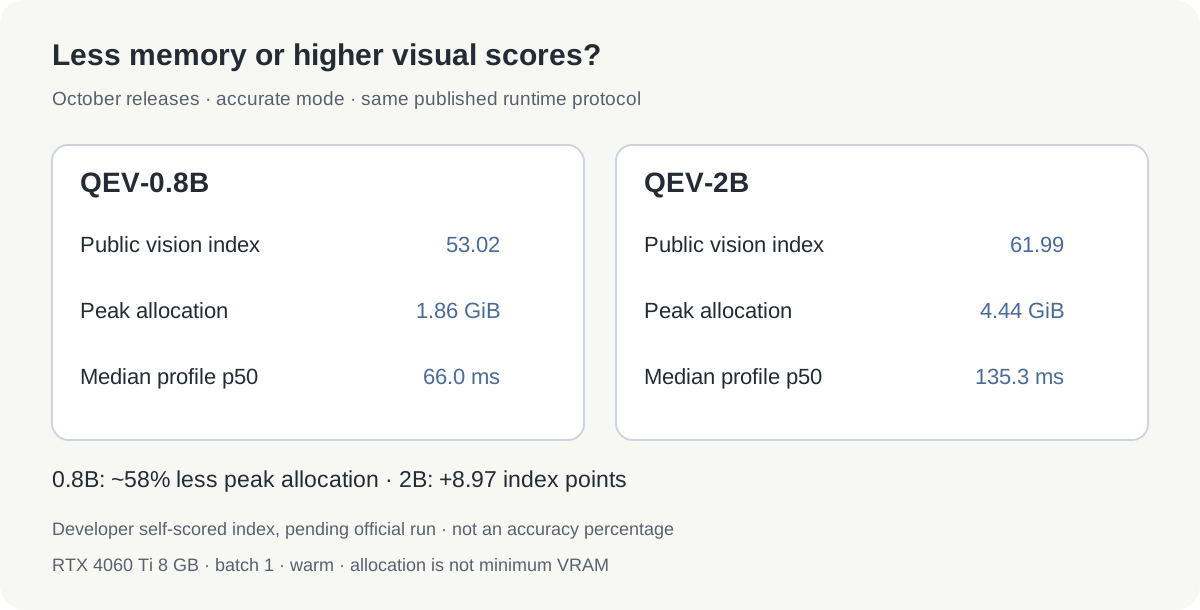 版を固定した2つのモデルカードに基づく独自の比較図。指数は自己採点で、メモリと時間は測定GPUのaccurateモードです。
測定はRTX 4060 Ti 8 GB、バッチ1、準備済みモデル、47の要求プロファイルで、各3回のウォームアップと30回の計時を使っています。accurateモードは1画像最大1.6 MPです。メモリはPyTorchの最大割当で、必要なGPU総容量ではありません。ドライバー、他アプリ、入力の違いのために余裕も必要です。時間にダウンロードと読込は含まず、CPU性能も予測しません。
fastモードは画像を0.26 MPに制限し、24層中16層で終了します。0.8Bではp50の中央値が44.6 ms、最も遅いプロファイルのp95が123.2 msになります。内部DEV精度はaccurateの86.0%から82.0%へ下がり、特に文書、グラフ、画面に影響します。fastの公開Decision Indexは報告されておらず、53.02はaccurateの値です。
これらの重みには別のPython 3.12環境を使ってください。旧qev==0.2.1パッケージは0.8Bリリースを読み込めません。
python -m pip install "qev @ git+https://github.com/ken-jo/qev@986a2d6d7b7e1583458b4006c9b88d6269dfa84a" huggingface_hub
from huggingface_hub import snapshot_download
import qev

path = snapshot_download(
    "ken-jo/QEV-0.8B",
    revision="def58ea5c773bb2e5bf53c428c6a1c76c6e55ceb",
)
model = qev.QEV.load(path, device="cuda")
# To reduce image resolution and depth further:
# model = qev.QEV.load(path, device="cuda", mode="fast")
前の例と同じように、model.predict(request)へDecisionRequestを渡します。0.8Bのaccurateから始め、まだ厳しければfastを試します。代表的な入力の誤りが追加のメモリと時間を正当化するなら2Bへ進み、同じ入力と候補説明で比べてください。
試す場面と、根拠の限界を知る
最初の実験は、見える根拠があり、影響が限定された仕事にします。文書画像を確認待ちへ振り分ける、物の写真を分類する、与えた取り扱い説明のどれが合うか選ぶ、といった例です。役立つかを測る間は人の確認経路を残します。
指示を調整する前に、小さな代表セットを選びます。採用された回答の精度、保留率、通過した誤りを記録し、照明、画像品質、言語を変えて繰り返します。QEVは基盤の多言語入力を引き継ぎますが、公開精度・較正の根拠は英語中心です。韓国語なども同等と仮定せず試してください。公開モデルカード
旧SDKモデルの評価にも限界が示されています。2,000問の型付き判断比較でQEVは77.00%、文章専門のLAYAは76.95%でした。1問差で、対応付き信頼区間はゼロをまたぎます。一般的な精度優位を示さず、ホスト型Jevとの直接比較でもありません。上の10月版比較とは別の結果です。文章専門化は、その条件では高速な場合もあります。比較方法と結果
視覚推論にはばらつきが残ります。探索的な2048評価では、72回の試行で成功はありませんでした。写真の材質を識別する小型モデルが、安定した空間計画もできるとは限りません。評価記録
ローカル運用、小型基盤、明示的な判断出力が同時に必要なら、QEVを調べる価値があります。Jevの実験的画像対応や他のQwenプロジェクトから、広い方向性も見えます。画像について制約付きの判断をモデルに求め、その結果の使い方を通常のソフトウェアが決める場面が増えています。
出典
2026年10月20日確認。構造、例、公開範囲は、版を固定したQEV公開ソースとSDK 0.2.1を参照しています。背景にはTypeSafeのJev発表、PixelJev論文、AutoTrustモデルカードを使いました。冒頭画像はQEV公開READMEの紹介用キャプチャで、画像出典と権利を別途記録しています。
分類ミスや方針変更を後から見直せるよう、元の根拠を判断と一緒に保存しましょう。Telli.shアカウントを作成して、資料、メモ、追加調査を1つの検索可能な作業場所へまとめられます。