PFNが次世代AIチップにメモリを積み重ねる理由
PFNとSEMIFIVEによるMN-Core L2000の共同開発は、AI推論のメモリボトルネックに挑みます。開発計画がエージェント、プライベートAI、将来のハードウェア購入に何を意味するのかを考えます。
AIアシスタントは、モデルを読み込むだけのメモリがあっても、返答が遅く感じられることがあります。演算器の準備ができていても、有効な計算には必要なデータを適切なタイミングで届けなければなりません。複数のプライベートアシスタントを提供する企業では、この違いによって、優れたチップ仕様が単語ごとの気になる待ち時間に変わってしまうことがあります。
Preferred NetworksとSEMIFIVEは、その問題に向けた開発に取り組んでいます。2026年11月16日の発表で説明されたMN-Core L2000シリーズは、ロジックとDRAMを垂直に積層する推論向けプロセッサです。目標は、先行するL1000シリーズの2倍を超えるメモリ帯域幅です。PFNは11月17日に自社サイトへ発表を掲載しました。PFNの発表
注目したいのは、この設計が将来AIサービスを運用する人に何をもたらすかです。データ転送の高速化は演算能力の追加と同じくらい重要になり得ますが、その効果が利用者の画面まで届くかどうかは、パッケージング、ソフトウェア対応、完成したサーバーに左右されます。L2000の発表は、購入判断を迫られる前に、こうした条件を整理するよい機会になります。
PLaMoを開発する会社は、その下で動く装置も設計している
Preferred Networksは東京を拠点とするAI企業で、プロセッサ、計算基盤、PLaMoモデル群を手がけています。今回の協業では、PFNがプロセッサアーキテクチャとロジック設計を担当し、SEMIFIVEがSamsung Foundryのプラットフォームと3D-IC設計基盤を利用して実装・サプライチェーンサービスを提供します。PFNと開発各社の役割
この分担が重要なのは、有用なアクセラレータが命令セットやチップの図だけでは完成しないからです。ロジック設計を製造可能なシリコンにし、メモリを接続し、パッケージ化したデバイスを安定して動作させる必要があります。顧客が最終的に必要とするのは、再現できるサーバー構成と、モデルをアプリケーションにつなぐソフトウェアの経路です。各段階の引き継ぎが、完成品のコストや納期に影響し得ます。
PLaMoとの関係は、読者にとって分かりやすい入り口です。ただし、PLaMoのすべての導入環境がこのハードウェアへ移行することを意味するわけではありません。モデル開発者とインフラ購入者では、問うべき点も違います。開発者はワークロードを効率よく表現できるかを考え、購入者はサポート対象の実装が設備の運用期間を通じてサービス目標を満たせるかを考えます。
韓国の読者にとってSEMIFIVEの参加は、国内の半導体設計技術が推論インフラに関与する具体例です。次に確かめたいのは、その技術が量産デバイスやサポートされるシステムにどうつながるかです。協業の発表は参加企業と方向性を示し、後続製品が顧客にとっての選択肢を決めます。
メモリ容量とメモリ帯域幅は、別々の問いに答える
容量は、メモリシステムが保持できるデータ量を表します。帯域幅は、一定時間に移動できるデータ量を表します。モデルが容量の上限内に収まっていても、帯域幅によってプロセッサの処理速度が制限されることがあります。容量を増やすだけでアプリケーションの応答がよくなるとは限りません。
簡単な計算で、まず容量の問題を確認できます。仮に300億パラメータの密なモデルをパラメータ当たり2バイトで保存すると、パラメータだけで約600億バイトが必要です。実行時の作業領域、アテンションのキャッシュ、その他のオーバーヘッドは含んでいません。保存容量の見積もりを説明する例であり、L2000の容量や対応モデルを述べたものではありません。
次に考えるのは、保存したデータをワークロードがどう使うかです。入力プロンプトの処理と、出力トークンを順番に生成する処理では、システムへの要求が異なります。NVIDIAの推論最適化の解説は、プロンプトを並列処理する段階と、メモリ転送が制約になり得る自己回帰デコードを区別しています。また、バッチ処理やアテンションキャッシュ管理がそのバランスを変える理由も説明しています。NVIDIAの推論最適化ガイド、2023年11月17日
メモリを、厨房につながった食品庫と考えてみてください。食品庫が大きければ材料を手元に多く置けます。通路が広ければ厨房へ運びやすくなります。ただし、それだけでは特定の料理が何分でできるかは分かりません。下ごしらえや残りの工程もあるからです。役割の違いを見失わないことで、ハードウェア比較は実用的になります。
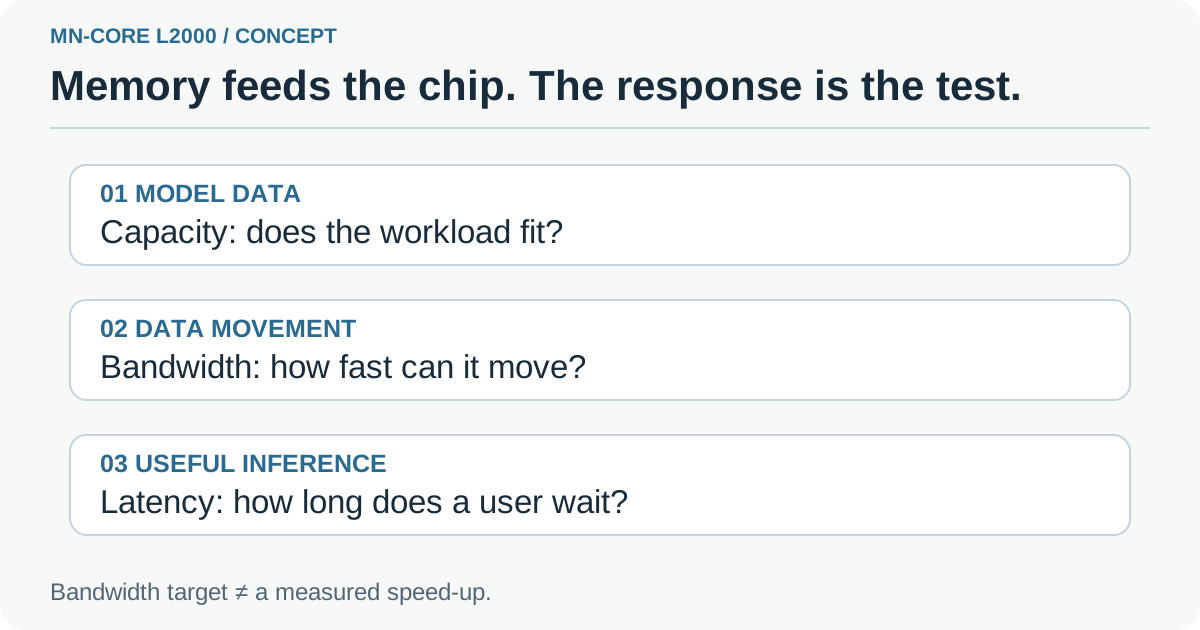
保存、データ転送、アプリケーションの応答を分けた独自の解説図です。判断の構造を示すもので、未公開のL2000パッケージ配置を描いたものではありません。
積層はデータ経路だけでなく、設計上の課題も変える
PFNの公式発表には、MN-Core LシリーズでロジックとDRAMを垂直に積層する図が含まれています。提案されている方向性を知るのに役立つ図です。一方、顧客が設置する完成済みサーバーを示すものでも、完成したアプリケーションの性能を証明するものでもありません。
部品を積層する設計では、物理システム全体として機能する必要があります。電力供給、放熱、製造の一貫性は、データ転送と同時に検討すべき項目です。スライド上で魅力的なアーキテクチャができてから考える付随問題ではありません。適切なコストでデバイスを製造、パッケージ化、冷却、サポートできるかに影響します。
運用者にとって、パッケージ設計は検討の終点ではなく始点です。ラックには電力の許容範囲があり、施設には冷却設計があり、サービスには稼働率への期待があります。新しいアクセラレータは、最終的にその三つに適合する必要があります。経済性は、運転を維持する設備や人件費を含む、導入全体で決まります。
効率の説明に測定条件が必要なのも同じ理由です。あるモデル、精度、同時実行数でよい結果が出ても、すべてのワークロードを説明することはできません。顧客は、どこで性能を発揮し、どこで余裕を失い、有用な回答の提供にサービス全体がどれだけのエネルギーを使うかを知る必要があります。
三つのワークロードでは、三つの異なる問いが生まれる
法務やエンジニアリングのチーム向けプライベート文書アシスタントを考えてみましょう。この仮想サービスではリクエストの到着が不規則で、利用者は回答が始まる前の遅れに気づきます。評価には代表的な文書、検索時間、モデルの最初の応答を含めるべきです。アクセラレータで経路の一部を改善しても、文書検索やアクセス制御の確認がより大きな遅延として残ることがあります。
二つ目は、タスク完了までモデルを繰り返し呼び出す社内エージェントです。この場合、一回の生成の遅れが、それに依存する後続の複数段階に影響する可能性があります。有用な成果は、ツールの結果や人の承認を含め、適切に認可されたタスクを完了する時間です。モデルのトークン生成速度を上げても、実際に生成を待つ部分しか短縮できません。
三つ目は、大量の記録を分類・要約する夜間処理キューです。大きなバッチを許容し、期限までの総処理量を重視できます。同じモデルを使っていても、対話型アシスタントとは違う構成を選ぶかもしれません。調達評価では、見出しになる最大の数値を出したデモを選ぶのではなく、この違いを保つ必要があります。
これらは評価計画であり、L2000を使った実験ではありません。性能を一つに決めつけなくても、メモリ重視のアーキテクチャを追う価値がある理由を示しています。よいパイロットは、チームが理解しているワークロードと、現行システムに比較できる結果から始まります。
| 判断対象 | チームが用意するもの | 結果で確認すべきこと |
|---|---|---|
| プライベート文書アシスタント | 代表的な質問、文書、アクセス規則 | 合意した応答目標の範囲内に有用な回答が届く |
| 多段階の社内エージェント | タスク全体、ツール呼び出し、承認箇所 | 正確さを損なわず、開始から完了までの時間が改善する |
| 夜間処理キュー | 固定した記録セットと完了期限 | 必要な作業を運用予算内で安定して終えられる |
帯域幅の目標は、サービスを見積もる一つの材料である
私たちは、購入する仕事の内容から比較を始めるのが最も有用だと考えます。チームが買うのは帯域幅そのものではなく、制約の下でタスクを終える能力です。その判断には、モデルとランタイムからサーバー、アプリケーションへと続く根拠が必要です。
最初にモデル対応を確認します。対象のアーキテクチャ、精度、必要な演算が、サポート対象のソフトウェアスタックで動かなければなりません。デモを実行できるコンパイラやランタイムでも、本番サービス向けには統合作業が残る場合があります。対応バージョン、変換が必要な演算、モデル変更時にその経路を保守する担当者を確認してください。
次に応答の指標を分けます。最初の有用な回答までの時間、生成中の速度、完了リクエストの総数は、別々の体験を表します。同じ入力サイズと同時実行数で、失敗や未完了の応答も含めて記録します。出力品質を変えたり、リクエストをひそかに落としたりして速くなった実行は、サービスの改善とは別の結果です。
最後に、モデルの周囲にアプリケーション全体を戻して考えます。検索、モデレーション、ツールへのアクセス、キュー、ネットワーク通信にも時間がかかります。ハードウェアのパイロットでは、タスク全体のうちどれだけが推論待ちかを示すべきです。それによって、推論経路の高速化で実際に期待できる効果を合理的に見積もれます。
次に確認できる節目は、設計データの製造への引き渡しだ
公表されたテープアウト目標は2027年第1四半期です。最終設計データを製造へ引き渡す時点を指します。開発上の節目であり、完成したサーバーの納入日ではありません。PFNの開発計画
製造、パッケージング、立ち上げ、検証を通じて、設計を利用可能な製品につなぐ必要があります。その後のソフトウェア適格性確認とシステム統合で、顧客が何を導入できるかが決まります。一般販売より前でも、各段階の進展は重要なニュースになります。ただし、それぞれが答える問いは異なります。
比較の基準にも同じ注意が必要です。L1000自体も2027年のリリース予定なので、この発表は現在購入できる二つのシステムではなく、開発世代を比較しています。発表には、L2000の小売価格、韓国向け納入日程、完成システムのベンチマークは公表されていません。調達日程は、将来サプライヤーが示すサポート構成と納入条件に基づいて決めるべきです。
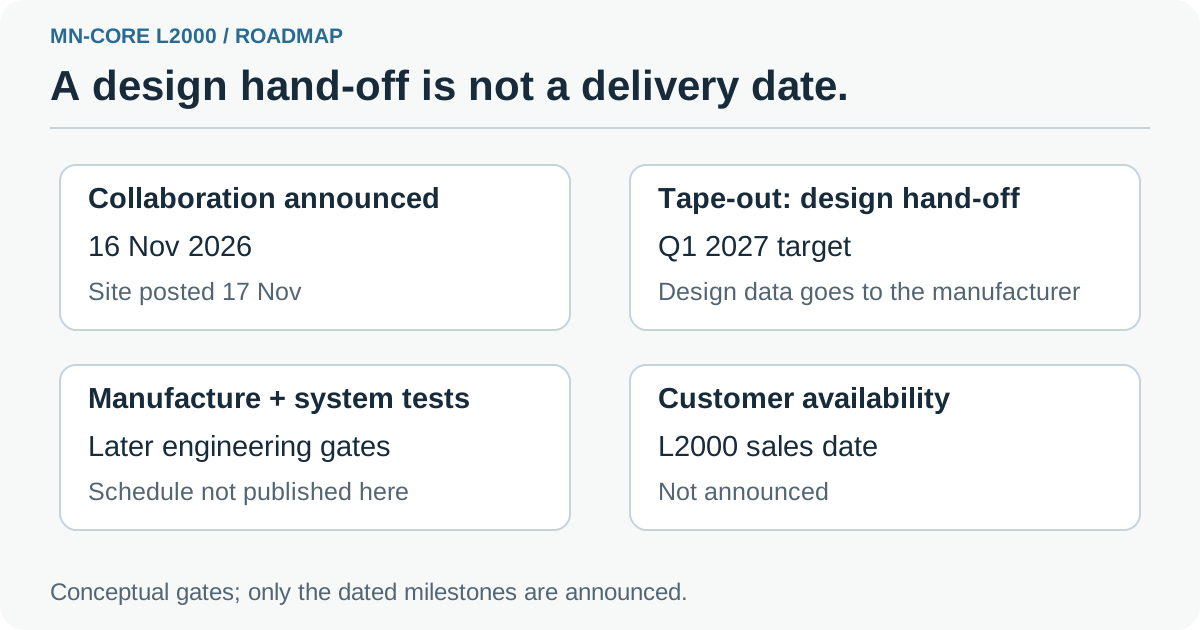
独自の開発段階ガイドです。公表されたテープアウト目標を、その後の製造、適格性確認、顧客への納入と分けています。後続段階の日程は未定です。
実用的な評価ファイルに何を残すべきか
開発計画を追いながら、チームができる有用な作業もあります。将来購入するのがMN-Coreシステムでも、GPUサーバーでも、ホステッドサービスでも使える、簡潔な基準を作っておくことです。目的は、将来のハードウェア比較を安く、意味のあるものにすることです。
- 仕事全体を選びます。 対話型タスクを一つ、必要ならバッチ処理も一つ定義します。正しい完了の条件と、応答または完了の期限を記録します。
- 試験資料とソフトウェアのバージョンを固定します。 プロンプト、入力文書、モデルのリビジョン、精度、ランタイム設定をまとめます。チームに処理する権限のある資料を使います。
- 現在の経路を測ります。 想定負荷の下で、モデルの応答時間、タスク全体の時間、失敗、リソース使用量を記録します。生成ではなく、検索やツールを待つ時間も記しておきます。
- 条件が一致するサポート構成を求めます。 将来のベンダー試験では、アクセラレータ、メモリ構成、ホスト、ランタイム、モデル対応を明示してもらいます。品質や精度の変更を見える状態に保ちます。
- 運用上の判断を比較します。 購入、ソフトウェア統合、電力、冷却、サポート、復旧作業を含めます。元の仕事を許容できるコストで解決する改善かを判断します。
このファイルは、関係のないスループットのスクリーンショットを集めるより役立ちます。新しいシステムが出るたびにワークロードを変えることを防げます。同じ仕事をきちんと終え、遅延や運用負担が減ったという、本当の改善も見つけやすくなります。
小さなチームでは、現時点の判断が、既存ハードウェアを使い続けながらアプリケーションを改善することかもしれません。応答時間の大半が検索なら、推論だけ高速化しても効果は限られます。必要な負荷でサービスが継続的に生成を待っているなら、新しいアクセラレータを試す理由が強くなります。どちらの発見も、利用者に影響するボトルネックへ支出を向ける助けになります。
ハードウェアの焦点はメモリへ近づいている
L2000の協業を追う価値があるのは、推論の問題と、それを解決するための物理設計・生産作業を結び付けているからです。次に役立つ根拠は、製造やソフトウェア適格性確認の進捗、そしてサポートされるシステムでの測定です。どのワークロードに効果があり、その効果を得るために運用者が何を投資する必要があるかが、そこから分かります。
今の段階でも、実用的な教訓はあります。AIハードウェアを比較するときは、モデルを収める容量、データ転送、アプリケーションの成果を分けてください。モデルがメモリに収まることは議論の出発点であり、購入者が必要とする結果は、信頼して運用できるサービスです。
出典
- Preferred Networks、PFNとSEMIFIVEによるMN-Core L2000シリーズの共同開発。発表日付は2026年11月16日、ウェブ掲載日は2026年11月17日。公式の構造図と開発日程を含みます。
- Preferred Networks、日本語の発表。同内容の企業発表です。
- Shashank Verma、Neal Vaidya、NVIDIA Technical Blog、Mastering LLM Techniques: Inference Optimization、2023年11月17日。推論の段階、バッチ処理、メモリ利用の背景資料で、MN-Coreハードウェアのベンチマークではありません。
ワークロード、モデル設定、サプライヤーの回答をまとめて残し、次の評価も比較可能な基準から始めましょう。Telli.shで最初のノートを作成する。