GitHub IssueからAIが使える要件を作ったか、OpenRE-Benchで分かるか?
十件のベンチマークで、機能要望を要件に変えるエージェント基盤を比較する。実例に沿って、コードを書く前に見るべき点を考える。
GitHubのIssueに「戻ってきたときも絞り込みを残してほしい」と書いてある。コーディングエージェントならすぐに何かを実装できるが、解釈を誤ることもある。「戻る」とは、項目を開いて一覧に戻ることか、ブラウザーを再読み込みすることか、翌日にログインすることか、別のワークスペースに移ることか。どれを選ぶかで、機能も受け入れテストも変わる。
OpenRE-Benchは、Issueと実装の間で何が起きるかを調べる。2026年11月10日にarXivへ提出されたプレプリントは、要件を生成するエージェント基盤向けの共通テスト環境を示した。最初のセットには十件あり、五件は公開GitHubの機能要望に由来し、五件は研究者が作成した。同じ入力と採点の取り決めを異なる基盤に適用するため、三つのアダプター例が用意されている。OpenRE-Benchプレプリント
このベンチマークを使うと、生成結果に具体的な問いを立てられる。提案された要件を二人が読んだとき、同じ動作を実装し、同じ結果をテストするだろうか。絞り込みの例で、最終文書と同じように判断の記録がなぜ大切か、チームのIssueから要件までの流れをどう確認できるかを考える。
コードを書く前に、判断した内容を見える形にする
要件工学は、目標、制約、観察できる動作を、関係者が合意できるまで明確にする作業だ。よいIssueが利用者の問題をよく伝えていても、実装上の判断がいくつか残ることはある。画面遷移で作業を失わないことに二人が合意していても、設定を端末間で同期するかでは意見が分かれ得る。役に立つ初稿はその違いを残し、責任を持つ人が判断できるようにする。
絞り込みの要望を、次のように解釈できる。ログイン済みの利用者が項目を開き、同じワークスペース内で一覧に戻ったら、直前の絞り込み値を復元する。別のワークスペースの設定変更は、チームが別途決めるまで対象外にする。受け入れテストには、明確な開始状態、操作、観察できる結果がある。試作品でも完成した機能でも検証できる。
もう一つの解釈では、ログアウト後や別の端末でも絞り込みを保持する。アカウント単位での保存方法と、端末ごとに異なる設定がある場合のルールが必要になる。元の一行には、そこまで指定されていない。便利そうだからとエージェントが追加すれば、小さな画面遷移の改善が、費用やプライバシーへの影響の異なる製品変更になってしまう。
| 要望の一部 | 確認可能な初稿 | 残る判断 |
|---|---|---|
| 項目から一覧に戻る | 同じワークスペースで表示中だった絞り込みを復元する | 一覧の表示位置も復元するか |
| 再読み込みや再ログイン | 未決事項として記録する | どれだけの期間、どこに設定を保存するか |
| ワークスペースを切り替える | あるワークスペースの絞り込みを別の場所に表示しない | ワークスペースごとに履歴を持つか |
| 絞り込み済みリンクを共有する | リンク共有は別のユースケースとして扱う | どの値を共有URLに表せるか |
実装前に生成された要件をレビューするための例。Telli.sh作成。
一行目は、保存層の技術説明がなくても検証できる。ほかの行には判断が必要なことも見える。使える要件は、約束する動作を具体的にし、チームに残された質問も明確にする。
ベンチマークは入力と証拠の取り決めをそろえる
OpenRE-Benchのプレプリントは、ケース名、説明、要件本文を持つ共通の CaseInput を示している。アダプターは共通形式と参加する各基盤の間を変換する。エージェント同士の連携方法は各基盤に任せながら、比較に必要な情報を残す役割だ。同梱の例はMARE、iReDev、QUAREで、著者はMAREとiReDevを元論文に基づく再実装として説明している。OpenRE-Bench論文、第II節
共通のテスト環境は四段階の出力を集める。初期モデル、調整の記録、統合モデル、検証結果だ。各段階で、レビューする問いが異なる。最初にエージェントが見たものは何か。どこで意見が分かれたか。統合後にどの判断が残ったか。結果を確認する根拠は何か。内部の役割名が基盤によって異なっても、共通構造で判断を追いやすい。
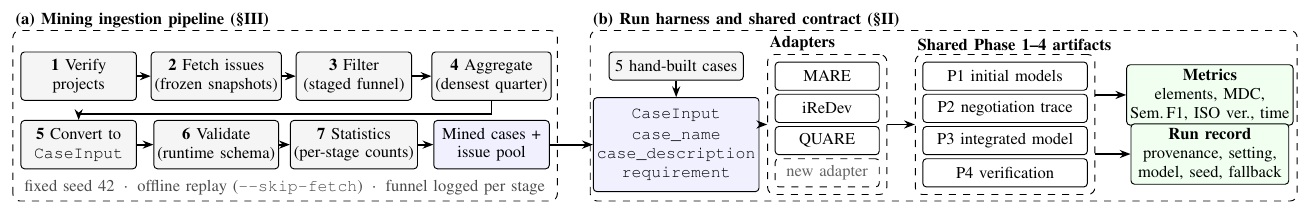
ChengほかによるOpenRE-Benchの図1(2026年11月10日)。著者のPDFから切り出し、表示用にサイズを調整。原図 · CC BY 4.0。
絞り込みの例では、段階1で「戻ったときに現在の一覧を復元する」と「端末をまたいで設定を記憶する」の両方を提案するかもしれない。段階2で、二つを別の範囲として記録できる。統合後の成果物には前者を残し、後者は未決とできる。最後の検証では、採用した動作を確認する。四段階を見れば、意図した範囲の決定と、誤って抜けた内容を区別できる。
基盤を比較するとき、アダプターがあると比較の限界も伝えやすい。内部で詳細な形式を使うシステムでも、共通スキーマに出力するときに一部の違いが失われることがある。結果の説明に役立つなら、各基盤の元の成果物も残す。比較には標準化した出力を使い、なぜ差が出たかを理解するために元の成果物を見る。
十件のケースは、分野全体より処理の流れを検証する
Chengらによると、Python、TypeScript、Javaにまたがる五プロジェクトから3,000件のIssueを取得し、フィルターで1,396件に絞った。そこから18件を使って抽出由来の五ケースを作成し、手作業の五件とあわせてv1.0に収録した。候補の総数と評価件数は別の数だ。収録セットでの実行対象は十件で、上流の処理が数千件から始まることとは区別する。OpenRE-Bench論文、表I
この処理自体もベンチマークの貢献だ。取得と絞り込みの手順が残っていれば、実際のプロジェクトのIssueがどのようにテストになったか分かる。新しい実行を公表済みの結果と比べるときに役立つ。ラベル、コメント、集計期間などの条件が、選ばれる要望の種類にどう影響するかも確認できる。
選択条件は、代表できる問題の範囲を決める。公開リポジトリーでは、誰でも読める場所で機能範囲を議論することが多い。社内の権限変更を計画するチームでは、顧客との会話や非公開の設計レビューで範囲を決めることもある。公開ケースで良い成績のモデルでも、そうした用途には固有のテストが必要になり得る。情報が足りない、要件が複数の文書に散らばる、コメントが矛盾するなど、実際によく起きる事例を追加する。
手書きの五件は、別の種類の出発点を与える。作り込んだケースなら特定の曖昧さを切り出しやすく、抽出したケースなら要望の自然な現れ方が残る。結果は両方を分けて報告する。整ったケースでは改善しても、抽出したスレッドで判断を見失う基盤には、Issueの一次確認に使う前に別の指示や補助資料が必要かもしれない。
共通の採点で安定した比較を行い、現場固有の確認も追加できる。Telli.sh作成。
検証可能性の点数と、元のIssueとの照合を組み合わせる
論文は、ISO/IEC/IEEE 29148に関連する適合の手がかりを使い、構造上の検証可能性を1から5で再現可能に採点する方法を説明している。要素数、同じ実行内の初期出力と統合出力の意味の保持、所要時間も報告する。構造化された成果物を安定して作り、工程全体で内容を保てるかを見る指標だ。全段階が同じ業務上の仮定を引き継いでいる場合、その仮定が正しいかまでは決められない。OpenRE-Bench論文、指標
たとえば初期モデルが「戻る」を「翌週ログインする」と解釈したとする。統合後も同じなら、意味の保持の指標は段階間の一貫性を捉えられる。元のIssueを読む人は、根拠のない解釈だと指摘できる。指標と人のレビューは異なる問いに答える。範囲を明確にすれば、どちらも役に立つ。
元の資料に関する主張を検証するため、小さな正解セットを用意する。各Issueで、要件を直接支える文と、判断が残る点を記録する。落ちた制約、事実として書かれた仮定、提案されたテストとIssueの食い違いを、確認者に印を付けてもらう。具体的な五問のチェックリストが、範囲の異なる多くのケースの平均より、実際の導入に役立つことがある。
架空のエクスポート機能も考えよう。Issueは、地域の日付形式が変わっても、レポートを表計算ソフトで読めるように求めている。一つの初稿は利用者、データ、手順、検証記録を定義し、「正しく日付を出力したことを確認」と書く。別の初稿は「日・月の順のロケールを選び、2026年3月4日の行をエクスポートした後、月・日の順のロケールで開き直しても、日付が2026年3月4日として保持されることを確認」と書く。後者はすぐテストにできる。前者は形式上の要素が多くても、正しい結果を人によって違って解釈できる。
レビュー自体も試せる。同じテスト案に必要な最小のデータを、二人に書いてもらう。一人が月と日を取り違えやすい日付を、もう一人が28日を選べば、検出する問題の種類が変わる。よい受け入れテストは、誤りが表れるデータを指定する。エージェントが元のIssueの重要性を理解できれば、その確認を作る手助けになる。
費用と時間も同じように扱う。異なる視点をすり合わせるため、呼び出しが増える基盤もある。チームが見逃しがちな矛盾を見つけるなら、時間をかける意味がある。簡単な基準方式と同じ結論で、中間成果物だけが長くなるなら、その差も費用比較に含める。追加手順の価値を判断する前に、同じケースで基準方式と基盤を動かす。
判断できる要件を使って、小さな比較を行う
- 論文が指定する版の成果物を使い、オフラインで動作を確認する。著者はキー不要の
single_agent設定を文書に載せている。モデルを使う有料比較の前に、実行環境と成果物の場所を確かめられる。OpenRE-Benchの成果物の手順 - 公開済みか利用が認められたIssueを少数選ぶ。単純な依頼、コメントが矛盾する依頼、方針が未決の依頼を含める。出力を見る前に、期待する動作と残る質問を書く。
- 同じ入力で各候補を実行し、基盤の版、モデルの構成、実行設定を記録する。中間成果物を残す。要件の欠落と根拠のない仮定には同じ判定基準を使う。
- 判断ごとに出力を比較する。製品の観察で何が検証でき、Issueのどの記述がそれを支えるかを確認する。コードを書く前に、人が範囲を明確にする必要があるかを記録する。
- 結果をもとに、エージェントを使う場所を決める。受け入れテスト案を作れる依頼と、依頼者に質問した方がよい依頼がある。両方の出力を作業の流れから見られるようにする。
次は、実際のレビュー会議で一件の要件を扱う。エージェントの初稿と、チームが最終的に提供すると合意した内容を比べる。確認者が毎回同じ種類の主張を書き直すなら、その項目をテストに加える。期待結果が具体的で出典をたどれる要件は、ほかの箇所に修正が残っていても役に立つ。
OpenRE-Benchを使えば、最初のコード変更の前に比較できる。確かめるべきなのは、次の担当者が、チームの合意した動作と根拠をたどれ、誰かが判断する必要のある点を理解できるかだ。
出典
- Chengほか、OpenRE-Benchプレプリント(2026年11月10日)
- 方法、データ、図1の原図を掲載した論文全文
- 著者が提供する版管理済みの成果物
- クリエイティブ・コモンズ 表示 4.0 国際
機能要望やレビューの判断を検索できる形に残すには、Telli.shアカウントを作成。