Rozpoznawanie mowy po cichu stało się otwarte — i waży 1,56 GB
Modele Qwen3-ASR od Alibaby są na licencji Apache 2.0, obsługują 52 języki i dialekty i zajmują mniej niż dwa gigabajty. Przystępny przewodnik po warstwie otwartych modeli transkrypcji: co już istnieje, co realnie daje uruchomienie modelu na własnym laptopie i gdzie zamknięte API wciąż wygrywają.
Rozpoznawanie mowy z otwartymi wagami można już uruchomić na laptopie: zespół Qwen z Alibaby udostępnia Qwen3-ASR-0.6B, Qwen3-ASR-1.7B i towarzyszący im Qwen3-ForcedAligner-0.6B na licencji Apache 2.0. Najmniejszy model zajmuje 1,56 GB, obsługuje 52 języki i dialekty, a od 26 czerwca można go uruchomić w trzech linijkach standardowego Pythona. Uruchomienie go na własnym komputerze oznacza brak opłaty za każde żądanie transkrypcji.
Ta zmiana będzie znajoma każdemu, kto śledził otwarte modele językowe: samodzielne uruchamianie daje większą kontrolę nad kosztami, prywatnością i pracą offline, a z hostowanych API łatwiej korzystać. W rozpoznawaniu mowy pojawia się podobny wybór, bo modele są już na tyle małe, by działać lokalnie.
Ten przewodnik wyjaśnia, jak działa rozpoznawanie mowy z otwartymi wagami, czym różnią się dostępne modele i licencje, na jakim sprzęcie można uruchomić mały model oraz gdzie hostowane API wciąż mają przewagę.
TL;DR:
- Otwarta transkrypcja jest dziś użyteczna: Qwen3-ASR na Apache 2.0 z 52 językami i dialektami, Whisper na MIT, Parakeet i Canary od NVIDII na CC BY 4.0, Voxtral od Mistrala na Apache 2.0.
- Własny hosting daje prywatność, pracę bez sieci i kontrolę kosztów. W niezależnym rankingu Artificial Analysis hostowanie otwartego modelu kosztuje 1,50 dolara za 1000 minut, wobec 6,00 za MAI-Transcribe-1.5 od Microsoftu i 18,15 za Gemini 3.1 Pro Preview.
- Pierwsze miejsce w dokładności nadal zajmuje zamknięty punkt końcowy w wersji zapoznawczej. Ale otwarty model na Apache 2.0, Voxtral Small, jest już piąty — mniej więcej jeden punkt procentowy współczynnika błędu słów za nim.
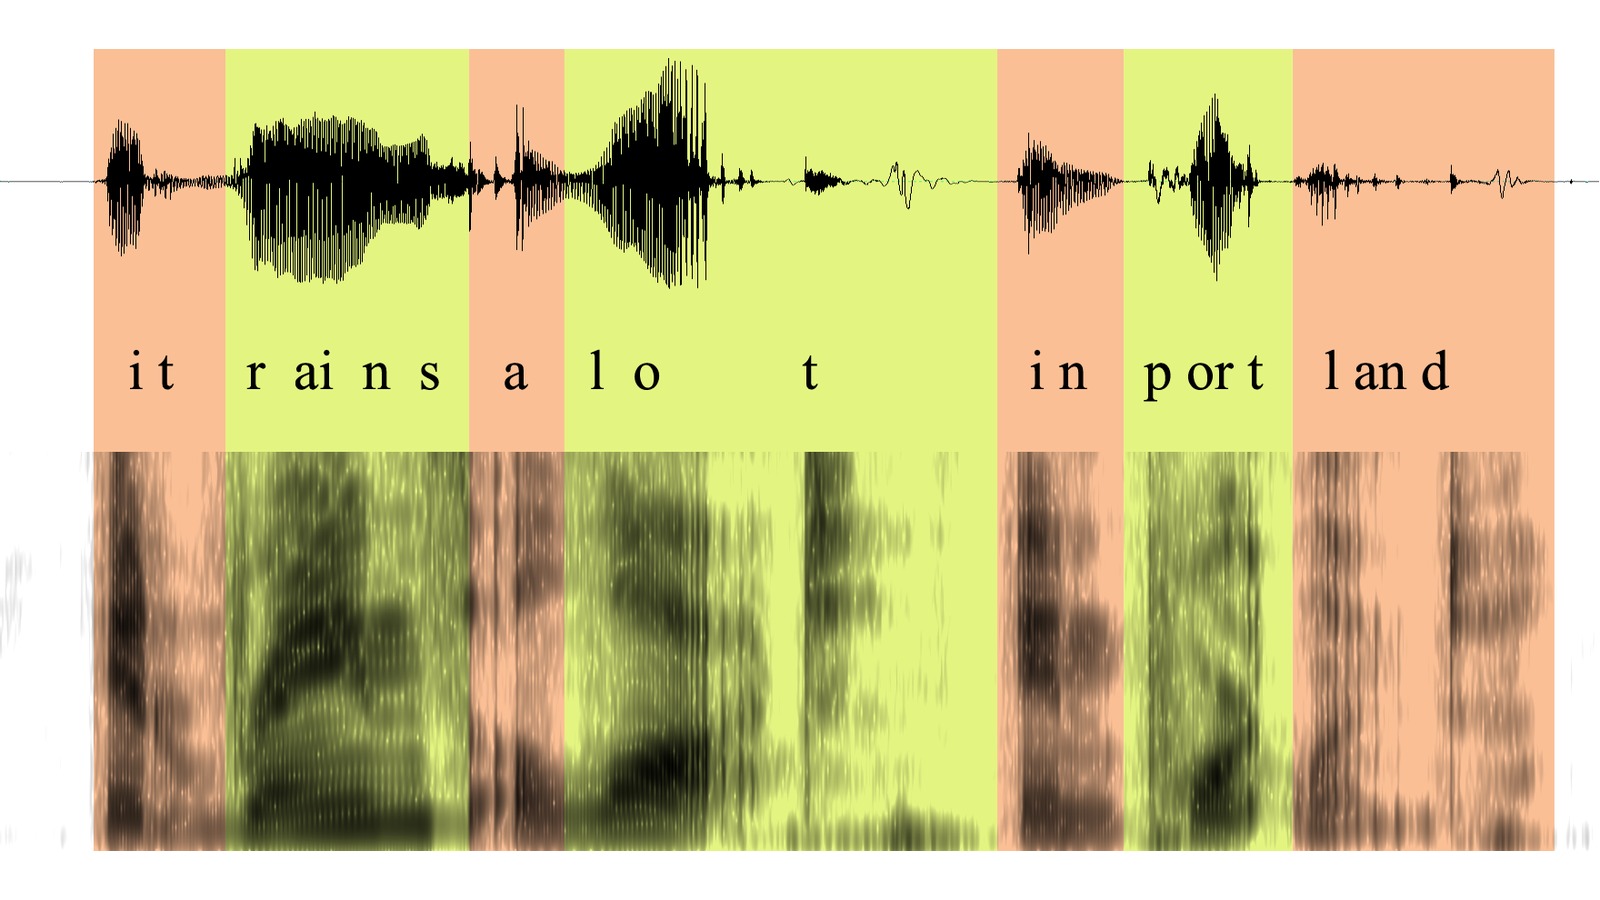
Zdjęcie: Aaron Parecki, Wikimedia Commons, CC BY 2.0. Przebieg fali i spektrogram zdania „it rains a lot in Portland", z literami ustawionymi nad dźwiękiem, któremu odpowiadają — dokładnie z takim surowcem pracuje każdy model rozpoznawania mowy.
Co właściwie pobierasz, pobierając model transkrypcji
Model ASR — automatyczne rozpoznawanie mowy, używane wymiennie ze STT, mowa na tekst — to program, który przyjmuje dźwięk i zwraca tekst. To całe jego zadanie. Nie ustala, kto mówił, nie streszcza, nie wie, o czym było twoje spotkanie. Słyszy słowa i je zapisuje.
„Otwarte wagi" znaczą, że laboratorium opublikowało sam plik gotowego modelu. Wagi modelu to ogromna siatka liczb wyuczona podczas treningu, a ich publikacja oznacza, że pobierasz ten plik, uruchamiasz na własnym sprzęcie i budujesz na nim, nie pytając nikogo o zgodę i nie płacąc za zapytanie. Alternatywą jest model zamknięty: wagi zostają na serwerach dostawcy, a ty wynajmujesz dostęp przez API — dźwięk idzie w górę, tekst wraca, rozliczenie jest za minuty.
Liczba w nazwie to liczba parametrów i w modelach mowy jest nietypowo konkretna. „0.6B" znaczy około 600 milionów parametrów, co w praktyce czyni Qwen3-ASR-0.6B plikiem o rozmiarze 1,56 GB, a Qwen3-ASR-1.7B — 4,08 GB. Oba dość małe, by leżeć na dysku laptopa niezauważone. Porównaj to z otwartymi modelami językowymi z naszego przeglądu chińskiej fali, gdzie sztandarowa premiera ważyła 1,56 terabajta w 96 fragmentach i wymagała klastra już do samego wczytania. Modele mowy są około tysiąc razy mniejsze od czołowych modeli tekstowych, i właśnie ten jeden fakt sprawia, że tutaj zmiana uderza mocniej niż tam.
Nazwijmy ten zakres rozmiarów klasą laptopową: modele są na tyle małe, że ich wypróbowanie oznacza pobranie pliku, a nie decyzję o budżecie na sprzęt. Większość czołowych modeli tekstowych się w nim nie mieści, ale wiele modeli mowy tak.
Przed wyborem modelu sprawdź jego licencję. Apache 2.0 i MIT pozwalają używać, modyfikować i rozpowszechniać model komercyjnie; CC BY 4.0, na której NVIDIA udostępnia swoje modele, również dopuszcza użycie komercyjne, ale wymaga podania autorstwa.
Qwen wydał rodzinę w styczniu; w czerwcu stała się łatwa
Qwen3-ASR pojawił się po raz pierwszy 28 stycznia 2026 roku, a dzień później ukazał się raport techniczny na arXiv. 26 czerwca Qwen opublikował wersje -hf wszystkich trzech modeli, zgodne z Hugging Face Transformers od wersji 5.13.0.
Zmiana sposobu pakowania ułatwia konfigurację: zamiast instalować pakiet Qwena qwen-asr albo backend vLLM, osoby korzystające z Transformers mogą wczytać checkpointy -hf za pomocą standardowego Pythona. Obniża to koszt konfiguracji, nie zmieniając tego, co model rozpoznaje.
Karty modeli wymieniają identyfikację języka i rozpoznawanie mowy w 30 językach, w tym po angielsku, chińsku, koreańsku, japońsku, hiszpańsku, arabsku, hindi, tajsku, wietnamsku i polsku, a także w 22 chińskich dialektach — łącznie 52 językach i dialektach. Oba rozmiary obsługują przetwarzanie strumieniowe i offline w jednym modelu, przyjmują długie nagrania, a karty wymieniają śpiew i utwory z muzyką w tle wśród obsługiwanych typów audio.
Qwen3-ForcedAligner-0.6B dodaje wymuszone wyrównywanie: na podstawie audio i transkrypcji oznacza czas początku i końca każdego słowa z dokładnością do milisekundy w 11 językach, dla nagrań do pięciu minut. Umożliwia to klikalne transkrypcje, synchronizację napisów i przejście do chwili, w której wypowiedziano dane słowo. Opublikowanie alignera obok modelu rozpoznającego sprawia, że ta rodzina przydaje się do budowania produktów transkrypcyjnych, a nie tylko do uruchamiania demonstracji.
Karty modeli Qwena podają wyniki Hugging Face Open ASR Leaderboard z 26 czerwca 2026 roku: średni współczynnik błędu słów wynosi 5,59 % dla modelu 1.7B i 6,31 % dla 0.6B; w podzbiorze nagrań ze spotkań AMI wyniki to odpowiednio 9,26 % i 10,57 %. Niższy współczynnik błędu słów oznacza mniej błędów. Qwen określa model 1.7B jako wiodący wśród otwartych modeli ASR i konkurencyjny wobec komercyjnych API; są to wyniki podane przez dostawcę. Niezależny ranking poniżej wykorzystuje inne nagrania, więc wyników nie można bezpośrednio porównywać.
To Whisper zaczął, i wciąż jego wszyscy uruchamiają
Nic z tego nie istniałoby w tym kształcie bez Whispera od OpenAI. Repozytorium otwarto 16 września 2022 roku na licencji MIT — kod i wagi razem — w momencie, gdy poważne rozpoznawanie mowy oznaczało umowę z dostawcą chmury. Od tego czasu zebrało 106 679 gwiazdek na GitHubie.
Whispera uczyniło ważnym nie tyle sam model, ile to, co społeczność zbudowała na nim w ciągu miesięcy. whisper.cpp przepisał go w czystym C i C++, licencja MIT, 52 591 gwiazdek, i sprawił, że działa na laptopach i telefonach bez Pythona i bez GPU. faster-whisper przebudował go na CTranslate2 z dużym zyskiem na szybkości i pamięci, także MIT, 24 750 gwiazdek. Model był nasieniem; drzewem był ekosystem.
Cztery lata później Whisper nadal jest szeroko używany. W ciągu 30 dni przed 5 sierpnia 2026 roku whisper-large-v3-turbo pobrano z Hugging Face 8,72 miliona razy, a whisper-large-v3 — 5,50 miliona; Qwen3-ASR-0.6B osiągnął 4,29 miliona pobrań. W rankingu Artificial Analysis Whisper Large v3 uzyskał 4,07 % AA-WER wobec 1,73 % lidera w tym zestawieniu.

Otwarta warstwa mowy przyszła dwiema falami oddzielonymi o trzy lata, a pomiędzy nimi prawie nic. Daty wydania z GitHuba i Hugging Face, pobrane 5 sierpnia 2026.
Otwarta strona to więcej niż jedno laboratorium
Qwen nie jest sam, a pozostali są dobrzy w wyraźnie różnych rzeczach.
Linia Parakeet od NVIDII stawia na szybkość. parakeet-tdt-0.6b-v3, wydany w sierpniu 2025 roku na licencji CC BY 4.0, ma 600 milionów parametrów, obsługuje 25 języków europejskich oraz automatyczne wykrywanie języka, interpunkcję, wielkie litery i znaczniki czasu dla poszczególnych słów; w jednym przebiegu przetwarza do 24 minut audio. Rodzina Canary od NVIDII — canary-1b-v2 i canary-qwen-2.5b, również na CC BY 4.0 — oferuje podobne możliwości. Modele Voxtral od Mistrala, wydane w lipcu 2025 roku na Apache 2.0, plasują się blisko czołówki niezależnego porównania poniżej.
Oto otwarta strona zestawiona obok siebie, z hostowanym API w ostatnim wierszu dla kontrastu.
| Model | Pobranie | Licencja | Języki | Działa na | Najlepszy w |
|---|---|---|---|---|---|
| Whisper Large v3 | 3,09 GB | MIT | 99 | Laptop lub jedno GPU | Bycie domyślnym wyborem, który wszystko już obsługuje |
| Qwen3-ASR-0.6B | 1,56 GB | Apache 2.0 | 52 z dialektami | Laptop | Wielojęzyczność w najmniejszym rozmiarze |
| Qwen3-ASR-1.7B | 4,08 GB | Apache 2.0 | 52 z dialektami | Laptop lub jedno GPU | Najlepsza dokładność w rodzinie Qwen |
| Parakeet TDT 0.6B v3 | 2,51 GB | CC BY 4.0 | 25 europejskich | Laptop lub jedno GPU | Szybkość i znaczniki czasu na poziomie słów |
| Voxtral Small | — | Apache 2.0 | — | GPU serwerowe, 24 mld parametrów | Najlepszy otwarty wynik w niezależnym rankingu |
| Hostowane API | Nie do pobrania | Zamknięta | Różnie | Chmura dostawcy | Rozdzielanie mówców, strumieniowanie, dostępność |
Rozmiar pobrania dotyczy domyślnego checkpointu w każdym repozytorium Hugging Face. „—" oznacza, że w materiałach wykorzystanych do tego porównania nie podano tej wartości. Zestawienie z 5 sierpnia 2026 roku.
Dalej jest praca nad opakowaniem, która wprowadza te modele na prawdziwe urządzenia — punkt, w którym klasa laptopowa przestaje być teorią. whisperkit-coreml, czyli Whisper skompilowany na sprzęt Apple, pobrano w ostatnich 30 dniach 8,31 miliona razy. Build MLX Parakeeta na Apple Silicon zebrał 1,87 miliona, a dwie konwersje GGUF — kwantyzowany format uruchamiający modele na zwykłych procesorach — 2,04 i 1,87 miliona. Miliony ludzi miesięcznie pobierają rozpoznawanie mowy zapakowane specjalnie po to, by działało na ich własnej maszynie. To nie badawcza ciekawostka. To kanał dystrybucji.
Pierwsze miejsce to nadal punkt końcowy w wersji zapoznawczej, którego nie pobierzesz
To porównanie pozwala oddzielić dokładność rozpoznawania od praktycznych korzyści z uruchamiania modelu samodzielnie.
Ranking mowa-na-tekst Artificial Analysis, pobrany 5 sierpnia 2026 roku, mierzy modele otwarte i zamknięte na tych samych nagraniach. Wyniki AA-WER v2 obejmują:
| Miejsce | Model | AA-WER | Do pobrania? |
|---|---|---|---|
| 1 | Fun-Realtime-ASR-preview | 1,73 % | Nie — punkt końcowy zapoznawczy |
| 2 | Scribe v2, ElevenLabs | 2,18 % | Nie — hostowane API |
| 3 | MAI-Transcribe-1.5, Microsoft | 2,38 % | Nie — hostowane API |
| 4 | Smallest AI Pulse Pro | 2,43 % | Nie — hostowane API |
| 5 | Voxtral Small, Mistral | 2,77 % | Tak — Apache 2.0 |
| 6 | Gemini 3.1 Pro Preview, High | 2,82 % | Nie — hostowane API |
| 11 | Whisper Large v3 | 4,07 % | Tak — MIT |
Źródło: ranking mowa-na-tekst Artificial Analysis, AA-WER v2, pobrany 5 sierpnia 2026 roku. Dostępność do pobrania ocenialiśmy na podstawie opublikowanej licencji każdego modelu.
Pierwsze cztery wiersze pokazują, że w tym zestawieniu najwyżej oceniono modele hostowane, a lider jest punktem końcowym w wersji zapoznawczej, a nie modelem do pobrania.
Voxtral Small jest na licencji Apache 2.0 i zajmuje piąte miejsce z wynikiem 2,77 % — mniej więcej o jeden punkt procentowy za zamkniętym modelem zapoznawczym z czołówki. W przypadku godzinnego spotkania liczącego 6300 słów ta różnica oznacza około 66 słów. Jest realna, ale nie nie do pokonania dla zespołów, którym zależy na lokalnym uruchamianiu.
Dla wielu zastosowań otwarte modele mowy są już użyteczne. Pozostaje zdecydować, czy niewielka różnica w dokładności jest warta kontroli zapewnianej przez samodzielne uruchamianie, czy funkcje hostowanej usługi uzasadniają jej cenę.
Co daje uruchomienie u siebie i ile to kosztuje
Trzy rzeczy pchają zespoły w stronę własnego hostingu i żadna z nich nie jest dokładnością.
Prywatność jest pierwsza i zwykle rozstrzygająca. Jeśli transkrybujesz konsultacje medyczne, wywiady prawne albo rozmowy kadrowe, „dźwięk nie opuszcza naszego sprzętu" nie jest preferencją, lecz wymogiem zakupowym, a model hostowany przez ciebie to jedyna architektura, która spełnia go czysto. Praca bez sieci jest druga: model na urządzeniu działa w samolocie, w piwnicy, na hali produkcyjnej, w terenie bez zasięgu. Dokładnie dlatego whisper.cpp i buildy GGUF mają takie liczby pobrań, jakie mają.
Koszt jest trzeci, i tu liczby są bezlitosne. Z tego samego zrzutu Artificial Analysis, cena za 1000 minut nagrania: Whisper Large v3 hostowany na fal.ai wychodzi 0,50 dolara, Canary Qwen 2.5B od NVIDII na Replicate 0,74, Parakeet TDT 0.6B V3 na Together AI 1,50. Po stronie zamkniętej Nova-3 od Deepgrama kosztuje 4,30, MAI-Transcribe-1.5 6,00, a Gemini 3.1 Pro Preview 18,15. To czterokrotna różnica wobec Microsoftu i dwunastokrotna wobec Google'a — i to tylko za hostowanie otwartego modelu na cudzych serwerach, przed rozważeniem uruchomienia go na własnych, gdzie koszt krańcowy tysięcznej godziny to prąd.
W tym samym zestawieniu najwyższy wynik szybkości ma Parakeet TDT 0.6B V3 hostowany przez Together AI: 885 razy szybciej niż czas rzeczywisty, czyli około cztery sekundy na przetworzenie godziny audio. Nova-3 od Deepgrama osiąga 512x, Whisper Large v3 w Together — 478x, a MAI-Transcribe-1.5 — 189x. Najszybsza pozycja na liście to model z otwartymi wagami, ale wynik dotyczy hostingu w Together AI, a nie lokalnego sprzętu.

Ten wybór nigdy nie był dokładnością przeciwko dokładności. To kontrola i koszt przeciwko funkcjom owiniętym wokół rozpoznawania.
Co wtedy sprzedają hostowane API? Wszystko, co nie jest rozpoznawaniem. Dokumentacja Deepgrama to uczciwy spis: rozdzielanie mówców, strumieniowanie w czasie rzeczywistym, formatowanie, własny słownik, maskowanie danych, wykrywanie języka i operacyjna gwarancja, że usługa stoi, kiedy ty śpisz. Pobierz Qwen3-ASR i dostaniesz słowa oraz znaczniki czasu. Bez etykiet mówców, bez SLA, a rachunek za GPU, skalowanie i telefon o trzeciej w nocy są twoje.
Najczęściej pobierany model w kategorii wcale nie transkrybuje
Statystyki pobrań pokazują również zapotrzebowanie na identyfikację mówców obok transkrypcji.
Kiedy posortujesz całą kategorię automatycznego rozpoznawania mowy na Hugging Face po pobraniach, na górze nie ma ani Whispera, ani Qwena, ani Parakeeta. Jest pyannote/speaker-diarization-3.1 z 8,91 miliona pobrań w ostatnich 30 dniach, a drugi model rozdzielania mówców od pyannote zajmuje piąte miejsce z 5,26 miliona. Rozdzielanie mówców to mechanizm ustalający, kto mówił i kiedy — warstwa bezpośrednio nad transkrypcją.

Otwarte wagi pokrywają już dwie pierwsze warstwy stosu. Te, które decydują o przydatności notatki, leżą wyżej.
Najczęściej pobierany model w kategorii rozpoznawania mowy nie rozpoznaje mowy — identyfikuje, kto i kiedy mówił. Ten popyt wskazuje na warstwę ponad transkrypcją, gdzie etykiety mówców pomagają zamienić rozpoznane słowa w użyteczny zapis spotkania. To echo luki produktowej opisanej w naszej analizie zamkniętej części rynku.
Wniosek
Ciekawe pytanie o otwarte rozpoznawanie mowy nigdy nie brzmiało „czy jest tak dobre jak modele zamknięte". Jest w granicach jednego punktu procentowego błędu, jest szybsze, jest od czterech do dwunastu razy tańsze i mieści się na laptopie. Ciekawe pytanie brzmi: co zbudujesz w przestrzeni, która się otwiera, kiedy transkrypcja przestaje być wynajmowaną pozycją w kosztach — bo plik 1,56 GB słyszący 52 języki nie jest produktem. To część, która właśnie stała się darmowa.
Dla zespołu, który wybiera narzędzie do notatek ze spotkań, a nie model, praktyczny wniosek jest krótki. Czy produkt uruchamia otwarty model, czy zamknięte API, to dziś w dużej mierze szczegół implementacyjny, i coraz częściej będzie to jedno i drugie: otwarte wagi do pracy masowej, hostowane API tam, gdzie rozdzielanie mówców, strumieniowanie i skala zarabiają na swoją cenę. Telli.sh już używa otwartego modelu w warstwie streszczeń, więc postępy po otwartej stronie płyną prosto do transkrypcji, tłumaczeń i notatek ze spotkań bez zmiany ceny. Oceniaj narzędzie po tym, co wychodzi na końcu: czy notatka mówi, kto się do czego zobowiązał.
Źródła
- Karta modelu Qwen3-ASR-0.6B-hf (Hugging Face) — licencja, lista języków, wyniki rankingu z 26 czerwca 2026
- Karta modelu Qwen3-ASR-1.7B-hf (Hugging Face)
- Qwen3-ForcedAligner-0.6B (Hugging Face)
- Qwen3-ASR Technical Report, arXiv:2601.21337 (złożony 29 stycznia 2026)
- Repozytorium OpenAI Whisper (MIT, opublikowane 16 września 2022)
- whisper.cpp i faster-whisper
- Karta modelu NVIDIA parakeet-tdt-0.6b-v3 (CC BY 4.0)
- Mistral Voxtral-Small-24B-2507 (Apache 2.0)
- Ranking mowa-na-tekst Artificial Analysis — AA-WER v2, dane o szybkości i cenie pobrane 5 sierpnia 2026
- Hugging Face Open ASR Leaderboard
- Dokumentacja Deepgram o rozdzielaniu mówców
- Strona zdjęcia w Wikimedia Commons
